Separator mowy służy do wydobycia mówionego głosu z zaszumionego nagrania — spośród hałasu ulicznego, muzyki, pogłosu pomieszczenia czy drugiej rozmawiającej osoby — tak aby otrzymać czystszą ścieżkę głosową, którą można transkrybować, edytować, dubbingować lub ponownie wykorzystać. To pojedyncze zadanie leży u podstaw zaskakująco wielu codziennych zadań produkcyjnych. YouTuber usuwa uliczny hałas z wywiadu. Producent podcastu ratuje dialog nagrany w zatłoczonej kawiarni. Zespół marketingowy przygotowuje czystą próbkę przed sklonowaniem głosu. Narzędzie dobrze wykonuje jedną rzecz, a dokładne zrozumienie, czym jest ta rzecz, powstrzyma cię od proszenia go o wykonanie zadań, do których nigdy nie zostało stworzone.
Traktuj je jako warstwę oczyszczania, a nie warstwę tworzenia. Nie tłumaczy, nie generuje nowej narracji i nie maskuje mówiącego. Przyjmuje dźwięk, który już zawiera mowę, i oddaje tę mowę z mniejszą ilością zakłóceń wokół niej. Wszystko poniżej omawia, gdzie to faktycznie pomaga, jak leżący u podstaw model podchodzi do problemu i kiedy zamiast tego powinieneś sięgnąć po inne narzędzie.
Spis treści
Jak faktycznie działa separator mowy
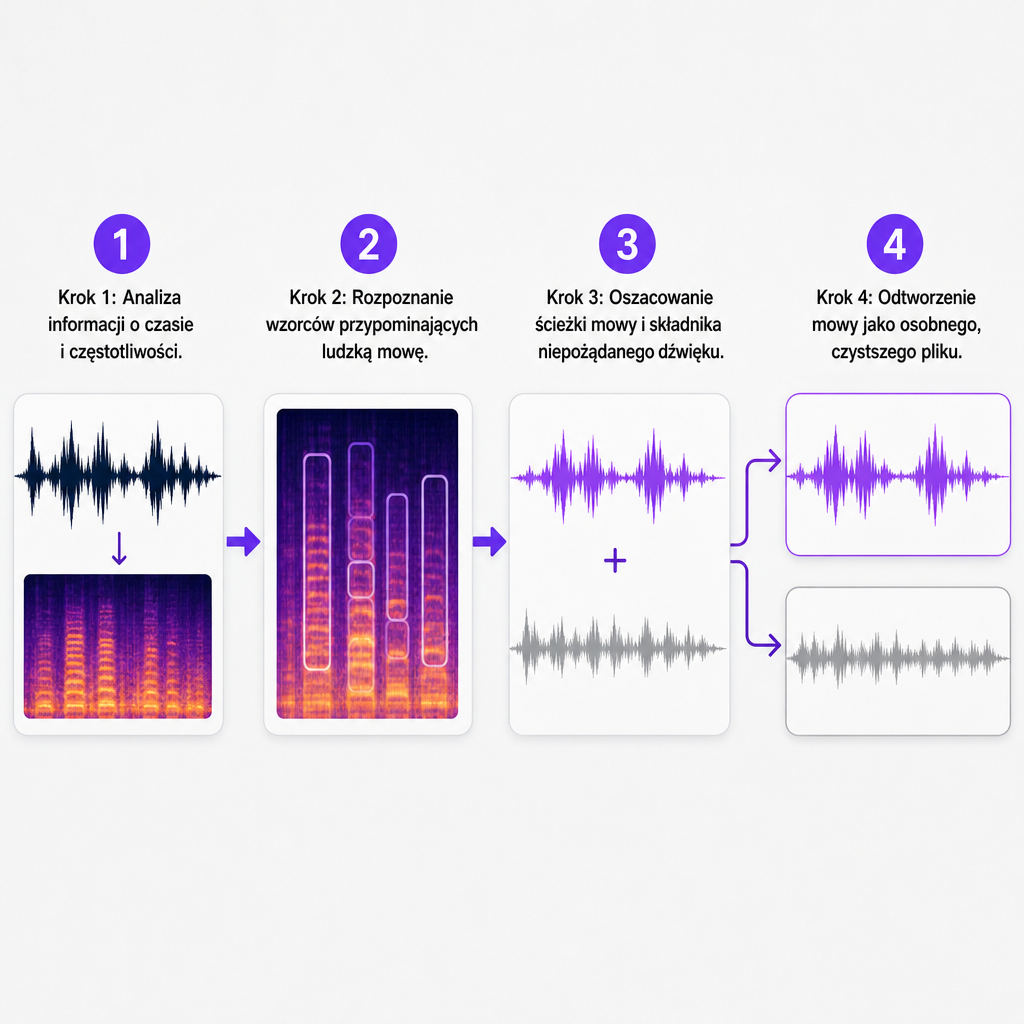
Pod przyciskiem kryje się model AI wytrenowany do rozpoznawania wzorców charakterystycznych dla ludzkiej mowy i odróżniania ich od wszystkiego innego w miksie. Odczytuje informacje o czasie i częstotliwości nagrania, szacuje, które części sygnału to głos, a które niechciany dźwięk, a następnie rekonstruuje mowę jako osobny, czystszy plik. Wiele systemów stosuje podejście oparte na maskach: części sygnału związane z mową mogą przejść, podczas gdy inne elementy są redukowane. Bardziej zaawansowane potoki łączą tłumienie szumów, separację mówiących i usuwanie pogłosu. Badania Microsoftu opisują jednokanałowe systemy czasu rzeczywistego, które łączą te etapy, aby wydobyć wielu mówiących z szumów i pogłosu.
Ważne zastrzeżenie kryje się w słowie rekonstruować. Wynikiem nie jest oryginalne czyste nagranie, które chciałbyś uchwycić. To oszacowanie AI tego, jak powinna brzmieć mowa po usunięciu zakłóceń, więc złożone miksy mogą generować artefakty — metaliczne tony, pominięte spółgłoski, drżenie czy nienaturalne przejścia. Wydajność spada również w realistycznych warunkach dalekiego pola i pogłosu, co dokumentują badania nad separacją mowy na rzeczywistych nagraniach. Im dalej mikrofon znajdował się od mówiącego i im bardziej pomieszczenie dawało pogłos, tym trudniejsze staje się zadanie modelu.
Separacja kontra usuwanie szumów: dlaczego nazwa ma znaczenie
Terminy te bywają używane zamiennie, ale zadanie, którego faktycznie potrzebujesz, decyduje o tym, które narzędzie pasuje. Usuwanie szumów obniża niechciany dźwięk tła. Poprawa mowy sprawia, że istniejący głos jest łatwiejszy do zrozumienia. Separacja mowy wydobywa głos z rzeczywiście zmieszanego sygnału. Separacja mówiących idzie o krok dalej i próbuje utworzyć odrębne ścieżki, gdy dwie osoby mówią jednocześnie. A separacja wokalu dzieli muzyczne stemy, co jest inną dyscypliną nakierowaną na utwory, a nie dialog.
| Zadanie | Główny cel | Przykład |
|---|---|---|
| Usuwanie szumów | Redukcja niechcianego dźwięku tła | Obniżenie hałasu ulicznego lub szumu klimatyzacji |
| Poprawa mowy | Poprawa zrozumiałości mowy | Ułatwienie słuchania cichego wywiadu |
| Separacja mowy | Wydobycie mowy ze zmieszanego sygnału | Izolowanie dialogu od muzyki lub tła dźwiękowego |
| Separacja mówiących | Nadanie każdemu mówiącemu odrębnej ścieżki | Rozdzielenie dwóch osób mówiących jedna przez drugą |
| Separacja wokalu | Rozdzielenie elementów muzycznych na stemy | Wydobycie wokalu z podkładu instrumentalnego |
Nasz Separator Mowy znajduje się po stronie izolacji mowy i usuwania szumów tła w tej tabeli. Jego zadaniem jest dostarczenie czystszej ścieżki głosowej, a strona produktu wymienia film, podcasty, wywiady, lektora i przygotowanie do klonowania głosu jako procesy, wokół których został zbudowany. Akceptuje popularne formaty audio, takie jak MP3, WAV i AAC, a także pliki wideo. Wiedza o tym, w której kolumnie się znajdujesz, uchroni cię przed oczekiwaniem stemów na poszczególnych mówiących od narzędzia dostrojonego do oczyszczania głosu z szumów.
Osiem zadań, do których ludzie zatrudniają separator mowy
Przypadki użycia nakładają się na siebie, ale każdy rozwiązuje nieco inny problem. Odczytywanie ich jako odrębnych zadań pomaga zdecydować, czy separacja jest właściwym pierwszym krokiem, czy też inne narzędzie powinno znaleźć się wcześniej w łańcuchu.
Czyszczenie nagrań z wywiadów. Wywiady rzadko odbywają się w pomieszczeniach z wygłuszeniem. Biura, ulice, wydarzenia i domy — wszędzie przenika dźwięk do ujęcia. Separacja redukuje to rozproszenie i ułatwia słyszenie rozmówcy, zanim przystąpisz do montażu, dodawania napisów czy dubbingu. Czego nie potrafi, to wymyślić mowy, która nigdy nie została uchwycona — jeśli mikrofon był zbyt daleko lub głośny zespół zagłuszył głos, może nie być nic czystego do odzyskania.
Poprawa dźwięku podcastu. Stukot klawiatury, wentylatory, syk i pogłos pomieszczenia — wszystko to zagłusza rozmowę. Czystsza ścieżka ułatwia późniejszą pracę: przycinanie pauz, wyważanie mówiących, wycinanie fragmentów i pisanie notatek do odcinka. Gdy kilka osób mówi jednocześnie, wyniki zależą w dużym stopniu od ilości nakładania się, a modele dostrojone do nakładających się mówiących mogą wprowadzać własne artefakty przetwarzania.
Przygotowanie dźwięku do zamiany mowy na tekst. Silniki transkrypcyjne działają najlepiej, gdy słowa są wyraźne, a zakłócenia niewielkie. Uruchomienie separacji na początku często poprawia transkrypcję, napisy lub przebieg generowania napisów. Nasze narzędzie Mowa na Tekst transkrybuje dźwięk i wideo oraz generuje napisy w wielu językach, a jego dokładność nadal zmienia się w zależności od jakości dźwięku, akcentów i warunków nagrywania. Traktuj separację jako krok przygotowawczy, a nie gwarancję: w niektórych przypadkach artefakty wynikające z poprawy mogą w rzeczywistości obniżyć dokładność rozpoznawania, więc w przypadku czegokolwiek ważnego warto porównać oczyszczoną i oryginalną ścieżkę.
Czyszczenie dialogu do postprodukcji wideo. Montażyści regularnie zmagają się z wiatrem, hałasem ulicznym, szumem, obsługą mikrofonu i przenikaniem muzyki tła. Użyteczną ścieżkę dialogową można następnie ponownie zmiksować z efektami lub zastępczym lektorem, a wynik często mówi ci, czy scenę da się uratować w postprodukcji, czy też potrzebuje świeżego nagrania. Agresywne przetwarzanie może usunąć naturalny ton pomieszczenia, więc profesjonalne wydania wciąż zasługują na ucho montażysty.
Poprawa materiału wejściowego do klonowania głosu. Model klonujący uczy się cech mówiącego z próbki, a szum, muzyka i pogłos to utrudniają. Czystszy materiał wejściowy zwykle daje lepszy wynik, dlatego przedstawiamy separację jako krok przygotowawczy do klonowania na stronie Separatora Mowy. Ma to największe znaczenie, gdy twoja jedyna próbka pochodzi z filmu z podkładem muzycznym, nagrania telefonicznego lub transmisji na żywo. Próbka musi być użyteczna pod względem prawnym i etycznym: przesyłaj tylko dźwięk, który posiadasz lub do którego przetwarzania masz pozwolenie, i uzyskaj zgodę mówiącego przed utworzeniem lub wdrożeniem klona.
Tworzenie wyraźniejszych lektorów. Gdy ponowne nagranie jest niewygodne, ale ujęcie narracyjne niesie umiarkowany szum, separacja może oczyścić je na tyle, aby nałożyć na wideo, połączyć z muzyką lub wykorzystać w krótkich formatach. Nie wygeneruje nowej narracji — jeśli ujęcie jest naprawdę nieużyteczne, lepiej pasuje droga zamiany tekstu na mowę lub klonowania głosu.
Wsparcie lokalizacji i dubbingu. Przed przetłumaczeniem filmu często chcesz mieć czystą ścieżkę dialogową, aby transkrybować, dodawać napisy i dubbingować, zachowując lub ponownie miksując tło. Oferujemy również Dubbing AI do lokalizacji treści, ale separacja i dubbing wykonują różne zadania: separacja oczyszcza źródłowy dźwięk, podczas gdy dubbing generuje mowę w innym języku.
Odzyskiwanie mowy z zaszumionych archiwów. Stare nagrania, webinary, zarejestrowane spotkania i materiały tworzone przez użytkowników czasem stają się wystarczająco zrozumiałe, aby je pojąć lub stworzyć zgrubną transkrypcję. W przypadku materiałów prawnych, medycznych, finansowych lub wrażliwych pod względem zgodności sprawdź wynik względem oryginału, ponieważ przetwarzanie AI może zmienić lub pominąć słowa.
Kiedy go użyć, a kiedy nagrać ponownie
Separacja sprawdza się, gdy głos jest obecny, ale zamaskowany umiarkowanymi zakłóceniami, gdy potrzebujesz czystszej ścieżki dialogowej do edycji, gdy poprawiasz materiał wejściowy przed transkrypcją lub klonowaniem, lub gdy ponowne nagranie po prostu nie jest praktyczne. Wspólnym mianownikiem jest to, że w pliku istnieje możliwa do odzyskania mowa.
Ma trudności, gdy głos jest wyjątkowo cichy lub niezrozumiały, gdy kilka osób nieustannie mówi jedna przez drugą, gdy muzyka całkowicie zagłusza głos, lub gdy nagranie niesie silne echo czy zniekształcenia. Jest to również niewłaściwe narzędzie, gdy potrzebujesz restauracji na poziomie kryminalistycznym lub nadawczym, lub gdy dokładność co do słowa jest niezbędna, a nikt nie przejrzy wyniku. Im poważniejsze zakłócenia, tym większe ryzyko słyszalnych artefaktów — a czynniki rzeczywiste, takie jak odległość mikrofonu, pogłos i wielu mówiących, obniżają wydajność separacji. Jeśli oryginalne ujęcie jest zniekształcone lub zagłuszone, świeże nagranie zwykle brzmi bardziej naturalnie niż cokolwiek, co możesz uratować.
Jak ocenić separator mowy, zanim się zdecydujesz
Dobierz narzędzie do konkretnego nagrania, które musisz naprawić, a nie do czystego klipu demonstracyjnego. Kilka kryteriów odróżnia dobre dopasowanie od frustrującego.
- Rodzaj separacji. Zdecyduj, czy potrzebujesz mowy z szumów, dialogu z muzyki, jednego mówiącego od drugiego, czy wokalu z podkładu instrumentalnego. Narzędzie stworzone do izolacji mowy może nie wyprodukować osobnej ścieżki dla każdego głosu w rozmowie.
- Formaty i limity wejściowe. Potwierdź, że narzędzie akceptuje twój plik źródłowy. Nasz Separator Mowy obsługuje pliki MP3, WAV, AAC i wideo; mimo to sprawdź maksymalny rozmiar pliku i formaty eksportu przed dużym projektem.
- Jakość dźwięku w rzeczywistych warunkach. Przetestuj próbkę zawierającą najgorsze tło w twoim projekcie, aby ocenić narzędzie na najtrudniejszym przypadku, a nie na najłatwiejszym.
- Artefakty wyjściowe. Wsłuchaj się w metaliczne tony, brakujące spółgłoski, poszarpane sylaby, przenikanie muzyki i drżenie podczas nakładającej się mowy. W przypadku ważnych treści porównaj przetworzony wynik z oryginałem i przejrzyj transkrypcję ręcznie.
- Kompatybilność z procesem pracy. Sprawdź, czego potrzebuje kolejny krok. Jeśli następuje transkrypcja, upewnij się, że wynik pobiera się w użytecznym formacie; jeśli następuje klonowanie lub dubbing, potwierdź, że pliki przechodzą dalej bez bezsensownej konwersji.
- Prywatność i zgoda. Dźwięk może zawierać dane osobowe lub rozpoznawalne głosy. Potwierdź, że masz pozwolenie na jego przesłanie i przetworzenie, i traktuj próbki do klonowania ze szczególną ostrożnością, ponieważ oczyszczona próbka ułatwia odtworzenie głosu.
Jak separacja wpisuje się w proces lokalizacji DubSmart
Separacja rzadko działa samodzielnie. To warstwa oczyszczania na początku dłuższego łańcucha, a otaczające narzędzia decydują o tym, ile wartości dodaje. Dla twórcy lokalizującego wywiad rozsądna sekwencja wygląda następująco:
- Uruchom Separator Mowy, aby wyizolować i oczyścić dialog.
- Wyślij oczyszczony dźwięk do zamiany mowy na tekst, aby uzyskać edytowalną transkrypcję.
- Przejrzyj nazwiska, terminy techniczne, liczby i wszelkie niejasne fragmenty.
- Przetłumacz lub zaadaptuj zatwierdzony tekst.
- Wygeneruj dubbingowany lub narrowany dźwięk za pomocą odpowiedniego procesu głosowego.
- Porównaj ostateczny dźwięk z oryginałem pod kątem znaczenia, tonu i synchronizacji.
Ten schemat pasuje zarówno do kanałów YouTube, podcastów, kursów online, filmów marketingowych, jak i filmów niezależnych. Separator zajmuje się jednym zadaniem, w którym jest dobry; nie zastępuje transkrypcji, tłumaczenia, montażu ani zarządzania zgodami. Gdy utrzymujesz te role osobno, każde narzędzie otrzymuje właściwy materiał wejściowy, a gotowy wynik się broni.
Najczęściej zadawane pytania
Czy separator mowy może usunąć muzykę w tle?
Może zredukować muzykę w tle lub wyizolować od niej mowę, ale wynik zależy od tego, jak głośna, złożona i podobna do głosu jest muzyka. Zawsze wsłuchaj się w przenikanie muzyki i artefakty mowy, zanim zdasz się na wynik.
Czy separacja mowy może poprawić transkrypcję?
Zwykle tak — oczyszczenie zakłóceń ułatwia silnikowi transkrypcyjnemu odczyt mowy. Jednak poprawa może sporadycznie wprowadzać artefakty szkodzące dokładności, więc ważne transkrypcje nadal wymagają przeglądu przez człowieka.
Czy mogę użyć separatora mowy przed klonowaniem głosu?
Tak. Czystsza próbka daje modelowi klonującemu lepszy materiał wejściowy. Używaj tylko dźwięku, który posiadasz lub do którego przetwarzania masz pozwolenie, i uzyskaj zgodę mówiącego przed utworzeniem lub wdrożeniem klona.
Czy rozdziela dwie osoby mówiące jednocześnie?
Niektóre systemy separacji mowy podejmują taką próbę, ale nakładający się mówiący są znacznie trudniejsi niż zwykłe usuwanie szumów. Wyniki różnią się w zależności od jakości mikrofonu, podobieństwa mówiących, pogłosu pomieszczenia i tego, jak bardzo głosy się nakładają.
Czy separator mowy to to samo co zmieniacz głosu?
Nie. Separator oczyszcza lub izoluje mowę, która już istnieje. Zmieniacz głosu przekształca tożsamość wokalną mówiącego. Separacja różni się także od zamiany mowy na tekst, tekstu na mowę, klonowania głosu i dubbingu AI — pokrewnych narzędzi, które rozwiązują różne problemy.