Jeśli Twój mikrofon rejestruje ruch uliczny, gwar kawiarni lub podkład muzyczny leżący dokładnie na dialogu, pytanie nie brzmi, czy nagranie nadaje się do użytku — lecz jak czysto wydobyć z niego głos. Dokładnie to robi separator mowy. Mówiąc prosto, separator mowy to narzędzie audio oparte na sztucznej inteligencji, które izoluje ludzką mowę od wszystkiego innego w nagraniu — szumu tła, muzyki i innych dźwięków — dzięki czemu zostaje Ci czysta ścieżka głosowa, którą możesz transkrybować, dubbingować, klonować lub remiksować. Dla każdego, kto tworzy treści wielojęzyczne, ta czysta ścieżka stanowi różnicę między dubbingiem, który brzmi profesjonalnie, a takim, który brzmi „wystarczająco dobrze".
Ten przewodnik wyjaśnia, czym właściwie jest separator mowy, jak działa od podszewki, kiedy naprawdę go potrzebujesz oraz co rozważyć przed wyborem konkretnego narzędzia. Wbudowaliśmy Separator Mowy w przepływ pracy DubSmart AI właśnie dlatego, że czysta mowa to fundament, na którym opiera się cała reszta.
Spis treści
Czym naprawdę jest separator mowy
W badaniach nad dźwiękiem separacja mowy jest definiowana jako zadanie oddzielenia docelowej mowy od zakłóceń tła w miksowanym nagraniu. Bardziej zaawansowane systemy idą dalej i rozdzielają wielu mówców od siebie nawzajem, tworząc odizolowaną ścieżkę dla każdego głosu.
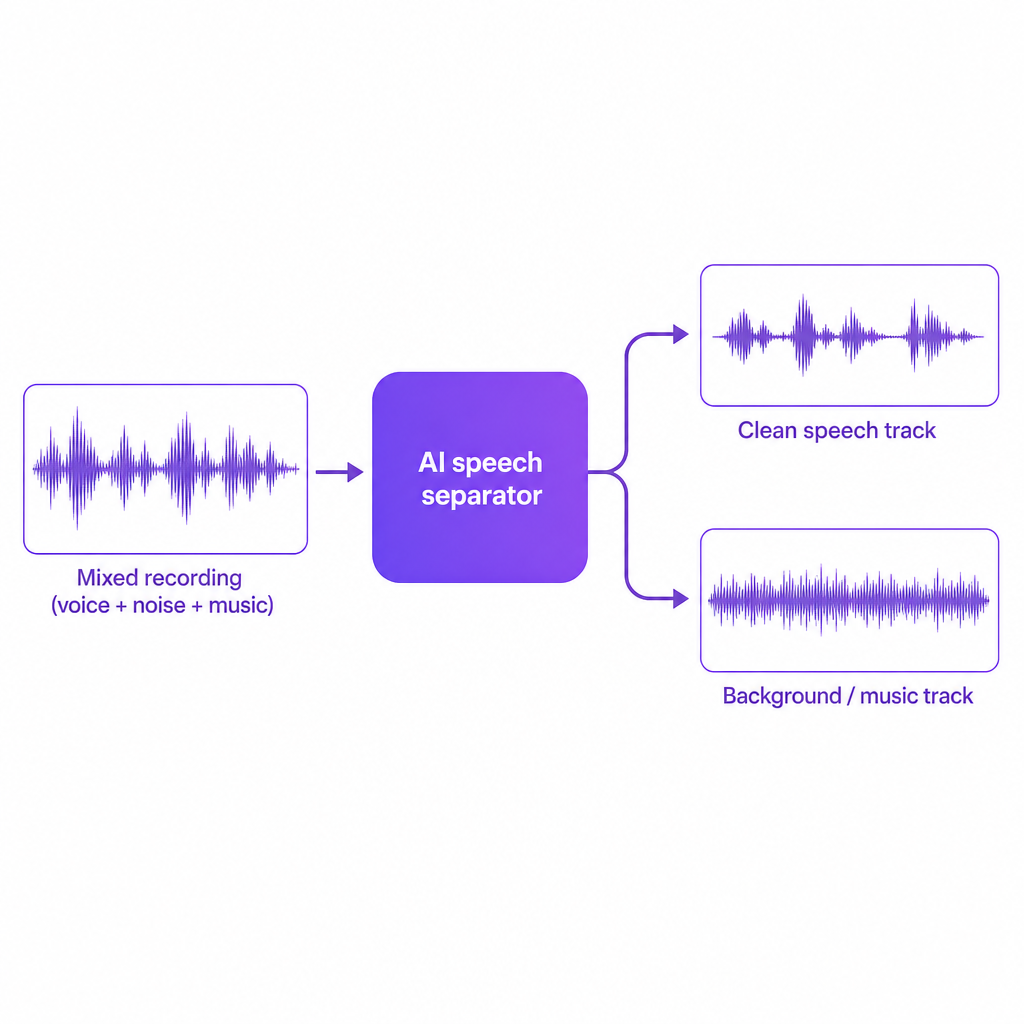
Przełożone na codzienną pracę produkcyjną, separator mowy bierze miksowany plik audio — dialog plus szum lub muzyka — i wypuszcza jedną lub więcej ścieżek zawierających wyłącznie mowę, plus opcjonalną ścieżkę z pozostałym dźwiękiem tła. Nasz Separator Mowy został zbudowany, aby usuwać szum tła i izolować mowę z dowolnego nagrania, co czyni go idealnym do postprodukcji filmów, podcastów i wywiadów. Działa zarówno na plikach audio, jak i wideo: potrafi odszumiać nagrania z głośnych otoczeń i oddzielać wokal od podkładu, dzięki czemu otrzymujesz osobne ścieżki (stemy) głosu i tła.
W tym miejscu ludzie często wpadają w powszechne nieporozumienie. Separator mowy to nie to samo, co tradycyjna redukcja szumu. Redukcja szumu obniża głośność niepożądanego dźwięku. Separator mowy aktywnie identyfikuje, gdzie w sygnale występuje mowa, i rekonstruuje ją jako osobny, czystszy strumień. To rozróżnienie sprawia, że separator potrafi uratować głos pogrzebany pod muzyką, podczas gdy bramka szumu głównie po prostu wycisza całe nagranie.
Czy naprawdę go potrzebujesz?
Prawdziwa decyzja dotyczy tego, czy Twoja praca zależy od niezawodnego, czystego dźwięku mowy, a nie od tego, co akurat zarejestrował mikrofon. Jeśli tak, dedykowany separator przestaje być miłym dodatkiem, a staje się podstawowym krokiem.
Kilka sytuacji sprawia, że ten upgrade staje się oczywisty. Twórcy YouTube i małe firmy często wykorzystują ponownie starsze materiały nagrane w pomieszczeniach z echem, kawiarniach lub na ulicy, gdzie szum utrudnia zrozumienie i transkrypcję mowy. Zespoły e-learningowe i szkoleniowe budują wielojęzyczne kursy z webinarów i wykładów na żywo, gdzie każda kolejna transkrypcja i dubbing dziedziczy jakość oryginalnej mowy. Filmowcy i producenci podcastów często muszą uratować świetne wykonanie zarejestrowane w niedoskonałych warunkach, zanim zmiksują je z powrotem z muzyką i sound designem. A programiści lub agencje wprowadzające dźwięk użytkowników do potoków transkrypcji, klonowania głosu czy dubbingu wiedzą, że zaszumione dane wejściowe bezpośrednio obniżają dokładność modeli.
Kilka konkretnych sygnałów wskazuje, że warto sięgnąć po separator:
- Lokalizujesz treści na wiele języków i chcesz spójnego, wyraźnego dubbingu oraz napisów. Czysta mowa zasila nasze silniki Dubbingu AI i Mowy na Tekst znacznie bardziej niezawodnie niż zaszumiony miks.
- Polegasz na klonowaniu głosu dla marki lub głosu postaci i chcesz uzyskać najlepsze możliwe efekty, trenując na odszumionych, wolnych od artefaktów próbkach.
- Regularnie otrzymujesz nagrania tworzone przez użytkowników lub nagrania terenowe, których nie kontrolowałeś, a mimo to musisz je przygotować do emisji. Separator daje Ci powtarzalny etap czyszczenia zamiast ręcznego dostrajania każdego pliku.
Uczciwy wyjątek: jeśli Twój dźwięk jest już nagrany w wyciszonym studiu, z osobnymi stemami dla dialogu i muzyki, separator jest wygodą, a nie koniecznością. Dla wszystkich innych pracujących z dźwiękiem z realnego świata zdobywa on stałe miejsce w potoku produkcyjnym.
Jak separacja mowy działa od podszewki
Nowoczesna separacja mowy opiera się na głębokim uczeniu i badaniach nad separacją źródeł, a nie na prostym korektorze (EQ) i filtrach. Zadanie leżące u podstaw jest łatwe do sformułowania i trudne do rozwiązania: mając miksowany sygnał zawierający kilka źródeł, odzyskać poszczególne sygnały mowy bez uprzedniej ich znajomości.
Większość obecnych systemów działa według potoku enkoder–separator–estymator–dekoder. Enkoder mapuje surowy przebieg fali lub spektrogram do wysokowymiarowej przestrzeni cech, gdzie łatwiej wykryć wzorce istotne dla mowy, takie jak formanty i harmoniczne. Separator — sieć neuronowa — przetwarza te cechy i uczy się rozdzielać informacje należące do różnych źródeł dźwięku, czy to mowa kontra szum, czy jeden mówca kontra inny. Etap estymacji następnie albo przewiduje maski, które odfiltrowują komponenty niebędące mową, albo bezpośrednio szacuje reprezentację cech każdego źródła. Wreszcie dekoder konwertuje te oddzielone reprezentacje z powrotem na dźwięk w dziedzinie czasu, dając jedną lub więcej czystych ścieżek mowy i opcjonalnie ścieżkę resztkowego tła.
Modele te są trenowane na dużych zbiorach danych pełnych mieszanek mowy i szumu, ucząc się rozróżniających wzorców mowy, mówców i zakłóceń na oznaczonych przykładach. Nowsze badania warunkują separator osadzeniami mówcy (speaker embeddings) lub podpowiedziami (promptami), co umożliwia wycelowanie separacji w konkretny głos w zatłoczonym dźwięku.
Praktyczny wniosek dla twórców jest taki, że nowoczesny separator to nie wypasiona bramka szumu. To model, który nauczył się, jak mowa wygląda i brzmi w wielu warunkach, i potrafi zrekonstruować głos nawet wtedy, gdy jest on pogrzebany pod muzyką, gwarem tłumu czy echem pomieszczenia.
Dwa główne zadania separacji
W praktyce spotkasz dwa rodzaje separacji mowy, a platformy często je łączą.
Pierwszym jest mowa pojedynczego mówcy kontra tło: wydobycie jednej spójnej ścieżki głosowej z szumu, muzyki lub ambientu. To zadanie, na którym koncentruje się nasz Separator Mowy w przypadku filmów, podcastów i wywiadów, ponieważ odpowiada bezpośrednio temu, czego większość twórców potrzebuje na co dzień.
Drugim jest separacja wielu mówców, gdzie system tworzy osobną ścieżkę dla każdego mówcy w rozmowie. Jest to szczególnie przydatne przy diaryzacji i analityce długich spotkań lub dyskusji panelowych, gdzie wiedza o tym, kto co powiedział, ma równie duże znaczenie jak to, co zostało powiedziane.
Narzędzia konsumenckie zwykle pakują je w proste interfejsy — prześlij piosenkę, aby uzyskać osobne ścieżki wokalną i instrumentalną, lub wyizoluj dialog w wideo do montażu. Nasza implementacja kładzie nacisk na separację mowy od tła, ponieważ jest to najbardziej bezpośrednio wartościowe zadanie w przepływach dubbingu, transkrypcji i klonowania.
Co rozważyć przed wyborem separatora
Gdy oceniasz, czy separator spełnia profesjonalne potrzeby, kilka kryteriów liczy się bardziej niż tekst marketingowy.
Zacznij od jakości mowy i artefaktów. Dobry separator zachowuje naturalną barwę głosu, zamiast sprawiać, że brzmi metalicznie, jak spod wody czy fazowo, i unika wprowadzania szumu muzycznego lub ostrych zniekształceń podczas usuwania silnych elementów tła, takich jak muzyka. Przeglądy akademickie wskazują na resztkowe zakłócenia i artefakty jako główne wyzwania, zwłaszcza przy niestacjonarnym szumie. Najbardziej niezawodnym testem wciąż pozostaje sprawdzenie próbek wyjściowych na własnym materiale.
Następna jest odporność na szum z realnego świata. Modele trenowane na czystych danych laboratoryjnych mogą mieć trudności z ruchem ulicznym, wiatrem, szmerem tłumu, pogłosowymi pomieszczeniami oraz treściami, gdzie mowa nakłada się na głośną muzykę lub efekty. Najnowocześniejsze prace celują dokładnie w te złożone mieszanki, ale wydajność wciąż różni się w zależności od warunków nagrania — więc testuj w środowiskach, w których faktycznie nagrywasz, od biur po ulice i domowe studia.
Obsługa muzyki i treści mieszanych to częsta, konkretna potrzeba. Usunięcie ścieżki dźwiękowej do ponownego dubbingu lub wyizolowanie narracji z ujęć B-roll wymaga narzędzia, które wyraźnie wspiera separację muzyki i głosu oraz wypuszcza dwa użyteczne pliki, a nie jeden stłumiony wynik. Nasz potok separacji wykrywa częstotliwości wokalne, izoluje je od muzyki i tworzy osobne pliki wysokiej jakości: jeden z czystym wokalem i jeden z podkładem muzycznym. Jest to szczególnie przydatne, gdy planujesz remiks, ponowne udźwiękowienie lub ponowny dubbing na inne języki.
Integracja z narzędziami downstream decyduje o tym, ile czasu separator faktycznie oszczędza. Separacja rzadko funkcjonuje samotnie — zasila modele transkrypcji, gdzie czystsze dane wejściowe obniżają współczynnik błędów słów, silniki klonowania głosu, które nagradzają próbki wolne od szumu, oraz systemy dubbingu, które dopasowują oryginalną mowę do przetłumaczonych ścieżek. Nasza platforma jest zbudowana wokół jednolitego przepływu pracy, który utrzymuje Separator Mowy, Mowę na Tekst, Tekst na Mowę, Klonowanie Głosu i Dubbing AI w jednym miejscu, dzięki czemu pojedyncze wyczyszczone nagranie może stać się wielojęzyczną, sklonowaną głosem, w pełni zlokalizowaną treścią bez odbudowywania potoku za każdym razem.
Opóźnienie, skala i automatyzacja mają znaczenie dla każdego, kto ma zaległości. Długie podcasty, kursy i archiwa potrzebują przetwarzania wsadowego, które obsługuje wielogodzinne pliki, rozsądnych czasów przetwarzania na plik oraz haków automatyzacji, gdzie separacja mieści się wewnątrz Twoich własnych systemów. Udostępniamy API Tekst na Mowę, Klonowania Głosu i Dubbingu AI, aby programiści mogli wpiąć przetwarzanie mowy w potoki end-to-end.
Wreszcie, prywatność i zgodność z przepisami nie znikają, gdy dźwięk staje się czysty. Oddzielenie mowy od tła nie zdejmuje z Ciebie odpowiedzialności za nagrania, które mogą zawierać wrażliwe rozmowy, ani za poszanowanie praw, gdy wydobywasz i ponownie wykorzystujesz głosy z licencjonowanych materiałów. Zespoły korporacyjne powinny potwierdzić jasne zasady dotyczące przechowywania i wykorzystania danych oraz dostosować każdy przepływ separacji do wewnętrznych wytycznych zgodności.
Gdzie zawodzi
Separator mowy potrafi przekształcić nagranie, ale nie jest magią, a udawanie, że jest inaczej, prowadzi do złych decyzji.
Nadmierne odszumianie to najczęstsza pułapka. Agresywna separacja może usunąć subtelne wskazówki mowy — miękkie spółgłoski, naturalny ton pomieszczenia — i pozostawić głos brzmiący nienaturalnie lub męcząco w odbiorze. Resztkowe artefakty to druga strona medalu: w trudnych warunkach model może pozostawić ślady muzyki lub szumu w ścieżce mowy albo generować szum muzyczny, szczególnie gdy zakłócenia są silne i nieustannie się zmieniają.
Trzeba też uwzględnić stronniczość wobec mówcy i języka. Modele trenowane głównie na określonych językach, akcentach lub stylach mówienia mogą radzić sobie gorzej z niedostatecznie reprezentowanymi głosami. A czysto wyglądający przebieg fali może stworzyć fałszywe poczucie bezpieczeństwa: nie gwarantuje, że dźwięk nadaje się do krytycznych zadań, takich jak analiza kryminalistyczna czy rygorystyczne konteksty zgodności.
W pracy twórczej i lokalizacyjnej te ograniczenia są do opanowania, ale stanowią silny argument za testowaniem na reprezentatywnych próbkach własnego materiału, zamiast ufać dema dostawców.
Separator Mowy w naszym przepływie pracy
Traktujemy Separator Mowy jako praktyczną, przyjazną twórcom implementację tej technologii, ściśle zintegrowaną z resztą platformy DubSmart AI, a nie doczepioną na siłę.
W użyciu usuwa on szum tła i izoluje mowę z dowolnego nagrania, tworząc czysty głos odpowiedni do postprodukcji filmów, podcastów i wywiadów. Wydobywa wyraźny wokal z miksowanych ścieżek i generuje osobne pliki wysokiej jakości dla mowy i muzyki tła, dzięki czemu możesz montować, ponownie dubbingować lub remiksować bez walki z oryginalnym miksem. Działa zarówno na źródłach audio, jak i wideo — przesyłasz pliki lub używasz linków, przepuszczasz je przez potok i pobierasz gotowe ścieżki. I co kluczowe, te wyniki są zoptymalizowane pod kątem zasilania naszych pozostałych narzędzi, więc jedno wyczyszczone nagranie może zostać zamienione w wielojęzyczną, sklonowaną głosem, w pełni zlokalizowaną treść.
Dla twórców YouTube, małych firm, trenerów, filmowców, podcasterów i zespołów programistycznych ta integracja zmienia samą rolę separacji. Przestaje być odizolowanym obowiązkiem „napraw dźwięk", a staje się pierwszym ustandaryzowanym krokiem w większym, zautomatyzowanym cyklu życia tworzenia i lokalizacji treści. Jeśli budujesz wielojęzyczny kanał lub bibliotekę kursów, to właśnie tam kumulują się prawdziwe oszczędności czasu.
Najczęściej zadawane pytania
Czym jest separator mowy, mówiąc prosto?
To narzędzie AI, które bierze zaszumione, miksowane nagranie i wypuszcza ścieżkę, gdzie słyszysz głównie tylko ludzki głos, plus opcjonalne ścieżki tła, które możesz zachować lub odrzucić.
Czy separator mowy to to samo co redukcja szumu?
Nie. Redukcja szumu po prostu obniża niepożądane dźwięki. Separacja mowy wyraźnie identyfikuje i rekonstruuje mowę jako odrębne źródło, zazwyczaj z wyższą klarownością i większą kontrolą nad wynikiem.
Czy separator mowy poradzi sobie z więcej niż jednym mówcą?
Wiele systemów klasy badawczej i niektóre produkty potrafią rozdzielić wielu mówców na indywidualne ścieżki, choć jakość różni się w zależności od nakładania się i warunków nagrania. Nasz Separator Mowy koncentruje się przede wszystkim na izolowaniu mowy od tła w typowych przepływach pracy twórców.
Czy użycie separatora mowy poprawi moje wyniki dubbingu i klonowania głosu?
Tak. Czystszy dźwięk wejściowy zazwyczaj poprawia rozpoznawanie mowy, dopasowanie i jakość klonowania głosu, co sprawia, że wielojęzyczny dubbing i sklonowane głosy są bardziej naturalne i spójne.
Czy separacja mowy działa niezależnie od języka?
Większość modeli separatorów operuje na wzorcach akustycznych, a nie na tekście, więc mogą obsługiwać wiele języków. Wydajność wciąż zależy od danych treningowych i tego, jak dobrze reprezentowany jest Twój akcent.