Zmieniacz głosu AI działający w czasie rzeczywistym przekształca Twój głos w inny głos podczas mówienia, przechwytując dźwięk z mikrofonu, analizując go, zmieniając tożsamość mówcy i odtwarzając przekonwertowany dźwięk z krótkim opóźnieniem. W przeciwieństwie do podstawowego filtra zmieniającego wysokość dźwięku, może zachować znaczną część Twoich słów, rytmu i ekspresji, zmieniając jednocześnie takie cechy jak barwa, postrzegany wiek, prezentacja płci czy styl postaci. A w przeciwieństwie do syntezy mowy, zaczyna od żywej mowy, a nie wpisanego tekstu.
Prawdziwa decyzja dla twórców, streamerów, edukatorów i firm nie polega po prostu na tym, czy wynik brzmi realistycznie. Chodzi o to, czy narzędzie pasuje do Twojego typu wejścia, tolerancji opóźnień, potrzeb kontroli głosu, integracji, zobowiązań prawnych i docelowej jakości produkcji. Ten przewodnik wyjaśnia, jak działa ta technologia, jak wypada na tle powiązanych narzędzi głosowych AI oraz kiedy nagrywany proces lepiej Ci posłuży.
Spis treści
Co tak naprawdę oznacza „czas rzeczywisty”
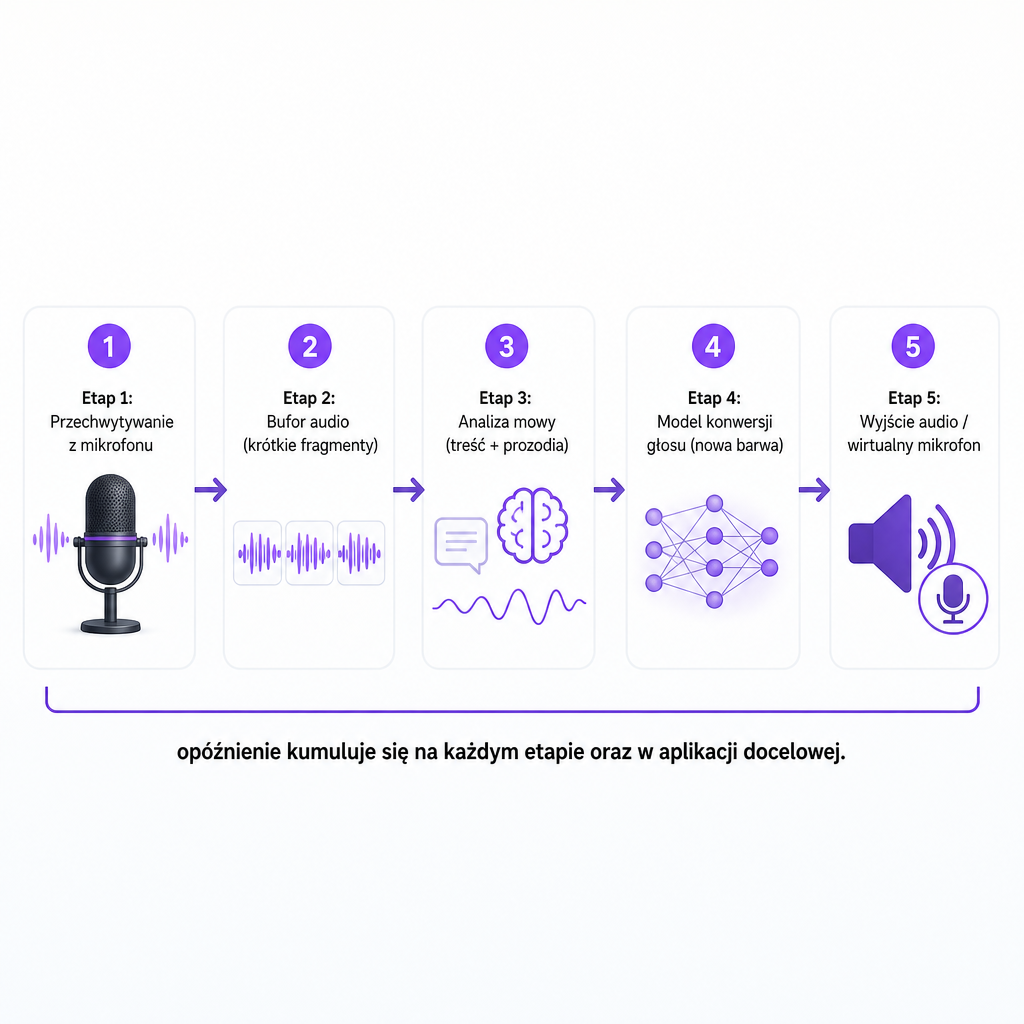
„Czas rzeczywisty” oznacza, że system przetwarza przychodzący strumień audio podczas mówienia, zamiast czekać na kompletne nagranie lub gotowy scenariusz. Sygnał przebywa ciągłą ścieżkę: mikrofon, bufor audio, analiza mowy, model konwersji głosu, wyjście audio. Ponieważ konwerter pracuje na krótkich segmentach, a nie na pełnych zdaniach, strumieniowa konwersja głosu jest technicznie różna od renderowania gotowego lektora, w którym cały scenariusz jest znany z wyprzedzeniem.
Pewne opóźnienie jest nieuniknione. System potrzebuje czasu na przechwycenie, analizę, syntezę i wyprowadzenie każdego fragmentu dźwięku. Badania pokazują, że konwersja o niskim opóźnieniu jest osiągalna, choć liczby zależą w dużym stopniu od modelu, sprzętu, rozmiaru bufora i jakości dźwięku. Model badawczy LLVC raportuje opóźnienie poniżej 20 milisekund na konsumenckim procesorze CPU, podczas gdy StreamVC raportuje opóźnienie całościowe wynoszące 70,8 milisekundy w swoim środowisku ewaluacyjnym. Są to wyniki badawcze uzyskane w określonych warunkach, a nie gwarancje wydajności dla jakiegokolwiek komercyjnego narzędzia, które możesz pobrać.
Jak działa zmieniacz głosu AI w czasie rzeczywistym
Proces przebiega jako pętla podczas mówienia, a nie jako pojedyncze renderowanie. Zrozumienie czterech etapów pomaga ocenić, dlaczego jedno narzędzie brzmi naturalnie, a inne robotycznie lub z opóźnieniem.
Po pierwsze, system przechwytuje Twoją mowę. Odbiera dźwięk z mikrofonu lub innego wejścia na żywo i dzieli go na krótkie fragmenty, aby model mógł przetwarzać go w sposób ciągły. Jakość wejścia ma większe znaczenie, niż wielu użytkowników się spodziewa. Szum tła, echo pomieszczenia, stukanie klawiatury, przesterowanie i niestabilny sygnał — wszystko to popycha konwersję w stronę nienaturalnych artefaktów.
Po drugie, oddziela treść mowy od tożsamości mówcy. Głos niesie jednocześnie kilka nakładających się warstw: treść językową, czyli słowa; prozodię, oznaczającą rytm, akcent i intonację; wysokość dźwięku; barwę, która sprawia, że głos jest rozpoznawalny; oraz szerszą tożsamość mówcy. Systemy konwersji starają się zachować treść i ekspresję, zastępując jednocześnie cechy mówcy. Współczesne badania nad strumieniowaniem opisują to jako zachowanie treści i prozodii mowy źródłowej przy jednoczesnym dopasowaniu barwy głosu docelowego mówcy. To rozdzielenie jest powodem, dla którego dobry konwerter pozwala mówić spontanicznie przekształconym głosem, zamiast rozmazywać stały filtr „robota” na przebieg fali.
Po trzecie, model syntetyzuje nowy głos. Rekonstruuje dźwięk, korzystając z profilu głosu docelowego, którym może być wbudowana postać, głos z biblioteki, niestandardowy głos utworzony z autoryzowanych nagrań lub profil zaprojektowany do anonimizacji, a nie imitacji. Wyjście jest tworzone w sposób ciągły z niewielkim buforem wyprzedzającym. Większy kontekst może poprawić stabilność, ale też zwiększa opóźnienie, co jest kluczowym kompromisem konwersji na żywo.
Po czwarte, przekonwertowany sygnał jest kierowany do aplikacji. Narzędzie desktopowe zazwyczaj udostępnia wyjście jako wirtualny mikrofon, więc inne programy odbierają je tak, jakby był zwykłym mikrofonem. To właśnie takie przekierowanie umożliwia transmisje na żywo, gry online, rozmowy wideo, czaty głosowe i wydarzenia wirtualne. Zmieniacz działający w czasie rzeczywistym musi więc działać na poziomie systemu operacyjnego i aplikacji, a nie tylko wewnątrz modelu. Zgodność z oprogramowaniem do streamingu, Discordem, Zoomem, przeglądarkami i urządzeniami mobilnymi może mieć takie samo znaczenie jak surowa jakość głosu. Jeśli chcesz wydobyć czysty tekst z tego samego przechwyconego dźwięku do napisów lub ponownego wykorzystania, osobny krok zamiany mowy na tekst obsługuje transkrypcję, a nie konwersję.
Konwersja w czasie rzeczywistym a powiązane narzędzia głosowe AI
Te technologie nakładają się na siebie w wyobraźni ludzi, ale rozwiązują naprawdę różne problemy. Poniższa tabela wyjaśnia, co każda z nich przyjmuje jako wejście i kiedy pojawia się wynik.
| Technologia | Wejście | Czas wyjścia | Najlepiej dopasowane do |
|---|---|---|---|
| Zmieniacz głosu w czasie rzeczywistym | Mowa z mikrofonu na żywo | Podczas rozmowy | Rozmowy na żywo, gry, streaming, występy |
| Synteza mowy | Tekst pisany | Po przesłaniu tekstu | Narracja, tutoriale, reklamy, e-learning |
| Klonowanie głosu | Próbki głosu | Generowane na żądanie | Wielokrotnego użytku syntetyczny głos do narracji lub dubbingu |
| Dubbing AI | Istniejące audio lub wideo | Po przetworzeniu | Tłumaczenie i lokalizacja nagranej treści |
| Efekt wysokości dźwięku lub formantów | Audio na żywo lub nagrane | Na żywo lub prawie na żywo | Prosta kreatywna modyfikacja głosu |
To rozróżnienie jest praktyczne, a nie akademickie. Platforma może oferować silne generowanie głosu AI lub klonowanie głosu bez udostępniania zmieniacza głosu na żywo z mikrofonu do rozmów i transmisji. Nasze własne narzędzia skupiają się na mediach generowanych i lokalizowanych: oferujemy Syntezę Mowy, Klonowanie Głosu, Dubbing AI, Zamianę Mowy na Tekst, Separator Mowy, Zamianę Tekstu na Obraz oraz Zamianę Obrazu na Wideo w jednym procesie. Są one zaprojektowane do tworzenia audio z tekstu lub budowania wielokrotnego użytku głosu do generowanej treści, więc należą do strony nagrywanego procesu z tej tabeli, a nie do konwersji na żywo z mikrofonu.
Do czego nadaje się konwersja głosu na żywo
Streamerzy i gracze sięgają po konwersję głosu, aby utrzymać postać, chronić prywatność lub zachować spójną personę kanału. Niskie opóźnienie ma tu największe znaczenie, ponieważ reagujesz na innych graczy i rozmawiasz z widownią. Niewielkie opóźnienie jest tolerowalne w monologu w stylu transmisji, ale staje się rażące podczas szybkich przekomarzań, rozgrywki konkurencyjnej czy komediowego wyczucia czasu.
W spotkaniach online i wydarzeniach wirtualnych przekonwertowany głos może wspierać odgrywanie ról, demonstracje, scenariusze dostępności lub udział dbający o prywatność. W kontekstach profesjonalnych zrozumiałość i niezawodność powinny przewyższać nowość, a uczestnicy powinni być poinformowani, gdy głos jest przekształcony, jeśli milczenie mogłoby ich wprowadzić w błąd.
Występ postaci to kolejne zastosowanie na żywo. Niezależni filmowcy, twórcy gier i podcasterzy mogą przesłuchiwać głosy postaci lub wykonywać tymczasowe dialogi na bieżąco. W przypadku ostatecznej wersji jednak nagrany lektor AI lub ludzki występ zwykle daje lepszą kontrolę nad edycją i spójność między sesjami.
Prywatność głosu i anonimizacja to odrębny cel od imitacji. Anonimizacja próbuje ukryć, kto mówi, podczas gdy imitacja próbuje odtworzyć konkretną tożsamość docelową. Żadna z nich nie jest niezawodna, a przekształcony głos nadal może ujawniać nawyki mowy, sformułowania lub dźwięki tła, które pomagają zidentyfikować mówcę.
Wreszcie technologia syntetycznego głosu wspiera dostępność i komunikację wspomagającą dla osób, które utraciły zdolność mowy. Federalna Komisja Handlu uznaje tę korzyść medyczną i w zakresie dostępności, ostrzegając jednocześnie, że replikacja głosu może być nadużywana do oszustw i niewłaściwego wykorzystania danych biometrycznych.
Kryteria decyzyjne, które naprawdę mają znaczenie
Opóźnienie jest na pierwszym miejscu i powinieneś pytać o zmierzone opóźnienie całościowe, a nie tylko o szybkość wnioskowania modelu. Opóźnienie, które faktycznie odczuwasz, obejmuje przechwytywanie z mikrofonu, buforowanie, ekstrakcję cech, wnioskowanie modelu, syntezę, przekierowanie wyjścia i to, co dodaje aplikacja do rozmów lub streamingu. Model, który w izolacji osiąga dobre wyniki benchmarków, może wydawać się powolny po złożeniu całej ścieżki.
Naturalność to kolejny test. Nasłuchuj metalicznych artefaktów, nagłych skoków tonalnych, problemów z oddechem i wymową, nienaturalnych pauz, zniekształconych spółgłosek, zakłóceń na granicach zdań oraz utraty ekspresji emocjonalnej. Przekonujący głos powinien pozostać zrozumiały podczas spontanicznej mowy, a nie tylko podczas starannie przeczytanych linii demonstracyjnych.
Zachowanie treści mowy łatwo przeoczyć, dopóki nie zawiedzie. Przetestuj szybką mowę, przerwania, liczby, imiona, akcenty, śmiech, pytania i zmiany głośności. Narzędzie, które zmienia tożsamość, ale spłaszcza Twój rytm i intonację, słabo pasuje do występu lub interakcji na żywo.
Wybór głosu i personalizacja decydują o tym, jak bardzo możesz ukształtować wynik. Sprawdź wbudowane głosy, tworzenie niestandardowych głosów, kontrolę wysokości i tonu, opcje emocji lub stylu, wybory akcentu, spójność między sesjami oraz wszelkie ograniczenia użytku komercyjnego. Tworzenie niestandardowego głosu powinno zawsze wymagać wyraźnej autoryzacji: próbka głosu nie jest zgodą na imitowanie osoby, od której pochodzi.
Obsługa sprzętu i platform decyduje o tym, czy narzędzie w ogóle pasuje do Twojej konfiguracji. Potwierdź, czy działa lokalnie na CPU lub GPU, w przeglądarce, przez aplikację desktopową, na urządzeniu mobilnym, przez wirtualny mikrofon czy przez API. Przetwarzanie w chmurze może uprościć konfigurację, ale wprowadza opóźnienie sieciowe i kwestie zarządzania danymi, podczas gdy przetwarzanie lokalne może zmniejszyć opóźnienie sieciowe, ale wymaga bardziej wydajnego sprzętu. Osobno zweryfikuj przekierowanie dźwięku: silny model jest bezużyteczny, jeśli jego wyjścia nie można wybrać jako mikrofonu w zamierzonej aplikacji.
Obsługa danych zamyka listę. Przed przesłaniem jakichkolwiek próbek głosu sprawdź, czy nagrania są przechowywane, czy zasilają ulepszanie modelu, jak usuwane są niestandardowe głosy, kto ma dostęp do plików, czy istnieją kontrole biznesowe lub korporacyjne oraz co dzieje się później z generowanym dźwiękiem. Nagrania głosu mogą być wrażliwymi danymi osobowymi lub związanymi z biometrią w zależności od kontekstu i obowiązującego prawa, więc traktuj je w ten sposób.
Kiedy nagrywany proces wygrywa z czasem rzeczywistym
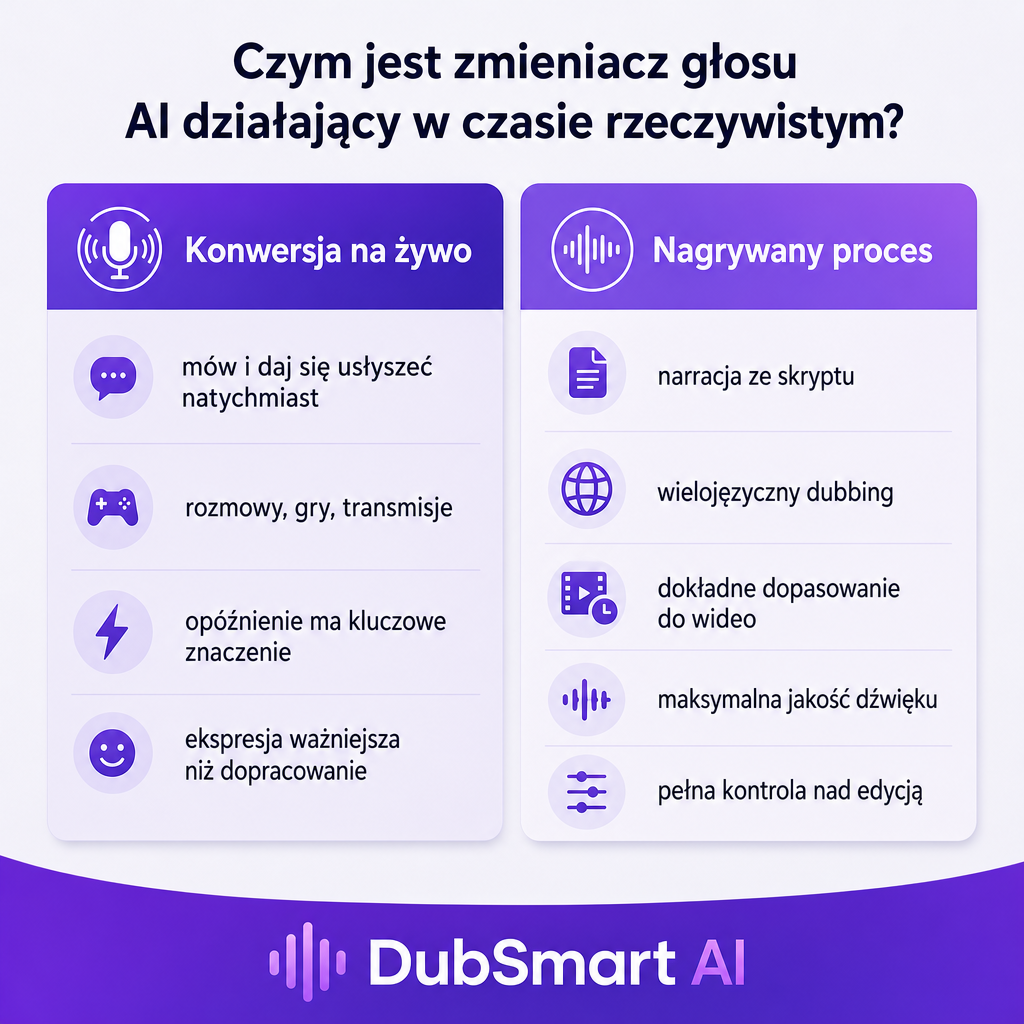
Konwersja na żywo jest właściwym wyborem, gdy osoba musi mówić naturalnie i aby przekształcony głos został usłyszany natychmiast. Jest złym wyborem, gdy Twoim priorytetem jest maksymalna jakość dźwięku, precyzyjna wymowa, wielojęzyczna narracja, dokładne dopasowanie czasowe do wideo, szczegółowa edycja, spójny komercyjny lektor czy wysokiej jakości dubbing.
Dla tych celów wygrywa nagrywany proces. Przy syntezie mowy kontrolujesz i dopracowujesz scenariusz przed wygenerowaniem jakiegokolwiek dźwięku, co całkowicie eliminuje problem opóźnień na żywo. Przy dubbingu AI system przetwarza istniejące wideo i dopasowuje przetłumaczoną mowę do źródła, czego żaden zmieniacz na żywo nie potrafi. Jeśli Twój plik źródłowy miesza dialog z muzyką lub szumem, separator mowy może wyizolować czystą ścieżkę głosu, zanim ją przetworzysz. Nasz Dubbing AI jest zbudowany do tłumaczenia nagranego audio lub wideo na obsługiwane języki docelowe, a nie do konwersji sygnału z mikrofonu na żywo.
Ryzyka i odpowiedzialne korzystanie
Podszywanie się i oszustwa to główne ryzyko. Realistyczny przekonwertowany głos może sprawić, że fałszywa tożsamość stanie się bardziej wiarygodna, a FTC ostrzega, że systemy klonowania głosu są wykorzystywane w oszustwach rodzinnych, podszywaniu się pod firmy, wymuszeniach i innych oszustwach, obok ryzyka dla artystów głosowych, których głosy mogą zostać przywłaszczone. Nie używaj rozpoznawalnego głosu prawdziwej osoby bez autoryzacji i nigdy nie przedstawiaj głosu wygenerowanego lub przekonwertowanego przez AI jako dowodu, że dana osoba mówiła.
Zgoda i prawa do głosu wynikają bezpośrednio z tego. Uzyskaj pozwolenie przed sklonowaniem lub celowym imitowaniem głosu innej osoby i zachowaj zapis tego pozwolenia, zwłaszcza w projektach komercyjnych, reklamie, szkoleniach, grach lub mediach publicznych. Cytowane tutaj materiały FTC omawiają szkody, egzekwowanie prawa i proponowane rozwiązania, a nie ustanawiają jednej zasady zgody dla każdego zastosowania, więc konkretne zobowiązania mogą zależeć od jurysdykcji, umowy, platformy i przypadku użycia. W razie wątpliwości zweryfikuj to w swojej sytuacji.
Ujawnienie jest rozsądne zawsze, gdy widownia mogłaby zasadnie uwierzyć, że prawdziwa osoba mówi na żywo. Krótka informacja, że głos jest wygenerowany przez AI lub przekonwertowany, zmniejsza zamieszanie. Bezpieczeństwo też ma znaczenie: chroń próbki głosu i niestandardowe pliki głosowe jak inne wrażliwe zasoby, ogranicz dostęp, unikaj przesyłania nagrań bez pozwolenia i usuwaj nieużywane profile głosowe tam, gdzie usługa na to pozwala. Wreszcie planuj na wypadek awarii jakości. Opóźnienia, utracony dźwięk i artefakty konwersji mogą zakłócić rozmowę, więc przetestuj całą konfigurację z faktycznym mikrofonem, słuchawkami, aplikacją, siecią i sprzętem przed publicznym występem.
Gdzie nasze narzędzia pasują do Twojego projektu głosowego
Prezentujemy zintegrowany proces mediów AI, a nie produkt do zmiany głosu z mikrofonu na żywo. Na naszej platformie możesz generować mowę z tekstu, wybierać spośród ponad 300 głosów, tworzyć sklonowane głosy z krótkiej próbki i używać tych głosów w projektach Syntezy Mowy i Dubbingu AI. Obsługujemy dubbing z ponad 60 języków źródłowych na 33 języki docelowe, co czyni nas świetnym wyborem, gdy zadaniem jest stworzenie lektora ze scenariusza, wytworzenie mowy z niestandardowym głosem, dubbing nagranego audio lub wideo czy lokalizacja treści dla wielojęzycznej widowni.
Dla deweloperów publikujemy osobne strony API dla Syntezy Mowy, Klonowania Głosu i Dubbingu AI. Są to procesy generowania i lokalizacji. Jeśli Twój projekt konkretnie potrzebuje zmieniacza głosu z mikrofonu na żywo, potwierdź, że strumieniowe wejście w czasie rzeczywistym, przekierowanie wyjścia, docelowe opóźnienia i obsługa sesji na żywo są wyraźnie udokumentowane, zanim zdecydujesz się na jakiekolwiek API, nasze czy czyjeś.
Jeśli rozważasz konwersję na żywo w porównaniu z nagrywanym procesem i nie masz pewności, która ścieżka pasuje do Twojej treści, podaj nam swój format źródłowy, języki docelowe oraz to, czy potrzebujesz wyjścia na żywo czy nagranego wcześniej, a wskażemy Ci właściwy proces.
Najczęściej zadawane pytania
Czy zmieniacz głosu AI w czasie rzeczywistym to to samo co synteza mowy?
Nie. Zmieniacz głosu w czasie rzeczywistym przekształca mowę z mikrofonu na żywo podczas mówienia, podczas gdy synteza mowy generuje nową mowę z pisanego tekstu, który najpierw przesyłasz. Nasza Synteza Mowy jest zbudowana do generowania mowy z tekstu, a nie do konwersji z mikrofonu na żywo.
Czy zmieniacz głosu AI w czasie rzeczywistym ma zerowe opóźnienie?
Nie. Każdy system potrzebuje czasu na przechwycenie i przetworzenie dźwięku, więc pewne opóźnienie jest nieuniknione. Praktyczne opóźnienie zależy od modelu, urządzenia, ustawień bufora, sieci i aplikacji docelowej, a systemy badawcze raportują różne liczby w różnych warunkach testowych.
Czy zmieniacz głosu AI może skopiować głos celebryty?
Niektóre systemy technicznie potrafią imitować rozpoznawalne głosy, ale możliwość techniczna nie jest pozwoleniem. Unikaj nieautoryzowanego podszywania się i sprawdź odpowiednie umowy, zasady platformy i prawa, zanim użyjesz głosu jakiejkolwiek rozpoznawalnej osoby.
Czego powinienem użyć do tworzenia wielojęzycznych filmów na YouTube?
Dla nagranych wcześniej filmów dubbing AI zwykle pasuje lepiej niż zmieniacz głosu na żywo, ponieważ przetwarza istniejące wideo i tworzy dopasowane, zlokalizowane audio. Nasz Dubbing AI tłumaczy i dubbinguje nagrane audio lub wideo na obsługiwane języki.
Czy Wasza platforma może zmienić mój głos na żywo podczas rozmowy?
Nasza platforma dokumentuje Syntezę Mowy, Klonowanie Głosu i Dubbing AI, a nie konwersję głosu z mikrofonu na żywo. Jeśli planujesz proces rozmów na żywo, najpierw potwierdź z nami aktualną dokumentację produktu, abyśmy mogli zarekomendować właściwe podejście.