Jeśli rozważasz voiceforge text to speech do swojego projektu, prawdziwym pytaniem rzadko jest to, czy głosy brzmią interesująco. Chodzi o to, czy narzędzie pasuje do długości twojego scenariusza, twoich praw publikacyjnych oraz rodzaju treści, które faktycznie tworzysz. VoiceForge to działająca w przeglądarce usługa zamiany tekstu na mowę, zbudowana wokół charakterystycznych głosów postaci. Zamienia ona scenariusz na możliwy do pobrania plik audio przy użyciu silnika syntezy opartej na selekcji jednostek, który łączy ze sobą nagrane segmenty mowy pochodzące od ludzkich lektorów, zamiast generować każdy dźwięk z pojedynczej matematycznej fali. Praktyczna decyzja sprowadza się do czterech potrzeb: zabawny, rozpoznawalny głos do projektów osobistych; licencjonowane audio do mediów zarobkowych; precyzyjna kontrola nad wymową i tempem; lub skalowalny wielojęzyczny przepływ pracy. Tylko pierwsze trzy czysto pasują do generatora głosów postaci, a właśnie ta luka najczęściej potyka twórców.
Publikujemy ten przewodnik, ponieważ to samo nieporozumienie pojawia się raz za razem: ludzie generują audio w ramach bezpłatnej wersji próbnej, zakładają, że mogą je zarobkowo wykorzystać, a potem odkrywają, że licencja jest powiązana z konkretnym planem. Poniżej omawiamy, jak działa silnik, co potrafi, a czego nie, oraz kiedy narzędzie z pojedynczym nowatorskim głosem jest właściwym wyborem, a kiedy wygrywa pełny przepływ pracy lokalizacyjnej.
Spis treści
Czym właściwie jest VoiceForge text to speech
VoiceForge zamienia zapisane słowa w mówione audio: wpisujesz scenariusz, wybierasz głos, generujesz klip, odsłuchujesz podgląd i pobierasz wynik, gdy pozwala na to twój plan. Tym, co odróżnia je od ogólnej biblioteki lektorskiej, jest jego nastawienie. VoiceForge skłania się ku głosom z charakterem, a nie neutralnemu korporacyjnemu brzmieniu, co czyni je naturalnym wyborem do skeczy na YouTube, klipów z gier, animowanych postaci, memów, nowatorskich zapowiedzi i projektów muzycznych.
To nastawienie na postaci jest zaletą dla niektórych treści, a wadą dla innych. Komiczny lub celowo syntetyczny głos może poprowadzić parodię lub NPC w grze, ale ten sam głos staje się rozpraszający w kursie e-learningowym, prezentacji produktu czy reklamie premium marki. Pierwszym filtrem nie jest więc „czy to brzmi jak człowiek?”. Jest nim „czy ten głos pasuje do mojej konkretnej publiczności?”
Jeśli wciąż zastanawiasz się, czy generator głosów ze stocka w ogóle odpowiada twoim potrzebom, nasze wyjaśnienie na temat tego, co robi generator głosu AI, obejmuje szerszą kategorię oraz to, jak te narzędzia różnią się od klonowania i dubbingu.
Jak silnik selekcji jednostek buduje głos
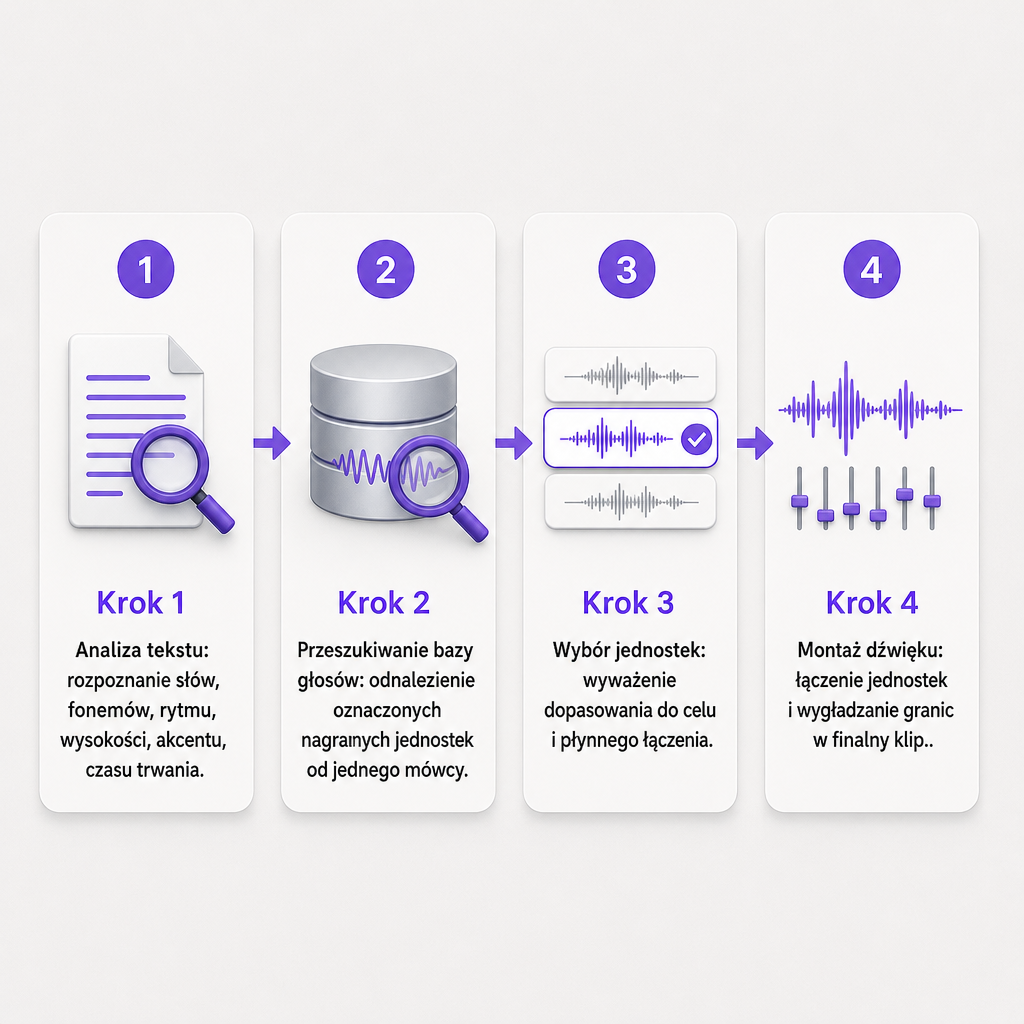
VoiceForge wykorzystuje syntezę opartą na selekcji jednostek, zwaną też syntezą konkatenacyjną. Zamiast generować całe nagranie z jednej fali wytworzonej przez model, system przeszukuje bazę danych nagranych segmentów mowy i łączy najlepiej pasujące fragmenty w twoje zdanie. Zrozumienie tego procesu wyjaśnia zarówno to, dlaczego głosy brzmią rozpoznawalnie, jak i to, dlaczego zachowują się tak, a nie inaczej pod presją.
Proces przebiega w kilku etapach. Najpierw analiza tekstu: silnik rozkłada słowa, strukturę zdania, fonemy, rytm, wysokość tonu, akcent i czas trwania, aby zdecydować, jak dana linia powinna zostać wypowiedziana. Następnie przeszukiwanie bazy głosów: każdy głos jest zbudowany z nagrań ludzkiego lektora, pociętych na mniejsze jednostki i oznaczonych według dźwięku i kontekstu. Potem selekcja jednostek, gdzie silnik równoważy naraz dwa konkurujące cele — dopasowanie do celu, które wybiera jednostkę o właściwym dźwięku, wysokości tonu, czasie trwania i kontekście, oraz płynne łączenie, które faworyzuje sąsiadujące jednostki łączące się bez widocznego szwu. Na koniec montaż audio zszywa wybraną sekwencję i stosuje lekkie wygładzenie na granicach.
Ponieważ efekt jest składany z prawdziwych nagrań, każdy głos zachowuje charakterystyczną tożsamość. Kompromisem jest to, że metoda ta nie została zaprojektowana tak, by oferować nieograniczone sterowanie emocjami ani w pełni regulowalny sposób wypowiedzi kojarzony z nowszymi systemami generatywnymi. Nietypowe frazowanie, szybkie zmiany lub niezręczne kombinacje wymowy mogą ujawnić łączenia między jednostkami, dając wyniki brzmiące mniej spójnie niż ciągłe nagranie ludzkie. Jeśli chcesz zobaczyć, jak różni się w pełni generatywny proces, nasza analiza tego, jak działa neuronowa zamiana tekstu na mowę, prowadzi przez podejście oparte na uczeniu głębokim, które zastępuje konkatenację.
Głosy, SSML i limit 500 znaków
VoiceForge wymienia 42 unikalne głosy, każdy nagrany przez innego lektora o własnej barwie i stylu mówienia. To mnóstwo, gdy sam głos jest częścią koncepcji twórczej — komiczny narrator do krótkiego filmu, dziwna osobowość do filmu z gry, syntetyczny ton do mema. To jednak mniejszy katalog dla zespołów, które potrzebują wielu wariantów regionalnych lub starannie dobranego narratora na kilku rynkach.
Do kontroli sposobu wypowiedzi VoiceForge obsługuje podzbiór języka Speech Synthesis Markup Language (SSML). Zamiast polegać wyłącznie na interpunkcji, wstawiasz instrukcje bezpośrednio w scenariuszu.
| Element sterujący SSML | Do czego służy |
|---|---|
<break> |
Wstawia pauzę |
<emphasis> |
Akcentuje słowo lub frazę |
<prosody> |
Dostosowuje wysokość tonu, tempo mowy lub głośność |
<phoneme> |
Wymusza dokładną wymowę |
<sub> |
Wypowiada zamiennik dla widocznego tekstu |
<p> / <s> |
Oznacza akapit lub zdanie |
Te znaczniki sprawdzają się, gdy silnik błędnie odczyta nazwę produktu, akronim lub termin techniczny. Zawinięcie skrótu w <sub alias="application programming interface">API</sub> sprawia, że zostaje wypowiedziana pełna fraza, a <phoneme> ustala trudną nazwę. Element <break time="500ms"/> między liniami dodaje celowe zatrzymanie tam, gdzie interpunkcja by tego nie zrobiła.
Oto haczyk, który zmienia sposób, w jaki piszesz dla tego narzędzia: pole tekstowe jest ograniczone do 500 znaków, a znaczniki SSML wliczają się do tego limitu. Każdy dodany znacznik zjada miejsce dostępne na faktyczne słowa. Długą narrację trzeba podzielić na wiele generacji, a intensywne znaczniki jeszcze bardziej kurczą każdy fragment. W praktyce oznacza to planowanie scenariusza w krótkich, samodzielnych fragmentach, zamiast wklejania całej strony.
Wersja próbna a licencja komercyjna: decyzja, która ma znaczenie
VoiceForge oferuje ograniczoną bezpłatną wersję próbną, ale wersja próbna to nie licencja publikacyjna. Jego plany wyraźnie oddzielają użytek osobisty od komercyjnego, i to właśnie na tej granicy najczęściej dochodzi do pomyłek.
Poziom Fan Voice jest przeznaczony do żartów, filmów, gier, animacji i memów, które nie są zarobkowe. Plan Publisher to subskrypcja przyznająca licencję komercyjną na audio TTS w treściach zarobkowych lub komercyjnych — zarobkowe filmy, gry niezależne i muzyka — i reklamuje nieograniczone pobieranie. Bezpłatna wersja próbna istnieje po to, byś mógł przetestować usługę przed podjęciem zobowiązania.
Zasada działania jest prosta: jeśli projekt zarabia pieniądze, promuje firmę, pojawia się w mediach zarobkowych lub trafia do sprzedaży komercyjnej, potwierdź odpowiedni plan przed publikacją. Audio wygenerowane podczas bezpłatnej wersji próbnej nie nabywa automatycznie praw komercyjnych tylko dlatego, że zostało pobrane. Zapisy licencyjne mogą się także zmieniać, więc strona planu jest punktem wyjścia, a nie substytutem przeglądu dostosowanego do konkretnego projektu, gdy stawka jest wysoka — materiał dla klienta, płatna reklama, kampania brandowa czy wydanie aplikacji.
Mocne strony i ograniczenia w rzeczywistych projektach
Mocne strony VoiceForge skupiają się wokół osobowości i prostoty. Głosy postaci wyróżniają się, gdy barwa jest częścią żartu lub marki kanału. Ponieważ podstawą jest nagrana ludzka mowa, głosy zachowują naturalne cechy wokalne i rozpoznawalną tożsamość. Kontrolki wymowy SSML dają ci realny wpływ na akronimy, nazwy i dziwne terminy. A plan Publisher czyni kwestię użytku komercyjnego bardziej jawną niż narzędzia, które oddzielają dostęp do generowania od szczegółów licencyjnych.
Ograniczenia są równie konkretne. Limit 500 znaków zmusza długie scenariusze do wielu małych generacji, a znaczniki skracają każdą z nich. Katalog 42 głosów jest skromny w porównaniu z dużymi bibliotekami, co ma znaczenie, jeśli potrzebujesz setek opcji lub wielu akcentów regionalnych. Styl skupiony na postaciach, który błyszczy w rozrywce, może zaszkodzić treściom prawnym, medycznym, instruktażowym lub premium markom. O ograniczenia planu łatwo się potknąć, ponieważ możliwość wygenerowania audio to nie to samo co prawo do jego zarobkowego wykorzystania. A ponieważ silnik łączy nagrane jednostki, niektóre frazowania mogą ujawnić artefakty zszywania, których ciągłe nagranie by nie miało.
Żadne z tych ograniczeń nie dyskwalifikuje narzędzia samo w sobie. Po prostu wyznaczają jego mocny punkt: krótkie, oparte na osobowości, jednojęzyczne klipy, w których głos jest sednem.
Kiedy pasuje głos postaci, a kiedy wygrywa przepływ pracy lokalizacyjnej
VoiceForge jest właściwym wyborem, gdy osobowość głosu jest kluczowa, twoje scenariusze dzielą się czysto na krótkie sekcje, potrzebujesz podstawowej kontroli wymowy i tempa, a tworzysz filmy, memy, animacje, muzykę lub treści z gier niezależnych — czy to osobiste (Fan Voice), czy zarobkowe z odpowiednią subskrypcją.
Szerszy przepływ pracy posłuży ci lepiej, gdy potrzebujesz dopracowanego neutralnego narratora, wielu języków i akcentów, własnego sklonowanego głosu, długich narracji, częstych aktualizacji komercyjnych, integracji z API lub spójnych głosów w dużym katalogu, gdzie nowatorskość liczy się mniej niż niezawodność. Kanał rozwijający się międzynarodowo dobrze ilustruje ten podział: VoiceForge może dostarczyć głos postaci do anglojęzycznego skeczu, podczas gdy wielojęzyczny zestaw TTS i dubbingu tworzy wersje zlokalizowane dla innych odbiorców.
To właśnie na tym drugim scenariuszu się skupiamy. Nasze narzędzie Text to Speech oferuje ponad 300 głosów AI, wielojęzyczne lektoraty, kontrolę tempa mowy i możliwe do pobrania projekty tworzone z myślą o produkcji, a nie jednorazowej nowince. Twórcy, którzy chcą zachować własną tożsamość w każdym filmie, mogą skorzystać z klonowania głosu zamiast zadowalać się gotową postacią, a deweloperzy potrzebujący generowania mowy wewnątrz aplikacji mogą budować w oparciu o nasze API Text to Speech. Gdy celem jest przekształcenie pojedynczego klipu w pełne zlokalizowane wydanie, AI Dubbing przenosi ten sam scenariusz na dodatkowe języki w jednym miejscu.
Lista kontrolna jakości przed publikacją
Zanim wypuścisz audio z VoiceForge, zrób szybki przegląd rzeczy, które psują się najczęściej. Wygenerowanie najpierw krótkich fragmentów testowych jest warte tych kilku dodatkowych minut, ponieważ głos, który sprawdza się w jednym zdaniu, może stać się męczący lub rozpraszający w całym filmie.
- Wymowa: Czy nazwy, skróty, liczby i terminy techniczne są wypowiadane poprawnie?
- Tempo: Czy pauzy padają naturalnie, a nie w środku frazy?
- Spójność postaci: Czy ten sam głos pasuje do każdej sceny, a nie tylko do początku?
- Przejścia audio: Czy są słyszalne skoki między osobno generowanymi klipami?
- Licencjonowanie: Czy twój obecny plan rzeczywiście obejmuje użytek zarobkowy lub komercyjny?
- Dopasowanie do odbiorców: Czy styl postaci jest odpowiedni dla platformy i tematu?
- Zestrojenie: Czy audio czysto współgra z twoim filmem, muzyką lub dialogami z gry?
- Prawa: Czy masz zgodę na jakikolwiek dostarczony scenariusz, nazwę lub odniesienie do podmiotu trzeciego w audio?
Najczęściej zadawane pytania
Czym jest VoiceForge text to speech?
To działająca w przeglądarce usługa, która zamienia zapisany tekst w mówione audio przy użyciu biblioteki charakterystycznych głosów postaci. Opiera się na syntezie opartej na selekcji jednostek, która składa nagrane segmenty mowy z ludzkich baz głosów, zamiast generować audio z pojedynczej fali modelu.
Czy VoiceForge jest generowany przez AI?
To usługa syntezy mowy, ale jej udokumentowana metoda to selekcja jednostek, a nie w pełni generatywny neuronowy system głosowy. Silnik wybiera i łączy nagrane jednostki ludzkiej mowy, aby stworzyć każdą wypowiedź.
Ile głosów VoiceForge jest dostępnych?
VoiceForge wymienia 42 unikalne głosy, każdy powiązany z innym lektorem i osobowością wokalną.
Jaki jest limit znaków w VoiceForge?
Usługa dokumentuje limit 500 znaków na jedno pole tekstowe, a wszelkie dodane znaczniki SSML wliczają się do tego limitu. Dłuższe scenariusze trzeba podzielić na wiele generacji.
Czy mogę wykorzystać audio z VoiceForge na YouTube?
Możesz, ale treści zarobkowe wymagają odpowiedniej subskrypcji komercyjnej. Plan Publisher opisywany jest jako licencja na audio TTS wykorzystywane w treściach zarobkowych lub komercyjnych, więc potwierdź swój plan przed publikacją zarobkowego filmu.
Czy VoiceForge to to samo co klonowanie głosu?
Nie. VoiceForge korzysta ze swojej istniejącej biblioteki głosów, podczas gdy klonowanie głosu tworzy niestandardowy syntetyczny głos z autoryzowanych nagrań konkretnego lektora. Ten osobny przepływ pracy wyjaśniamy na naszej stronie klonowania głosu.