Ten płaski, lekko robotyczny narrator czytający napisy na klipie stał się jednym z najbardziej rozpoznawalnych dźwięków w krótkich formach wideo. W momencie, gdy ludzie go słyszą, dokładnie wiedzą, jaki rodzaj treści oglądają. Jeśli szukasz niezawodnego sposobu, aby przenieść ten efekt zamiany tekstu na mowę z tiktoka do filmów publikowanych wszędzie indziej, dobra wiadomość jest taka, że nie musisz pozostawać zamknięty w edytorze jednej aplikacji, aby go uzyskać. Dzięki naszemu narzędziu Text to Speech piszesz scenariusz, wybierasz głos pasujący do tonu, jakiego chcesz, generujesz dźwięk i synchronizujesz go z materiałem filmowym do TikToka, YouTube Shorts, Reels lub gdziekolwiek indziej publikujesz.
Powód, dla którego to ma znaczenie, wykracza poza kopiowanie trendu. Charakterystyczny głos narratora to element tożsamości twojego kanału. Gdy jest rozpoznawalny, widzowie kojarzą go z tobą na każdej platformie. Problem z poleganiem wyłącznie na wbudowanym narratorze aplikacji polega na tym, że jesteś ograniczony do tej aplikacji, jej krótkiej listy głosów i jej zasad. Zbudowaliśmy nasz proces tak, aby ten sam głos, który kochasz, mógł towarzyszyć twoim treściom wszędzie i, gdy będziesz gotowy, także w innych językach.
Spis treści
- Dlaczego głos narratora TikToka stał się narzędziem do opowiadania historii
- Odtwarzanie efektu za pomocą naszego narzędzia Text to Speech
- Wykraczanie poza gotowe głosy dzięki klonowaniu głosu
- Przenoszenie jednego głosu między językami i formatami
- Automatyzacja narracji w stylu TikToka za pomocą naszych API
- Wybór ścieżki: gotowy głos, sklonowany głos lub API
- Najczęściej zadawane pytania
Dlaczego głos narratora TikToka stał się narzędziem do opowiadania historii
Wbudowany narrator zaczynał jako funkcja ułatwiająca życie. Dodajesz tekst do klipu, dotykasz, aby przekształcić go w mowę, wybierasz spośród kilku głosów, a aplikacja czyta twoje napisy na głos. Poradniki w całej sieci prowadzą początkujących dokładnie przez to: dodaj tekst, przytrzymaj go lub dotknij ikony głosu, a następnie wybierz narratora. Ponieważ proces jest tak prosty, twórcy zaadoptowali go do komediowych fragmentów, poradników krok po kroku, postów typu storytime i omówień produktów.
To, co zamieniło narzędzie w trend, to powtarzalność. Gdy miliony klipów używa tej samej neutralnej, równomiernie tempowanej narracji, ten dźwięk staje się skrótem dla pewnego stylu treści. Widzowie przestają słyszeć go jako maszynę i zaczynają słyszeć go jako głos krótkoformatowego opowiadania historii. Ta znajomość jest powodem, dla którego tak wielu twórców chce teraz tego samego efektu na każdej platformie, na której publikują, i chce większej kontroli, niż pozwala na to stała lista głosów.
Praktyczne ograniczenie łatwo napotkać. Wbudowany narrator aplikacji daje ci krótkie menu głosów i utrzymuje wszystko wewnątrz tej jednej aplikacji. Jeśli przerabiasz film na inną platformę, albo tracisz narrację, albo nagrywasz ją ponownie. Jeśli chcesz głosu, którego nie ma na liście, utknąłeś. A jeśli planujesz opublikować ten sam pomysł w innym języku, wbudowane narzędzie nie przeniesie twojego narratora za ciebie. Właśnie te luki są miejscem, gdzie dedykowany proces Text to Speech udowadnia swoją wartość, pozwalając ci wygenerować narrację raz i wykorzystać ją ponownie wszędzie, gdzie publikujesz.
Odtwarzanie efektu za pomocą naszego narzędzia Text to Speech
Nasze narzędzie Text to Speech jest elementem, który bezpośrednio odtwarza efekt narratora na ekranie. Zamiast wpisywać napisy do jednej aplikacji i mieć nadzieję, że jej narrator będzie pasować, wklejasz swój scenariusz, wybierasz z biblioteki ponad 300 naturalnie brzmiących głosów i generujesz czysty dźwięk, który możesz wstawić do dowolnego filmu. Wynikiem jest plik do pobrania, więc należy on do twojego projektu, a nie do edytora jednej platformy.
Aplikacja internetowa działa w czterech prostych krokach. Po pierwsze, wybierz Text to Speech. Po drugie, utwórz mowę, wprowadzając swój tekst i wybierając mówcę. Po trzecie, edytuj projekt, gdzie możesz dodać więcej mówców lub dostosować tekst. Po czwarte, pobierz gotowy projekt w potrzebnym formacie. Nie ma w tym nic technicznego, i o to właśnie chodzi: powinieneś poświęcić swoją energię na scenariusz i montaż, a nie na zmaganie się z oprogramowaniem.
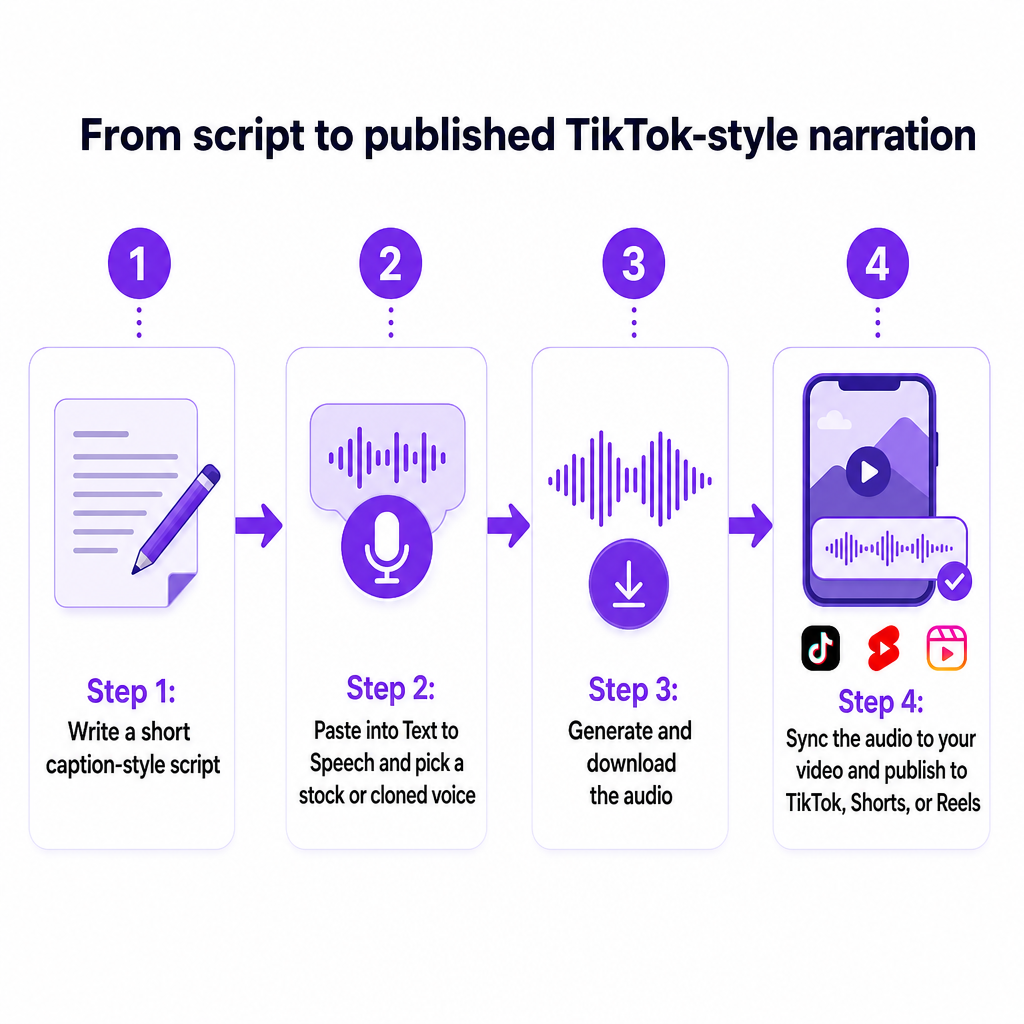
Zastosowany do krótkiej formy wideo, proces staje się jeszcze bardziej konkretny. Zacznij od napisania krótkiego scenariusza w stylu napisów, dokładnie tych słów, które chcesz odczytać nad twoim klipem. Utrzymuj go zwięzłym; efekt narratora działa najlepiej z ciasnymi, rytmicznymi liniami. Wklej ten scenariusz do Text to Speech i wybierz głos, którego ton pasuje do nastroju, jakiego szukasz, czy to bez wyrazu, energiczny, czy rzeczowy. Wygeneruj dźwięk, a następnie przenieś go do wybranego edytora i dopasuj do obrazu przed opublikowaniem na TikToku, Shorts lub Reels.
Ponieważ generujesz narrację poza jakąkolwiek pojedynczą aplikacją, ten sam plik audio działa na każdej platformie w twojej rotacji publikacyjnej. Nagraj raz, wykorzystaj wszędzie. To samo rozwiązuje największą frustrację związaną z wbudowanym narratorem aplikacji: nie budujesz już tego samego podkładu głosowego trzy razy dla trzech miejsc docelowych.
Pisanie scenariuszy pasujących do stylu narratora
Głos wykonuje dużą część pracy, ale scenariusz nadaje tempo. Krótkie zdania oznajmujące czytają się czysto i lądują z wyrazistą kadencją, którą widzowie kojarzą z trendem. Liczby, listy i wyraźne zwroty jak „najpierw", „potem" i „na końcu" dobrze przekładają się na syntetyzowaną mowę, ponieważ dają głosowi naturalne punkty pauzy. Jeśli linia brzmi niezręcznie, gdy czytasz ją na głos, będzie brzmieć niezręcznie także wtedy, gdy głos ją odczyta, więc szybki przegląd na głos przed wygenerowaniem oszczędza wiele późniejszej regeneracji.
Wykraczanie poza gotowe głosy dzięki klonowaniu głosu
Wybieranie z biblioteki to szybka ścieżka, a dla wielu twórców dobrze wybrany gotowy głos to wszystko, czego potrzebują. Ale jest granica brzmienia jak wszyscy inni. Jeśli twoim celem jest narrator, który jest niewątpliwie twój, nasze Klonowanie głosu zamienia twój własny głos, lub głos marki za zgodą, w wielokrotnego użytku model, który możesz sterować z tekstu.
Ta różnica ma znaczenie. Ogólna zamiana tekstu na mowę oznacza wybieranie z gotowych narratorów. Klonowanie głosu buduje syntetyczny model jednego konkretnego mówcy, więc nowa mowa w tym głosie może być generowana z dowolnego tekstu, który wpiszesz. W aplikacji internetowej przesyłasz plik audio zawierający co najmniej 20 sekund czystej mowy, z minimalnym szumem tła, do sekcji klonowania głosu. Z tej krótkiej, cichej próbki tworzymy niestandardowy głos, którego możesz używać jak każdego innego w swoich projektach Text to Speech.
Dwadzieścia sekund czystego dźwięku to niski próg wysiłku produkcyjnego. Cichy pokój, telefon lub podstawowy mikrofon i krótkie odczytanie wystarczą, aby wygenerować charakterystycznego narratora, którego możesz wykorzystywać w nieskończoność. Gdy już istnieje, nie wybierasz już między anonimowymi gotowymi głosami; masz głos, który niesie twoją tożsamość do każdego klipu i pozostaje spójny, niezależnie od tego, czy publikujesz dziś, czy za sześć miesięcy.
To tutaj rozpoznawalny narrator staje się aktywem marki, a nie jednorazowym efektem. Sklonowany głos czyta scenariusze, których nigdy faktycznie nie nagrałeś, zachowuje swój charakter przez cały kalendarz treści i nigdy nie potrzebuje sesji ponownego nagrywania, ponieważ zmieniłeś swój sprzęt. Dla twórców budujących długoterminową tożsamość kanału ta spójność jest prawdziwym ulepszeniem w porównaniu z rotacyjnym menu głosów aplikacji.
Przenoszenie jednego głosu między językami i formatami
Głos narratora działający tylko w jednym języku ogranicza twój zasięg w momencie, gdy chcesz rozwijać się na arenie międzynarodowej. Nasza platforma obsługuje wielojęzyczny dubbing w 33 językach docelowych i może generować mowę z tekstu w wybranym przez ciebie języku, więc ten sam trend, który działa w języku angielskim, może być odtworzony dla odbiorców gdzie indziej.
Oto jak elementy pasują do siebie. Text to Speech daje ci narrację. Klonowanie głosu pozwala tej narracji pozostać w jednym rozpoznawalnym głosie. Nasz Dubbing AI rozszerza tę samą treść na inne języki, obsługując wideo i audio poprzez zamianę tekstu na mowę, mowy na tekst i klonowanie głosu w ramach jednego procesu. Zamiast wynajmować oddzielnych narratorów dla każdego rynku, zachowujesz jedną tożsamość głosu i pozwalasz platformie przenieść ją między wersjami.
Proces skaluje się także poza krótkie klipy. W przypadku dłuższych treści możesz przesyłać pełne filmy lub pliki audio, dostosowywać ustawienia mówcy, wybierać języki i wybierać preferowane głosy wewnątrz projektu przed eksportem. Więc to samo podejście, którego używasz do dodania narratora w stylu wirusowym do piętnastosekundowego klipu, dotyczy także poradnika, lekcji lub całego odcinka. Krótka forma to miejsce, gdzie żyje trend, ale leżące u podstaw narzędzia nie zatrzymują się na krótkiej formie.
Dla twórców planujących globalny rozwój zmienia to ekonomikę lokalizacji. Pojedynczy scenariusz staje się angielskim shortem, wersją hiszpańską i dodatkowymi wersjami językowymi, wszystkie z narracją w spójnym głosie, bez odbudowywania dźwięku od zera za każdym razem. Efekt rozpoznawalnego narratora staje się czymś, co możesz obsługiwać jako powtarzalny system, a nie jako szczęśliwy jednorazowy przypadek.
Automatyzacja narracji w stylu TikToka za pomocą naszych API
Indywidualni twórcy mogą robić wszystko powyższe w przeglądarce. Agencje, większe kanały i zespoły z katalogami wstecznymi zwykle potrzebują tego samego rezultatu na dużą skalę i tutaj wchodzą nasze API. API Text to Speech to usługa RESTful, która przekształca tekst w naturalnie brzmiącą mowę: wysyłasz żądanie POST ze swoim tekstem i preferencjami głosu i otrzymujesz gotowy do użycia plik audio. Obsługuje te same 300+ głosów i klonowanie głosu dostępne w aplikacji.
Aby uczynić niestandardowego narratora programowalnym, nasze API Klonowania głosu działa według zwięzłego trzyetapowego wzorca. Po pierwsze, prześlij plik audio i otrzymaj klucz pliku. Po drugie, utwórz niestandardowy głos, podając nazwę i ten klucz pliku. Po trzecie, użyj powstałego sklonowanego głosu wewnątrz projektów Text to Speech poprzez punkty końcowe projektów TTS platformy. Gdy głos istnieje, staje się wielokrotnego użytku aktywem, które twoje aplikacje mogą wywołać, a nie jednorazowym eksportem.
Zebrane razem, pozwala to zespołowi zindustrializować efekt. Wyobraź sobie agencję zarządzającą kilkoma kanałami klientów: może utrzymywać jeden sklonowany głos marki na klienta, przekazywać scenariusze przez API i generować narrowany dźwięk dla dziesiątek filmów, bez potrzeby ręcznego wklejania tekstu do narzędzia za każdym razem. Ten sam wzorzec obsługuje systemy edukacyjne i procesy lokalizacyjne, gdzie sklonowane głosy są wywoływane na żądanie w miarę tworzenia treści.
Dla zespołów, które generują także obrazy lub chcą budować krótkie filmy wokół nieruchomych zasobów, nasze narzędzie image-to-video znajduje się w tym samym ekosystemie, więc produkcja audio i wizualna żyje w jednym miejscu, a nie jest rozproszona po odłączonych aplikacjach. Celem jest jeden proces: jedna platforma do pisania, głosu, lokalizacji i montażu.
Uwaga na temat oczekiwań: opisujemy te API w kategoriach funkcjonalnych, ponieważ tego zależy proces. Jeśli chcesz szczegółów na temat limitów szybkości, przepustowości lub konfiguracji specyficznych dla planu, powiedz nam swój oczekiwany wolumen i przypadek użycia, abyśmy mogli przygotować rekomendację pasującą do twojego obciążenia.
Wybór ścieżki: gotowy głos, sklonowany głos lub API
Większość czytelników przychodzi z jedną z trzech potrzeb, a właściwy punkt startowy zależy od tego, która z nich cię opisuje. Poniższa tabela mapuje każdą sytuację do najszybszego użytecznego pierwszego ruchu.
| Twoja sytuacja | Najlepszy punkt startowy | Dlaczego pasuje |
|---|---|---|
| Szybkie testowanie efektu | Gotowy głos w Text to Speech | Wybierz spośród 300+ głosów, wygeneruj dźwięk w kilka minut, bez potrzeby nagrywania |
| Budowanie charakterystycznego głosu kanału | Klonowanie głosu | Zamień 20-sekundową czystą próbkę w wielokrotnego użytku niestandardowego narratora |
| Produkcja na dużą skalę lub dla wielu klientów | API TTS i Klonowania głosu | Automatyzuj narrację w wielu filmach i wersjach wielojęzycznych |
Jeśli nie jesteś pewien, zacznij prosto. Napisz krótki scenariusz w stylu napisów dla swojego następnego posta, otwórz Text to Speech w przeglądarce i wygeneruj go z gotowym głosem, który pasuje do twojego tonu. Jeśli podoba ci się efekt, ale chcesz, aby brzmiał jak ty, prześlij czystą 20-sekundową próbkę i sklonuj swój głos, a następnie porównaj oba na tym samym klipie. To pojedyncze porównanie zwykle rozstrzyga pytanie, czy chcesz gotowego narratora w stylu wirusowym, czy unikalnego głosu marki na przyszłość.
Zespoły i deweloperzy prowadzący wiele kanałów lub duży katalog wsteczny uzyskają więcej wartości z dostępu do API, ponieważ ręczny przepływ przeglądarki nie skaluje się do setek zasobów. Cokolwiek pasuje do twojego wolumenu, leżąca u podstaw zdolność jest ta sama: rozpoznawalny narrator, na twoich warunkach, na każdej platformie, na której publikujesz. Jeśli chcesz pomocy w dopasowaniu planu kanału, rozmiaru katalogu i celów językowych do właściwego podejścia, podziel się z nami tymi szczegółami, a zaproponujemy odpowiednią konfigurację.
Jedna praktyczna ostrożność warta zapamiętania: gdy klonujesz głos, użyj własnego lub takiego, do którego masz wyraźne pozwolenie, i przestrzegaj zasad publikacji platformy, na której publikujesz. To sprawia, że twoja strategia rozpoznawalnego narratora jest zrównoważona, a nie ryzykowna.
Najczęściej zadawane pytania
Czy DubSmart AI ma ustawienie oznaczone jako „głos TikToka"?
Nasz nacisk kładziemy na odtwarzanie efektu, a nie na naśladowanie konkretnego zastrzeżonego ustawienia. Uzyskujesz ten znajomy odczuwalny efekt narratora na ekranie, generując dźwięk w Text to Speech z biblioteki 300+ głosów, a następnie wybierając ten, którego ton pasuje do stylu, jakiego chcesz. Możesz także sklonować niestandardowy głos dla narratora, który jest wyjątkowo twój. Jeśli masz na myśli konkretny ton lub głos marki, powiedz nam, a zaproponujemy pasujące podejście.
Jak dodać efekt narratora do filmów poza TikTokiem?
Napisz krótki scenariusz w stylu napisów, wklej go do naszego narzędzia Text to Speech, wybierz mówcę i wygeneruj dźwięk. Pobierz plik i dopasuj go do swojego materiału filmowego w dowolnym edytorze, a następnie opublikuj na Shorts, Reels lub gdziekolwiek indziej. Ponieważ dźwięk jest samodzielnym plikiem, jedna narracja działa na każdej platformie, na której publikujesz.
Czego potrzebuję, aby sklonować swój własny głos?
Prześlij plik audio zawierający co najmniej 20 sekund czystej mowy z minimalnym szumem tła do sekcji klonowania głosu. Z tej krótkiej, cichej próbki tworzymy niestandardowy model głosu, którego możesz następnie używać wewnątrz swoich projektów Text to Speech jak każdego innego głosu.
Czy mogę używać tego samego głosu w różnych językach?
Tak. Nasza platforma obsługuje wielojęzyczny dubbing w 33 językach docelowych, a łącząc Text to Speech, klonowanie głosu i Dubbing AI, możesz zachować jeden rozpoznawalny głos we wszystkich wersjach tej samej treści, więc angielski short i jego wersje w innych językach dzielą spójnego narratora.
Czy jest sposób na zautomatyzowanie tego dla wielu filmów naraz?
Deweloperzy i agencje mogą używać naszego API Text to Speech, aby programowo przekształcać tekst w dźwięk, oraz API Klonowania głosu, aby przesłać próbkę, utworzyć nazwany niestandardowy głos i wywołać go w projektach TTS. To pozwala generować narrację w dużych katalogach i wielu kanałach bez ręcznej pracy przy każdym filmie.
Czy powinienem wybrać gotowy głos, czy sklonować własny?
Gotowy głos to najszybszy sposób na przetestowanie efektu i dobrze sprawdza się u wielu twórców. Klonowanie to lepszy wybór, gdy chcesz narratora, który jest niewątpliwie związany z twoją marką i pozostaje spójny w czasie. Wypróbowanie obu na tym samym klipie to najszybszy sposób, aby zdecydować, który wolisz.