Najszybszym sposobem na integrację API zamiany tekstu na mowę jest potraktowanie go jako usługi REST: uwierzytelnij się za pomocą klucza API, wyślij swój tekst wraz z ustawieniami głosu w formacie JSON, pozwól usłudze wygenerować mowę w tle, a następnie pobierz i przechowuj wynikowe pliki audio do odtwarzania wszędzie tam, gdzie potrzebują ich Twoi użytkownicy. Nasze API zamiany tekstu na mowę dokładnie odpowiada temu schematowi, udostępniając ponad 300 naturalnych głosów i nieograniczone klonowanie głosu, dzięki czemu możesz wprowadzić realistyczną mowę do stron internetowych, aplikacji, procesów wideo i platform edukacyjnych. Ten przewodnik przeprowadzi Cię przez to, co faktycznie podłączasz, jak działa nasz silnik oraz decyzje, które określają, czy integracja pasuje do Twojego produktu.
Spis treści
Co robi API zamiany tekstu na mowę w DubSmart
API zamiany tekstu na mowę przekształca ustrukturyzowany tekst na mówione audio na żądanie, dzięki czemu Twój kod może zażądać narracji lub dialogu w momencie, gdy skrypt jest gotowy, zamiast czekać na ręczne nagrywanie. Nasz silnik zamiany tekstu na mowę zasila zarówno przeglądarkowe narzędzie Text to Speech, jak i API, dając dostęp do ponad 300 głosów AI w różnych językach, płciach i stylach, z prozodią dostrojoną do narracji, materiałów wyjaśniających i dialogów.
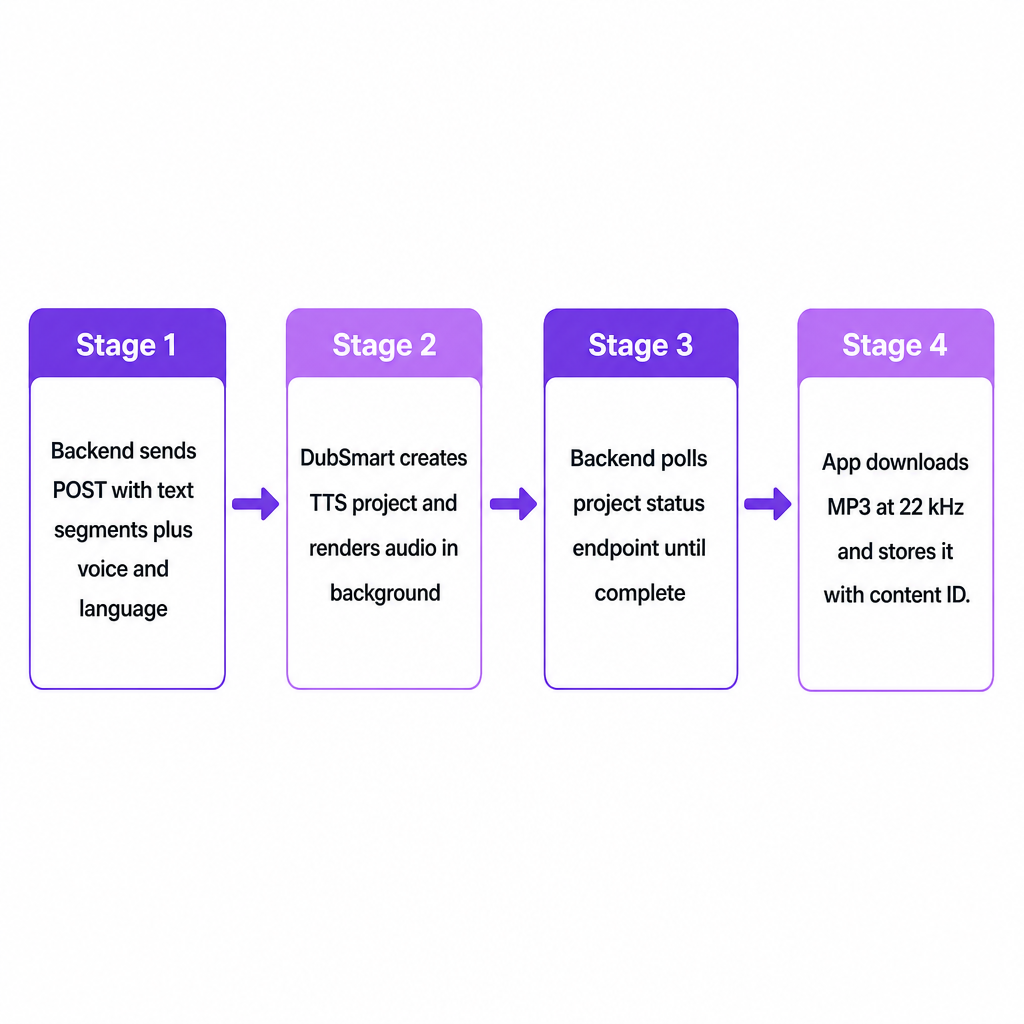
Na warstwie API udostępniamy ten silnik jako usługę RESTful: Twój backend wysyła żądanie POST zawierające segmenty tekstu i parametry głosu, a usługa zwraca obiekt projektu, którego status możesz odpytywać, dopóki audio nie będzie gotowe do pobrania. Wynik dostarczany jest jako wysokiej jakości pliki audio, zazwyczaj MP3 w 22 kHz, odpowiednie do bezpośredniego użycia w edytorach wideo, procesach podcastowych lub odtwarzaczach internetowych bez dodatkowej konwersji.
Dla twórców i zespołów, które obsługujemy — YouTuberów, małych firm, producentów e-learningu, filmowców i agencji deweloperskich — API łączy planowanie treści z publikacją. Gdy tylko skrypt trafi do CMS-a lub platformy edukacyjnej, backend może automatycznie generować lektorów, co eliminuje wąskie gardło powtarzającego się ręcznego nagrywania.
Decyzja o integracji: co właściwie podłączasz?
„Zintegruj API zamiany tekstu na mowę" brzmi ogólnie, ale w praktyce decydujesz o trzech rzeczach: w którym miejscu Twojego procesu mowa powinna być generowana, które głosy i języki będą reprezentować Twoją markę oraz jak ściśle zautomatyzujesz generowanie i pobieranie audio.
Dla twórcy YouTube rozszerzającego się na treści wielojęzyczne integracja często oznacza powiązanie naszego API z narzędziem do planowania wideo lub bazą danych skryptów, tak aby każdy ukończony skrypt stał się lektorem w odpowiednim języku i stylu. Dla małych firm i zespołów marketingowych API zazwyczaj działa za CMS-em lub platformą automatyzacji marketingu, przekształcając wpisy blogowe, materiały wyjaśniające produkty i teksty do mediów społecznościowych w wielokrotnego użytku zasoby audio. Dostawcy e-learningu i szkoleń korporacyjnych zwykle podłączają API do narzędzi autorskich, aby moduły lekcyjne mogły żądać narracji per slajd lub per temat i natychmiast ją regenerować przy aktualizacji materiału.
Deweloperzy i agencje integrujące AI głosowe głębiej zazwyczaj wybierają między dwoma wzorcami. Model wsadowy zbiera skrypty i przetwarza je poprzez zaplanowane zadania. Model transakcyjny wyzwala natychmiastowe żądanie za każdym razem, gdy pojawia się nowa treść lub akcja użytkownika. Nasze API oparte na projektach działa czysto w obu przypadkach, ponieważ każdy projekt TTS enkapsuluje tekst, wybór głosu, język i wynikowe audio w sposób, który odpowiada Twoim własnym jednostkom treści — filmom, lekcjom lub odcinkom podcastu. Jeśli wciąż rozważasz samą koncepcję, nasz towarzyszący artykuł wyjaśniający, czym jest API zamiany tekstu na mowę i jak działa, omawia podstawy zanim zdecydujesz się na projekt.
Jak nasze API zamiany tekstu na mowę działa od kuchni
Nasze API zamiany tekstu na mowę zbudowane jest wokół projektów i segmentów, co czyni je bardziej elastycznym niż pojedynczy punkt końcowy typu „tekst na wejściu, audio na wyjściu". Projekt TTS grupuje jeden lub więcej segmentów tekstu pod tytułem i wspólną konfiguracją, taką jak język i domyślny głos. Każdy segment niesie własny tekst, identyfikator głosu i znacznik języka, co pozwala mieszać style narracji lub języki wewnątrz jednego wyniku.
Typowy ładunek JSON do punktu końcowego projektu TTS zawiera czytelny dla człowieka tytuł projektu do Twoich pulpitów i logów oraz tablicę segmentów. Każdy segment ustawia text (skrypt lub zdanie do wypowiedzenia), voice (wbudowany identyfikator głosu lub niestandardowy identyfikator głosu utworzony za pomocą API klonowania głosu) oraz language (kod wskazujący język segmentu).
Gdy Twój backend wysyła ten ładunek do punktu końcowego TTS z prawidłowym kluczem API w nagłówku Authorization, tworzymy projekt i rozpoczynamy renderowanie audio w tle. API udostępnia punkt końcowy statusu projektu, który raportuje, czy przetwarzanie wciąż trwa, czy zostało zakończone, wraz z odwołaniami do wygenerowanych plików audio, gdy będą gotowe. Ten asynchroniczny projekt utrzymuje Twoje własne żądania szybkimi: zapisz identyfikator projektu, zwróć kontrolę użytkownikowi i pozwól procesowi w tle sprawdzać zakończenie oraz pobierać audio, gdy będzie dostępne.
Wygenerowana mowa dostarczana jest jako pliki do pobrania w standardowych formatach, w szczególności MP3 w 22 kHz, co łatwo wpasowuje się w odtwarzacze internetowe, aplikacje mobilne i osie czasu edycji wideo. Ponieważ ten sam silnik zasila nasze narzędzie przeglądarkowe, deweloperzy mogą interaktywnie prototypować głosy i skrypty, a następnie migrować zwycięskie kombinacje do zautomatyzowanych wywołań API. Pełna dokumentacja punktów końcowych znajduje się na stronie Text to Speech API.
Łączenie klonowania głosu i dubbingu AI z zamianą tekstu na mowę
Naszą cechą wyróżniającą jest to, że Zamiana Tekstu na Mowę, Klonowanie Głosu i Dubbing AI współdzielą jeden podstawowy silnik głosowy i proces. Oznacza to, że API TTS nie jest odizolowane — stanowi rdzeń szerszego procesu lokalizacji.
API klonowania głosu pozwala przesłać próbki audio mówcy, utworzyć niestandardowy głos AI i odwołać się do tego głosu w projektach TTS. Gdy niestandardowy głos już istnieje, jego identyfikator staje się polem voice w Twoich segmentach zamiany tekstu na mowę, dzięki czemu narracja odtwarzana jest w sklonowanym głosie zamiast w generycznym głosie z biblioteki. Ta ciągłość ma znaczenie dla prowadzących, podcasterów i rzeczników marki, którzy chcą spójnej tożsamości dźwiękowej w różnych językach i formatach. Jeśli planujesz dodać klonowanie, nasz przewodnik dotyczący integracji API klonowania głosu w Twojej aplikacji omawia szczegóły.
API dubbingu AI rozszerza to dalej, łącząc transkrypcję, tłumaczenie i zamianę tekstu na mowę w jednym procesie, który dubbinguje filmy na ponad 33 języki docelowe. Tutaj silnik TTS przekształca przetłumaczone skrypty na mowę, wykorzystując tę samą bibliotekę ponad 300 głosów lub Twój sklonowany głos, dzięki czemu wersje dubbingowane zachowują ton i synchronizację. Dla wielojęzycznych twórców i firm API zamiany tekstu na mowę staje się elementem budulcowym zarówno dla jednojęzycznych lektorów, jak i w pełni zlokalizowanych treści dubbingowanych. Nasz przegląd tego, jak działa lokalizacja AI, pokazuje, jak te elementy łączą się od początku do końca.
Kluczowe kryteria decyzyjne przy integracji naszego API TTS
Integracja „jakiegokolwiek" API TTS nie wystarczy; wybory dotyczące implementacji określają, jak dobrze pasuje ono do Twojej produkcji, marki i stosu technologicznego.
Potrzeby skali i automatyzacji. Jeśli wolumen treści jest niski i sporadyczny, narzędzie przeglądarkowe może wystarczyć. Gdy skrypty są generowane regularnie lub powiązane z kalendarzami treści, systemami zarządzania nauczaniem lub automatyzacją marketingu, API staje się właściwą warstwą, ponieważ można je wyzwalać programowo i skalować wraz z Twoim backendem.
Strategia głosowa i językowa. Nasza platforma obsługuje dubbing z ponad 60 języków źródłowych na 33 języki docelowe, napędzana tym samym silnikiem głosowym, którego używa API TTS. Jeśli Twoja marka potrzebuje wyróżniającego się głosu rzecznika, połączenie API klonowania głosu z TTS zachowuje ten głos spójnym w różnych językach i kanałach. Jeśli priorytetem jest szybkość nad personalizacją, wbudowane głosy upraszczają implementację.
Punkt integracji w Twoim stosie. Dla kanałów YouTube naturalnym miejscem jest proces wideo: skrypty przechowywane w narzędziu do planowania, wysyłane do API TTS po sfinalizowaniu i zwracane jako audio gotowe dla edytorów. Platformy e-learningowe mogą integrować się na poziomie lekcji lub slajdu, gdzie każdy blok treści odpowiada segmentowi, a projekty reprezentują całe kursy. Zespoły marketingowe często integrują się na poziomie CMS, aby każdy artykuł lub strona produktu mogła zażądać wersji audio ze względu na dostępność.
Zarządzanie, zgodność i ryzyko. Ponieważ klonowanie głosu może replikować rozpoznawalne głosy, zgoda, licencjonowanie i polityki użytkowania mają znaczenie. Sklonowane głosy identyfikowane są za pomocą identyfikatorów i mogą być tagowane metadanymi, co ułatwia egzekwowanie wewnętrznych zasad dotyczących tego, gdzie konkretne głosy mogą być używane. Zdecyduj z góry, które środowiska mogą wyzwalać sklonowane głosy w porównaniu z głosami generycznymi, i dodaj logowanie we własnych systemach.
Oczekiwania dotyczące opóźnień i doświadczenia użytkownika. Przetwarzanie asynchroniczne oferuje elastyczność, ale dodaje kwestię czasową. Dla procesów, w których użytkownicy oczekują natychmiastowego odtwarzania — takich jak edytor skryptów z natychmiastowym podglądem — twórz mniejsze projekty lub segmenty i pokazuj wskaźniki postępu podczas renderowania audio. Dla lokalizacji wsadowej całych bibliotek opóźnienie ma mniejsze znaczenie, a zadania mogą działać według harmonogramów z ukończonym audio dołączonym do rekordów treści później.
| Obszar decyzyjny | Model wsadowy | Model transakcyjny |
|---|---|---|
| Wyzwalacz | Zaplanowane zadania | Na element treści lub akcję użytkownika |
| Tolerancja opóźnień | Wysoka | Niska |
| Najlepsze zastosowanie | Katalogi kursów, biblioteki wideo | Edytory skryptów, podglądy na żywo |
| Strategia głosowa | Zatwierdzony głos na język | Zatwierdzony głos na język |
Ryzyka i praktyczne zabezpieczenia
Integracja API zamiany tekstu na mowę niesie kilka przewidywalnych ryzyk, które przemyślany projekt może złagodzić.
Wybieranie głosów bez testowania może wytworzyć mowę, która wydaje się nie pasować do charakteru marki lub prowadzącego. Najpierw wypróbuj głosy w interaktywnym interfejsie i prowadź zatwierdzony katalog głosów wewnątrz swoich własnych systemów, zorganizowany per język i typ treści, zanim zakodujesz identyfikatory głosów w wywołaniach API.
Nadmierna automatyzacja wrażliwych treści to kolejna pułapka. Automatyczne generowanie mowy dla materiałów dotyczących zgodności, medycznych lub prawnych może nie być odpowiednie. Ponieważ nasze API operuje na odrębnych projektach i segmentach, możesz utrzymywać reguły routingu, które przesyłają do TTS tylko zatwierdzone kategorie, zachowując wrażliwe treści w procesach nagrywanych przez ludzi.
Błędy operacyjne — nieudane projekty lub brakujące pobrania — zdarzają się, gdy problemy sieciowe lub nieprawidłowe ładunki przerywają przetwarzanie. Punkty końcowe statusu projektu i ustrukturyzowane odpowiedzi pozwalają potwierdzić, że projekt został ukończony, a jego wyniki są dostępne przed publikacją. Powiąż każdy identyfikator projektu TTS z własnym identyfikatorem treści i zaimplementuj ponawianie prób lub rozwiązania awaryjne, gdy sprawdzenia statusu raportują błędy.
Nadużywanie sklonowanych głosów zasługuje na wyraźne kontrole. Niestandardowe głosy muszą być tworzone za pomocą dedykowanych punktów końcowych, a następnie odwoływane po identyfikatorze w projektach TTS, co daje Ci jasną techniczną granicę do monitorowania. Ogranicz, kto może tworzyć lub przypisywać identyfikatory sklonowanych głosów, i loguj, gdzie są używane.
Praktyczną ścieżką startową jest najpierw zintegrowanie TTS dla standardowych lektorów, walidacja głosów i obsługi błędów w produkcji, a następnie dodanie Klonowania Głosu i Dubbingu AI, gdy podstawowa integracja będzie stabilna. Powiedz nam o swoim wolumenie treści, językach docelowych i miejscu, w którym API powinno znajdować się w Twoim stosie, a wskażemy Ci odpowiednie punkty końcowe i plan dla Twojego procesu.
Najczęściej zadawane pytania
Czym API zamiany tekstu na mowę różni się od narzędzia przeglądarkowego?
Narzędzie przeglądarkowe to wizualny interfejs, w którym wklejasz tekst, wybierasz głos i ręcznie pobierasz audio. API udostępnia ten sam silnik poprzez punkty końcowe REST, dzięki czemu Twój backend może automatycznie generować i pobierać audio w odpowiedzi na skrypty, harmonogramy lub akcje użytkowników.
Czy API może mówić moim własnym głosem, a nie tylko głosami z biblioteki?
Tak. Integrując API klonowania głosu, przesyłasz próbki audio mówcy, tworzysz niestandardowy głos AI, a następnie odwołujesz się do identyfikatora tego głosu w swoich segmentach zamiany tekstu na mowę, dzięki czemu cała wygenerowana mowa odtwarzana jest w sklonowanym głosie.
Jak to pomaga w wielojęzycznych kanałach YouTube lub podcastach?
Nasza platforma przekształca mowę lub skrypty z ponad 60 języków źródłowych w treści dubbingowane w 33 językach docelowych, przy czym TTS generuje finalne audio przy użyciu ponad 300 głosów lub Twojego sklonowanego głosu. Podłączenie API TTS i dubbingu AI do Twojego procesu publikacji pozwala nowym filmom lub odcinkom otrzymać lektorów lub pełne dubbingi, gdy tylko skrypty lub audio źródłowe będą gotowe.
Jakie formaty audio otrzyma moja aplikacja lub edytor?
API TTS dostarcza wysokiej jakości pliki audio, w tym MP3 w 22 kHz, odpowiednie dla większości środowisk internetowych, mobilnych i edycji wideo bez dodatkowej konwersji.
Czy mogę zintegrować zamianę tekstu na mowę teraz, a dodać dubbing AI później?
Tak. Zamiana Tekstu na Mowę, Klonowanie Głosu i Dubbing AI współdzielą wspólny ekosystem API, więc możesz zacząć od TTS dla lektorów, a później dodać Klonowanie Głosu i Dubbing AI, aby zautomatyzować wielojęzyczny dubbing bez przebudowywania podstawowej integracji.