Zapytaj, jak powstają lektorzy AI, a tak naprawdę pytasz, jak napisany scenariusz zamienia się w mowę bez konieczności wchodzenia do studia nagraniowego. Krótka odpowiedź: neuronowy model text-to-speech przekształca Twój scenariusz w syntetyczne audio, opcjonalny sklonowany głos sprawia, że to audio brzmi jak konkretna osoba, a warstwa dubbingu synchronizuje wszystko z Twoim wideo w różnych językach. W DubSmart AI uruchamiamy cały ten łańcuch w jednym miejscu pracy, dzięki czemu możesz przejść od akapitu tekstu do gotowego, wielojęzycznego lektora bez przełączania narzędzi czy rezerwowania czasu w studiu.
To, jak ten proces będzie wyglądał w Twoim przypadku, zależy od jednej decyzji, a reszta tego przewodnika omawia mechanizmy, opcje oraz sposób wyboru.
Spis treści
Decyzja stojąca za tym, jak powstają lektorzy AI
Zanim zostanie wygenerowane jakiekolwiek audio, podejmujesz dwie decyzje, które kształtują wszystko na dalszych etapach. Pierwsza to czy chcesz gotowego głosu z biblioteki, czy klona własnego głosu. Druga to czy potrzebujesz lektora w jednym języku, czy w pełni zlokalizowanej wersji w wielu językach.
Dla twórcy YouTube lub małej firmy zwykle rozstrzyga się to szybko: wybierz gotowy głos dla szybkości, sklonuj głos, gdy liczy się spójność marki, a po dubbing sięgnij tylko wtedy, gdy działasz wielojęzycznie. Dla deweloperów i agencji to samo rozwidlenie staje się kwestią architektury — czy wywołujesz punkt końcowy text-to-speech dla jednorazowego audio, czy łączysz klonowanie głosu i dubbing w potok, który działa samodzielnie?
Zbudowaliśmy DubSmart właśnie wokół tych rozwidleń. Text to Speech, Voice Cloning, Speech to Text, Speech Separator, Text to Image, Image to Video oraz AI Dubbing — wszystko to znajduje się na jednej platformie, dzięki czemu możesz zwiększać lub zmniejszać poziom automatyzacji i personalizacji bez zszywania ze sobą oddzielnych dostawców.
Mechanizmy: jak faktycznie powstają lektorzy AI
Text to speech: zamiana scenariusza w dźwięk
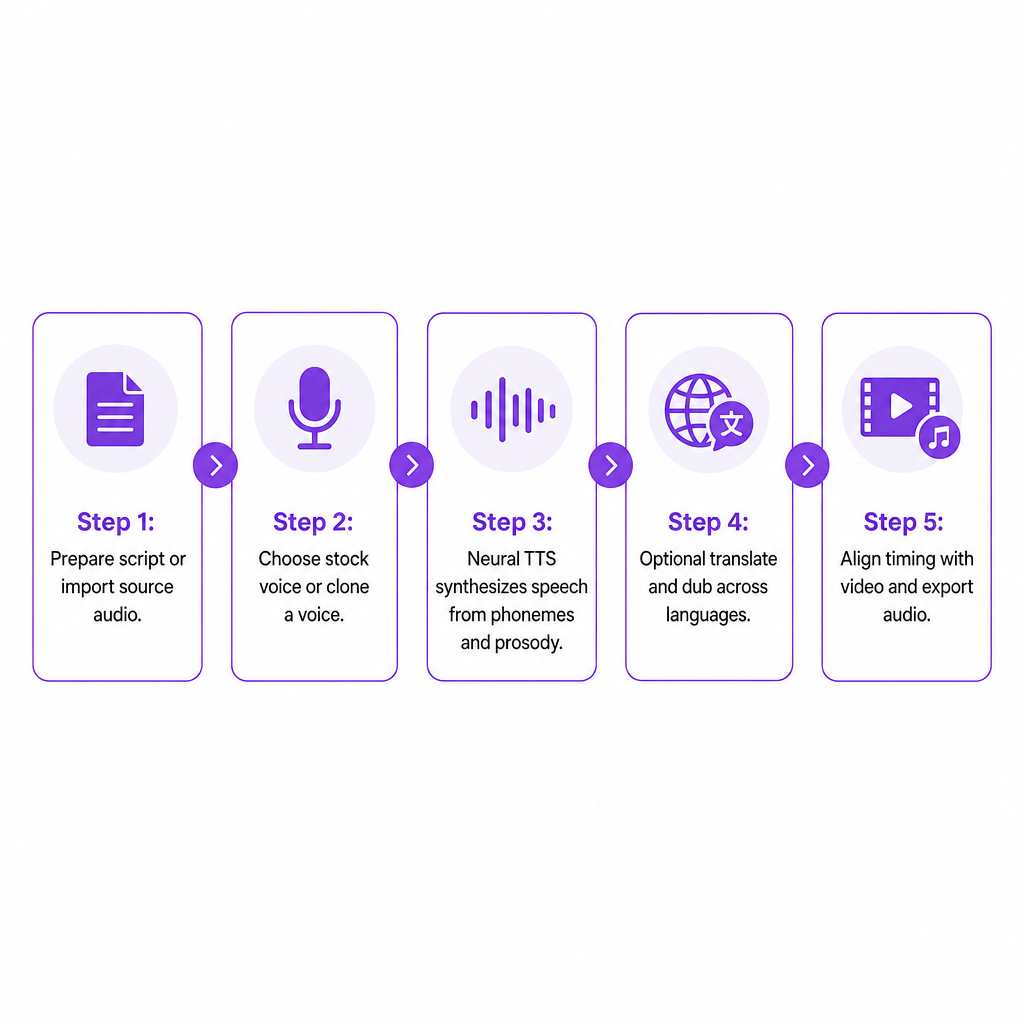
Text-to-speech (TTS) znajduje się w centrum każdego lektora AI. Silnik najpierw analizuje Twój scenariusz — rozbijając tekst na fonemy, odczytując interpunkcję i strukturę oraz wnioskując prozodię, czyli rytm, akcent i intonację, które sprawiają, że mowa nie brzmi płasko. Modele neuronowe następnie syntezują te fonemy w audio i stosują wzorce prozodii, dzięki którym przekaz brzmi płynnie zamiast robotycznie.
Nasz silnik Text to Speech pozwala wkleić tekst w dowolnym języku, wybrać głos z biblioteki liczącej ponad 300 pozycji i wygenerować realistyczną mowę w kilka sekund. Głosy brzmią naturalnie i po ludzku, a są skategoryzowane według języka, płci i stylu, dzięki czemu możesz dopasować ton tego, co tworzysz. Dla deweloperów ten sam silnik jest udostępniany poprzez interfejs RESTful Text to Speech API: wyślij żądanie POST z tekstem i parametrami głosu, a otrzymasz gotowe do użycia pliki audio. Ustrukturyzowany tekst na wejściu, realistyczne audio na wyjściu, bez ręcznego nagrywania.
Modele głosów i biblioteki głosów
Lektorzy AI opierają się na wytrenowanych modelach głosów — sieciach neuronowych, które uczą się, jak dany głos powinien brzmieć w różnych słowach, językach i emocjach. Biblioteka głosów to po prostu katalog tych modeli. Utrzymujemy bibliotekę ponad 300 naturalnie brzmiących głosów obejmujących wiele płci, akcentów i stylów mówienia w wielu językach, a jest ona dostępna zarówno w aplikacji internetowej, jak i przez API, dzięki czemu narzędzia wewnętrzne mogą generować mowę na żądanie.
Klonowanie głosu: sprawianie, by AI brzmiało jak Ty
Klonowanie to mechanizm, który sprawia, że lektor brzmi jak konkretna osoba zamiast generycznego narratora. System analizuje próbkę nagrania, uczy się barwy głosu mówiącego, zakresu wysokości i wzorców wymowy, a następnie stosuje te cechy do nowej mowy syntetycznej.
W praktyce przesyłasz plik audio o długości co najmniej 20 sekund do Voice Cloning — najlepiej czysty i wolny od szumów w tle. Przetwarzamy tę próbkę na niestandardowy profil głosu, który możesz nazwać i wykorzystywać ponownie, przy czym klonowanie zwykle zajmuje tylko kilka sekund. Po utworzeniu sklonowany głos staje się dostępny w Text to Speech i AI Dubbing, dzięki czemu możesz generować scenariusze lub dubbingowane wersje własnym głosem. Programistycznie Voice Cloning API odzwierciedla to: uzyskaj URL do przesłania, wyślij audio w obsługiwanym formacie, utwórz niestandardowy głos z wynikowego klucza pliku, a następnie wykorzystaj go w projektach TTS lub dubbingu.
Dubbing i wielojęzyczni lektorzy
Przejście od lektora jednojęzycznego do treści wielojęzycznych dodaje lokalizację na wierzch podstawowego TTS. Ogólny schemat jest spójny:
- Przechwyć lub zaimportuj oryginalną mowę.
- Transkrybuj ją na tekst.
- Przetłumacz ten tekst.
- Wygeneruj nową mowę w języku docelowym.
- Zsynchronizuj czas z oryginalnym wideo lub audio.
Nasz proces AI Dubbing podąża dokładnie tym schematem, łącząc speech-to-text, tłumaczenie maszynowe i text-to-speech, opcjonalnie wykorzystując ponownie sklonowany głos, aby dubbingowana ścieżka pasowała do oryginalnego mówiącego. Zamienia treści mówione z ponad 60 języków źródłowych na dubbingowane wersje w 33 językach docelowych. Dubbing speech-to-speech dąży do utrzymania tonu i czasu blisko oryginalnego wykonania, co ma największe znaczenie w przypadku e-learningu, szkoleń i treści filmowych, gdzie synchronizacja ruchu warg i tempo tworzą doświadczenie.
API i zautomatyzowane procesy
Dla zespołów produkujących lektorów na dużą skalę API to sposób na wpisanie tworzenia głosu w istniejące systemy. TTS API obsługuje tekst na wejściu, audio na wyjściu; Voice Cloning API dodaje programistyczne tworzenie i zarządzanie niestandardowymi głosami; a AI Dubbing API rozszerza oba o automatyczne tłumaczenie i dubbing w ponad 33 językach z dostępem do sklonowanych głosów. Razem pozwalają budować potoki, w których scenariusze, napisy lub transkrypcje pobierane z systemu treści stają się lektorami lub dubbingowanymi ścieżkami automatycznie, bez ręcznej obsługi plików.
Trzy sposoby tworzenia lektorów AI w DubSmart
Na naszej platformie pytanie sprowadza się do trzech praktycznych punktów wyjścia.
Zacznij od scenariusza z Text to Speech. Wklej tekst, wybierz gotowy lub sklonowany głos, ustaw język i podstawowe elementy sterujące, a następnie wygeneruj mowę, którą możesz pobrać w standardowych formatach. Pasuje to do filmów szkoleniowych, treści wyjaśniających, spotów marketingowych i intro podcastów, gdzie masz scenariusz od samego początku.
Zacznij od istniejących mediów z AI Dubbing. Prześlij źródłowy plik wideo lub audio, pozwól systemowi na transkrypcję i tłumaczenie, a następnie wygeneruj dubbingowane ścieżki w wybranych językach — wykorzystując ponownie sklonowane głosy, aby zachować spójne brzmienie. To ścieżka dla kanałów rozszerzających się na wielojęzyczne grono odbiorców oraz dla firm ponownie wykorzystujących webinary lub prezentacje produktów.
Zacznij od własnych systemów z generowaniem opartym na API. Twoja aplikacja wysyła tekst i parametry głosu do TTS API, opcjonalnie wiąże treść z konkretnym głosem poprzez Voice Cloning API i pobiera audio gotowe do dołączenia do filmów lub lektorów e-learningowych dla modułów szkoleniowych. To odpowiada deweloperom, agencjom i dostawcom LMS, którzy potrzebują spójnych, programistycznych wyników.
Kryteria decyzyjne: wybór konfiguracji lektora AI
Naturalność i jakość audio
Naturalność jest niepodlegająca negocjacjom. Mocne silniki modelują prozodię i artykulację, dzięki czemu mowa płynie z odpowiednimi pauzami i akcentami. Ponieważ generowanie jest szybkie, możesz iterować scenariusz i regenerować audio, aż przekaz będzie brzmiał właściwie, zamiast zadowalać się pierwszym podejściem.
Zasięg językowy i głębia lokalizacji
Jeśli kanały wielojęzyczne lub międzynarodowe szkolenia są na Twojej mapie drogowej, zasięg decyduje o tym, jak daleko możesz sięgnąć. Przekształcanie treści z ponad 60 języków źródłowych na 33 języki docelowe w ramach jednego procesu określa rynki, które możesz obsłużyć, a dubbing speech-to-speech pomaga zachować spójność tonu i czasu we wszystkich wersjach.
Branding głosu i możliwość klonowania
Rozpoznawalny głos ma znaczenie dla firm, twórców i podcastów. Klonowanie pozwala przenosić ten sam głos przez różne języki i kanały. Możliwość sklonowania z około 20 sekund czystego audio i ponownego wykorzystania tego profilu w Text to Speech i AI Dubbing sprawia, że charakterystyczne brzmienie jest praktyczne do ustanowienia i utrzymania.
Prostota procesu a integracja techniczna
Twórcy często chcą, aby przesyłanie, edycja i pobieranie były obsługiwane w jednym miejscu. Zespoły techniczne często potrzebują API. Oferujemy oba: narzędzia skierowane do użytkownika w zunifikowanej aplikacji oraz API dla deweloperów udostępniające te same silniki. Wybór sprowadza się do tego, czy Twój zespół pracuje głównie w przeglądarce, czy buduje na systemach wewnętrznych.
Szybkość, skalowalność i spójność
Narzędzie do lektorów powinno skracać produkcję i skalować się bez spadku jakości. Niemal natychmiastowe generowanie TTS i klonowanie kończące się w kilka sekund pozwalają na szybką iterację i masowe wyniki, a API pozwalają automatycznie przetwarzać tysiące scenariuszy lub segmentów ze spójnymi głosami i ustawieniami.
Struktura budżetu i kontrola
Zamiast opłat za sesję w studiu, narzędzia do lektorów AI zwykle stosują cennik oparty na użytkowaniu. Nasz model oparty na kredytach daje Ci dostęp do AI Dubbing, Text to Speech, Voice Cloning, Speech to Text, Speech Separator, Text to Image i Image to Video w ramach jednego konta, z darmowym poziomem i planami dla przedsiębiorstw. Kredyty zapewniają przewidywalne limity użytkowania, podczas gdy przeniesienie i skalowanie pozostają dostępne, gdy wolumen rośnie. Jeśli chcesz dopasować kredyty do czasu działania, nasze zestawienie kosztu dubbingu AI za minutę omawia matematykę.
Zgodność, zgoda i obsługa danych
Klonowanie i mowa syntetyczna niosą ze sobą wagę etyczną i prawną. Wymagamy, abyś przesyłał audio, do którego masz prawa, i zalecamy czyste nagrania dla najlepszych rezultatów, co utrzymuje zgodę i kontrolę w centrum. Nasza dokumentacja API używa bezpiecznych, wstępnie podpisanych URL-i do przesyłania i standardowych formatów audio, dając deweloperom jasny wzorzec zgodnego użytkowania wewnątrz aplikacji.
Ryzyka warte uwzględnienia w planowaniu
Nawet z zaawansowanymi narzędziami warto przewidzieć kilka trybów awarii.
Nienaturalne lub robotyczne audio zwykle wynika ze źle interpunkcyjnych scenariuszy lub głosu niedopasowanego do treści. Wybór z biblioteki naturalnych głosów i regenerowanie, aż przekaz będzie pasował, to praktyczne rozwiązanie, a szybkie generowanie sprawia, że takie eksperymentowanie jest tanie.
Błędna wymowa zwykle pojawia się przy nazwach, terminach technicznych i treściach zlokalizowanych. Potok, który uruchamia transkrypcję, tłumaczenie i przegląd — zamiast ślepej konwersji audio na audio — wychwytuje więcej takich błędów, zanim trafią do produkcji.
Niedopasowania czasowe między syntezowaną mową a elementami wizualnymi na ekranie szkodzą doświadczeniu widza. Dubbing speech-to-speech, który pozostaje blisko oryginalnego tonu i czasu, w połączeniu z edycją wewnątrz środowiska projektu, daje Ci lepszą kontrolę nad synchronizacją.
Etycznie, klonowanie głosu bez odpowiednich praw zaprasza poważne problemy. Wymaganie czystej próbki pod Twoją kontrolą oraz ujmowanie klonowania jako narzędzia dla twórców i firm, a nie anonimowego podszywania się, to właśnie to, co utrzymuje tę praktykę w ramach odpowiedzialności. Gdy lokalizujesz istniejące materiały, nasz przewodnik dotyczący zmiany języka głosu w wideo pokazuje ścieżkę przyjazną przeglądowi.
Jak różni twórcy wprowadzają to w praktykę
Twórca YouTube rozszerzający się za granicę może przekształcić jedno angielskie wideo w wersje hiszpańską, portugalską i niemiecką za pomocą AI Dubbing i sklonowanego głosu, dzięki czemu prowadzący pozostaje rozpoznawalny na każdym rynku — wszystko w ramach potoku ponad 60 języków źródłowych i 33 języków docelowych.
Mała firma lub zespół marketingowy może stworzyć scenariusz wyjaśniający produkt lub reklamy w dokumencie, przekonwertować go na audio za pomocą Text to Speech i wybrać głos pasujący do tonu marki — energiczny, formalny lub konwersacyjny. Te same scenariusze można później zlokalizować poprzez AI Dubbing przy użyciu sklonowanego głosu marki.
Producent e-learningu lub szkoleń korporacyjnych może zautomatyzować narrację dla prezentacji slajdów i pakietów SCORM, wysyłając tekst lekcji przez TTS API i dołączając zwrócone audio do każdego modułu, przy czym klonowanie utrzymuje spójny głos instruktora nawet w różnych wersjach regionalnych.
Niezależny filmowiec lub twórca podcastów może produkować zwiastuny, promocje lub przetłumaczone dialogi bez rezerwowania studia w każdym języku, łącząc Speech to Text, AI Dubbing i sklonowane głosy, aby utrzymać stałą tożsamość postaci.
Deweloperzy i agencje mogą osadzić API TTS, Voice Cloning i AI Dubbing w narzędziach wewnętrznych lub platformach klienckich, automatyzując wszystko od krótkoformatowych lektorów społecznościowych po interaktywnych agentów głosowych.
Najczęściej zadawane pytania
Czym lektorzy AI różnią się od tradycyjnych nagrywanych lektorów?
Tradycyjni lektorzy potrzebują ludzkiego aktora głosowego, czasu w studiu i wielu sesji. Lektorzy AI są generowani przez silniki text-to-speech i klonowania głosu, które zamieniają scenariusze bezpośrednio w audio przy użyciu wytrenowanych modeli neuronowych zamiast wykonania na żywo.
Czy lektor AI może brzmieć jak konkretna osoba?
Tak. Klonowanie głosu analizuje krótką próbkę czyjegoś głosu i buduje niestandardowy model, który może wypowiedzieć dowolny scenariusz tym głosem, dostępny w naszym narzędziu Voice Cloning i API.
Ile audio potrzeba, aby sklonować głos?
Prosimy o co najmniej 20 sekund czystego audio, wolnego od szumów w tle, aby stworzyć niezawodny profil sklonowanego głosu, przy czym klonowanie zwykle kończy się w kilka sekund.
Czy mogę tworzyć lektorów w wielu językach z jednego źródłowego wideo?
Tak. Łączymy speech-to-text, tłumaczenie i text-to-speech, aby przekształcić treści z ponad 60 języków źródłowych w dubbingowane wyniki w 33 językach docelowych, dzięki czemu jedno oryginalne wideo może wyprodukować wielu zlokalizowanych lektorów.
Czy istnieje sposób na automatyzację tworzenia lektorów zamiast korzystania z interfejsu?
Nasze TTS API i Voice Cloning API pozwalają aplikacjom i narzędziom wewnętrznym wysyłać tekst i próbki audio, tworzyć niestandardowe głosy oraz otrzymywać mowę syntetyczną programistycznie, dzięki czemu lektorzy mogą być generowani automatycznie na dużą skalę.