Separacja mowy przez AI to proces głębokiego uczenia, który wyodrębnia ludzki głos z zaszumionego miksu i zwraca czystą ścieżkę mowy, gotową do transkrypcji, dubbingu lub klonowania głosu. Ta jedna funkcja odpowiada na pytanie, które faktycznie ma większość twórców: czy da się uratować to nagranie bez ponownego kręcenia? Zrozumienie, jak działa separacja mowy przez AI, pomaga zdecydować, kiedy się na niej oprzeć, kiedy od razu nagrywać czyściej i jak czysta ścieżka głosu po cichu poprawia wszystko na dalszych etapach. Ten przewodnik omawia mechanizm, różnicę między wzmacnianiem jednego mówcy a rozdzielaniem wielu, miejsce tego procesu w potoku lokalizacji oraz to, czego nadal nie potrafi naprawić.
Spis treści
Decyzja stojąca za separacją mowy
Każde rzeczywiste nagranie rejestruje znacznie więcej niż samego mówcę. Vlogi, webinary, filmy szkoleniowe i podcasty wychwytują hałas uliczny, akustykę pomieszczenia, podkłady muzyczne, kliknięcia klawiatury i nakładające się rozmowy, które mogą zagłuszyć słowa mające znaczenie. Separator mowy istnieje po to, by rozplątać tę mieszaninę: bierze jeden zmiksowany plik i zwraca ścieżkę zawierającą głównie ludzką mowę oraz opcjonalną ścieżkę zawierającą pozostałe dźwięki tła.
Ta czysta ścieżka głosu staje się fundamentem dla wszystkiego, co następuje potem: dokładnej zamiany mowy na tekst, wielojęzycznego dubbingu, wysokiej jakości klonowania głosu lub po prostu lepiej brzmiącego oryginału. Prawdziwa decyzja nie jest więc techniczna, lecz praktyczna. Czy ufasz swojemu obecnemu materiałowi audio na tyle, by budować na nim treści wielojęzyczne, czy wolisz, aby AI najpierw oczyściło i rozdzieliło mowę? I czy chcesz samodzielnego narzędzia do czyszczenia, czy separatora wbudowanego w szerszą platformę do tworzenia i lokalizacji, żeby nie żonglować kilkoma aplikacjami?
Nasz Separator Mowy zaprojektowaliśmy tak, aby pełnił rolę pierwszej bramki AI w ujednoliconym procesie. Znajduje się przed zamianą mowy na tekst, zamianą tekstu na mowę, klonowaniem głosu i dubbingiem, dzięki czemu każdy kolejny system otrzymuje możliwie najczystszy sygnał głosu zamiast dziedziczyć hałas obecny w pomieszczeniu.
Mechanizm: od przebiegu fali do czystego głosu
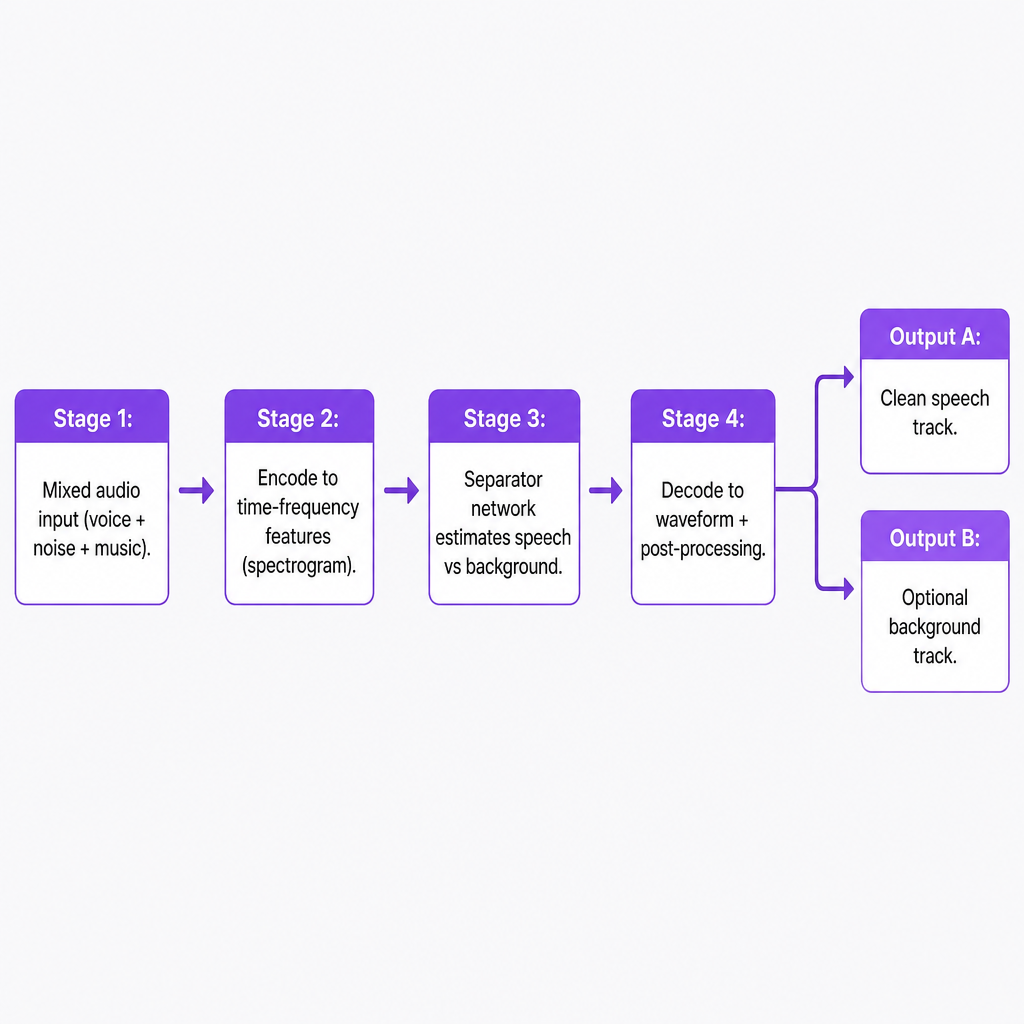
Nowoczesna separacja mowy przez AI przebiega według czteroetapowego potoku: zakoduj sygnał, rozdziel źródła w wyuczonej przestrzeni cech, oszacuj czystą mowę i zdekoduj ją z powrotem do audio.
Od przebiegu fali do cech
Większość systemów najpierw konwertuje surowy przebieg fali z mikrofonu na reprezentację czasowo-częstotliwościową, taką jak spektrogram, który pokazuje, jak energia w różnych pasmach częstotliwości zmienia się w czasie. Taki widok ułatwia sieci neuronowej dostrzeżenie wzorców odpowiadających ludzkiej mowie w odróżnieniu od hałasu lub muzyki. Sieć kodera następnie odwzorowuje wejście na wielowymiarową przestrzeń cech, w której różne źródła dźwięku stają się łatwiejsze do rozróżnienia, podkreślając cechy mowy takie jak formanty, harmoniczne i strukturę czasową, jednocześnie tłumiąc nieistotne treści tła.
Sieci separujące i maski
Sercem procesu jest sieć separująca, głęboki model wytrenowany do oceny, co należy do głosu, a co nie, w każdym punkcie czasowo-częstotliwościowym. Dominują dwie strategie. Separacja oparta na maskach przewiduje maskę dla spektrogramu, która zachowuje energię mowy i tłumi wszystko inne; po zastosowaniu do oryginalnego spektrogramu hałas tła i muzyka gwałtownie spadają, a mowa pozostaje. Bezpośrednie szacowanie źródła zamiast tego przewiduje sam czysty spektrogram mowy, a czasem tło rezydualne, które następnie jest dekodowane z powrotem do audio.
Dla trudniejszych przypadków istnieją bardziej wyspecjalizowane podejścia. Głębokie klastrowanie uczy się osadzenia dla każdego kubełka czasowo-częstotliwościowego tak, aby kubełki z tego samego źródła grupowały się razem, po czym standardowe klastrowanie oddziela mowę od innych źródeł. Inne modele stosują trening niezależny od permutacji, dzięki czemu mogą rozdzielić kilku mówców bez zakładania, który mówca jest wyjściem pierwszym, a który drugim.
Trening z przykładami nadzorowanymi
Modele te uczą się na przykładowych miksach sparowanych z referencyjną czystą mową, dostosowując się tak, aby zminimalizować różnicę między swoim wyjściem a wzorcem. Celami treningowymi mogą być maski, czyste spektrogramy lub zrekonstruowane przebiegi fali, a funkcje straty są często powiązane z miarami jakości percepcyjnej, takimi jak stosunek sygnału do zniekształceń. Nakarmiona wieloma różnorodnymi próbkami obejmującymi akcenty, mikrofony i środowiska, sieć internalizuje solidne wskazówki oddzielające ludzką mowę od treści tła i uogólnia się na nagrania, których nigdy nie widziała.
Dekodowanie z powrotem do audio
Na koniec system odwzorowuje rozdzieloną reprezentację mowy z powrotem na przebieg fali w dziedzinie czasu poprzez transformację odwrotną, po czym następuje przetwarzanie końcowe, takie jak odszumianie i normalizacja głośności. Rezultatem jest ścieżka zdominowana przez mowę, która może występować samodzielnie lub zostać ponownie połączona z kontrolowaną ilością tła dla naturalności. Nasz Separator Mowy działa dokładnie według tego wzorca: pobiera przesłany plik audio lub wideo, uruchamia potok separacji i zwraca ścieżkę skupioną na mowie oraz opcjonalne tło, dzięki czemu to Ty decydujesz, jak suchy lub ambientowy ma być finalny miks.
Wzmacnianie jednego mówcy a separacja wielu mówców
Istnieje ważna granica między wzmacnianiem jednego dominującego mówcy a faktycznym rozdzielaniem kilku nakładających się głosów, i to ona kształtuje to, czego można realistycznie oczekiwać.
Wzmacnianie jednego mówcy izoluje jeden główny głos od hałasu tła, pogłosu i dźwięków niebędących mową, dzięki czemu zrozumiałość skacze w górę. Sprawdza się to szczególnie dobrze w vlogach, webinarach, wykładach i treściach typu talking-head, gdzie problemem jest hałas otoczenia lub podkład muzyczny, a nie przesłuchy. Nasz Separator Mowy jest zoptymalizowany pod ten przypadek: traktuje ludzką mowę jako główne źródło, a wszystko inne jako tło, dostarczając oczyszczoną ścieżkę głosu oraz opcjonalną ścieżkę tła.
Separacja wielu mówców to inne zadanie: rozdzielanie miksu kilku osób mówiących jednocześnie na indywidualne strumienie, po jednym na głos. Modele badawcze rozdzieliły do pięciu głosów z jednego mikrofonu, trenując różne sieci dla różnych liczb mówców i wybierając najlepiej pasujące dopasowanie dla każdej próbki. Techniki takie jak głębokie klastrowanie i neuronowe kształtowanie wiązki z wieloma mikrofonami zwiększają wydajność w ustawieniach dalekiego pola i wielokanałowych, ale są bardziej złożone i obliczeniowo obciążające. W praktyce systemy te wciąż celują w wyspecjalizowane scenariusze, takie jak transkrypcja spotkań, centra obsługi telefonicznej i urządzenia inteligentne, a nie w codzienne procesy twórców. Dla większości naszych użytkowników prowadzących kanały YouTube, zespoły marketingowe czy biblioteki kursów największą praktyczną korzyścią jest silne wzmacnianie jednego mówcy i separacja mowy od tła, a nie pełne rozdzielanie wielu głosów.
Gdzie separacja mieści się w procesie lokalizacji
Separacja jest pomostem między zaszumionymi nagraniami z rzeczywistego świata a wysokiej jakości pracą z głosem AI. Typowa ścieżka przebiega czysto przez kilka narzędzi.
Twórca przesyła plik audio lub wideo, a separator izoluje ścieżkę mowy i opcjonalnie tło. Ta czysta mowa trafia do zamiany mowy na tekst, dzięki czemu transkrypcja i tłumaczenie działają na czystym sygnale, co poprawia dokładność i redukuje halucynowane słowa spowodowane głośną muzyką lub hałasem. Powstały tekst i tłumaczenia przechodzą następnie do zamiany tekstu na mowę i dubbingu AI, które generują nowe wersje językowe przy użyciu sklonowanych lub syntetycznych głosów; ponieważ źródłowa mowa była czysta, dopasowanie czasowe jest precyzyjniejsze, a artefakty miksowania, takie jak pompowanie, są zredukowane.
Klonowanie głosu zależy od tego samego czystego wejścia. Modele potrzebują względnie wolnych od szumów przykładów, aby wiarygodnie nauczyć się barwy, prozodii i artykulacji mówcy, a separacja redukuje zanieczyszczenie tłem, które może zniekształcić sklonowany głos. Nasz hiszpańskojęzyczny przewodnik po separacji dobrze oddaje codzienne doświadczenie: prześlij plik, pozwól AI oddzielić głos od tła, a następnie pobierz albo czystą ścieżkę głosu, albo wyizolowane tło do dalszej edycji, dubbingu czy narracji, wszystko w ramach jednego procesu. Ta konsolidacja jest kluczowa dla małych zespołów, które w przeciwnym razie skaczą między osobnymi wtyczkami redukcji szumów, narzędziami transkrypcji, usługami dubbingu i platformami klonowania.
Wybór i korzystanie z separacji mowy przez AI
Kiedy decydujesz, jak wdrożyć separację, garść praktycznych kryteriów wykonuje większość roboty.
Warunki audio i typ treści. Przy jednym głównym mówcy i umiarkowanym hałasie tła lub muzyce separacja jest bardzo skuteczna i niskiego ryzyka. Przy dużym nakładaniu się głosów, mikrofonach dalekiego pola lub bardzo niskiej jakości wejścia spodziewaj się malejących zysków i połącz AI z lepszym nagrywaniem, zamiast polegać na tym, że uratuje wszystko.
Integracja z narzędziami na dalszych etapach. Separator, który płynnie przechodzi bezpośrednio do transkrypcji, zamiany tekstu na mowę i dubbingu, redukuje tarcia i kumulujące się artefakty w porównaniu z eksportowaniem i ponownym importowaniem między aplikacjami. Łączymy Separator Mowy z resztą naszych narzędzi lokalizacyjnych właśnie z tego powodu, co ma większe znaczenie, gdy Twoim celem jest publikacja wielojęzyczna, a nie jednorazowa redukcja szumów.
Kontrola nad dźwiękiem tła. W storytellingu marki często chcesz zachować część akustyki lub muzyki dla oddziaływania emocjonalnego. Systemy, które generują zarówno czystą ścieżkę mowy, jak i wyizolowane tło, dają montażystom więcej swobody niż narzędzia produkujące tylko jeden odszumiony miks. Nasz separator wspiera ten paradygmat mowy plus opcjonalnego tła, dzięki czemu możesz remiksować z rozmysłem.
Szybkość, prostota i skala. Dla twórców i małych zespołów użyteczność dorównuje surowej wydajności. Separacja jednym kliknięciem przez przeglądarkę lub API, z automatyczną obsługą popularnych formatów, przewyższa złożone łańcuchy wtyczek zakładające ekspertyzę w inżynierii dźwięku. Gdy zarządzasz setkami filmów lub modułów kursów, przetwarzanie wsadowe i automatyzacja przestają być luksusem.
Niezawodność i artefakty. Silny model poprawia zrozumiałość bez dodawania oczywistych zniekształceń, metalicznego dzwonienia czy artefaktów oddechu. Dema mogą pochlebiać systemowi, więc przetestuj go na własnych reprezentatywnych nagraniach, zanim uczynisz jakikolwiek separator stałą częścią swojego potoku.
Prywatność i zgodność. Separacja operuje bezpośrednio na danych głosowych, które mogą zawierać wrażliwe informacje. Zespoły korporacyjne powinny potwierdzić, jak audio jest przechowywane, czy jest wykorzystywane do trenowania modeli oraz jakie istnieją mechanizmy kontroli retencji i dostępu, zwłaszcza w branżach regulowanych i przy wewnętrznych treściach szkoleniowych.
Zważenie tych kryteriów względem Twoich rzeczywistych przypadków użycia, czy to ekspansji kanału, szkoleń, marketingu, pracy narracyjnej czy produktu API, powie Ci, czy zintegrowany separator z dalszymi narzędziami głosowymi pasuje do sposobu, w jaki działasz.
Ryzyka, ograniczenia i czego nie da się naprawić
Nawet silne modele mają twarde granice, które warto znać przed podjęciem zobowiązania.
- Ekstremalny hałas lub bardzo niski stosunek sygnału do szumu. Gdy mowa jest pogrzebana pod głośnym hałasem lub muzyką, model może nie odzyskać każdego słowa, produkując przerwy lub przytłumione wyjście.
- Duże nakładanie się mówców. Ludzie mówiący dokładnie w tym samym czasie stanowią wyzwanie nawet dla zaawansowanych systemów wielu mówców i mogą powodować przenikanie mowy między rozdzielonymi strumieniami.
- Artefakty nadmiernej separacji. Agresywne maskowanie może wprowadzić szum muzyczny lub robotyczną barwę, najbardziej zauważalne przy przeciągłych dźwiękach i sybilantach.
- Rozbieżność treningu z rzeczywistością. Modele dostrojone do określonych mikrofonów, języków lub środowisk mogą działać gorzej na bardzo różnych nagraniach, co następnie obniża dokładność transkrypcji i dubbingu.
- Etyka i prawa. Czysto rozdzielona mowa jest łatwiejsza do transkrypcji, analizy i remiksowania, więc zespoły muszą szanować zgodę i prawa przy ponownym wykorzystywaniu głosów w nowych językach lub kontekstach.
Uczciwy wniosek jest taki, że separacja to potężne ulepszenie, a nie zamiennik rozsądnych nawyków nagraniowych. Dobre mikrofony, rozsądne poziomy i przemyślany wybór lokalizacji nadal się opłacają, a AI następnie mnoży te wybory, czyniąc treść znacznie bardziej elastyczną w lokalizacji i ponownym wykorzystaniu. Jeśli badasz, jak to dopasować do większego setupu publikacyjnego, nasze wyjaśnienie tego, czym jest separator mowy, omawia podstawy bardziej dogłębnie.
Często zadawane pytania
Czym jest separacja mowy przez AI w prostych słowach?
To proces AI, który bierze zmiksowane nagranie i izoluje ludzką mowę, dając Ci czystą ścieżkę głosu oraz, opcjonalnie, osobną ścieżkę tła, którą możesz zachować lub odrzucić.
Czym nasz Separator Mowy różni się od podstawowej redukcji szumów?
Tradycyjna redukcja szumów głównie tłumi hałas stacjonarny. Nasz separator wykorzystuje głębokie uczenie do rozpoznawania wzorców mowy i wyciągania jej z szerokiego zakresu dźwięków tła i muzyki, co zazwyczaj daje czystszy i bardziej naturalny dialog.
Czy poradzi sobie z wieloma mówcami?
Nasz Separator Mowy jest zoptymalizowany do izolowania ludzkiej mowy od tła niebędącego mową, co działa najlepiej z głównym mówcą w miksie. Rozdzielanie kilku nakładających się głosów to aktywny obszar badań i istnieją wyspecjalizowane modele, ale zazwyczaj celują one w spotkania lub centra obsługi telefonicznej, a nie w ogólne procesy twórców.
Dlaczego separacja mowy ma znaczenie dla wielojęzycznego dubbingu?
Lokalizacja opiera się na dokładnej transkrypcji i synchronizacji czasowej. Czysta ścieżka mowy redukuje błędy rozpoznawania i pomaga przetłumaczonym lektorom dopasować się do oryginalnego wideo, ograniczając słyszalne artefakty, gdy nowe głosy są miksowane z zachowaną muzyką i efektami.
Ile wiedzy technicznej potrzebuję, by z tego korzystać?
Bardzo niewiele. Przesyłasz plik audio lub wideo, pozwalasz AI go przetworzyć i pobierasz rozdzielone ścieżki mowy i tła do edycji, dubbingu lub automatyzacji, bez potrzeby ręcznego dostrajania parametrów.