Wybór najlepszych głosów syntezatora mowy do YouTube to nie tyle poszukiwanie jednego „idealnego" głosu, co dopasowanie odpowiedniej konfiguracji głosu do niszy Twojego kanału, planów językowych i tego, jak rzeczywiście tworzysz filmy. W DubSmart AI wybór sprowadza się do czterech praktycznych opcji w ramach jednej przestrzeni roboczej: naszej biblioteki ponad 300 gotowych głosów AI, głosu sklonowanego z Twojego własnego nagrania, tych samych głosów zastosowanych do wielojęzycznego dubbingu oraz głosów sterowanych przez API do zautomatyzowanych procesów. Każda z nich rozwiązuje inny problem, a najlepszy wybór zazwyczaj łączy kilka z nich w miarę rozwoju Twojego kanału.
Ten przewodnik omawia, co każda konfiguracja głosu robi dobrze, gdzie się sprawdza i gdzie ma ograniczenia, abyś mógł podjąć decyzję z pewnością, zamiast zgadywać na podstawie ogólnego rankingu.
Spis treści
Jak wybieramy najlepsze głosy syntezatora mowy do YouTube
Wybieramy głosy i konfiguracje głosu, które sprawdzają się na prawdziwym kanale YouTube, a nie pod kątem abstrakcyjnych rankingów rynkowych. Pięć kryteriów kształtuje każdy wybór poniżej.
Naturalność liczy się najbardziej, ponieważ większość czasu oglądania odbywa się na telefonach przy zmiennej głośności. Głos musi brzmieć ludzko i pozostać wyraźny mimo skompresowanego dźwięku i hałasu w tle podczas dojazdów. Następnie liczy się zakres języków i akcentów: głos jest przydatny dla rozwoju tylko wtedy, gdy możesz go przenieść do nowych regionów bez ponownego nagrywania całego dotychczasowego katalogu. Trzecim filtrem jest spójność marki, ponieważ ten sam głos powinien być możliwy do ponownego użycia zarówno w naszym studiu syntezy mowy, jak i w dubbingu, w tym sklonowany głos, który brzmi jak Ty. Dopasowanie do przepływu pracy decyduje o tym, czy głos jest praktyczny do wygenerowania, edycji i eksportu w ramach realnego harmonogramu produkcji. Wreszcie potencjał automatyzacji decyduje, czy deweloperzy i agencje mogą wywoływać te same głosy przez API do szablonowej lub wielkoskalowej produkcji.
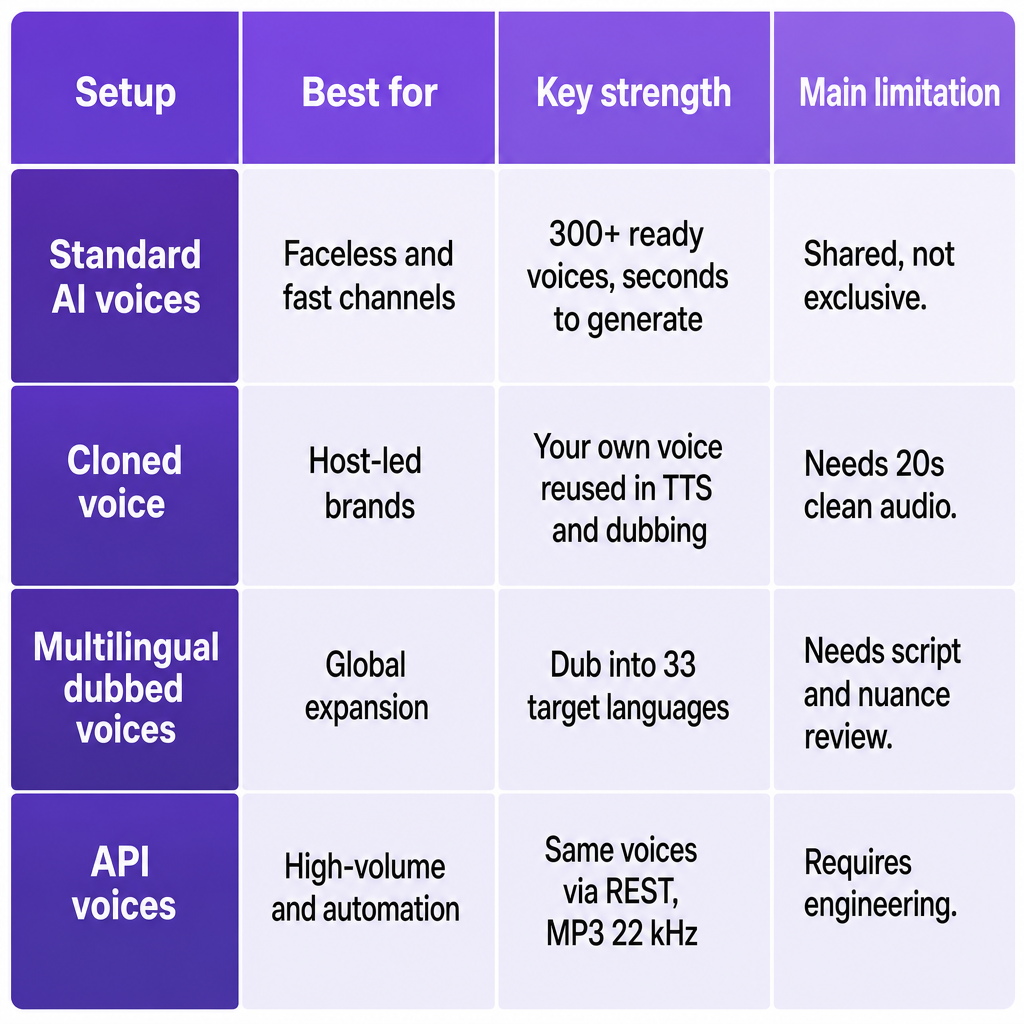
Każda pozycja poniżej ma jedną sekcję z jej cechą wyróżniającą, najlepszym dopasowaniem na YouTube oraz uczciwymi ograniczeniami, wynikającymi z tego, jak te narzędzia faktycznie działają na naszej platformie.
Biblioteka standardowych głosów AI: szybka narracja gotowa do publikacji
Najszybszą drogą do gotowego lektora jest nasz silnik syntezy mowy: wklej skrypt w swoim języku, wybierz spośród ponad 300 głosów AI, wyświetl podgląd i wygeneruj realistyczną mowę w kilka sekund. Możesz wybrać mówcę, dostosować podstawowe ustawienia i wyeksportować standardowy dźwięk, który wstawiasz bezpośrednio do montażu na YouTube. Ten sam katalog jest udostępniany przez nasze API TTS, więc każdy gotowy głos istnieje zarówno w studiu internetowym, jak i w programistycznych przepływach pracy.
Ta konfiguracja pasuje do kanałów bez twarzy i komentatorskich, które cenią szybkość i spójność ponad jedną rozpoznawalną osobowość. Sprawdza się przy analizach wiadomości, listach, materiałach wyjaśniających i pokazach slajdów, które potrzebują czystej narracji przy napiętym harmonogramie, a także przy kanałach e-learningowych, korporacyjnych i marketingowych preferujących neutralny, profesjonalny ton. Twórca może wkleić skrypt, wybrać głos, wygenerować i pobrać materiał dla edytora takiego jak Premiere lub Final Cut, bez dotykania sprzętu nagrywającego. Dla zespołów technicznych nasze API syntezy mowy zwraca pliki MP3 w jakości 22 kHz po prostym żądaniu zawierającym tekst i preferencje głosu, co dobrze wpasowuje się w szablonowe lub oparte na danych procesy produkcji wideo. Jeśli interesuje Cię głębsza mechanika, nasz materiał o tym, jak działa neuronowa synteza mowy, omawia, co dzieje się za każdym renderowaniem.
Kompromisem jest ekskluzywność. Standardowe głosy są współdzielone przez użytkowników, więc silnie zbrandowany, oparty na osobowości kanał może z czasem chcieć czegoś bardziej wyróżniającego. Możesz dostroić język, mówcę i niektóre parametry, ale nie uzyskasz subtelnych niuansów własnego głosu bez klonowania. A ponieważ katalog jest szeroki, znalezienie głosu, który naprawdę pasuje do Twojej publiczności, nadal wymaga kilku testów odsłuchowych, a nie jednego szczęśliwego wyboru.
Sklonowany głos twórcy: rozpoznawalny prowadzący na dużą skalę
Gdy Twoje brzmienie jest częścią marki, klonowanie zmienia wszystko. Nasze klonowanie głosu tworzy niestandardowy głos AI z krótkiej próbki, a następnie udostępnia ten głos wszędzie tam, gdzie pojawiają się standardowe głosy, zarówno w syntezie mowy, jak i w dubbingu. Przesyłasz co najmniej 20 sekund czystego dźwięku bez hałasu w tle, a system tworzy klon do wielokrotnego użytku. Obsługujemy klonowanie dowolnej liczby głosów, więc marka nie jest ograniczona do jednego prowadzącego: możesz sklonować kilku rzeczników lub głosów postaci w zależności od potrzeb.
Sklonowany głos to najlepszy wybór dla kanałów opartych na osobowości, gdzie widzowie subskrybują ze względu na konkretną osobę. Pasuje też do twórców, którzy chcą zachować własny głos, jednocześnie automatyzując części produkcji, takie jak narracja do ujęć B-roll, ścieżki w innych językach czy skryptowane shorty. Jest również podstawą wielojęzycznych kanałów, które chcą zachować spójną tożsamość jednego mówcy w różnych językach, gdy jest połączony z dubbingiem. Po sklonowaniu Twój głos staje się normalną opcją w studiu, gotowy do skryptowanej narracji lub do ponownego udźwiękowienia pełnych filmów w innych językach przy zachowaniu Twojej tożsamości.
Jakość zależy od Twojego nagrania źródłowego. Hałaśliwa lub pogłosowa próbka daje słabszy klon i może wprowadzać artefakty, więc wielu twórców nagrywa dedykowaną czystą próbkę zamiast wykorzystywać dźwięk z transmisji na żywo lub vloga. W różnych językach akcent i prozodia podążają za modelem syntezy, więc wymowa może nie idealnie odpowiadać rodzimemu mówcy w każdym języku docelowym. Klonowanie dodaje też krok konfiguracji przed pierwszym użyciem, co sprawia, że najlepiej sprawdza się dla kanałów nastawionych na długoterminową spójność, a nie na jednorazowy test.
Wielojęzyczne głosy dubbingowe: zamiana jednego kanału w wiele
Najbardziej bezpośrednią drogą do globalnego kanału jest dubbing. Dzięki naszemu dubbingowi AI przesyłasz film, tłumaczysz go i ponownie udźwiękawiasz w dowolnym z 33 języków docelowych, a opcjonalnie stosujesz sklonowany głos do tych dubbingowanych ścieżek. Kluczowy szczegół polega na tym, że dubbing korzysta z tego samego katalogu głosów i sklonowanych głosów, które są używane w syntezie mowy, więc Twoje „najlepsze" głosy dubbingowe to po prostu wybrane przez Ciebie głosy skonfigurowane do przetłumaczonych skryptów. Ponieważ przestrzeń robocza łączy również rozpoznawanie mowy, separator mowy oraz narzędzia do obrazów i wideo, unikasz łączenia oddzielnych dostawców transkrypcji, tłumaczenia, lektora i grafiki.
Pasuje to do kanałów już odnoszących sukces w jednym języku i gotowych do ekspansji bez ponownego nagrywania. Samouczki, recenzje produktów, dokumenty i długie treści o wysokiej wartości odtworzeń uzasadniają wysiłek, podobnie jak firmy, dostawcy e-learningu i zespoły marketingowe, które potrzebują spójnej, zbrandowanej narracji w różnych regionach. Możesz zacząć od istniejących filmów, wygenerować przetłumaczone skrypty i zastosować standardowy głos lub swój sklonowany głos do dubbingowanego dźwięku, tworząc lokalne wersje swojego kanału zachowujące tę samą osobowość. Utrzymywanie syntezy mowy i dubbingu w jednej przestrzeni roboczej ułatwia dopasowanie stylu narracji między wersją oryginalną a przetłumaczoną. Jeśli rozważasz formaty lokalizacji, nasze porównanie dubbingu a napisów pomaga ująć tę decyzję w ramy.
Dubbing dodaje pracy, której nie ma przy narracji jednojęzycznej. Nawet przy silnym tłumaczeniu i syntezie nadal musisz przejrzeć skrypty pod kątem niuansów kulturowych, dostosować przykłady i potwierdzić, że styl głosu pasuje do odbiorców docelowych. Zużywa to też więcej kredytów i wymaga więcej zarządzania eksportem niż jednorazowy klip. Sklonowane głosy zachowują tożsamość, ale synchronizacja ust i timing mogą nie idealnie pasować do oryginalnych materiałów wideo w przypadku szybko mówiących lub mocno animowanych treści, więc spodziewaj się pewnych ręcznych poprawek w edytorze wideo.
Głosy sterowane przez API: zautomatyzowana produkcja na dużą skalę
Dla zespołów produkujących na dużą skalę te same głosy są dostępne programistycznie poprzez trzy punkty końcowe. Nasze API syntezy mowy przekształca tekst w naturalną mowę przy użyciu pełnego zestawu ponad 300 głosów i zwraca pliki MP3 do pobrania w jakości 22 kHz po zakończeniu przetwarzania. Nasze API klonowania głosu pozwala przesyłać próbki i tworzyć niestandardowe głosy używalne w TTS lub dubbingu. Nasze API dubbingu AI pozwala deweloperom i agencjom tłumaczyć i dubbingować filmy programistycznie, osadzając te możliwości bezpośrednio w procesach produkcji treści lub w CMS.
Ta konfiguracja pasuje do kanałów generujących wiele podobnych filmów, takich jak cykliczne skróty wiadomości, podsumowania oparte na danych lub szablonowe materiały wyjaśniające, gdzie skrypty są generowane lub uzupełniane z danych strukturalnych. Sprawdza się u agencji zarządzających wieloma kanałami klientów, które potrzebują powtarzalnego, zautomatyzowanego przepływu głosu, oraz w produktach programistycznych oferujących funkcje automatycznej publikacji, które potrzebują wysokiej jakości lektorów na dużą skalę. Ponieważ sklonowane głosy mogą być przywoływane po ID obok standardowych głosów, automatyzacja nie kosztuje Cię spójności marki: każde renderowanie używa tego samego zamierzonego głosu w różnych filmach i kanałach.
Kosztem jest inżynieria. Przepływy pracy oparte na API wymagają znajomości usług RESTful oraz infrastruktury do przechowywania dźwięku, jego przetwarzania i dołączania do zasobów wideo. Mniejsi twórcy pracujący wyłącznie w edytorze internetowym zwykle nie odniosą korzyści, dopóki nie osiągną znaczącej skali. Zautomatyzowane procesy potrzebują też zabezpieczeń wokół jakości skryptów, timingu i zgodności, ponieważ słabe dane wejściowe nadal dają słabe wyniki, bez względu na to, jak dobry jest głos.
Jak wybrać odpowiednią konfigurację głosu dla swojego kanału
Cztery pytania rozstrzygają większość decyzji. Odpowiedz na nie po kolei, a Twój zestaw głosów ułoży się sam.
Publiczność i format. Jeśli Twój kanał jest bez twarzy, informacyjny lub oparty na listach, zacznij od standardowych głosów AI dla szybkiej realizacji i łatwego testowania tonu. Jeśli widzowie subskrybują właśnie ze względu na Ciebie, zainwestuj w sklonowanie swojego głosu i używanie go zarówno w syntezie mowy, jak i w dubbingu.
Strategia językowa. Jeśli publikujesz w jednym języku, znajdź jeden lub dwa głosy pasujące do Twojego tonu i trzymaj się ich dla spójności. Jeśli planujesz wyjść na świat, projektuj wokół dubbingu: wybierz główny sklonowany głos i przypisz go do dubbingowanych ścieżek w nawet 33 językach docelowych.
Wielkość produkcji. Przy cotygodniowych publikacjach lub okazjonalnych seriach wystarczą internetowe narzędzia syntezy mowy i dubbingu AI. Przy treściach o dużej skali lub opartych na danych zaplanuj przepływ pracy oparty na API, w którym nowe skrypty i zasoby automatycznie uruchamiają generowanie głosu.
Kontrola marki i ryzyko. Używaj standardowych głosów do niskiego ryzyka pilotaży i kanałów, gdzie tożsamość głosu nie jest kluczowa. Używaj sklonowanych głosów z jasnymi wewnętrznymi zasadami dotyczącymi tego, kto może je uruchamiać i gdzie mogą się pojawiać, co ma największe znaczenie dla kanałów korporacyjnych lub zbrandowanych.
Dopasowanie głosów do oczekiwań odbiorców, planów językowych i przepływu pracy to sposób na uniknięcie typowych niepowodzeń: niespójnej narracji, niespodziewanych zmian głosu między filmami oraz przekombinowanych procesów, które są trudne w utrzymaniu. Praktyczna ścieżka to najpierw przetestowanie kilku standardowych głosów, dodanie sklonowanego głosu, gdy Twoja tożsamość zaczyna mieć znaczenie, oraz wprowadzenie API i wielojęzycznego dubbingu, gdy Twoja działalność przerasta ręczne renderowanie.
Najczęściej zadawane pytania
Czy mogę używać głosów AI DubSmart w moich filmach na YouTube?
Nasze narzędzia syntezy mowy i dubbingu AI są zbudowane dla twórców i firm do tworzenia lektorów do treści publicznych, w tym na YouTube, w ramach modelu użytkowania opartego na kredytach. Pozostajesz odpowiedzialny za przestrzeganie warunków YouTube, zasad reklamowych i lokalnych przepisów, ale nasza platforma jest zaprojektowana do komercyjnego wykorzystania mediów.
Ile dźwięku potrzebuję, aby sklonować swój głos?
Potrzebujesz co najmniej 20 sekund czystej mowy bez hałasu w tle, aby stworzyć użyteczny sklonowany głos. Im czystsze nagranie, tym dokładniejszy i bardziej naturalny wynik, więc dedykowana cicha próbka przewyższa hałaśliwy, przetworzony dźwięk.
Czy mój sklonowany głos będzie działał w wielu językach?
Tak. Sklonowany głos jest używalny zarówno w syntezie mowy, jak i w dubbingu AI, które obsługują wiele języków oraz 33 języki docelowe dla dubbingu. Zachowujesz tę samą tożsamość głosu w skryptach w różnych językach, choć wymowa i akcent podążają za modelem syntezy, a nie za naturalną ludzką mową w każdym przypadku.
Czy mogę później przełączyć się ze standardowych głosów na sklonowany głos?
Tak. Traktujemy sklonowane głosy jako głosy wielokrotnego użytku w tym samym katalogu co standardowe głosy AI, więc możesz zacząć od standardowych głosów, a później przełączyć projekty na sklonowany głos przy użyciu tych samych interfejsów syntezy mowy i dubbingu AI lub API, bez przebudowywania przepływu pracy.
Jak API pomagają w produkcji na YouTube?
Nasze API syntezy mowy, klonowania głosu i dubbingu AI pozwalają przekształcać skrypty w mowę, klonować głosy i dubbingować filmy poprzez punkty końcowe RESTful. Dzięki temu praktyczne staje się automatyzowanie cyklicznych formatów, podłączanie lektorów do istniejącego CMS lub procesu montażu oraz skalowanie w wielu kanałach lub językach bez ręcznego uruchamiania każdego renderowania.