Spraak-naar-spraakvertaling zet gesproken woorden in de ene taal om in hoorbare spraak in een andere taal, zodat je publiek de vertaling hoort in plaats van leest. Stel je een docent voor die een les in het Engels heeft opgenomen en nu een Spaanse versie nodig heeft zonder iets opnieuw op te nemen: het systeem transcribeert het Engels, vertaalt de betekenis en genereert daarvoor in de plaats Spaanse audio. Die verschuiving van lezen naar luisteren is het hele punt, en het verandert hoe je meertalige content plant, beoordeelt en publiceert.
De echte vraag is zelden of de technologie werkt. Het gaat erom welke versie ervan je nodig hebt: opgenomen vertaling voor video's, cursussen en podcasts; bijna-realtime vertaling voor vergaderingen en evenementen; stembehoudende output die de identiteit van de oorspronkelijke spreker behoudt; of een API die je in je eigen applicatie kunt inbouwen. Elk van die paden brengt verschillende afwegingen met zich mee op het gebied van kwaliteit, latentie en beoordelingsinspanning, en deze gids brengt ze in kaart zodat je met open ogen kunt kiezen.
Inhoudsopgave
Hoe spraak-naar-spraakvertaling werkt
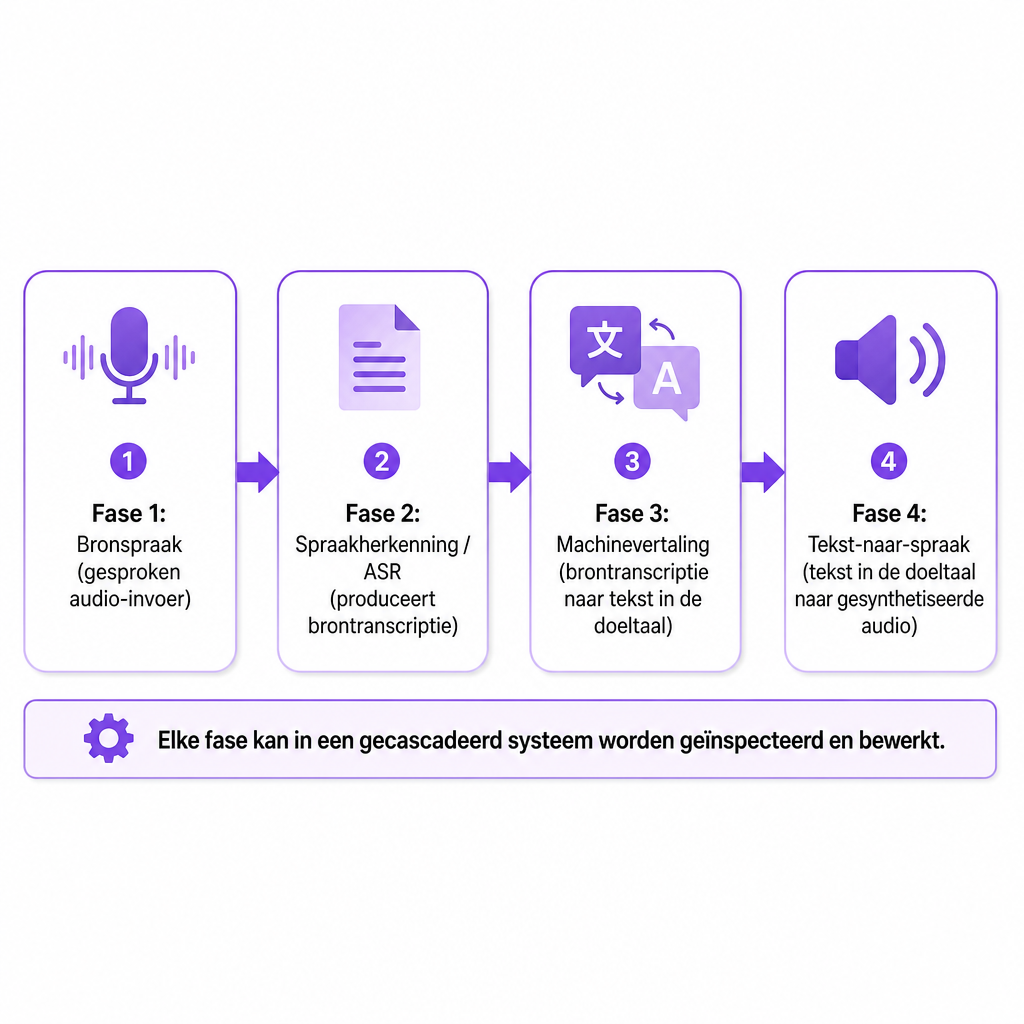
De meeste systemen draaien een verbonden pijplijn van drie technologieën. Eerst analyseert automatische spraakherkenning (ASR) de bronaudio en produceert een transcript. Vervolgens zet machinevertaling die brontaaltekst om naar de doeltaal. Ten slotte verandert tekst-naar-spraak de vertaalde tekst in gesproken audio. De stroom leest helder als bronspraak, dan herkenning, dan vertaalde tekst, dan gesynthetiseerde spraak.
Bronspraak → spraakherkenning → vertaalde tekst → gesynthetiseerde spraak
Dit gelaagde ontwerp wordt cascaded spraak-naar-spraakvertaling genoemd, en de NIST-publicatie over de evaluatie van spraakvertaling beschrijft dezelfde structuur: ASR bouwt het brontranscript, machinevertaling produceert doeltaaltekst en tekst-naar-spraak genereert de gesproken output. Het voordeel van een cascade is dat elke fase inspecteerbaar is, zodat je een transcript of een vertaling kunt corrigeren voordat de audio ooit wordt gegenereerd.
Een nieuwere aanpak traint een end-to-end-model om bronaudio direct naar doeltaalaudio om te zetten zonder aparte transcriptie- en synthesefasen bloot te leggen. Onderzoek gedeeld via het DTIC technisch rapport over directe spraakvertaling schetst dit als een manier om vertraging te verminderen en meer van de stem van de oorspronkelijke spreker te behouden, terwijl wordt opgemerkt dat er nog steeds afwegingen zijn tussen snelheid, context, taaldekking en outputkwaliteit. In de praktijk geeft de cascade je meer redactionele controle; de end-to-end-aanpak jaagt op lagere latentie en stemcontinuïteit.
Spraak-naar-spraakvertaling versus verwante taken
Mensen vermengen spraak-naar-spraakvertaling vaak met transcriptie, tekstvertaling en nasynchronisatie, maar elk eindigt met een ander eindproduct. Tekstvertaling stopt bij geschreven output. Spraak-naar-spraakvertaling eindigt met gesproken output, ook al gebruikt een cascadesysteem intern nog steeds tekst als tussenliggende representatie. Het uitzoeken van de in- en uitvoer behoedt je ervoor het verkeerde gereedschap voor de klus te kiezen.
| Technologie | Invoer | Uitvoer | Typisch gebruik |
|---|---|---|---|
| Spraak naar tekst | Gesproken audio | Geschreven transcript | Ondertitels, notities, doorzoekbare content |
| Tekstvertaling | Geschreven tekst | Vertaalde tekst | Documenten, ondertitels, webpagina's |
| Tekst naar spraak | Geschreven tekst | Synthetische spraak | Voice-over, toegankelijkheid, steminterfaces |
| Spraak-naar-spraakvertaling | Gesproken audio | Vertaalde spraak | Gesprekken, nasynchronisatie, meertalige media |
Nasynchronisatie verdient zijn eigen onderscheid. Spraak-naar-spraakvertaling richt zich nauw op het veranderen van de gesproken taal. Nasynchronisatie is de bredere medialokalisatie-workflow die eromheen zit: dialoog vertalen, sprekers toewijzen, nieuwe stemmen genereren, timing aanpassen, vertaalde stemmen mixen met muziek en achtergrondgeluid, en een afgewerkt project exporteren. Voor een opgenomen YouTube-video, een online cursus, een podcast of een film is nasynchronisatie meestal het praktischere format omdat het die redactionele controles bovenop de vertaling toevoegt. Als je audio afweegt tegen tekst op het scherm, behandelt onze uitleg over nasynchronisatie versus ondertitels voor video die specifieke keuze, en de bredere mechanica staat in onze gids over wat AI-nasynchronisatie is en hoe het werkt.
De drie componenten die de kwaliteit bepalen
Outputkwaliteit is geen enkel getal. Het is het product van drie fasen, elk met hun eigen faalmodi, dus het helpt om ze apart te beoordelen in plaats van op een algemene indruk te vertrouwen.
Automatische spraakherkenning identificeert de woorden in de bronopname, en de nauwkeurigheid daalt bij achtergrondmuziek, overlappende sprekers, sterke accenten, snelle of onvolledige spraak, domeinspecifieke termen, slechte microfoons en code-switching tussen talen. Een veelgebruikte maatstaf hier is de woordfoutenratio (WER), die een automatisch transcript vergelijkt met een menselijke referentie door substituties, weglatingen en invoegingen te tellen. Dezelfde NIST-publicatie gebruikt WER als herkenningsbenchmark, al bevestigt een lage WER niet dat de latere vertaling betekenis of toon heeft behouden. Als je bronaudio ruis bevat, kan het eerst isoleren van schone spraak met een tool zoals onze spraakscheider de herkenningsnauwkeurigheid verhogen nog voordat de vertaling begint.
Machinevertaling moet meer interpreteren dan afzonderlijke woorden. Het behandelt zinsstructuur, context, voornaamwoorden en geslacht, idioom, humor, formaliteit, culturele verwijzingen, technische terminologie en verschillen in woordvolgorde. Een letterlijke vertaling kan grammaticaal correct zijn en toch onnatuurlijk klinken of stilletjes de bedoelde betekenis veranderen, wat vooral riskant is voor reclameclaims, juridische instructies, medische informatie, financiële content en lesmateriaal.
Spraaksynthese genereert de uiteindelijke doeltaalstem en bestuurt uitspraak, pauzes, spreeksnelheid, intonatie, nadruk, emotionele toon, stemidentiteit en accent of taalvariant. Ons Tekst naar Spraak-product biedt meer dan 300 AI-stemmen, meertalige generatie en stemklonen in 33 talen, met controles voor spreeksnelheid, nadruk, getallenlezing en emotionele voordracht. Een technisch nauwkeurige vertaling kan nog steeds slecht overkomen als de voordracht niet past bij het merk, de cursus of de documentaire waartoe het behoort.
Stemklonen in vertaalde spraak
Stemklonen is optioneel, maar het is wat ervoor zorgt dat vertaalde content aanvoelt als dezelfde maker in plaats van een vreemde die een script voorleest. In plaats van aan elke taal een niet-gerelateerde voorraadstem toe te wijzen, kan een systeem een doeltaalvoordracht bouwen gemodelleerd naar de vocale identiteit van de oorspronkelijke spreker. Die continuïteit is belangrijk voor een kanaal dat één herkenbare stem over talen heen wil, een bedrijf met een bekende presentator, een lange cursus onder leiding van een docent, een filmmaker die consistentie over nagesynchroniseerde versies nodig heeft, of een podcasthost die een vertrouwd geluid in vertaalde afleveringen behoudt.
Het is geen garantie. Klonen behoudt de vocale identiteit, maar emotie, humor, tempo, uitspraak en culturele context hebben nog steeds een menselijke controle nodig voordat je publiceert. Even belangrijk is autorisatie: een verantwoorde workflow bevestigt dat wie de opname heeft aangeleverd toestemming heeft gegeven voor klonen en dat de resulterende stem gebruikt mag worden voor de beoogde commerciële, openbare of geografische distributie. Als je nieuwsgierig bent naar de mechanica hierachter, gaat ons overzicht van hoe stemklonen werkt dieper in op het onderwerp, en de Voice Cloning-tool laat de productiekant zien.
Opgenomen vertaling versus realtime vertaling
Dit is de beslissing waar de meeste teams daadwerkelijk mee te maken krijgen, en de twee modi zouden niet met dezelfde maatstaf beoordeeld moeten worden.
Opgenomen vertaling is meestal de betere keuze voor mediaproductie omdat het je tijd geeft om te werken. Je kunt het transcript corrigeren, terminologie bewerken, de vertaling beoordelen, sprekers identificeren, timing aanpassen, stemmen opnieuw genereren, achtergrondaudio mixen en menselijke kwaliteitscontrole uitvoeren voordat er iets wordt gepubliceerd. Dat maakt het zeer geschikt voor YouTube-kanalen, e-learning, bedrijfstraining, podcasts, productvideo's en onafhankelijke films.
Realtime vertaling werkt onder een zwaardere beperking: het moet beginnen met het produceren van output voordat de spreker een zin afmaakt. Meer context verbetert de vertaalkwaliteit maar voegt vertraging toe, terwijl kortere vertragingen voorspellingen of gedeeltelijke vertalingen forceren, en fouten zijn moeilijk terug te nemen zodra de audio al is afgespeeld. Het DTIC-rapport merkt op dat eerdere cascadesystemen vaak draaiden met vertragingen van vier tot vijf seconden, fouten over fasen heen opstapelden en beperkte personalisatie hadden, en dat het vergroten van de vooruitkijk van een model de kwaliteit kan verhogen terwijl de interactie minder direct aanvoelt. Een livevergaderfunctie en een gepolijste meertalige nasynchronisatie lossen verschillende problemen op, dus houd ze aan verschillende standaarden.
Hoe je een spraak-naar-spraak-workflow beoordeelt
Test met een representatief voorbeeld, niet met een nette demozin. De onderstaande checklist weerspiegelt de echte omstandigheden die je content zal tegenkomen, en houdt de beoordeling eerlijk.
- Taal- en dialectdekking: "Ondersteunt Spaans" betekent mogelijk niet het accent, de woordenschat of de regionale voorkeuren die je publiek verwacht. Bevestig bron- en doelvarianten, inclusief Amerikaans versus ander Engels, Latijns-Amerikaans versus Europees Spaans en Canadees versus Europees Frans.
- Transcriptnauwkeurigheid: Een vertaling kan een transcript dat namen, cijfers of producttermen verhaspelt niet betrouwbaar herstellen. Controleer of je het transcript kunt inspecteren en bewerken voordat je audio genereert.
- Betekenis en context: Test bewust idiomen, grappen, oproepen tot actie, productclaims en vakterminologie. Vloeiendheid is geen nauwkeurigheid.
- Sprekerverwerking: Verifieer voor interviews, panels en films of de tool meerdere sprekers kan identificeren en hun stemmen consistent kan houden, ook wanneer mensen elkaar onderbreken.
- Timing en synchronisatie: Vertaalde zinnen komen zelden overeen met de oorspronkelijke duur. Zoek naar timing- of spreeksnelheidcontroles, plus dialoogbewerkingen, behoud van achtergrondaudio, volumeaanpassing, segmentregeneratie en visuele uitlijning waar nodig.
- Natuurlijkheid van de stem: Luister naar uitspraak, pauzes, nadruk, emotioneel bereik en onnatuurlijk ritme.
- Latentie: Meet voor livegebruik de vertraging van spreker naar audio. Geef voor opgenomen gebruik prioriteit aan bewerkingsflexibiliteit boven ruwe verwerkingssnelheid.
- Beoordelings- en exportcontroles: Een productieklare tool laat je tekst corrigeren, individuele segmenten regenereren, timing aanpassen en exporteren in een format dat je publicatieworkflow accepteert.
Laat deze voorbeelden door je shortlist lopen en vergelijk transcriptnauwkeurigheid, vertaalbetekenis, uitspraak, natuurlijkheid van de stem, sprekerconsistentie, timing, achtergrondaudiokwaliteit, beoordelingsinspanning en totale kosten bij je verwachte volume. Het sterkste systeem is niet degene met de meeste stemmen of talen. Het is degene die acceptabele resultaten produceert voor jouw specifieke content met een beoordelingslast die je team daadwerkelijk kan volhouden.
Risico's en beperkingen om rekening mee te houden
Elke fase introduceert zijn eigen soort fout, en een natuurlijk klinkende stem kan ze allemaal verbergen. AI kan dubbelzinnige uitdrukkingen, namen, idiomen en gespecialiseerde termen verkeerd vertalen, dus menselijke beoordeling blijft essentieel overal waar nauwkeurigheid juridisch, veiligheids-, financieel of reputatiegewicht draagt. Herkenningsfouten vergroten het probleem: ruis, overspraak, accenten en slechte opnames kunnen ervoor zorgen dat het systeem de bron verkeerd hoort, en daarom is het beoordelen van het transcript voordat je de vertaling goedkeurt niet onderhandelbaar.
Culturele betekenis is gemakkelijk te verliezen. Een directe vertaling kan humor, beleefdheid of verwijzingen laten vallen die alleen een herschrijving overleven in plaats van een woord-voor-woordvertaling. Stemklonen voegt toestemmings- en imitatierisico toe, dus documenteer wie de stem heeft geautoriseerd, de gebruiksreikwijdte, het territorium, de duur en of deze mag verschijnen in reclame of synthetische openbare verklaringen. Er is ook een dimensie van publieksvertrouwen: het DTIC-rapport beschrijft hoe één vertaalervaring gebruikers informeert dat de vertaalde audio synthetisch is gegenereerd, een redelijke verwachting om in je eigen bekendmakingen op te plannen.
Twee stillere risico's maken de lijst compleet. Privacy is belangrijk wanneer audio persoonlijke informatie, vertrouwelijke discussies, klantgegevens of niet-uitgebrachte content bevat, dus beoordeel de dataverwerking, bewaring, toegang en verwijderingsvoorwaarden van een provider voordat je uploadt. En vals vertrouwen is de meest verraderlijke fout van allemaal: een gepolijste stem laat een onjuiste vertaling gezaghebbend klinken, dus behandel vloeiendheid nooit als bewijs van feitelijke nauwkeurigheid.
Waar DubSmart past
We zijn het meest direct relevant voor opgenomen spraak-naar-spraakvertaling via AI-nasynchronisatie, in plaats van enige claim van universele live gespreksvertaling. Onze nasynchronisatieworkflow accepteert audio- en video-uploads en YouTube-links, ondersteunt meer dan 60 brontalen en 33 doeltalen, kloont de stem van elke spreker voor de vertaalde versie, en laat je tekst, sprekers en timings bewerken, segmenten regenereren, achtergrondgeluidvolume aanpassen en het voltooide project downloaden. Die redactionele laag is precies wat opgenomen mediaproductie nodig heeft.
Voor teams die hun eigen pijplijnen bouwen, bieden we ook AI-nasynchronisatie-, Tekst naar Spraak- en Voice Cloning-API's, die geschikt zijn voor bureaus, mediaworkflows en applicaties die meertalige stemproductie moeten automatiseren. De juiste keuze komt neer op de vraag of je project een afgewerkte media-editor, een API-aangedreven pijplijn, of beide wil. Voor een korte boodschap met veel op het spel kan professionele menselijke vertaling en opname nog steeds winnen; voor een grote, regelmatig bijgewerkte contentbibliotheek schaalt een AI-workflow beter met menselijke beoordeling gericht op het materiaal met het hoogste risico.
Veelgestelde vragen
Is spraak-naar-spraakvertaling hetzelfde als tolken?
Nee. Menselijk tolken vertrouwt op een getrainde persoon die luistert, begrijpt en betekenis op het moment overbrengt. Spraak-naar-spraakvertaling is geautomatiseerd: snel en schaalbaar, maar het kan beoordeling vereisen en kan moeite hebben met nuance die een professionele tolk natuurlijk aankan.
Werkt het altijd in realtime?
Nee. Sommige systemen verwerken opgenomen audio met volledige bewerkingscontrole, terwijl andere live of bijna-realtime output leveren. Live-systemen balanceren voortdurend vertaalcontext, latentie en nauwkeurigheid.
Kan het de stem van de oorspronkelijke spreker behouden?
Soms. Systemen die stemklonen of stembehoudende synthese gebruiken, kunnen de identiteit van de oorspronkelijke spreker modelleren, maar het resultaat hangt af van de technologie, het taalpaar, de audiokwaliteit en de autorisatie om die stem te gebruiken.
Is AI-nasynchronisatie een vorm van spraak-naar-spraakvertaling?
Ja. AI-nasynchronisatie is een opgenomen-mediatoepassing van spraak-naar-spraakvertaling die bewerking, sprekerbeheer, timing, mixen en exportfuncties bovenop de kernvertaling toevoegt.
Hoe nauwkeurig is het?
Nauwkeurigheid varieert per taal, opnamekwaliteit, terminologie, spreker en systeem. Beoordeel het transcript, de vertaling en de gegenereerde audio apart in plaats van te vertrouwen op één nauwkeurigheidspercentage.