Een AI-nasynchronisatie-API is het verschil tussen één video handmatig nasynchroniseren en nasynchronisatie direct inbouwen in alles wat je al publiceert. Eenvoudig gezegd is het een ontwikkelaarsinterface waarmee een applicatie een video- of audiobestand kan versturen, een of meer doeltalen en steminstellingen kan kiezen, en via API-verzoeken een gelokaliseerde versie terugkrijgt in plaats van dat een mens door een dashboard moet klikken. Dus de echte vraag achter wat is een ai-nasynchronisatie-api gaat zelden alleen om definities. Het gaat erom of je een incidentele nasynchronisatietool nodig hebt, of dat lokalisatie herhaaldelijk, op schaal en binnen je eigen product- of contentpijplijn moet plaatsvinden.
Deze gids is de centrale plek voor de ontwikkelaarskant van die beslissing: wat een nasynchronisatie-API daadwerkelijk doet, hoe de workflow is opgebouwd, hoe deze verschilt van een gewone tekst-naar-spraak-aanroep, en hoe je beoordeelt of het de moeite waard is om er een in je stack in te bouwen. Waar het nuttig is, verwijzen we naar onze diepgaandere uitleg in plaats van die hier te herhalen.
Inhoudsopgave
Wat een nasynchronisatie-API daadwerkelijk doet
Een nasynchronisatie-API bundelt verschillende media-verwerkingsstappen die anders afzonderlijke tools zouden vereisen. Vanuit één pijplijn verzorgt het spraakherkenning om de gesproken woorden op te vangen, transcriptie naar tekst, vertaling naar een gekozen taal, sprekerdetectie en -scheiding, stemselectie of -klonen, spraaksynthese in de nieuwe taal, timing en synchronisatie, en ten slotte het renderen van een gelokaliseerd video- of audiobestand om te downloaden.
Die bundeling is wat het onderscheidt van een eenvoudige tekst-naar-spraak-API. Een Tekst-naar-spraak-API begint met tekst die je al hebt en geeft audio terug. Een nasynchronisatie-API begint met opgenomen media en beheert de hele lokalisatieketen eromheen, zodat je applicatie nooit zelf transcriptie, vertaling en stemgeneratie aan elkaar hoeft te knopen. Als je alleen maar een voltooid script invoert, is een tekst-naar-spraak-aanroep de lichtere keuze; als je begint met bestaande beelden, doet de nasynchronisatie-API veel meer onder de motorkap.
De vier lagen van een nasynchronisatie-workflow
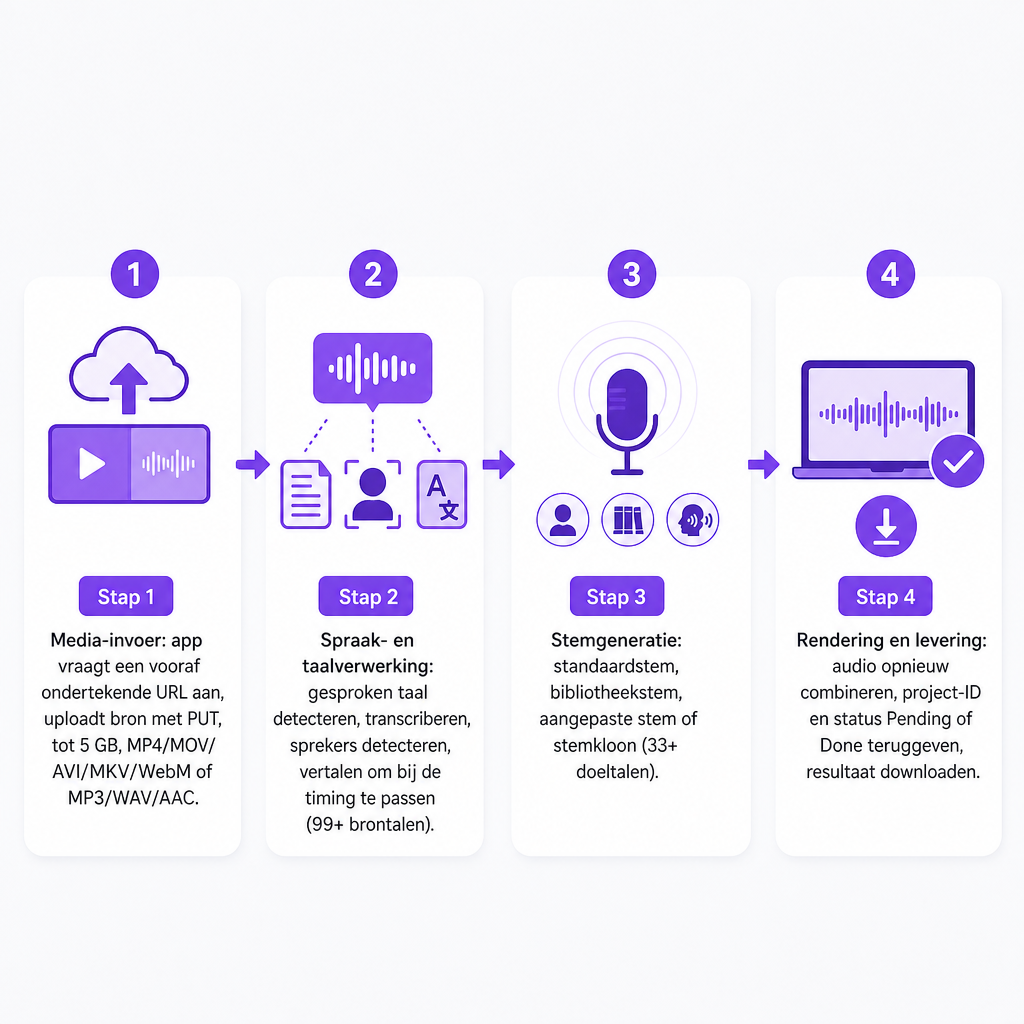
Implementaties verschillen, maar vrijwel elke op API gebaseerde nasynchronisatiestroom valt uiteen in vier logische lagen, en ze begrijpen vertelt je waar dingen goed of fout kunnen gaan.
Media-opname. Je applicatie verstuurt het bronbestand naar de service. Sommige API's accepteren een directe upload; andere gebruiken een openbare media-URL of een tijdelijke uploadlink. Onze gepubliceerde workflow gebruikt een presigned upload-URL: de applicatie vraagt de URL aan en uploadt vervolgens het bestand met een PUT-verzoek. Onze gedocumenteerde API accepteert veelgebruikte videoformaten zoals MP4, MOV, AVI, MKV en WebM, plus audioformaten waaronder MP3, WAV en AAC, tot een maximale bestandsgrootte van 5 GB.
Spraak- en taalverwerking. De service bepaalt wat er is gezegd, welke taal werd gesproken, wanneer elke zin valt en wie er spreekt, en vertaalt vervolgens de transcriptie om bij de beschikbare timing te passen. Dit is de laag waar menselijke controle nog steeds loont voor namen, technische termen, grappen, culturele verwijzingen en merktaal.
Stemgeneratie. De vertaalde tekst wordt spraak met behulp van een standaard synthetische stem, een bibliotheekstem, een aangepaste stem of een kloon van de oorspronkelijke spreker. Onze AI-nasynchronisatie-API ondersteunt stemklonen bedoeld om toon, toonhoogte, accent en spreekstijl te behouden in meer dan 33 doeltalen, met brontaaldetectie voor meer dan 99 brontalen. Klonen is niet automatisch de juiste keuze: een moedertaal-stem kan voor sommige doelgroepen natuurlijker klinken, terwijl een gekloonde stem een terugkerende presentator of docent sterkere continuïteit geeft.
Rendering en levering. De API combineert de gegenereerde spraak opnieuw met de oorspronkelijke media en geeft een nagesynchroniseerde video, aparte audio of afzonderlijke segmenten terug. Onze workflow maakt een project aan, geeft een project-ID terug en een verwerkingsstatus zoals Pending of Done met voortgangsinformatie, en toont downloadbare resultaat-URL's zodra de rendering is voltooid.
API versus de dashboard-nasynchronisatietool
Een online nasynchronisatietool is gebouwd voor een persoon achter een scherm: uploaden, instellingen kiezen, controleren, downloaden. Een nasynchronisatie-API is gebouwd voor software, zodat een ontwikkelaar nasynchronisatie kan koppelen aan een video-uploadplatform, een content- of leermanagementsysteem, een lokalisatiepijplijn, een YouTube-productieworkflow, een mobiele of webapp, of het batchsysteem van een bureau. De onderliggende AI kan identiek zijn; de controle en de ervaring niet.
De keuze komt meestal neer op frequentie en waar het werk plaatsvindt.
| Toepassing | Beter startpunt |
|---|---|
| Af en toe één video nasynchroniseren | Webgebaseerde nasynchronisatietool |
| Elke nieuwe upload lokaliseren | Nasynchronisatie-API of geautomatiseerde integratie |
| Taalkeuze toevoegen binnen een app | Nasynchronisatie-API |
| Een paar trainingsvideo's maken | Webgebaseerde tool, tenzij automatisering belangrijk is |
| Veel bestanden of talen herhaaldelijk verwerken | Nasynchronisatie-API |
| Stemkwaliteit testen voordat je bouwt | Webgebaseerde tool of kleine API-pilot |
Als je antwoord is "ik synchroniseer nu en dan handmatig video's na", begin dan in de browser met AI Dubbing en stap pas over op de API zodra het volume de engineeringtijd rechtvaardigt.
Waarom nasynchronisatie een taak is, geen directe aanroep
Transcriptie, vertaling, synthese, synchronisatie en rendering kosten allemaal echte tijd, vaak langer dan een normaal webverzoek zal wachten. Een productie-integratie moet nasynchronisatie behandelen als een asynchrone taak in plaats van een functie die direct een voltooide video teruggeeft.
Het betrouwbare patroon is: media en instellingen indienen, een project- of taak-ID ontvangen, later de status controleren of een voltooiingsmelding accepteren als webhooks bestaan, de voltooide media en gerelateerde bestanden ophalen, en vervolgens mislukte taken, herhalingen en verlopen downloadlinks afhandelen. Onze openbare API documenteert projectcreatie, projectstatussen, voortgangsregistratie en statusophalen op project-ID, en één verzoek kan meerdere doeltalen bevatten, waarbij gegroepeerde projecten worden gemaakt voor talen zoals Spaans, Frans en Duits tegelijk.
Wanneer je providers vergelijkt, is het opvallende aantal talen minder belangrijk dan deze operationele details. Controleer op polling, webhooks, herhalingsrichtlijnen, idempotentie en duidelijke foutstatussen, want dat is wat een pijplijn stabiel houdt in productie.
Nasynchronisatie-API of aparte spraak-API's
Een nasynchronisatie-API is een end-to-end lokalisatieproduct: je geeft het media en krijgt een andere taal terug met minimale orchestratie. Aparte API's zijn logisch wanneer je meer van de keten zelf wilt beheren. Gebruik een Spraak-naar-tekst-stap om te transcriberen zonder te vertalen, een vertaalstap op een bestaande transcriptie, een tekst-naar-spraak-stap om een voltooid script in te spreken, een Voice Cloning API om een aangepaste stem te maken en te hergebruiken, of een Speech Separator om spraak van muziek te scheiden vóór verwerking.
De beslisregel is eenvoudig. Grijp naar de geïntegreerde nasynchronisatie-API wanneer snelheid en eenvoud winnen. Grijp naar aparte services wanneer je de transcriptie, het vertaalgeheugen, de stempijplijn, het timingmodel of de uiteindelijke renderinglaag moet beheren. Veel teams beginnen geïntegreerd en breken de pijplijn pas op zodra een specifieke fase, meestal vertaalcontrole of audiomixing, een knelpunt wordt.
Wat je via de API kunt bedienen
De instellingen die een nasynchronisatie-API blootstelt, bepalen hoeveel finesse je kunt bereiken zonder de pijplijn te verlaten. Nuttige besturingselementen op API-niveau zijn onder meer brontaal of automatische detectie, een of meer doeltalen, stemselectie en -klonen, aantal sprekers en spreker-naar-stem-toewijzing, achtergrondvolume, bewerkbare vertaaltekst, segmenttiming, ondertitelgeneratie, regeneratie van geselecteerde segmenten, en uitvoerformaat en downloadopties.
Onze gepubliceerde voorbeelden omvatten het ophalen van stemmen gefilterd op taal, geslacht en accent; het ophalen van aangepaste stemmen; sprekerbeheer; segmentbewerking; aanpassing van het achtergrondvolume; en regeneratie van een heel project of slechts geselecteerde segmenten. Die laatste mogelijkheid verdient zijn plaats: wanneer één naam, zin, uitspraak of vertaling verkeerd is, laat regeneratie op segmentniveau je dat deel repareren in plaats van de hele video opnieuw te renderen. Zonder dit kan een correctie van één woord je een volledige render kosten.
Hoe je een nasynchronisatie-API evalueert voordat je bouwt
Een proof of concept dat één schone clip nasynchroniseert, vertelt je vrijwel niets over productiebetrouwbaarheid. Test zeven gebieden grondig voordat je engineeringtijd inzet.
Taaldekking. Negeer het ruwe totaal en controleer de exacte talen en regionale varianten die je publiek nodig heeft. Kan het de brontaal detecteren? Worden dialecten en het vereiste schriftsysteem ondersteund? Zijn er stemmen beschikbaar in elke doeltaal, en zijn de mogelijkheden identiek voor gekloonde en standaardstemmen? Wij adverteren openbaar met meer dan 33 doeltalen en meer dan 99 brontalen, waaronder Engels, Spaans, Portugees, Frans, Duits, Chinees, Japans, Koreaans, Russisch, Arabisch en Hindi; bevestig de huidige lijst en stembeschikbaarheid voordat je erop vertrouwt.
Stemkwaliteit en identiteit. Een perfecte vertaling faalt alsnog als de stem vlak klinkt. Test korte en lange zinnen, vragen, snelle spraak, pauzes, meerdere sprekers, emotionele voordracht, eigennamen, en dezelfde spreker over meerdere video's. Als je een stem kloont, bevestig dan dat je gedocumenteerde toestemming hebt om deze te klonen en te verspreiden, vooral voor commercieel werk en herkenbare personen.
Vertaal- en bewerkingsbesturing. Zoek naar een manier om het vertaalde script te controleren en te corrigeren vóór de uiteindelijke rendering, met segmentbewerking zodat één zin of timingbereik kan veranderen zonder volledige regeneratie.
Invoer- en uitvoerlimieten. Controleer de maximale bestandsgrootte en -duur, ondersteunde formaten, URL- versus bestandsupload, uitvoerformaten, vervaltijd van downloadlinks, bewaarbeleid en batchlimieten. Onze gepubliceerde pagina vermeldt een maximale bestandsgrootte van 5 GB en ondersteunt veelgebruikte video- en audioformaten.
Integratieontwerp. Een bruikbare API is meer dan één endpoint. Bekijk authenticatie, uploadverwerking, projectcreatie, statusophalen, foutstatussen, herhalingen, paginering, stemdetectie, segmentbewerking, resultaatdownloads, gebruiksrapportage en webhooks of een ander voltooiingsmechanisme. Houd inloggegevens op je server, nooit in browser- of mobiele-appcode.
Kostenmodel. De werkelijke kosten hangen af van de bronduur, het aantal doeltalen, het aantal sprekers, klonen, opnieuw renderen, opslag, transcriptiegebruik, API-aanroepen en prioriteitsverwerking. Ga er niet van uit dat één nagesynchroniseerde minuut gelijkstaat aan een volledig lokalisatieproject; schat het aantal gerenderde taalversies, inclusief revisies. Onze openbare API-pagina beschrijft de functieset maar publiceert daar geen API-prijzen, dus vraag de actuele commerciële voorwaarden op voordat je budgetteert.
Privacy, rechten en beveiliging. Voordat je media naar een derde partij stuurt, verduidelijk je bewaartermijnen, of bestanden modellen trainen, waar gegevens worden verwerkt, hoe verwijdering werkt, wie eigenaar is van gegenereerde audio, welke rechten gelden voor gekloonde stemmen, of commercieel gebruik is toegestaan, en of er enterprise-controles bestaan. Een API kan een ongeautoriseerde opname, script, uitvoering of stem niet juridisch bruikbaar maken; je hebt de rechten vooraf nodig.
Risico's en wanneer een API de verkeerde keuze is
Automatisering schaalt fouten net zo efficiënt als het output schaalt, dus ken de faalmodi. AI-vertaling kan context, humor, idiomen of culturele verwijzingen missen en toch vloeiend klinken. Vertaalde spraak is vaak langer of korter dan het origineel, wat onnatuurlijke pauzes, gehaaste voordracht of overlappingen veroorzaakt. Gekloonde stemmen kunnen emotioneel detail of uitspraak verliezen, en verslechteren bij ruizige audio, overlappende sprekers, muziek of zeer korte samples. Muziek en effecten verlagen de nauwkeurigheid van transcriptie en sprekersscheiding, dus schonere bronaudio levert betere resultaten op. Klonen zonder toestemming creëert een reëel risico op nabootsing, en daarom zijn gedocumenteerde autorisatie en beperkte toegang tot aangepaste stemmen belangrijk.
Een API is de verkeerde keuze wanneer je slechts één korte video nodig hebt, wanneer de content genuanceerd acteerwerk vereist, wanneer de bronopname ruizig of slecht gescheiden is, wanneer je een dialect nodig hebt dat de API niet ondersteunt, wanneer je organisatie geen media naar een externe verwerker mag sturen, of wanneer elke regel professionele taalkundige en voordrachtcontrole vereist. De meest betrouwbare opzet is meestal hybride: automatiseer transcriptie, vertaling, stemgeneratie en rendering, zet dan een persoon op het script en de uiteindelijke audio voordat er iets wordt gepubliceerd, en houd dat controlepunt verplicht voor onderwijs-, reclame-, gezondheidszorg-, financiële en juridische content.
Waar de DubSmart AI-nasynchronisatie-API past
Onze AI-nasynchronisatie-API is gebouwd voor teams die vaak genoeg media lokaliseren om een integratie te rechtvaardigen in plaats van handmatige nasynchronisatie. De gepubliceerde API dekt meer dan 33 doeltalen, detectie en verwerking voor meer dan 99 brontalen, stemklonen om sprekerskenmerken te behouden, meerdere doeltalen in één projectverzoek, presigned bestandsuploads, bearer-token-authenticatie, projectcreatie en statusophalen, spreker- en segmentbewerking, selectieve regeneratie, video- en audiodownloads, ondersteuning voor veelgebruikte formaten, een maximale bestandsgrootte van 5 GB, en commercieel gebruik over al zijn abonnementen.
Als je dit afzet tegen het bredere API-landschap, kadert onze Wat Is een Voice AI-API? Een Gids voor Beginners de vijf API-typen, en Wat Is een Tekst-naar-spraak-API en Hoe Werkt Het? behandelt het alleen-voordracht-geval. Wanneer je klaar bent om het in te bouwen, bevat de AI-nasynchronisatie-API-pagina de actuele voorbeelden en mogelijkheden. Voor een quickstart-patroon op een naburige service toont onze uitleg over hoe je een Voice Cloning API integreert het upload-create-generate-ritme dat je ook bij nasynchronisatie zult herkennen.
Veelgestelde vragen
Wat is een AI-nasynchronisatie-API?
Het is een software-interface die gesproken media vertaalt en automatisch nagesynchroniseerde audio of video genereert, meestal met een combinatie van transcriptie, vertaling, spraaksynthese, synchronisatie en media-rendering in één workflow.
Is een AI-nasynchronisatie-API hetzelfde als tekst-naar-spraak?
Nee. Tekst-naar-spraak zet aangeleverde tekst om in audio. Een nasynchronisatie-API begint met opgenomen video of audio en beheert transcriptie, vertaling, stemgeneratie en synchronisatie eromheen.
Kan een AI-nasynchronisatie-API de stem van de oorspronkelijke spreker klonen?
Sommige kunnen dat. Onze gepubliceerde AI-nasynchronisatie-API bevat stemklonen bedoeld om de kenmerken van de oorspronkelijke spreker in de doeltaal te behouden, onder voorbehoud van gedocumenteerde toestemming.
Kan ik een video in meerdere talen tegelijk nasynchroniseren?
Sommige API's ondersteunen meerdere doeltalen in één projectverzoek. Onze gepubliceerde workflow toont één verzoek dat gegroepeerde projecten voor Spaans, Frans en Duits aanmaakt.
Wat ontvangt een applicatie na het indienen van een nasynchronisatietaak?
Doorgaans eerst een project- of taak-identificatie. De applicatie bewaakt vervolgens de verwerking en haalt de voltooide video, audio, transcriptie, ondertitels of segmenten op zodra ze klaar zijn.