Een spraakscheider wordt gebruikt om een gesproken stem uit een rommelige opname te halen—weg van verkeer, muziek, galm in de ruimte, of een tweede persoon die praat—zodat je een schoner stemspoor overhoudt dat je kunt transcriberen, bewerken, nasynchroniseren of hergebruiken. Die ene taak ligt ten grondslag aan een verrassend aantal alledaagse productietaken. Een YouTuber verwijdert straatgeluid uit een interview. Een podcastproducent redt dialoog die is opgenomen in een druk café. Een marketingteam bereidt een schoon sample voor voordat een stem wordt gekloond. De tool doet één ding goed, en precies begrijpen wat dat ding is voorkomt dat je hem taken laat uitvoeren waarvoor hij nooit is gebouwd.
Zie het als een opschoonlaag in plaats van een creatielaag. Hij vertaalt niet, genereert geen nieuwe vertelstem, en vermomt geen spreker. Hij neemt audio die al spraak bevat en geeft je die spraak met minder storing eromheen. Alles hieronder loopt door waar dat daadwerkelijk helpt, hoe het onderliggende model het probleem benadert, en wanneer je in plaats daarvan beter naar een andere tool kunt grijpen.
Inhoudsopgave
Hoe een spraakscheider echt werkt
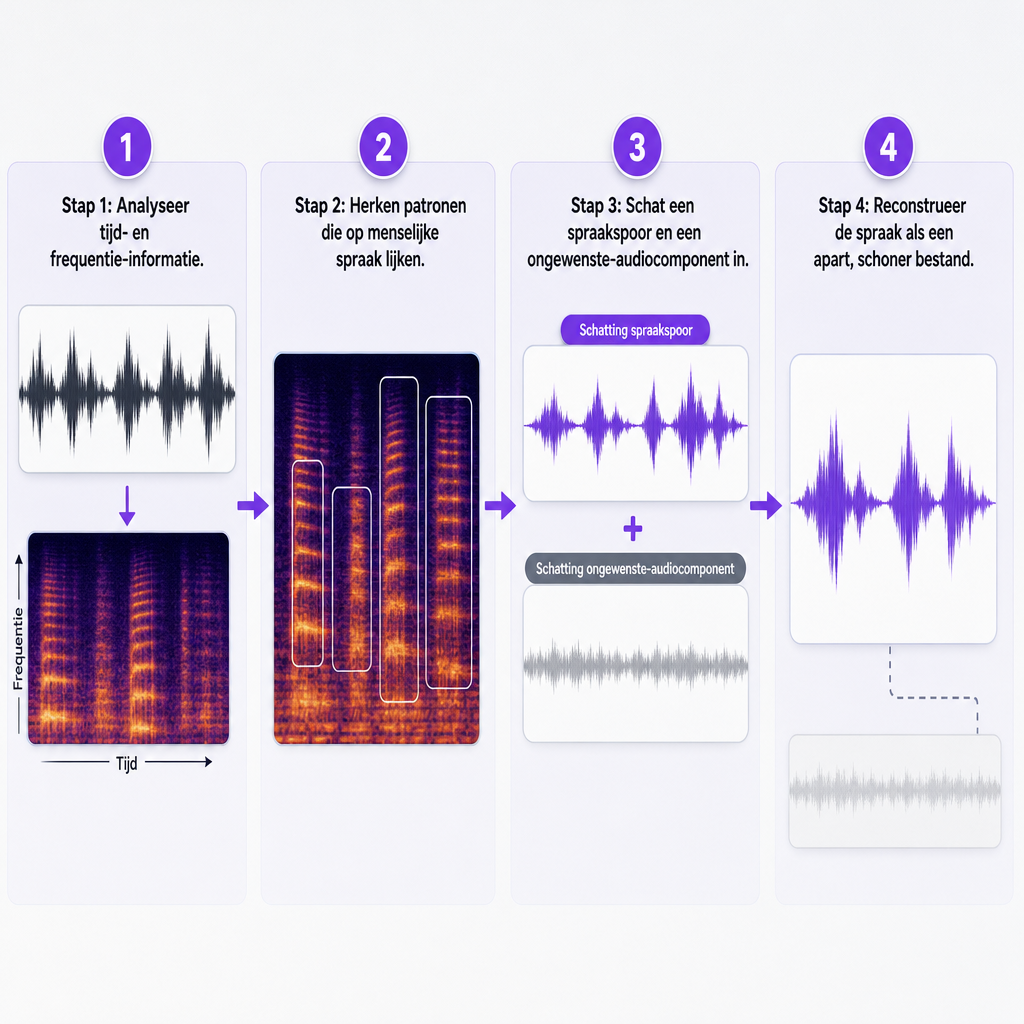
Onder de knop zit een AI-model dat is getraind om de patronen te herkennen die menselijke spraak kenmerken en deze te onderscheiden van al het andere in de mix. Het leest de tijd- en frequentie-informatie van de opname, schat welke delen van het signaal stem zijn en welke ongewenst geluid, en reconstrueert vervolgens de spraak als een apart, schoner bestand. Veel systemen gebruiken een op maskers gebaseerde aanpak: spraakgerelateerde delen van het signaal mogen door, terwijl andere elementen worden verminderd. Geavanceerdere pipelines stapelen ruisonderdrukking, sprekerscheiding en degalming op elkaar. Onderzoek van Microsoft beschrijft realtime single-channel-systemen die deze fasen combineren om meerdere sprekers uit ruis en galm te halen.
De belangrijke kanttekening zit in het woord reconstrueren. De output is niet de originele schone opname die je had willen vastleggen. Het is een AI-schatting van hoe de spraak zou moeten klinken zonder de storing, dus complexe mengsels kunnen artefacten opleveren—metaalachtige tonen, weggevallen medeklinkers, getril of onnatuurlijke overgangen. De prestaties nemen ook af in realistische far-field- en galmomstandigheden, zoals onderzoek naar spraakscheiding op praktijkopnames documenteert. Hoe verder de microfoon van de spreker stond en hoe meer de ruimte galmde, hoe moeilijker de taak van het model wordt.
Scheiding versus ruisverwijdering: waarom het label ertoe doet
Deze termen worden door elkaar gebruikt, maar de taak die je echt nodig hebt verandert welke tool past. Ruisverwijdering verlaagt ongewenst achtergrondgeluid. Spraakverbetering maakt een bestaande stem makkelijker te verstaan. Spraakscheiding haalt de stem uit een werkelijk gemengd signaal. Sprekerscheiding gaat een stap verder en probeert aparte sporen te maken wanneer twee mensen tegelijk praten. En vocale scheiding splitst muzikale stems, wat een andere discipline is die zich op liedjes richt in plaats van dialoog.
| Taak | Hoofddoel | Voorbeeld |
|---|---|---|
| Ruisverwijdering | Ongewenst achtergrondgeluid verminderen | Verkeer of airco-gezoem verlagen |
| Spraakverbetering | Spraakverstaanbaarheid verbeteren | Een stil interview beter hoorbaar maken |
| Spraakscheiding | Spraak uit een gemengd signaal extraheren | Dialoog isoleren van muziek of omgevingsgeluid |
| Sprekerscheiding | Elke spreker een apart spoor geven | Twee mensen die door elkaar praten splitsen |
| Vocale scheiding | Muzikale elementen in stems splitsen | Zang extraheren uit een instrumentale track |
Onze Spraakscheider bevindt zich aan de kant van spraakisolatie en achtergrondruisverwijdering in die tabel. Zijn taak is je een schoner stemspoor te bezorgen, en de productpagina noemt film, podcasts, interviews, voice-overs en voorbereiding van stemkloning als de workflows waar hij omheen is gebouwd. Hij accepteert gangbare audioformaten zoals MP3, WAV en AAC, plus videobestanden. Weten in welke kolom je zit voorkomt dat je per-spreker-stems verwacht van een tool die is afgestemd op het opschonen van stem-uit-ruis.
De acht taken waarvoor mensen een spraakscheider inschakelen
De toepassingen overlappen, maar elke lost een iets ander probleem op. Ze als afzonderlijke taken lezen helpt je te beslissen of scheiding de juiste eerste stap is of dat een andere tool eerder in de keten thuishoort.
Interviewopnames opschonen. Interviews vinden zelden plaats in akoestisch behandelde ruimtes. Kantoren, straten, evenementen en huizen laten allemaal geluid in de opname lekken. Scheiding vermindert die afleiding en maakt het onderwerp beter hoorbaar voordat je bewerkt, ondertitelt of nasynchroniseert. Wat het niet kan doen is spraak verzinnen die nooit is vastgelegd—als de microfoon te ver weg stond of een luide band de stem bedolf, is er misschien niets schoons te herstellen.
Podcastaudio verbeteren. Toetsenbordgeratel, ventilatoren, geruis en galm verdringen allemaal een gesprek. Een schoner spoor maakt later werk makkelijker: pauzes bijsnijden, sprekers balanceren, clips knippen en shownotes schrijven. Wanneer meerdere mensen tegelijk praten, hangen de resultaten sterk af van de mate van overlap, en modellen die zijn afgestemd op overlappende sprekers kunnen hun eigen verwerkingsartefacten introduceren.
Audio voorbereiden voor spraak-naar-tekst. Transcriptie-engines doen hun beste werk wanneer woorden duidelijk zijn en de storing laag is. Eerst scheiding uitvoeren verbetert vaak een transcriptie-, ondertitelings- of bijschriftronde. Onze Spraak-naar-tekst-tool transcribeert audio en video en genereert ondertitels in meerdere talen, en de nauwkeurigheid verandert nog steeds met audiokwaliteit, accenten en opnameomstandigheden. Behandel scheiding als een voorbereidingsstap, geen garantie: in sommige gevallen kunnen verbeteringsartefacten de herkenningsnauwkeurigheid juist verminderen, dus het vergelijken van de opgeschoonde en originele sporen is de moeite waard voor alles wat belangrijk is.
Dialoog opschonen voor videopostproductie. Editors vechten regelmatig tegen wind, verkeer, gezoem, microfoonhantering en doorsijpelende achtergrondmuziek. Een bruikbaar dialoogspoor kan vervolgens worden gemixt met effecten of een vervangende voice-over, en het resultaat vertelt je vaak of een scène in postproductie te redden is of een verse opname nodig heeft. Agressieve verwerking kan de natuurlijke ruimtetoon wegstrippen, dus professionele releases verdienen nog steeds het oor van een editor.
Input voor stemkloning verbeteren. Een kloonmodel leert de kenmerken van een spreker uit een sample, en ruis, muziek en galm maken dat moeilijker. Schonere input leidt doorgaans tot een beter resultaat, en daarom presenteren we scheiding als voorbereidingsstap voor klonen op de Spraakscheider-pagina. Dit is het belangrijkst wanneer je enige sample afkomstig is van een video met muziek, een telefoonopname of een livestream. Het sample moet juridisch en ethisch bruikbaar zijn: upload alleen audio die je bezit of die je mag verwerken, en verkrijg toestemming van de spreker voordat je een kloon maakt of inzet.
Helderdere voice-overs maken. Wanneer opnieuw opnemen onhandig is maar een vertelopname matige ruis bevat, kan scheiding deze genoeg opschonen om over video te plaatsen, met muziek te combineren of in short-form te knippen. Het zal geen nieuwe vertelstem genereren—als de opname echt onbruikbaar is, past een tekst-naar-spraak- of stemkloningsroute beter.
Lokalisatie en nasynchronisatie ondersteunen. Voordat je een video vertaalt, wil je vaak een schoon dialoogspoor zodat je kunt transcriberen, ondertitelen en nasynchroniseren terwijl je de achtergrond behoudt of opnieuw mixt. We bieden ook AI-nasynchronisatie voor het lokaliseren van content, maar scheiding en nasynchronisatie doen verschillende taken: scheiding schoont de bronaudio op, terwijl nasynchronisatie spraak in een andere taal genereert.
Spraak uit ruisige archieven herstellen. Oude beelden, webinars, opgenomen vergaderingen en door gebruikers gegenereerde clips worden soms verstaanbaar genoeg voor begrip of een ruwe transcriptie. Controleer bij juridisch, medisch, financieel of compliance-gevoelig materiaal de output tegen het origineel, want AI-verwerking kan woorden wijzigen of laten vallen.
Wanneer je er een gebruikt en wanneer je opnieuw opneemt
Scheiding verdient haar plek wanneer de stem aanwezig is maar gemaskeerd door matige storing, wanneer je een schoner dialoogspoor nodig hebt om te bewerken, wanneer je input verbetert vóór transcriptie of klonen, of wanneer opnieuw opnemen simpelweg niet praktisch is. De rode draad is dat er herstelbare spraak in het bestand aanwezig is.
Het heeft moeite wanneer de stem extreem stil of onverstaanbaar is, wanneer meerdere mensen voortdurend door elkaar praten, wanneer muziek de stem volledig maskeert, of wanneer de opname ernstige galm of vervorming bevat. Het is ook de verkeerde tool wanneer je forensische of broadcast-kwaliteit restauratie nodig hebt, of wanneer exacte woord-voor-woord-nauwkeurigheid essentieel is en niemand het resultaat zal controleren. Hoe ernstiger de storing, hoe groter de kans op hoorbare artefacten—en praktijkfactoren zoals microfoonafstand, galm en meerdere sprekers verminderen allemaal de scheidingsprestaties. Als de originele opname vervormd of bedolven is, klinkt een verse opname meestal natuurlijker dan alles wat je kunt redden.
Hoe je een spraakscheider evalueert voordat je kiest
Kies de tool op basis van de specifieke opname die je moet repareren, niet een schone democlip. Een paar criteria onderscheiden een goede match van een frustrerende.
- Type scheiding. Bepaal of je spraak uit ruis, dialoog uit muziek, de ene spreker van de andere, of zang uit een instrumentale track nodig hebt. Een tool gebouwd voor spraakisolatie produceert mogelijk geen apart spoor voor elke stem in een gesprek.
- Invoerformaten en limieten. Bevestig dat de tool je bronbestand accepteert. Onze Spraakscheider ondersteunt MP3, WAV, AAC en videobestanden; controleer toch de maximale bestandsgrootte en exportformaten vóór een groot project.
- Audiokwaliteit onder echte omstandigheden. Test een sample met de slechtste achtergrond in je project, zodat je de tool beoordeelt op je moeilijkste geval in plaats van je makkelijkste.
- Output-artefacten. Luister naar metaalachtige tonen, ontbrekende medeklinkers, hakkelende lettergrepen, doorsijpelende muziek en getril tijdens overlappende spraak. Vergelijk voor belangrijke content de verwerkte output met het origineel en controleer de transcriptie handmatig.
- Workflow-compatibiliteit. Controleer wat de volgende stap nodig heeft. Als transcriptie volgt, zorg dan dat de output in een bruikbaar formaat downloadt; als klonen of nasynchronisatie volgt, bevestig dat de bestanden overgaan zonder zinloze conversie.
- Privacy en toestemming. Audio kan persoonsgegevens of identificeerbare stemmen bevatten. Bevestig dat je toestemming hebt om deze te uploaden en te verwerken, en behandel kloonsamples met extra zorg, aangezien een opgeschoond sample een stem makkelijker reproduceerbaar maakt.
Hoe scheiding past in een DubSmart-lokalisatieworkflow
Scheiding werkt zelden alleen. Het is de opschoonlaag aan het begin van een langere keten, en de omringende tools bepalen hoeveel waarde het toevoegt. Voor een maker die een interview lokaliseert, ziet een verstandige volgorde er zo uit:
- Draai Spraakscheider om de dialoog te isoleren en op te schonen.
- Stuur de opgeschoonde audio naar spraak-naar-tekst voor een bewerkbare transcriptie.
- Controleer namen, technische termen, getallen en eventuele onduidelijke delen.
- Vertaal of pas de goedgekeurde tekst aan.
- Genereer de nagesynchroniseerde of ingesproken audio via de juiste stemworkflow.
- Vergelijk de uiteindelijke audio met het origineel op betekenis, toon en timing.
Dat patroon past evengoed bij YouTube-kanalen, podcasts, online cursussen, marketingvideo's en onafhankelijke films. De scheider handelt de ene taak af waar hij goed in is; hij vervangt geen transcriptie, vertaling, montage of toestemmingsbeheer. Wanneer je die rollen gescheiden houdt, krijgt elke tool een eerlijke input en houdt het afgeronde resultaat stand.
Veelgestelde vragen
Kan een spraakscheider achtergrondmuziek verwijderen?
Hij kan spraak van achtergrondmuziek verminderen of isoleren, maar het resultaat hangt af van hoe luid, complex en stemachtig de muziek is. Luister altijd naar doorsijpelende muziek en spraakartefacten voordat je op de output vertrouwt.
Kan spraakscheiding transcriptie verbeteren?
Meestal wel—storing opschonen maakt spraak makkelijker leesbaar voor een transcriptie-engine. Maar verbetering kan af en toe artefacten introduceren die de nauwkeurigheid schaden, dus belangrijke transcripties hebben nog steeds een menselijke controleronde nodig.
Kan ik een spraakscheider gebruiken vóór stemkloning?
Ja. Een schoner sample geeft een kloonmodel betere input. Gebruik alleen audio die je bezit of die je mag verwerken, en verkrijg toestemming van de spreker voordat je een kloon maakt of inzet.
Scheidt het twee mensen die tegelijk praten?
Sommige spraakscheidingssystemen proberen dit, maar overlappende sprekers zijn veel moeilijker dan gewone ruisverwijdering. Resultaten variëren met microfoonkwaliteit, overeenkomst tussen sprekers, galm en hoeveel de stemmen overlappen.
Is een spraakscheider hetzelfde als een stemvervormer?
Nee. Een scheider schoont of isoleert spraak die al bestaat. Een stemvervormer transformeert de vocale identiteit van een spreker. Scheiding verschilt ook van spraak-naar-tekst, tekst-naar-spraak, stemkloning en AI-nasynchronisatie—verwante tools die verschillende problemen oplossen.