Als je microfoon verkeer, cafégekwebbel of een muziekbed opvangt dat pal boven de dialoog zit, is de vraag niet of de opname bruikbaar is—maar hoe je de stem er weer schoon uithaalt. Dat is precies wat een spraakscheider doet. Simpel gezegd is een spraakscheider een AI-gestuurde audiotool die menselijke spraak isoleert van al het andere in een opname—achtergrondgeluid, muziek en andere geluiden—zodat je een schoon stemspoor overhoudt dat je kunt transcriberen, dubben, klonen of remixen. Voor iedereen die meertalige content produceert, is dat schone spoor het verschil tussen dubbing die professioneel klinkt en dubbing die "goed genoeg" klinkt.
Deze gids legt uit wat een spraakscheider eigenlijk is, hoe het onder de motorkap werkt, wanneer je er echt een nodig hebt en wat je moet afwegen voordat je voor een tool kiest. We bouwen de Spraakscheider in de DubSmart AI-workflow juist omdat schone spraak het fundament is waar al het andere op rust.
Inhoudsopgave
Wat een spraakscheider echt is
In audio-onderzoek wordt spraakscheiding gedefinieerd als de taak om doelspraak te scheiden van achtergrondinterferentie in een gemengde opname. Geavanceerdere systemen gaan verder en splitsen meerdere sprekers van elkaar, waarbij ze een geïsoleerd spoor voor elke stem produceren.
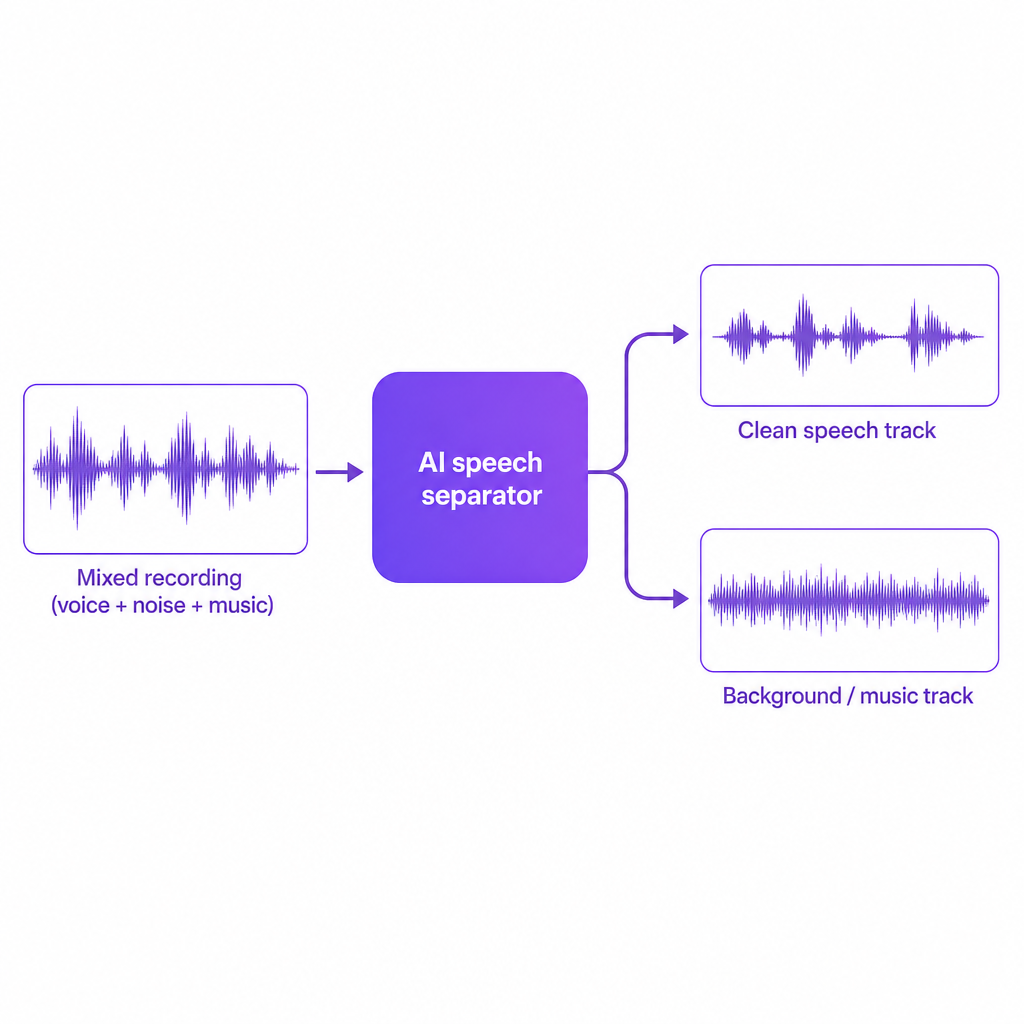
Vertaald naar het dagelijkse productiewerk neemt een spraakscheider een gemengd audiobestand—dialoog plus ruis of muziek—en levert het een of meer sporen op die alleen spraak bevatten, plus een optioneel spoor met de resterende achtergrondaudio. Onze Spraakscheider is gebouwd om achtergrondgeluid te verwijderen en spraak te isoleren uit elke opname, wat het uitstekend geschikt maakt voor de postproductie van films, podcasts en interviews. Het werkt op zowel audio- als videobestanden: het kan opnames uit luidruchtige omgevingen ruisvrij maken en zang scheiden van een begeleidingsspoor, zodat je losse stem- en achtergrondstems overhoudt.
Hier struikelen mensen over een veelvoorkomende misvatting. Een spraakscheider is niet hetzelfde als traditionele ruisonderdrukking. Ruisonderdrukking verlaagt het volume van ongewenst geluid. Een spraakscheider identificeert actief waar spraak in het signaal aanwezig is en reconstrueert deze als een aparte, schonere stroom. Dat onderscheid is de reden waarom een scheider een stem kan redden die onder muziek bedolven ligt, terwijl een ruispoort de hele opname meestal alleen maar stiller maakt.
Heb je er echt een nodig?
De echte beslissing is of je werk afhankelijk is van betrouwbare, schone spraakaudio in plaats van wat de microfoon toevallig heeft opgevangen. Als dat zo is, is een speciale scheider niet langer een leuke bonus maar een fundamentele stap.
Verschillende situaties maken die stap voor de hand liggend. YouTube-makers en kleine bedrijven hergebruiken vaak oudere beelden die zijn opgenomen in galmende ruimtes, cafés of op straat, waar ruis spraak moeilijk te verstaan en moeilijk te transcriberen maakt. E-learning- en trainingsteams bouwen meertalige cursussen op basis van live webinars en colleges, waarbij elk stroomafwaarts transcript en elke dub de kwaliteit van de oorspronkelijke spraak overneemt. Filmmakers en podcastproducenten moeten vaak een geweldige uitvoering redden die onder imperfecte omstandigheden is vastgelegd voordat ze deze weer mixen met muziek en sounddesign. En ontwikkelaars of bureaus die gebruikersaudio invoeren in transcriptie-, stemklonings- of dubbingpijplijnen weten dat ruizige invoer de modelnauwkeurigheid direct omlaag haalt.
Een paar concrete triggers geven aan dat een scheider de moeite van het overnemen waard is:
- Je lokaliseert naar meerdere talen en wilt consistente, duidelijke dubbing en ondertitels. Schone spraak voedt onze AI-dubbing- en Spraak-naar-tekst-engines veel betrouwbaarder dan een ruizige mix.
- Je vertrouwt op stemkloning voor een merk- of personagestem en wilt de best mogelijke resultaten door te trainen op ruisvrije, artefactvrije samples.
- Je ontvangt regelmatig door gebruikers gegenereerde of veldopnames die je niet in de hand had, en die toch uitzendklaar moeten zijn. Een scheider geeft je een herhaalbare opschoonfase in plaats van elk bestand handmatig af te stellen.
De eerlijke uitzondering: als je audio al is opgenomen in een akoestisch behandelde studio, met aparte stems voor dialoog en muziek, is een scheider een gemak in plaats van een vereiste. Voor iedereen die met geluid uit de echte wereld werkt, verdient het een permanente plek in de pijplijn.
Hoe spraakscheiding onder de motorkap werkt
Moderne spraakscheiding is gebouwd op deep learning en bronscheidingsonderzoek, niet op eenvoudige EQ en filters. De onderliggende taak is eenvoudig te formuleren en lastig op te lossen: gegeven een gemengd signaal dat meerdere bronnen bevat, herstel de individuele spraaksignalen zonder ze vooraf te kennen.
De meeste huidige systemen volgen een encoder–scheider–schatter–decoder-pijplijn. De encoder brengt de ruwe golfvorm of het spectrogram in kaart naar een hoogdimensionale feature-ruimte waar spraakrelevante patronen zoals formanten en harmonischen gemakkelijker te detecteren worden. De scheider—een neuraal netwerk—verwerkt die features en leert informatie te ontkoppelen die tot verschillende geluidsbronnen behoort, of dat nu spraak versus ruis is of de ene spreker versus de andere. De schattingsfase voorspelt vervolgens ofwel maskers die niet-spraakcomponenten eruit filteren, ofwel schat direct de feature-representatie van elke bron. Ten slotte zet de decoder die gescheiden representaties terug om in tijddomein-audio, wat een of meer schone spraaksporen oplevert en optioneel een resterend achtergrondspoor.
Deze modellen worden getraind op grote datasets vol spraak-en-ruismengsels, waarbij ze de onderscheidende patronen van spraak, sprekers en interferentie leren van gelabelde voorbeelden. Nieuwer onderzoek conditioneert de scheider op speaker-embeddings of prompts, wat het mogelijk maakt om de scheiding te richten op een specifieke stem binnen drukke audio.
De praktische conclusie voor makers is dat een moderne scheider geen opgepoetste ruispoort is. Het is een model dat heeft geleerd hoe spraak eruitziet en klinkt onder veel omstandigheden, en het kan een stem reconstrueren, zelfs als deze bedolven ligt onder muziek, menigtegeluid of galm.
De twee belangrijkste scheidingstaken
In de praktijk kom je twee varianten van spraakscheiding tegen, en platforms combineren ze vaak.
De eerste is spraak van één spreker versus achtergrond: het extraheren van één samenhangend stemspoor uit ruis, muziek of omgevingsgeluid. Dit is de taak waar onze Spraakscheider zich op richt voor films, podcasts en interviews, omdat het direct aansluit op wat de meeste makers dag in dag uit nodig hebben.
De tweede is scheiding van meerdere sprekers, waarbij het systeem een apart spoor produceert voor elke spreker in een gesprek. Dat is vooral nuttig voor diarisatie en analyse bij langere vergaderingen of paneldiscussies, waar weten wie wat zei net zo belangrijk is als wat er werd gezegd.
Consumententools verpakken deze meestal in eenvoudige interfaces—upload een nummer om aparte zang- en instrumentaalsporen te krijgen, of isoleer dialoog in een video voor bewerking. Onze implementatie legt de nadruk op scheiding van spraak versus achtergrond omdat het de meest direct waardevolle taak is voor dubbing-, transcriptie- en kloningsworkflows.
Wat je moet afwegen voordat je een scheider kiest
Wanneer je beoordeelt of een scheider aan professionele behoeften voldoet, doet een handvol criteria er meer toe dan marketingteksten.
Begin met spraakkwaliteit en artefacten. Een goede scheider behoudt de natuurlijke klankkleur van een stem in plaats van deze metaalachtig, onderwater- of faserig te laten klinken, en vermijdt het introduceren van muzikale ruis of harde vervorming wanneer sterke achtergrondelementen zoals muziek eruit worden gestript. Academische overzichten benoemen resterende interferentie en artefacten als de belangrijkste uitdagingen, vooral bij niet-stationaire ruis. De betrouwbaarste test blijft het controleren van voorbeelduitvoer op je eigen materiaal.
Robuustheid tegen ruis uit de echte wereld komt daarna. Modellen die zijn getraind op schone labdata kunnen moeite hebben met verkeer, wind, gemompel van menigten, galmende ruimtes en content waar spraak overlapt met luide muziek of effecten. State-of-the-art werk richt zich precies op deze complexe mengsels, maar de prestaties variëren nog steeds met de opnameomstandigheden—dus test in de omgevingen waarin je daadwerkelijk opneemt, van kantoren tot straten tot thuisstudio's.
Het omgaan met muziek en gemengde content is een veelvoorkomende, specifieke behoefte. Het verwijderen van een soundtrack om te herdubben, of het isoleren van vertelling van B-roll, vraagt om een tool die expliciet scheiding van muziek en stem ondersteunt en twee bruikbare bestanden oplevert in plaats van één gedempt resultaat. Onze scheidingspijplijn detecteert zangfrequenties, isoleert ze van de muziek en produceert aparte hoogwaardige bestanden: één met schone zang en één met het muziekbed. Dat is vooral nuttig wanneer je van plan bent te remixen, opnieuw te scoren of naar andere talen te herdubben.
Integratie met stroomafwaartse tools bepaalt hoeveel tijd de scheider daadwerkelijk bespaart. Scheiding staat zelden op zichzelf—het voedt transcriptiemodellen waar schonere invoer de woordfoutpercentages verlaagt, stemklonings-engines die ruisvrije samples belonen, en dubbingsystemen die originele spraak uitlijnen met vertaalde sporen. Ons platform is gebouwd rond een uniforme workflow die Spraakscheider, Spraak-naar-tekst, Tekst-naar-spraak, Stemkloning en AI-dubbing op één plek houdt, zodat één opgeschoonde opname meertalige, gekloonde-stem, volledig gelokaliseerde content kan worden zonder telkens een pijplijn opnieuw te bouwen.
Latentie, schaal en automatisering doen ertoe voor iedereen met een achterstand. Langere podcasts, cursussen en archieven hebben batchverwerking nodig die meer-uursbestanden aankan, redelijke verwerkingstijden per bestand en automatiseringshaken waar scheiding binnen je eigen systemen zit. We bieden Tekst-naar-spraak-, Stemklonings- en AI-dubbing-API's zodat ontwikkelaars spraakverwerking in end-to-end-pijplijnen kunnen inbouwen.
Ten slotte verdwijnen privacy en compliance niet zodra audio schoon is. Het scheiden van spraak van achtergrond ontslaat je niet van je verantwoordelijkheid voor opnames die gevoelige gesprekken kunnen bevatten, of voor het respecteren van rechten wanneer je stemmen uit gelicentieerd materiaal extraheert en hergebruikt. Enterprise-teams moeten duidelijk beleid over gegevensbewaring en -gebruik bevestigen en elke scheidingsworkflow afstemmen op interne compliancerichtlijnen.
Waar het tekortschiet
Een spraakscheider kan een opname transformeren, maar het is geen magie, en doen alsof dat wel zo is leidt tot slechte beslissingen.
Over-ruisonderdrukking is de meest voorkomende valkuil. Agressieve scheiding kan subtiele spraaksignalen wegstrippen—zachte medeklinkers, natuurlijke ruimteklank—en een stem onnatuurlijk of vermoeiend om naar te luisteren achterlaten. Resterende artefacten zijn de keerzijde: onder moeilijke omstandigheden kan een model sporen van muziek of ruis in het spraakspoor achterlaten, of muzikale ruis genereren, vooral wanneer de interferentie sterk is en voortdurend verandert.
Er is ook spreker- en taalbias om rekening mee te houden. Modellen die overwegend op bepaalde talen, accenten of spreekstijlen zijn getraind, kunnen slechter presteren op ondervertegenwoordigde stemmen. En een schoon ogende golfvorm kan een vals gevoel van veiligheid creëren: het garandeert niet dat de audio geschikt is voor kritieke taken zoals forensische analyse of strikte compliancecontexten.
Voor creatief en lokalisatiewerk zijn deze beperkingen beheersbaar, maar ze vormen een sterk argument om te testen met representatieve samples van je eigen materiaal in plaats van te vertrouwen op demo's van leveranciers.
De Spraakscheider binnen onze workflow
We beschouwen de Spraakscheider als een praktische, makervriendelijke implementatie van deze technologie, strak geïntegreerd met de rest van het DubSmart AI-platform in plaats van er losjes op vastgeschroefd.
In gebruik verwijdert het achtergrondgeluid en isoleert het spraak uit elke opname, waarbij het schone stem produceert die geschikt is voor postproductie in films, podcasts en interviews. Het extraheert heldere zang uit gemengde sporen en genereert aparte hoogwaardige bestanden voor spraak en achtergrondmuziek, zodat je kunt bewerken, herdubben of remixen zonder tegen de originele mix te vechten. Het werkt op zowel audio- als videobronnen—je uploadt bestanden of gebruikt links, laat ze door de pijplijn lopen en downloadt de afgewerkte sporen. En cruciaal: die uitvoer is geoptimaliseerd om onze andere tools te voeden, zodat één opgeschoonde opname kan worden omgezet in meertalige, gekloonde-stem, volledig gelokaliseerde content.
Voor YouTube-makers, kleine bedrijven, trainers, filmmakers, podcasters en ontwikkelaarsteams verandert die integratie de rol van scheiding zelf. Het houdt op een geïsoleerde "repareer de audio"-klus te zijn en wordt de eerste gestandaardiseerde stap in een grotere, geautomatiseerde levenscyclus van contentcreatie en lokalisatie. Als je een meertalig kanaal of cursusbibliotheek bouwt, is dat waar de echte tijdsbesparing zich opstapelt.
Veelgestelde vragen
Wat is een spraakscheider, eenvoudig gezegd?
Het is een AI-tool die een ruizige, gemengde opname neemt en een spoor oplevert waar je voornamelijk alleen de menselijke stem hoort, plus optionele achtergrondsporen die je kunt behouden of weggooien.
Is een spraakscheider hetzelfde als ruisonderdrukking?
Nee. Ruisonderdrukking verlaagt simpelweg ongewenste geluiden. Spraakscheiding identificeert en reconstrueert spraak expliciet als een aparte bron, meestal met hogere helderheid en meer controle over het resultaat.
Kan een spraakscheider meer dan één spreker aan?
Veel systemen op onderzoeksniveau en sommige producten kunnen meerdere sprekers in individuele sporen scheiden, hoewel de kwaliteit varieert met overlap en opnameomstandigheden. Onze Spraakscheider richt zich primair op het isoleren van spraak van achtergrond voor gangbare makerworkflows.
Verbetert het gebruik van een spraakscheider mijn dubbing- en stemkloningsresultaten?
Ja. Schonere invoeraudio verbetert over het algemeen spraakherkenning, uitlijning en stemkloningskwaliteit, wat meertalige dubbing en gekloonde stemmen natuurlijker en consistenter maakt.
Werkt spraakscheiding ongeacht de taal?
De meeste scheidermodellen werken op akoestische patronen in plaats van tekst, dus ze kunnen veel talen aan. De prestaties hangen nog steeds af van de trainingsdata en hoe goed je accent vertegenwoordigd is.