Een realtime AI-stemvervormer zet je stem tijdens het spreken om in een andere stem door microfoonaudio op te vangen, te analyseren, de identiteit van de spreker te transformeren en de geconverteerde audio met een korte vertraging terug te spelen. In tegenstelling tot een eenvoudig toonhoogte-filter kan het veel van je woorden, timing en expressie intact houden, terwijl eigenschappen zoals timbre, waargenomen leeftijd, genderpresentatie of karakterstijl worden veranderd. En anders dan tekst-naar-spraak begint het bij live spraak in plaats van getypte tekst.
De echte beslissing voor makers, streamers, docenten en bedrijven is niet simpelweg of het resultaat realistisch klinkt. Het gaat erom of de tool past bij jouw invoertype, latentietolerantie, behoeften aan stembeheersing, integraties, rechtenverplichtingen en gewenste productiekwaliteit. Deze gids legt uit hoe de technologie werkt, waar ze past ten opzichte van verwante AI-stemtools, en wanneer een opgenomen workflow je beter van dienst is.
Inhoudsopgave
Wat "realtime" eigenlijk betekent
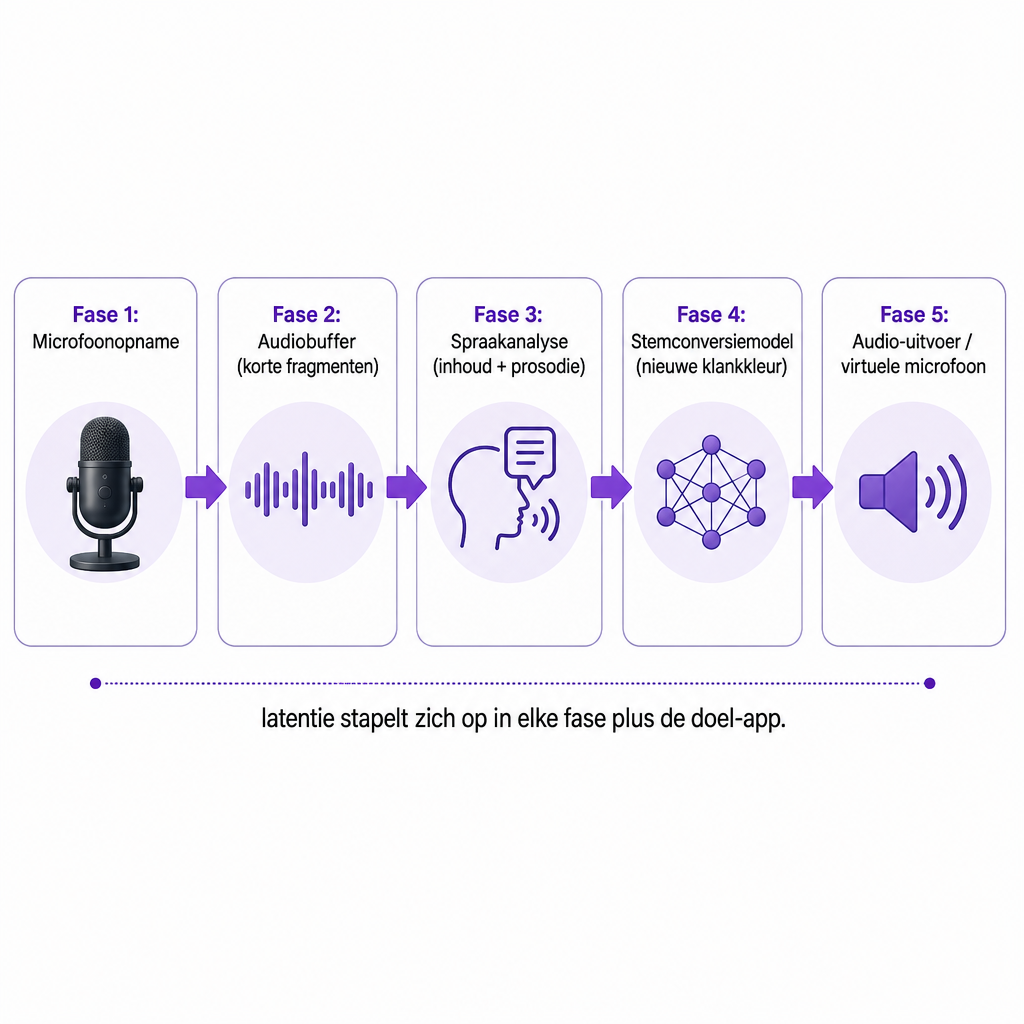
"Realtime" betekent dat het systeem een binnenkomende audiostroom verwerkt terwijl je spreekt, in plaats van te wachten op een volledige opname of een afgerond script. Het signaal legt een doorlopend pad af: microfoon, audiobuffer, spraakanalyse, stemconversiemodel, audio-uitvoer. Omdat de vervormer werkt op korte segmenten in plaats van volledige zinnen, is streaming stemconversie technisch anders dan het renderen van een afgeronde voice-over waarbij het hele script vooraf bekend is.
Enige vertraging is onvermijdelijk. Het systeem heeft tijd nodig om elke audiobrok op te vangen, te analyseren, te synthetiseren en uit te voeren. Onderzoek toont aan dat conversie met lage latentie haalbaar is, al hangen de cijfers sterk af van het model, de hardware, de buffergrootte en de audiokwaliteit. Het LLVC-onderzoeksmodel rapporteert een latentie van minder dan 20 milliseconden op een consumenten-CPU, terwijl StreamVC een end-to-end latentie van 70,8 milliseconden rapporteert in zijn evaluatieomgeving. Dit zijn onderzoeksresultaten onder specifieke omstandigheden, geen prestatiegaranties voor commerciële tools die je zou kunnen downloaden.
Hoe een realtime AI-stemvervormer werkt
Het proces loopt als een lus terwijl je praat, niet als een enkele render. Inzicht in de vier fasen helpt je te beoordelen waarom de ene tool natuurlijk aanvoelt en de andere robotachtig of traag.
Eerst legt het systeem je spraak vast. Het ontvangt audio van een microfoon of een andere live-invoer en verdeelt deze in korte stukken zodat het model deze continu kan verwerken. De invoerkwaliteit telt zwaarder dan veel gebruikers verwachten. Achtergrondgeluid, galm in de ruimte, toetsenbordgeklepper, clipping en een instabiel signaal duwen de conversie allemaal richting onnatuurlijke artefacten.
Ten tweede scheidt het de spraakinhoud van de identiteit van de spreker. Een stem draagt meerdere overlappende lagen tegelijk: de taalkundige inhoud, oftewel de woorden; de prosodie, oftewel ritme, nadruk en intonatie; de toonhoogte; het timbre dat een stem herkenbaar maakt; en de bredere identiteit van de spreker. Conversiesystemen proberen de inhoud en expressie te behouden terwijl de sprekerkenmerken worden vervangen. Modern streamingonderzoek beschrijft dit als het behouden van de spraakinhoud en prosodie van de bron, terwijl het vocale timbre van een doelspreker wordt overgenomen. Door die scheiding kan een goede vervormer je spontaan laten spreken in een getransformeerde stem, in plaats van een vast "robot"-filter over de golfvorm te smeren.
Ten derde synthetiseert het model een nieuwe stem. Het reconstrueert audio met een doelstemprofiel, dat een ingebouwd personage kan zijn, een bibliotheekstem, een aangepaste stem gemaakt op basis van geautoriseerde opnames, of een profiel ontworpen voor anonimisering in plaats van imitatie. De uitvoer wordt continu geproduceerd met een kleine vooruitkijk-buffer. Meer context kan de stabiliteit verbeteren, maar voegt ook vertraging toe, wat de kern van de afweging bij live conversie is.
Ten vierde wordt het geconverteerde signaal naar een applicatie geleid. Een desktoptool stelt de uitvoer doorgaans beschikbaar als een virtuele microfoon, zodat andere programma's het ontvangen alsof het een normale microfoon was. Die routering maakt livestreams, online games, videogesprekken, voicechats en virtuele evenementen mogelijk. Een realtime vervormer moet daarom werken op het niveau van het besturingssysteem en de applicatie, niet alleen binnen het model. Compatibiliteit met streamingsoftware, Discord, Zoom, browsers en mobiele apparaten kan net zo belangrijk zijn als de ruwe stemkwaliteit. Als je uit diezelfde opgevangen audio schone tekst wilt halen voor ondertiteling of hergebruik, zorgt een aparte spraak-naar-tekst-stap voor transcriptie in plaats van conversie.
Realtime conversie vs. verwante AI-stemtools
Deze technologieën overlappen in de hoofden van mensen, maar lossen echt verschillende problemen op. De onderstaande tabel verduidelijkt wat elk ervan als invoer gebruikt en wanneer de uitvoer verschijnt.
| Technologie | Invoer | Timing van uitvoer | Best geschikt voor |
|---|---|---|---|
| Realtime stemvervormer | Live microfoonspraak | Tijdens het gesprek | Live gesprekken, gamen, streamen, optredens |
| Tekst-naar-spraak | Geschreven tekst | Nadat de tekst is ingediend | Voice-overs, tutorials, advertenties, e-learning |
| Stem klonen | Stemmonsters | Op aanvraag gegenereerd | Herbruikbare synthetische stem voor voice-over of nasynchronisatie |
| AI-nasynchronisatie | Bestaande audio of video | Na verwerking | Vertalen en lokaliseren van opgenomen content |
| Toonhoogte- of formant-effect | Live of opgenomen audio | Live of bijna-live | Eenvoudige creatieve stemaanpassing |
Dat onderscheid is praktisch, niet academisch. Een platform kan sterke AI-stemgeneratie of stemkloning bieden zonder een live microfoonvervormer voor gesprekken en streams te bieden. Onze eigen tools richten zich op gegenereerde en gelokaliseerde media: we bieden Tekst-naar-spraak, Stem klonen, AI-nasynchronisatie, Spraak-naar-tekst, Spraakscheider, Tekst-naar-afbeelding en Afbeelding-naar-video binnen één workflow. Deze zijn ontworpen om audio uit tekst te produceren of een herbruikbare stem te bouwen voor gegenereerde content, dus ze horen thuis aan de opgenomen-workflow-kant van deze tabel in plaats van bij live microfoonconversie.
Waar live stemconversie goed voor is
Streamers en gamers grijpen naar stemconversie om een personage te behouden, privacy te beschermen of een consistente kanaalpersona aan te houden. Lage latentie telt hier het zwaarst, omdat je reageert op andere spelers en praat met een publiek. Een kleine vertraging is te tolereren in een uitzendachtige monoloog, maar wordt opvallend tijdens snel geklets, competitief spel of komische timing.
In online vergaderingen en virtuele evenementen kan een geconverteerde stem rollenspel, demonstraties, toegankelijkheidsscenario's of privacybewuste deelname ondersteunen. Voor professionele settings zouden verstaanbaarheid en betrouwbaarheid boven nieuwheid moeten staan, en deelnemers zouden moeten worden geïnformeerd wanneer een stem is getransformeerd als stilzwijgen misleidend kan zijn.
Karakteruitvoering is een ander live gebruik. Indie-filmmakers, gameontwikkelaars en podcasters kunnen karakterstemmen auditeren of spontaan tijdelijke dialogen uitvoeren. Voor de eindoplevering geeft een opgenomen AI-voice-over of een menselijke uitvoering echter meestal betere montagecontrole en consistentie van sessie tot sessie.
Stemprivacy en anonimisering is een ander doel dan imitatie. Anonimisering probeert te verhullen wie er spreekt, terwijl imitatie een specifieke doelidentiteit probeert na te bootsen. Geen van beide is waterdicht, en een getransformeerde stem kan nog steeds spreekgewoonten, formuleringen of achtergrondgeluiden lekken die helpen de spreker te identificeren.
Tot slot ondersteunt synthetische stemtechnologie toegankelijkheid en ondersteunende communicatie voor mensen die het vermogen om te spreken hebben verloren. De Federal Trade Commission erkent dit medische en toegankelijkheidsvoordeel, maar waarschuwt ook dat stemreplicatie kan worden misbruikt voor fraude en misbruik van biometrische gegevens.
De beslissingscriteria die er echt toe doen
Latentie komt op de eerste plaats, en je zou moeten vragen naar gemeten end-to-end latentie, niet alleen naar de inferentiesnelheid van het model. De vertraging die je daadwerkelijk voelt omvat microfoonopname, buffering, kenmerkextractie, modelinferentie, synthese, uitvoerroutering en wat de belapp of streamingapp er bovenop toevoegt. Een model dat geïsoleerd snel presteert, kan traag aanvoelen zodra het volledige pad is samengesteld.
Natuurlijkheid is de volgende test. Luister naar metalige artefacten, plotselinge toonsprongen, problemen met ademhaling en uitspraak, onnatuurlijke pauzes, vervormde medeklinkers, haperingen bij zinsgrenzen en verlies van emotionele expressie. Een overtuigende stem moet verstaanbaar blijven tijdens spontane spraak, niet alleen tijdens zorgvuldig voorgelezen demoregels.
Het behoud van spraakinhoud wordt gemakkelijk over het hoofd gezien totdat het faalt. Test snelle spraak, onderbrekingen, cijfers, namen, accenten, gelach, vragen en volumeveranderingen. Een tool die de identiteit verandert maar je ritme en intonatie afvlakt, is een slechte keuze voor optredens of live interactie.
Stemselectie en aanpassing bepalen hoever je het resultaat kunt vormgeven. Controleer op ingebouwde stemmen, het maken van aangepaste stemmen, bedieningselementen voor toonhoogte en toon, emotie- of stijlopties, accentkeuzes, consistentie tussen sessies en eventuele beperkingen voor commercieel gebruik. Het maken van aangepaste stemmen zou altijd duidelijke toestemming moeten vereisen: een stemmonster is geen toestemming om de persoon van wie het afkomstig is te imiteren.
Hardware- en platformondersteuning bepaalt of de tool überhaupt bij jouw opstelling past. Bevestig of het lokaal op CPU of GPU draait, in een browser, via een desktopapp, op mobiel, via een virtuele microfoon of via een API. Cloudverwerking kan de installatie vereenvoudigen, maar introduceert netwerklatentie en vraagstukken rond gegevensbeheer, terwijl lokale verwerking de netwerkvertraging kan verminderen maar krachtigere hardware vereist. Controleer daarnaast de audioroutering: een sterk model is nutteloos als de uitvoer ervan niet als microfoon kan worden geselecteerd in de door jou beoogde applicatie.
Gegevensverwerking sluit de lijst af. Controleer vóór het uploaden van stemmonsters of opnames worden bewaard, of ze bijdragen aan modelverbetering, hoe aangepaste stemmen worden verwijderd, wie toegang heeft tot de bestanden, of er zakelijke of enterprise-controles bestaan en wat er daarna met de gegenereerde audio gebeurt. Stemopnames kunnen afhankelijk van de context en toepasselijke wetgeving gevoelige persoons- of biometrisch gerelateerde gegevens zijn, dus behandel ze op die manier.
Wanneer een opgenomen workflow het wint van realtime
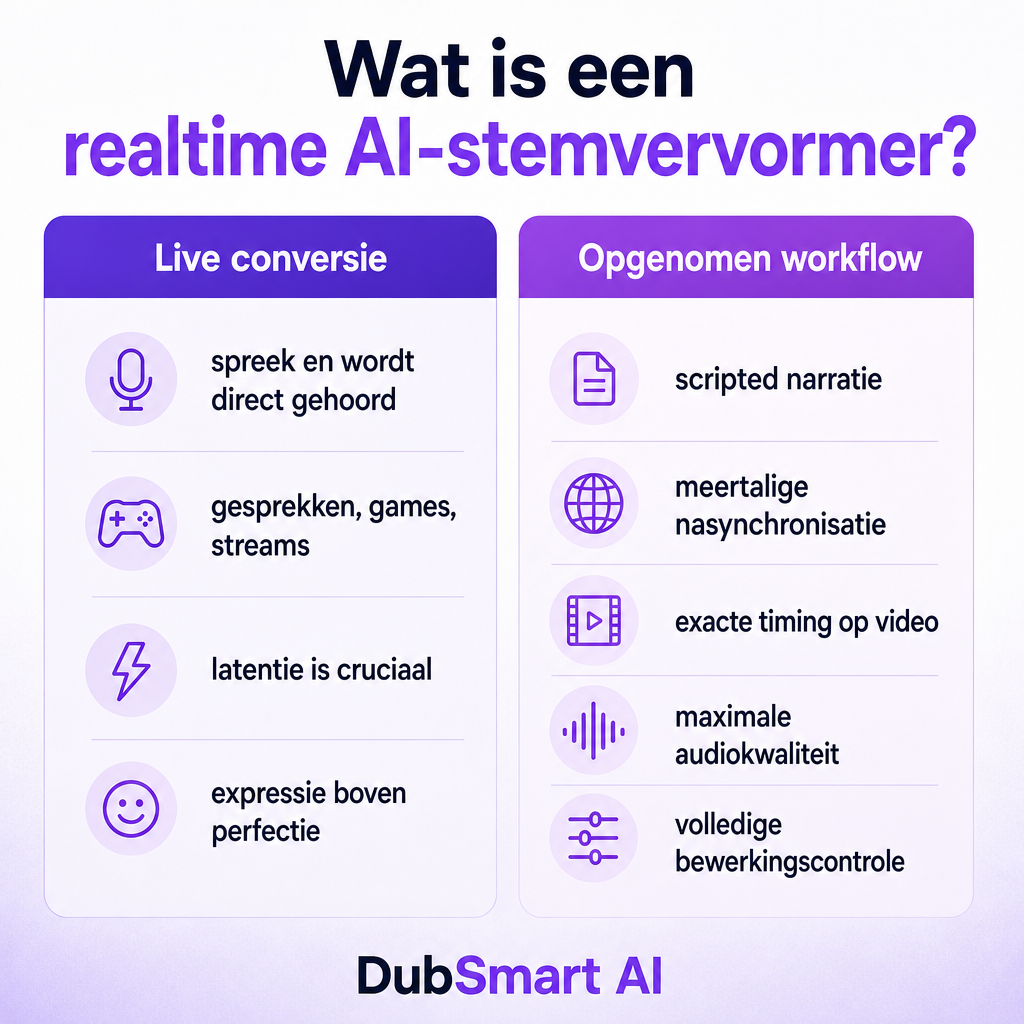
Live conversie is de juiste keuze wanneer iemand natuurlijk moet kunnen spreken en de getransformeerde stem onmiddellijk gehoord moet worden. Het is de verkeerde keuze wanneer je prioriteit ligt bij maximale audiokwaliteit, nauwkeurige uitspraak, meertalige voice-overs, exacte timing bij video, gedetailleerde montage, consistente commerciële voice-overs of hoogwaardige nasynchronisatie.
Voor die doelen wint een opgenomen pijplijn. Met tekst-naar-spraak beheer en verfijn je het script voordat er audio wordt gegenereerd, wat het live-latentieprobleem volledig wegneemt. Met AI-nasynchronisatie verwerkt het systeem een bestaande video en lijnt het vertaalde spraak uit op de bron, iets wat geen enkele live vervormer kan. Als je bronbestand dialoog mengt met muziek of ruis, kan een spraakscheider een schoon stemspoor isoleren voordat je het verwerkt. Onze AI-nasynchronisatie is gebouwd om opgenomen audio of video te vertalen naar ondersteunde doeltalen, niet om een live microfoonsignaal te converteren.
Risico's en verantwoord gebruik
Imitatie en fraude vormen het grootste risico. Een realistische geconverteerde stem kan een valse identiteit geloofwaardiger maken, en de FTC waarschuwt dat stemkloningssystemen worden gebruikt bij familiescams, bedrijfsimpersonatie, afpersing en andere fraude, naast risico's voor stemkunstenaars wier stemmen mogelijk worden toegeëigend. Gebruik de herkenbare stem van een echt persoon niet zonder toestemming, en presenteer een AI-gegenereerde of geconverteerde stem nooit als bewijs dat een specifiek persoon heeft gesproken.
Toestemming en stemrechten volgen hier rechtstreeks uit. Vraag toestemming voordat je de stem van iemand anders kloont of bewust imiteert, en bewaar een vastlegging van die toestemming, vooral voor commerciële projecten, reclame, trainingen, games of openbare media. Het hier aangehaalde FTC-materiaal bespreekt schade, handhaving en voorgestelde oplossingen in plaats van één enkele toestemmingsregel voor elk gebruik vast te stellen, dus specifieke verplichtingen kunnen afhangen van rechtsgebied, contract, platform en gebruiksscenario. Verifieer bij twijfel wat voor jouw situatie geldt.
Openbaarmaking is verstandig wanneer een publiek redelijkerwijs zou kunnen geloven dat een echt persoon live spreekt. Een korte melding dat de stem AI-gegenereerd of stem-geconverteerd is, vermindert verwarring. Beveiliging telt ook: bescherm stemmonsters en aangepaste stembestanden zoals andere gevoelige middelen, beperk de toegang, upload geen opnames zonder toestemming en verwijder ongebruikte stemprofielen waar de dienst dat toestaat. Plan tot slot voor kwaliteitsfouten. Latentie, wegvallende audio en conversie-artefacten kunnen een gesprek ontsporen, dus test de volledige opstelling met de daadwerkelijke microfoon, koptelefoon, applicatie, netwerk en hardware voordat je live gaat.
Waar onze tools passen in jouw stemproject
Wij presenteren een geïntegreerde AI-mediaworkflow in plaats van een live microfoonstemvervormerproduct. Op ons platform kun je spraak genereren uit tekst, kiezen uit meer dan 300 stemmen, gekloonde stemmen maken op basis van een kort monster, en die stemmen gebruiken in Tekst-naar-spraak- en AI-nasynchronisatieprojecten. We ondersteunen nasynchronisatie vanuit meer dan 60 brontalen naar 33 doeltalen, wat ons een sterke keuze maakt wanneer de taak is om een voice-over te maken uit een script, spraak te produceren met een aangepaste stem, opgenomen audio of video te nasynchroniseren, of content te lokaliseren voor een meertalig publiek.
Voor ontwikkelaars publiceren we aparte API-pagina's voor Tekst-naar-spraak, Stem klonen en AI-nasynchronisatie. Dit zijn generatie- en lokalisatieworkflows. Als je project specifiek een live microfoonstemvervormer nodig heeft, bevestig dan dat realtime streaming-invoer, uitvoerroutering, latentiedoelen en ondersteuning voor live sessies expliciet gedocumenteerd zijn voordat je je vastlegt op welke API dan ook, de onze of die van iemand anders.
Als je live conversie afweegt tegen een opgenomen pijplijn en niet zeker weet welk pad bij jouw content past, vertel ons dan je bronformaat, doeltalen en of je live of vooraf opgenomen uitvoer nodig hebt, dan wijzen wij je de juiste workflow.
Veelgestelde vragen
Is een realtime AI-stemvervormer hetzelfde als tekst-naar-spraak?
Nee. Een realtime stemvervormer transformeert live microfoonspraak terwijl je praat, terwijl tekst-naar-spraak nieuwe spraak genereert uit geschreven tekst die je eerst indient. Onze Tekst-naar-spraak is gebouwd voor het genereren van spraak uit tekst, niet voor live microfoonconversie.
Heeft een realtime AI-stemvervormer geen enkele vertraging?
Nee. Elk systeem heeft tijd nodig om audio op te vangen en te verwerken, dus enige latentie is onvermijdelijk. De praktische vertraging hangt af van het model, het apparaat, de bufferinstellingen, het netwerk en de bestemmingsapplicatie, en onderzoekssystemen rapporteren verschillende cijfers onder verschillende testomstandigheden.
Kan een AI-stemvervormer de stem van een beroemdheid kopiëren?
Sommige systemen kunnen technisch gezien herkenbare stemmen imiteren, maar technisch vermogen is geen toestemming. Vermijd ongeautoriseerde imitatie en controleer de relevante contracten, platformregels en wetten voordat je de stem van een herkenbaar persoon gebruikt.
Wat moet ik gebruiken om meertalige YouTube-video's te maken?
Voor vooraf opgenomen video's past AI-nasynchronisatie over het algemeen beter dan een live stemvervormer, omdat het de bestaande video verwerkt en uitgelijnde, gelokaliseerde audio produceert. Onze AI-nasynchronisatie vertaalt en nasynchroniseert opgenomen audio of video naar ondersteunde talen.
Kan jullie platform mijn stem live tijdens een gesprek veranderen?
Ons platform documenteert Tekst-naar-spraak, Stem klonen en AI-nasynchronisatie in plaats van live microfoonstemconversie. Als je een live-gespreksworkflow plant, bevestig dan eerst de actuele productdocumentatie bij ons, zodat we de juiste aanpak kunnen aanbevelen.