Als je voiceforge text to speech overweegt voor een project, is de echte vraag zelden of de stemmen interessant klinken. Het gaat erom of de tool past bij je scriptlengte, je publicatierechten en het soort content dat je daadwerkelijk maakt. VoiceForge is een browsergebaseerde tekst-naar-spraakdienst die draait om onderscheidende karakterstemmen. Het zet een script om in downloadbare audio met een unit-selectie-syntheseengine die opgenomen spraaksegmenten van menselijke sprekers aan elkaar naait, in plaats van elk geluid vanuit één wiskundige golfvorm te genereren. De praktische beslissing komt neer op vier behoeften: een leuke, herkenbare stem voor persoonlijke projecten; gelicentieerde audio voor gemonetiseerde media; nauwkeurige controle over uitspraak en tempo; of een schaalbare meertalige workflow. Alleen de eerste drie sluiten netjes aan op een karakterstem-generator, en in dat gat struikelen de meeste makers.
We publiceren deze gids omdat dezelfde verwarring keer op keer opduikt: mensen genereren audio tijdens een gratis proefperiode, gaan ervan uit dat ze die kunnen monetiseren, en ontdekken vervolgens dat de licentie gekoppeld is aan een specifiek abonnement. Hieronder leggen we uit hoe de engine werkt, wat het wel en niet kan, en wanneer een tool met één noviteitsstem de juiste keuze is versus een volledige lokalisatie-workflow.
Inhoudsopgave
Wat VoiceForge text to speech werkelijk is
VoiceForge zet geschreven woorden om in gesproken audio: je voert een script in, kiest een stem, genereert de clip, bekijkt een voorbeeld en downloadt het resultaat wanneer je abonnement dat toestaat. Wat het onderscheidt van een algemene vertelbibliotheek is de oriëntatie. VoiceForge neigt naar stemmen met persoonlijkheid in plaats van een neutrale, zakelijke voordracht, waardoor het van nature past bij YouTube-sketches, gaming-clips, geanimeerde personages, memes, noviteitsaankondigingen en muziekprojecten.
Die karakter-eerst-focus is voor sommige content een voordeel en voor andere een nadeel. Een komische of bewust synthetische stem kan een parodie of een game-NPC dragen, maar diezelfde stem wordt afleidend in een e-learningcursus, een productdemo of een premium merkspot. Dus de eerste filter is niet "klinkt dit menselijk?" Het is "hoort deze stem thuis bij mijn specifieke publiek?"
Als je nog aan het bepalen bent of een stock-stemgenerator überhaupt bij je behoeften past, behandelt onze uitleg over wat een AI-stemgenerator doet de bredere categorie en hoe deze tools verschillen van klonen en nasynchronisatie.
Hoe de unit-selectie-engine een stem opbouwt
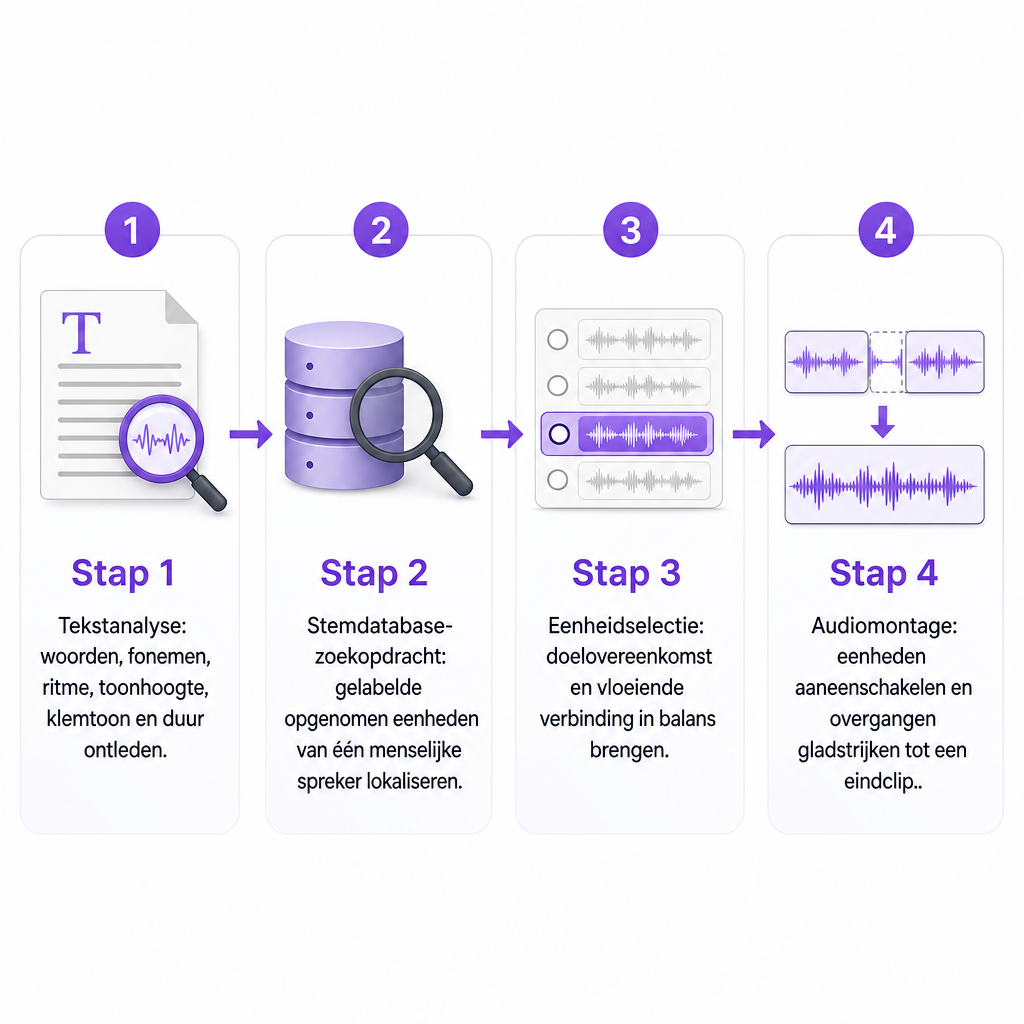
VoiceForge gebruikt unit-selectie-synthese, ook wel concatenatieve synthese genoemd. In plaats van een volledige opname te genereren vanuit één door een model geproduceerde golfvorm, doorzoekt het systeem een database van opgenomen spraaksegmenten en voegt het de best passende stukken samen tot jouw zin. Het begrijpen van deze pijplijn verklaart zowel waarom de stemmen herkenbaar klinken als waarom ze zich onder druk zo gedragen.
Het proces verloopt in enkele fasen. Eerst de tekstanalyse: de engine ontleedt woorden, zinsstructuur, fonemen, ritme, toonhoogte, klemtoon en duur om te bepalen hoe een regel uitgesproken moet worden. Vervolgens een zoektocht in de stemmendatabase: elke stem is opgebouwd uit opnames van een menselijke spreker, opgedeeld in kleinere eenheden en gelabeld op klank en context. Dan de unit-selectie, waarbij de engine twee concurrerende doelen tegelijk afweegt — doelmatching, die een eenheid kiest met de juiste klank, toonhoogte, duur en context, en vloeiend samenvoegen, dat de voorkeur geeft aan aangrenzende eenheden die zonder duidelijke naad op elkaar aansluiten. Ten slotte naait de audiomontage de gekozen reeks samen en past lichte verzachting toe aan de randen.
Omdat de output wordt samengesteld uit echte opnames, behoudt elke stem een onderscheidende identiteit. De keerzijde is dat deze methode niet is ontworpen om onbeperkte emotionele sturing of de volledig aanpasbare voordracht te bieden die bij nieuwere generatieve systemen hoort. Ongebruikelijke formuleringen, snelle wisselingen of lastige uitspraakcombinaties kunnen de naden tussen eenheden blootleggen, met resultaten die minder consistent klinken dan een doorlopende menselijke opname. Als je wilt zien hoe een volledig generatieve pijplijn verschilt, loopt onze uiteenzetting over hoe neurale tekst-naar-spraak werkt door de deep-learningaanpak die concatenatie vervangt.
Stemmen, SSML en de limiet van 500 tekens
VoiceForge biedt 42 unieke stemmen, elk opgenomen door een andere spreker met een eigen timbre en spreekstijl. Dat is ruim voldoende wanneer de stem zelf deel uitmaakt van het creatieve concept — een komische verteller voor een korte film, een rare persoonlijkheid voor een gamingvideo, een synthetische toon voor een meme. Het is echter een kleinere catalogus voor teams die veel regionale varianten nodig hebben of een zorgvuldig op elkaar afgestemde verteller voor meerdere markten.
Voor controle over de voordracht ondersteunt VoiceForge een deel van Speech Synthesis Markup Language (SSML). In plaats van alleen op interpunctie te vertrouwen, voeg je instructies rechtstreeks in het script in.
| SSML-besturing | Wat het doet |
|---|---|
<break> |
Voegt een pauze in |
<emphasis> |
Legt nadruk op een woord of zinsdeel |
<prosody> |
Past toonhoogte, spreeksnelheid of volume aan |
<phoneme> |
Dwingt een exacte uitspraak af |
<sub> |
Spreekt een vervanging uit voor de zichtbare tekst |
<p> / <s> |
Markeert een alinea of zin |
Deze tags bewijzen hun nut wanneer de engine een productnaam, acroniem of technische term verkeerd leest. Door een afkorting te verpakken in <sub alias="application programming interface">API</sub> wordt de volledige zin uitgesproken, en <phoneme> legt een lastige naam vast. Een <break time="500ms"/> tussen regels voegt een bewuste pauze toe waar interpunctie dat niet zou doen.
Hier is de valkuil die bepaalt hoe je ervoor schrijft: de tekstinvoer is begrensd op 500 tekens, en SSML-markup telt mee binnen die limiet. Elke tag die je toevoegt knabbelt aan de ruimte die beschikbaar is voor echte woorden. Lange verteltekst moet worden opgesplitst in meerdere generaties, en zware markup verkleint elk stuk verder. In de praktijk betekent dat je je script plant in korte, op zichzelf staande passages in plaats van een volledige pagina te plakken.
Gratis proefperiode vs. commerciële licentie: de beslissing die ertoe doet
VoiceForge biedt een beperkte gratis proefperiode, maar een proefperiode is geen publicatielicentie. De abonnementen trekken een duidelijke grens tussen persoonlijk en commercieel gebruik, en op die grens gaan de meeste fouten mis.
Het Fan Voice-niveau is bedoeld voor grappen, video's, games, animaties en memes die niet gemonetiseerd worden. Het Publisher-abonnement is het abonnement dat een commerciële licentie verleent voor TTS-audio in gemonetiseerde of commerciële content — gemonetiseerde video's, indiegames en muziek — en adverteert met onbeperkte downloads. De gratis proefperiode bestaat zodat je de dienst kunt testen voordat je je vastlegt.
De werkregel is eenvoudig: als een project geld oplevert, een bedrijf promoot, in gemonetiseerde media verschijnt of commercieel wordt uitgebracht, bevestig dan het toepasselijke abonnement voordat je publiceert. Audio die je tijdens een gratis proefperiode genereert, draagt niet automatisch commerciële rechten alleen omdat je het hebt gedownload. Licentievoorwaarden kunnen ook veranderen, dus de abonnementspagina is een startpunt, geen vervanging voor een projectspecifieke controle wanneer er veel op het spel staat — een leverprestatie voor een klant, een betaalde advertentie, een merkcampagne of een app-release.
Sterke punten en beperkingen voor echte projecten
De sterke punten van VoiceForge draaien om persoonlijkheid en eenvoud. De karakterstemmen vallen op wanneer timbre deel uitmaakt van de grap of het merk van een kanaal. Omdat de basis opgenomen menselijke spraak is, behouden de stemmen natuurlijke vocale eigenschappen en een herkenbare identiteit. De SSML-uitspraakbesturing geeft je echte zeggenschap over acroniemen, namen en vreemde termen. En het Publisher-abonnement maakt de vraag over commercieel gebruik explicieter dan tools die toegang tot generatie scheiden van licentiedetails.
De beperkingen zijn net zo concreet. De limiet van 500 tekens dwingt lange scripts in veel kleine generaties, en markup maakt elk stuk korter. De catalogus van 42 stemmen is bescheiden naast grote bibliotheken, wat van belang is als je honderden opties of veel regionale accenten nodig hebt. De karakter-eerst-stijl die schittert in entertainment kan juridische, medische, instructieve of premium merkcontent ondermijnen. Abonnementsbeperkingen zijn gemakkelijk over het hoofd te zien, aangezien het kunnen genereren van audio niet hetzelfde is als het recht om het te monetiseren. En omdat de engine opgenomen eenheden aan elkaar voegt, kunnen bepaalde formuleringen naad-artefacten laten opduiken die een doorlopende opname niet zou hebben.
Geen van deze is op zichzelf een dealbreaker. Ze bakenen simpelweg de ideale toepassing af: korte, persoonlijkheidsgedreven clips in één taal waarbij de stem de essentie is.
Wanneer een karakterstem past en wanneer een lokalisatie-workflow wint
VoiceForge is de juiste keuze wanneer de persoonlijkheid van de stem centraal staat, je scripts zich netjes laten opsplitsen in korte secties, je basiscontrole over uitspraak en tempo nodig hebt, en je video's, memes, animaties, muziek of indiegamecontent produceert — of dat nu persoonlijk is (Fan Voice) of gemonetiseerd met het juiste abonnement.
Een bredere workflow dient je beter wanneer je een gepolijste neutrale verteller nodig hebt, veel talen en accenten, je eigen gekloonde stem, langere verteltekst, frequente commerciële updates, API-integratie of consistente stemmen over een grote catalogus waar betrouwbaarheid belangrijker is dan noviteit. Een kanaal dat internationaal uitbreidt illustreert de scheiding goed: VoiceForge kan de karakterstem leveren voor een Engelstalige sketch, terwijl een meertalige TTS- en nasynchronisatie-opzet de gelokaliseerde versies produceert voor andere doelgroepen.
Op dat tweede scenario richten wij ons. Onze Text to Speech-tool biedt meer dan 300 AI-stemmen, meertalige voice-overs, besturing van de spreeksnelheid en downloadbare projecten die zijn gebouwd voor productie in plaats van eenmalige noviteit. Makers die hun eigen identiteit in elke video willen behouden kunnen Voice Cloning gebruiken in plaats van genoegen te nemen met een stockpersonage, en ontwikkelaars die spraakgeneratie binnen een app nodig hebben kunnen bouwen op onze Text to Speech API. Wanneer het doel is om één clip om te zetten in een volledig gelokaliseerde release, brengt AI Dubbing hetzelfde script op één plek over naar extra talen.
Een kwaliteitschecklist vóór publicatie
Voordat je VoiceForge-audio uitbrengt, doe je een snelle controle op de zaken die het vaakst misgaan. Eerst korte testpassages genereren is de paar extra minuten waard, want een stem die in één zin goed valt, kan gedurende een volledige video vermoeiend of afleidend worden.
- Uitspraak: Worden namen, afkortingen, getallen en technische termen correct uitgesproken?
- Tempo: Vallen pauzes natuurlijk, niet midden in een zinsdeel?
- Karakterconsistentie: Past dezelfde stem bij elke scène, niet alleen bij de opening?
- Audio-overgangen: Zijn er hoorbare sprongen tussen afzonderlijk gegenereerde clips?
- Licentie: Dekt je huidige abonnement daadwerkelijk gemonetiseerd of commercieel gebruik?
- Aansluiting bij publiek: Is de karakterstijl geschikt voor het platform en het onderwerp?
- Uitlijning: Sluit de audio netjes aan op je video, muziek of gamedialoog?
- Rechten: Heb je toestemming voor elk aangeleverd script, elke naam of elke verwijzing van derden in de audio?
Veelgestelde vragen
Wat is VoiceForge text to speech?
Het is een browsergebaseerde dienst die geschreven tekst omzet in gesproken audio met behulp van een bibliotheek van onderscheidende karakterstemmen. Het steunt op unit-selectie-synthese, die opgenomen spraaksegmenten uit menselijke stemmendatabases samenvoegt in plaats van audio te genereren vanuit één modelgolfvorm.
Is VoiceForge AI-gegenereerd?
Het is een spraaksynthesedienst, maar de gedocumenteerde methode is unit-selectie, geen volledig generatief neuraal stemsysteem. De engine selecteert en voegt opgenomen menselijke spraakeenheden samen om elke uiting te produceren.
Hoeveel VoiceForge-stemmen zijn er beschikbaar?
VoiceForge biedt 42 unieke stemmen, elk gekoppeld aan een andere spreker en vocale persoonlijkheid.
Wat is de tekenlimiet van VoiceForge?
De dienst documenteert een limiet van 500 tekens per tekstinvoer, en elke SSML-markup die je toevoegt telt mee binnen die limiet. Langere scripts moeten worden opgesplitst in meerdere generaties.
Kan ik VoiceForge-audio op YouTube gebruiken?
Dat kan, maar gemonetiseerde content vereist het juiste commerciële abonnement. Het Publisher-abonnement wordt beschreven als de licentie voor TTS-audio die wordt gebruikt in gemonetiseerde of commerciële content, dus bevestig je abonnement voordat je een gemonetiseerde video publiceert.
Is VoiceForge hetzelfde als voice cloning?
Nee. VoiceForge gebruikt zijn bestaande stemmenbibliotheek, terwijl voice cloning een aangepaste synthetische stem creëert op basis van geautoriseerde opnames van een specifieke spreker. We leggen die aparte workflow uit op onze Voice Cloning-pagina.