Die vlakke, licht robotachtige verteller die bijschriften voorleest over een clip is een van de meest herkenbare geluiden op korte video's geworden. Op het moment dat mensen het horen, weten ze precies wat voor soort content ze bekijken. Als je op zoek bent geweest naar een betrouwbare manier om dat tiktok voice text to speech-effect toe te voegen aan video's die je overal elders plaatst, is het goede nieuws dat je niet vast hoeft te zitten in de editor van één enkele app om het te krijgen. Met onze Text to Speech-tool schrijf je het script, kies je een stem die past bij de toon die je wilt, genereer je de audio en synchroniseer je die met je beeldmateriaal voor TikTok, YouTube Shorts, Reels of waar je ook publiceert.
De reden waarom dit belangrijk is, gaat verder dan het kopiëren van een trend. Een onderscheidende vertellerstem is een onderdeel van de identiteit van je kanaal. Zodra die herkenbaar is, verbinden kijkers hem met jou op elk platform. Het probleem met alleen vertrouwen op de ingebouwde verteller van een app is dat je beperkt bent tot die app, de korte stemlijst en de regels ervan. We hebben onze workflow zo gebouwd dat dezelfde stem waar je van houdt je content overal kan volgen en, wanneer je er klaar voor bent, ook naar andere talen.
Inhoudsopgave
- Waarom de TikTok-vertellerstem een storytelling-tool werd
- Het effect nabootsen met onze Text to Speech-tool
- Verder gaan dan standaardstemmen met voice cloning
- Eén stem meenemen over talen en formaten heen
- TikTok-stijl vertelling automatiseren met onze API's
- Je pad kiezen: standaardstem, gekloonde stem of API
- Veelgestelde vragen
Waarom de TikTok-vertellerstem een storytelling-tool werd
De ingebouwde verteller begon als een handige functie. Je voegt tekst toe aan een clip, tikt om die om te zetten in spraak, kiest uit een handvol stemmen en de app leest je bijschriften hardop voor. Tutorials op het hele web leiden beginners precies daar doorheen: voeg tekst toe, druk er lang op of tik op het stemicoon en kies dan een verteller. Omdat het proces zo eenvoudig is, hebben makers het overgenomen voor komische fragmenten, stapsgewijze uitleg, storytime-posts en productbeschrijvingen.
Wat een hulpmiddel in een trend veranderde, is herhaling. Wanneer miljoenen clips dezelfde neutrale, gelijkmatig getempoteerde vertelling gebruiken, wordt dat geluid een steno voor een bepaalde stijl van content. Kijkers horen het niet langer als een machine maar beginnen het te horen als de stem van korte storytelling. Die vertrouwdheid is de reden waarom zoveel makers nu hetzelfde effect willen op elk platform waarop ze publiceren, en meer controle willen dan een vaste stemlijst toestaat.
De praktische beperking is gemakkelijk te bereiken. De ingebouwde verteller van een app geeft je een kort menu met stemmen en houdt alles binnen die ene app. Als je een video hergebruikt voor een ander platform, verlies je ofwel de vertelling of neem je hem opnieuw op. Als je een stem wilt die niet op de lijst staat, zit je vast. En als je van plan bent hetzelfde idee in een andere taal te publiceren, zal de ingebouwde tool je verteller niet voor je meenemen. Precies daar verdient een toegewijde Text to Speech-workflow zijn plek, waardoor je vertelling één keer kunt genereren en overal hergebruiken waar je plaatst.
Het effect nabootsen met onze Text to Speech-tool
Onze Text to Speech-tool is het onderdeel dat het effect van de verteller op het scherm direct nabootst. In plaats van bijschriften in één app te typen en te hopen dat de verteller past, plak je je script, kies je uit een bibliotheek van meer dan 300 natuurlijk klinkende stemmen en genereer je schone audio die je in elke video kunt plaatsen. De output is een downloadbaar bestand, dus het hoort bij je project in plaats van bij de editor van één enkel platform.
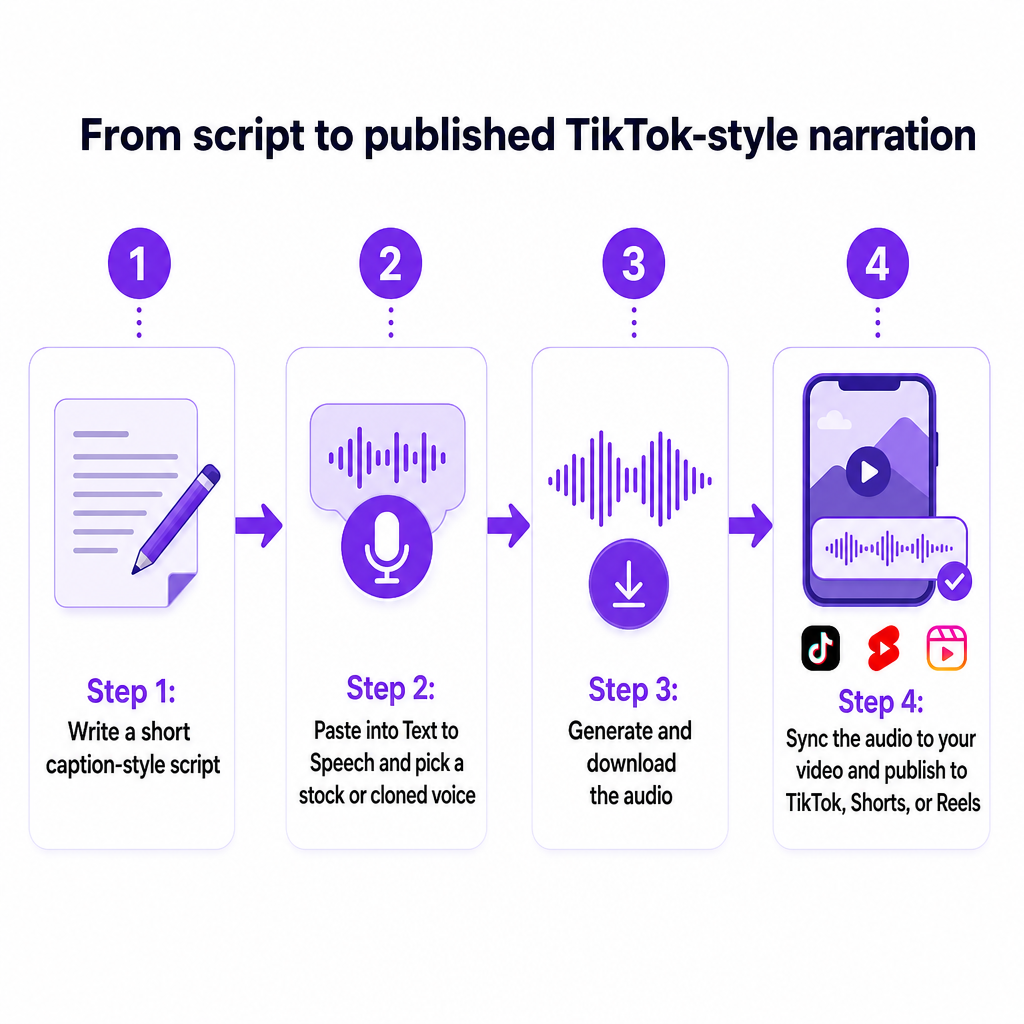
De web-app volgt vier eenvoudige stappen. Kies eerst Text to Speech. Maak ten tweede spraak door je tekst in te voeren en een spreker te selecteren. Bewerk ten derde het project, waar je meer sprekers kunt toevoegen of de tekst kunt aanpassen. Download ten vierde het afgewerkte project in het formaat dat je nodig hebt. Er is niets technisch aan, en dat is het punt: je moet je energie besteden aan het script en de bewerking, niet aan het worstelen met software.
Toegepast op korte video's wordt de flow nog concreter. Begin met het schrijven van een kort, bijschrift-achtig script, precies de woorden die je over je clip wilt laten voorlezen. Houd het pittig; het verteller-effect werkt het best met strakke, ritmische regels. Plak dat script in Text to Speech en kies een stem waarvan de toon past bij de sfeer die je zoekt, of dat nu droog, opgewekt of nuchter is. Genereer de audio, breng die dan naar je editor naar keuze en lijn hem uit met de beelden voordat je publiceert op TikTok, Shorts of Reels.
Omdat je de vertelling buiten een enkele app genereert, werkt hetzelfde audiobestand op elk platform in je postrotatie. Neem één keer op, hergebruik overal. Dat alleen al lost de grootste frustratie op met de ingebouwde verteller van een app: je bouwt niet langer dezelfde voice-over drie keer opnieuw voor drie bestemmingen.
Scripts schrijven die passen bij de vertellerstijl
De stem doet veel van het werk, maar het script bepaalt het tempo. Korte stellende zinnen lezen schoon en landen met de krokante cadans die kijkers associëren met de trend. Cijfers, lijsten en duidelijke overgangen zoals "eerst", "dan" en "ten slotte" vertalen goed naar gesynthetiseerde spraak omdat ze de stem natuurlijke pauzepunten geven. Als een regel onhandig klinkt wanneer je hem hardop leest, zal hij ook onhandig klinken wanneer de stem hem leest, dus een snelle gesproken doorloop voordat je genereert bespaart later veel hergeneratie.
Verder gaan dan standaardstemmen met voice cloning
Kiezen uit een bibliotheek is de snelle route, en voor veel makers is een goed gekozen standaardstem alles wat ze nodig hebben. Maar er zit een plafond aan klinken als iedereen. Als je doel een verteller is die onmiskenbaar de jouwe is, verandert onze Voice cloning je eigen stem, of een merkstem met toestemming, in een herbruikbaar model dat je vanuit tekst kunt aansturen.
Het onderscheid is belangrijk. Generieke text to speech betekent kiezen uit vooraf ingestelde vertellers. Voice cloning bouwt een synthetisch model van één specifieke spreker, zodat nieuwe spraak in die stem kan worden gegenereerd vanuit elke tekst die je typt. In de web-app upload je een audiobestand van ten minste 20 seconden schone spraak, met minimale achtergrondruis, naar het voice clone-gedeelte. Uit dat korte, rustige monster maken we een aangepaste stem die je net als elke andere kunt gebruiken in je Text to Speech-projecten.
Twintig seconden schone audio is een lage drempel voor productie-inspanning. Een rustige kamer, een telefoon of eenvoudige microfoon en een korte voordracht zijn genoeg om een kenmerkende verteller te genereren die je onbeperkt kunt hergebruiken. Zodra hij bestaat, kies je niet langer tussen anonieme standaardstemmen; je hebt een stem die je identiteit meeneemt naar elke clip, en hij blijft consistent of je nu vandaag publiceert of over zes maanden.
Dit is waar een herkenbare verteller een merkactivum wordt in plaats van een eenmalig effect. Een gekloonde stem leest scripts voor die je nooit daadwerkelijk hebt opgenomen, behoudt zijn karakter over een hele contentkalender en heeft nooit een heropnamesessie nodig omdat je je opstelling hebt gewijzigd. Voor makers die een langetermijn-kanaalidentiteit opbouwen, is die consistentie de echte upgrade ten opzichte van een roterend menu van app-stemmen.
Eén stem meenemen over talen en formaten heen
Een vertellerstem die maar in één taal werkt, beperkt je bereik op het moment dat je internationaal wilt groeien. Ons platform ondersteunt meertalige nasynchronisatie over 33 doeltalen en kan spraak genereren uit tekst in de taal die je kiest, zodat dezelfde trend die in het Engels werkt, kan worden gereproduceerd voor doelgroepen elders.
Zo passen de stukken in elkaar. Text to Speech geeft je de vertelling. Voice cloning zorgt ervoor dat die vertelling in één herkenbare stem blijft. Onze AI Dubbing breidt dezelfde content uit naar andere talen door video en audio te verwerken via text to speech, speech to text en voice cloning binnen één workflow. In plaats van aparte vertellers in te huren voor elke markt, behoud je één stemidentiteit en laat je het platform die over versies heen dragen.
De workflow schaalt ook voorbij korte clips. Voor langere content kun je volledige video's of audiobestanden uploaden, sprekerinstellingen aanpassen, talen kiezen en voorkeursstemmen selecteren binnen een project voordat je exporteert. Dus dezelfde aanpak die je gebruikt om een viral-achtige verteller toe te voegen aan een clip van vijftien seconden, geldt ook voor een uitlegvideo, een les of een volledige aflevering. Korte video's zijn waar de trend leeft, maar de onderliggende tools stoppen niet bij korte video's.
Voor makers die wereldwijde groei plannen, verandert dit de economie van lokalisatie. Eén enkel script wordt een Engelse short, een Spaanse versie en aanvullende taalversies, allemaal verteld in een consistente stem, zonder je audio elke keer helemaal opnieuw op te bouwen. Het herkenbare-verteller-effect wordt iets wat je kunt bedienen als een herhaalbaar systeem in plaats van een gelukkig toeval.
TikTok-stijl vertelling automatiseren met onze API's
Individuele makers kunnen alles hierboven in de browser doen. Bureaus, grotere kanalen en teams met achtercatalogi hebben meestal hetzelfde resultaat op grote schaal nodig, en daar komen onze API's om de hoek kijken. De Text to Speech API is een RESTful-service die tekst omzet in natuurlijk klinkende spraak: je stuurt een POST-verzoek met je tekst en stemvoorkeuren en ontvangt in ruil een kant-en-klaar audiobestand. Het ondersteunt dezelfde 300+ stemmen en voice cloning die beschikbaar zijn in de app.
Om een aangepaste verteller programmeerbaar te maken, volgt onze Voice Cloning API een compact patroon van drie stappen. Upload eerst een audiobestand en ontvang een file key. Maak ten tweede een aangepaste stem door een naam en die file key op te geven. Gebruik ten derde de resulterende gekloonde stem binnen Text to Speech-projecten via de TTS-project-endpoints van het platform. Zodra een stem bestaat, wordt hij een herbruikbaar activum dat je applicaties kunnen aanroepen, geen eenmalige export.
Samengenomen laat dit een team het effect industrialiseren. Stel je een bureau voor dat meerdere klantkanalen beheert: het kan één gekloonde merkstem per klant onderhouden, scripts door de API voeden en verteld audio genereren voor tientallen video's zonder dat iemand telkens handmatig tekst in een tool plakt. Hetzelfde patroon ondersteunt leersystemen en lokalisatiepijplijnen, waar gekloonde stemmen op aanvraag worden aangeroepen naarmate content wordt geproduceerd.
Voor teams die ook visuals genereren of korte video's rond stilstaande activa willen bouwen, zit onze image-to-video-tooling in hetzelfde ecosysteem, zodat audio- en visuele productie op één plek leven in plaats van verspreid over losse apps. Het doel is één workflow: één platform om te schrijven, van stem te voorzien, te lokaliseren en samen te stellen.
Een opmerking over verwachtingen: we beschrijven deze API's in functionele termen omdat de workflow daarvan afhankelijk is. Als je details wilt over rate limits, doorvoer of plan-specifieke opstellingen, vertel ons dan je verwachte volume en use case, zodat we een aanbeveling kunnen voorbereiden die bij je werklast past.
Je pad kiezen: standaardstem, gekloonde stem of API
De meeste lezers komen met een van drie behoeften, en het juiste beginpunt hangt af van welke jou beschrijft. De onderstaande tabel koppelt elke situatie aan de snelste nuttige eerste stap.
| Jouw situatie | Beste beginpunt | Waarom het past |
|---|---|---|
| Het effect snel testen | Standaardstem in Text to Speech | Kies uit 300+ stemmen, genereer audio in minuten, geen opname nodig |
| Een kenmerkende kanaalstem opbouwen | Voice cloning | Verander een schoon monster van 20 seconden in een herbruikbare aangepaste verteller |
| Op schaal of over klanten heen produceren | TTS- en Voice Cloning-API's | Automatiseer vertelling over veel video's en meertalige versies |
Als je het niet zeker weet, begin dan eenvoudig. Stel een kort bijschrift-achtig script op voor je volgende post, open Text to Speech in de browser en genereer het met een standaardstem die bij je toon past. Als je het effect leuk vindt maar wilt dat het als jou klinkt, upload dan een schoon monster van 20 seconden en kloon je stem, en vergelijk dan de twee op dezelfde clip. Die ene vergelijking beslist meestal de vraag of je een viral-achtige standaardverteller of een unieke merkstem wilt voor de toekomst.
Teams en ontwikkelaars die meerdere kanalen of een grote achtercatalogus beheren, halen meer waarde uit API-toegang, aangezien de handmatige browserflow niet schaalt naar honderden activa. Wat ook bij je volume past, de onderliggende mogelijkheid is dezelfde: een herkenbare verteller, op jouw voorwaarden, op elk platform waarop je publiceert. Als je hulp wilt bij het koppelen van je kanaalplan, catalogusgrootte en taaldoelen aan de juiste aanpak, deel die details dan met ons en we stellen een geschikte opstelling voor.
Eén praktische waarschuwing die het waard is om te onthouden: wanneer je een stem kloont, gebruik dan je eigen stem of een waarvoor je duidelijke toestemming hebt, en volg de postregels van welk platform je ook op publiceert. Dat houdt je herkenbare-verteller-strategie duurzaam in plaats van riskant.
Veelgestelde vragen
Heeft DubSmart AI een preset met het label "TikTok voice"?
Onze focus ligt op het nabootsen van het effect in plaats van het nadoen van een specifieke propriëtaire preset. Je krijgt dat vertrouwde verteller-op-het-scherm-gevoel door audio te genereren in Text to Speech uit een bibliotheek van 300+ stemmen, en dan een te kiezen waarvan de toon past bij de stijl die je wilt. Je kunt ook een aangepaste stem klonen voor een verteller die uniek de jouwe is. Als je een bepaalde toon of merkstem in gedachten hebt, vertel het ons dan en we stellen een passende aanpak voor.
Hoe voeg ik het verteller-effect toe aan video's buiten TikTok?
Schrijf een kort bijschrift-achtig script, plak het in onze Text to Speech-tool, selecteer een spreker en genereer de audio. Download het bestand en lijn het uit met je beeldmateriaal in een willekeurige editor, en publiceer dan naar Shorts, Reels of waar dan ook. Omdat de audio een op zichzelf staand bestand is, werkt één vertelling op elk platform waarop je plaatst.
Wat heb ik nodig om mijn eigen stem te klonen?
Upload een audiobestand van ten minste 20 seconden schone spraak met minimale achtergrondruis naar het voice clone-gedeelte. Uit dat korte, rustige monster maken we een aangepast stemmodel dat je vervolgens net als elke andere stem in je Text to Speech-projecten kunt gebruiken.
Kan ik dezelfde stem in verschillende talen gebruiken?
Ja. Ons platform ondersteunt meertalige nasynchronisatie over 33 doeltalen, en door Text to Speech, voice cloning en AI Dubbing te combineren kun je één herkenbare stem behouden over versies van dezelfde content, zodat een Engelse short en zijn anderstalige versies een consistente verteller delen.
Is er een manier om dit voor veel video's tegelijk te automatiseren?
Ontwikkelaars en bureaus kunnen onze Text to Speech API gebruiken om tekst programmatisch naar audio om te zetten, en de Voice Cloning API om een monster te uploaden, een benoemde aangepaste stem te maken en die binnen TTS-projecten aan te roepen. Daarmee kun je vertelling genereren over grote catalogi en meerdere kanalen zonder handmatig werk per video.
Moet ik een standaardstem kiezen of mijn eigen stem klonen?
Een standaardstem is de snelste manier om het effect te testen en werkt goed voor veel makers. Klonen is de betere keuze wanneer je een verteller wilt die onmiskenbaar aan je merk is gekoppeld en in de loop van de tijd consistent blijft. Beide op dezelfde clip proberen is de snelste manier om te beslissen welke je verkiest.