Contentproductie schalen met AI betekent dat je van elk script, elke video en elke opname talrijke afgewerkte, meertalige assets maakt zonder dat je team in hetzelfde tempo meegroeit. Het praktische antwoord op hoe je contentproductie met AI schaalt, is niet steeds meer tools op elkaar stapelen—het is het samenbrengen van stem, nasynchronisatie, transcriptie en beeldmateriaal in één workflow waarin elke asset vanaf dag één is ontworpen om vermenigvuldigd te worden. Bij DubSmart AI hebben we ons platform precies rond die verschuiving gebouwd, zodat één hoofdstuk content kan uitgroeien tot tientallen gelokaliseerde, hergebruikte versies zonder een evenredige toename van personeel of budget.
De echte beslissing is niet of AI media kan genereren. Het is of je elke video, aflevering en cursus als een eenmalige productie blijft behandelen, of standaardiseert op een AI-first workflow waarin content is gebouwd om te schalen over talen, formaten en kanalen heen.
Inhoudsopgave
Wat je eigenlijk probeert te schalen
Voordat je een tool kiest, helpt het om te benoemen wat schalen voor jouw kanaal of organisatie betekent, want de drie veelvoorkomende varianten trekken in verschillende richtingen:
- Meer versies van dezelfde content — extra talen, formaten en lengtes vanuit één master.
- Meer totale content — meer afleveringen, lessen of campagnes die elke maand worden gepubliceerd.
- Meer kanalen — YouTube, TikTok, podcasts, leerplatforms en interne portals vanuit hetzelfde bronmateriaal.
De meeste makers en teams hebben uiteindelijk alle drie tegelijk nodig, en daarom hebben we DubSmart ontworpen als één plek om media te creëren, te lokaliseren en te schalen—stem, video en beelden—in plaats van als een generator met één functie.
Voor de doelgroepen die we bedienen, neemt schalen meestal een herkenbare vorm aan. Een YouTube-maker verandert één vlaggenschipvideo in nagesynchroniseerde versies voor meerdere markten, plus shorts en promo's. Een klein bedrijf zet een handvol Engelstalige uitlegvideo's om in volledige meertalige funnels van landingsvideo's, advertentiecreatives en instructieclips. Een e-learningteam verandert één cursus in consistente voice-over en gelokaliseerde edities over regio's heen. Filmmakers en podcasters hergebruiken masters voor internationale releases en toegankelijke versies. Ontwikkelaars en bureaus integreren stem en nasynchronisatie rechtstreeks in hun eigen producten via onze API's.
De beslissing die onder al deze ligt, is dezelfde: stop met het produceren van elke asset als een nieuw project, en begin met het produceren van masters die je wilt vermenigvuldigen.
Van handmatige productie naar een AI-versnelde workflow
Een handmatige pijplijn herhaalt dezelfde kostbare stappen voor elke asset: schrijf het script, boek en neem een menselijke voice-over op, bewerk, mix, master, vertaal daarna en neem opnieuw op voor elke taal voordat je exporteert en opnieuw exporteert voor elke revisie. Elke nieuwe taal of elk nieuw formaat herstart het grootste deel van die keten.
Een AI-versnelde workflow behoudt de creatieve beslissingen en automatiseert de herhaalbare productie. In ons platform wonen de stappen die vroeger aparte planning, software en leveranciers vereisten in één browserwerkruimte:
- Text to Speech zet een geschreven script in seconden om in natuurlijk klinkende voice-over, gebruikmakend van een bibliotheek met 300+ stemmen in vele talen.
- Voice Cloning creëert een stem opnieuw vanuit een korte sample, zodat een merk- of makerpersona consistent blijft over elk project en elke taal heen.
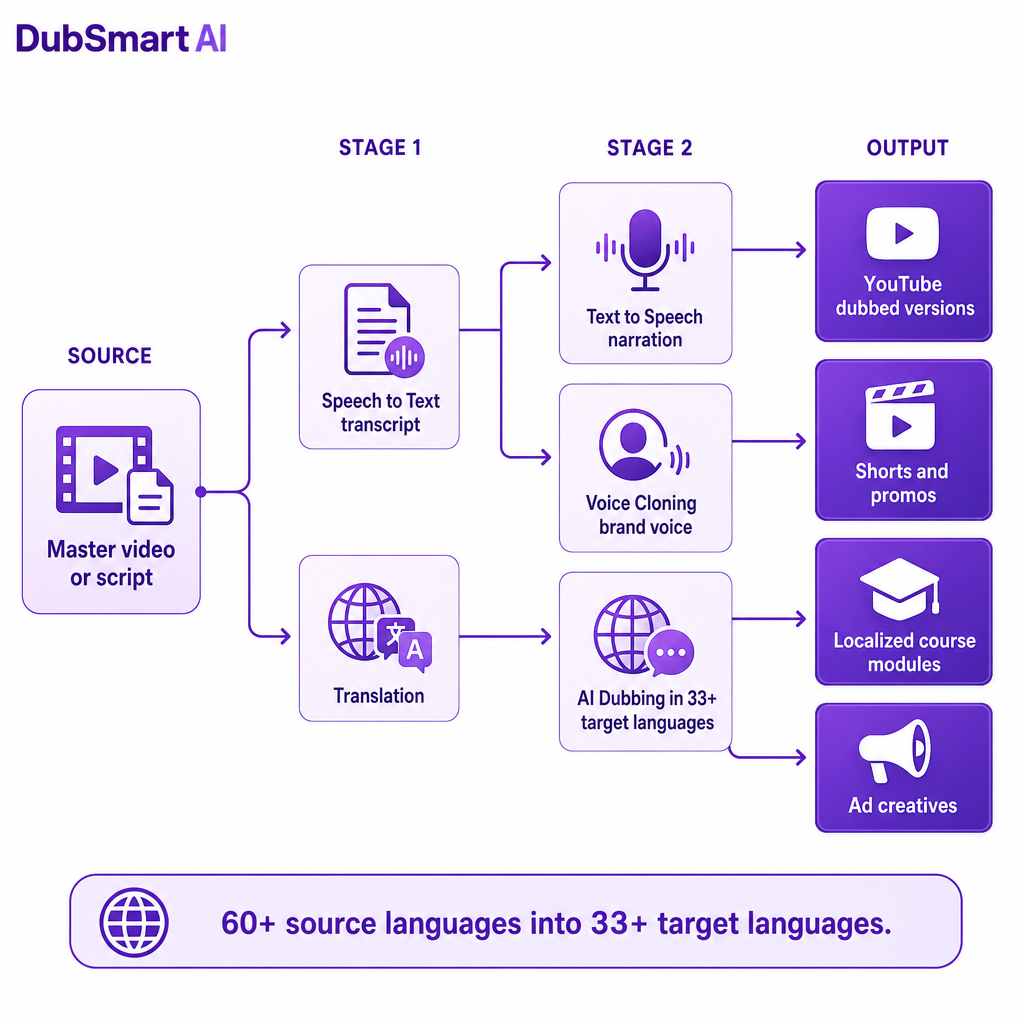
- AI Dubbing neemt een bronvideo of -audio, transcribeert deze, vertaalt deze en genereert gelokaliseerde stemtracks in 33+ doeltalen vanuit 60+ brontalen.
- Speech to Text en Speech Separator reinigen en transcriberen bestaande opnames, waardoor archieven doorzoekbaar en klaar voor hermontage worden.
- Text to Image en Image to Video genereren beelden vanuit prompts en zetten stills om in beweging, zodat je campagnes kunt publiceren zonder vanuit beeldmateriaal te beginnen.
Het mechanisme dat daadwerkelijk schaal produceert, is geen van deze functies afzonderlijk. Het is de consolidatie: de output van één stap voedt de volgende binnen hetzelfde systeem, dus een script wordt voice-over, voice-over wordt een nagesynchroniseerde catalogus en een transcript wordt nieuwe geschreven en visuele assets—zonder tussen losgekoppelde apps te exporteren.
De kernmechanismen die je output vermenigvuldigen
Voice-over zonder meer talent te boeken
Met onze Text to Speech-tool kun je een script plakken, kiezen uit honderden mannelijke, vrouwelijke en neutrale stemmen en direct voice-over genereren. Dat verandert hoe je plant: je kunt eerst scripten en later audio genereren, meerdere tonen testen voordat je je vastlegt, en consistente series produceren—cursusmodules, podcastsegmenten, onboardingflows—zonder voice-sessies te hoeven inplannen.
Voice cloning breidt dit uit door je een herbruikbare aangepaste stem te laten bouwen vanuit een korte sample en deze toe te passen over zowel voice-over als nasynchronisatie. Voor een merk betekent dat één herkenbare hoststem over elke taal heen, zelfs wanneer het oorspronkelijke talent niet in de ruimte is, plus ruimte voor bewuste varianten—een rustigere stem voor interne trainingen naast een krachtigere voor marketing—terwijl je merktrouw blijft.
Eén master, vele talen
Nasynchronisatie is de belangrijkste hefboom om één stuk content om te zetten in een wereldwijde catalogus. In de praktijk upload je een video of plak je een link, detecteert ons platform sprekers, transcribeert en vertaalt het de spraak en genereert het gelokaliseerde tracks met dezelfde stemengine. Vervolgens pas je timings, sprekers en tekstsegmenten aan in de editor voordat je het door jou gekozen formaat exporteert.
De functies die dit laten schalen in plaats van simpelweg vertalen zijn detectie van meerdere sprekers—essentieel voor interviews, panels en gescript dialoog—brede taaldekking en nauwe integratie met voice cloning zodat elke nagesynchroniseerde versie de identiteit van de oorspronkelijke spreker kan behouden of een consistente merkstem kan dragen. Voor de stapsgewijze tactieken behandelt onze gids over hoe je een meertalig YouTube-kanaal maakt de operationele workflow; deze uitleg richt zich op waarom je het toepast.
Archieven omzetten in nieuwe content
Schalen gaat niet alleen over nieuwe productie. Een groot deel van onbenutte output zit al in je opnames. Speech to Text maakt nauwkeurige transcripties en ondertitels, waardoor oude audio en video doorzoekbaar, bewerkbaar en klaar voor hergebruik worden. Speech Separator isoleert stem van muziek en achtergrondgeluid, zodat je een track kunt reinigen, remixen of hergebruiken zonder opnieuw op te nemen.
Samen ontsluiten deze podcastcatalogi die blogposts, shorts en nagesynchroniseerde afleveringen worden; opgenomen trainingen die gestructureerde modules worden met heldere voice-over en ondertitels; en ruw beeldmateriaal dat verfijnd kan worden tot releases van hogere kwaliteit. Als je het praktische proces wilt, behandelt onze handleiding over hoe je audio naar tekst transcribeert dit direct.
Beeldmateriaal op contentsnelheid
Teams lopen vaak tegen het schaalplafond aan bij ontwerp en video, niet bij audio. Onze AI-beeldgenerator produceert merkconforme beelden vanuit prompts voor thumbnails, social posts en slides, terwijl Image to Video stills omzet in beweging, geschikt voor uitlegvideo's, advertenties en intro's. Gecombineerd met voice-over en nasynchronisatie laat dit je van script naar AI-stem naar AI-beelden naar gelokaliseerde nasynchronisatie bewegen binnen één systeem, in plaats van aparte apps aan elkaar te knopen voor elke fase.
Hoe verschillende teams hun schaalstrategie structureren
Omdat het platform deze tools bundelt, hangt de juiste strategie af van waar je begint.
YouTube-makers en onafhankelijke filmmakers leunen op nasynchronisatie om elke vlaggenschipvideo om te zetten in meerdere taalversies met ondersteuning voor meerdere sprekers en consistente gekloonde stemmen, en combineren dat vervolgens met korte promo's ingesproken door Text to Speech om de kalender vol te houden zonder extra opnames.
Kleine bedrijven en marketingteams behandelen het platform als een contentvermenigvuldiger: script of neem één kern-uitlegvideo op, lokaliseer deze vervolgens en spin productdemo's en advertentiecreatives eruit, met bijpassende beelden en korte video's zodat een lancering in meerdere regio's geen evenredig ontwerpbudget vereist.
E-learning- en bedrijfstrainingsproducenten genereren heldere, consistente voice-over voor modules, lokaliseren vervolgens cursussen via nasynchronisatie en voegen nauwkeurige ondertitels toe met Speech to Text—waardoor een grote catalogus coherent blijft terwijl meertalige teams worden ondersteund.
Podcasters en audio-first makers reinigen dialoog met Speech Separator, transcriberen voor bewerking en ondertitels, en hergebruiken die assets in nagesynchroniseerde of samengevatte afleveringen. Wanneer een release een filmische of uitzendwaardige afwerking met menselijk toezicht nodig heeft, voegt onze professionele dubbingstudiolaag dat toezicht toe.
Ontwikkelaars en bureaus integreren onze AI Dubbing API samen met onze Text to Speech- en Voice Cloning-API's om schaalbare stem en lokalisatie in hun eigen producten in te bedden—een goede match voor leerplatforms, OTT-apps en social-videotools die geautomatiseerde nasynchronisatie op volume nodig hebben.
Beslissen wanneer AI-first productie de juiste keuze is
Vijf factoren bepalen meestal of een AI-first stack zijn plaats verdient boven het toevoegen van meer freelancers en eenmalige tools.
| Beslissingsfactor | AI-first productie past wanneer | Wat ons platform bijdraagt |
|---|---|---|
| Volume en frequentie | Je publiceert wekelijkse series, shows met meerdere afleveringen of cursussen met meerdere modules | Een werkruimte gebouwd voor makers en bedrijven met hoog volume |
| Taal- en marktdekking | Internationaal bereik of toegankelijkheid is een prioriteit | Nasynchronisatie vanuit 60+ bron- naar 33+ doeltalen, met transcriptie en vertaling ingebouwd |
| Budget en kostenstructuur | Menselijke kosten per sessie zijn onvoorspelbaar | Een creditgebaseerd model met doorrollende credits en een gratis laag om over tools te verdelen |
| Merkstem en kwaliteit | Je hebt consistente host-, personage- of merkstemmen nodig | Voice cloning plus een bibliotheek met 300+ stemmen, met een menselijk gesuperviseerde studio-optie voor cruciale fragmenten |
| Workflow en controle | Je wilt redactioneel toezicht, geen black-box-output | Browsergebaseerde projecteditors, bediening voor meerdere sprekers en API's |
Als meerdere rijen jouw situatie beschrijven, is centraliseren op één platform meestal duurzamer dan het uitbreiden van een lappendeken van leveranciers en apps met één functie. Als er maar één op jou van toepassing is, kan het de moeite waard zijn om eerst één tool te adopteren en de stack te schalen naarmate je catalogus groeit.
Risico's die het waard zijn om te beheersen voordat je schaalt
Schalen met AI introduceert echte risico's, en een paar verdienen een plan in plaats van een schouderophalen.
Robotachtige of weinig vertrouwenwekkende audio. Dunne synthetische spraak ondermijnt geloofwaardigheid. Stemmen kiezen per use case—verschillende keuzes voor advertenties, trainingen en podcasts—en testen voor publicatie houdt de kwaliteit hoog over een grote stembibliotheek.
Gefragmenteerd merkgeluid. Werk verspreiden over veel tools en freelancers versplintert je identiteit. Herbruikbare gekloonde stemprofielen toegepast over nasynchronisatie en voice-over houden één herkenbaar geluid.
Vertaling en culturele nuance. Automatische vertaling gaat snel maar kan idioom en toon missen. Voor content met hoge inzet zoals film, uitzending of gevoelige trainingen, voeg menselijke beoordeling toe—onze professionele studiodienst bestaat precies voor die gevallen.
Rechten en toestemming voor synthetische stemmen. Voice cloning roept licentie- en toestemmingsvragen op. Behandel gekloonde stemmen als assets die gedocumenteerde toestemming nodig hebben, en houd het gebruik binnen een beheerde werkruimte in plaats van anonieme generators. Bevestig voor jurisdictie-specifieke verplichtingen de vereisten voor jouw eigen situatie.
Misbruik en deepfakes. Elke capabele stemengine kan worden misbruikt wanneer governance zwak is. Projecten getraceerd houden binnen één platform, onder duidelijke organisatiebeleidslijnen, maakt synthetische stem veel gemakkelijker te controleren dan verspreide ad-hoctools.
Als je nog steeds AI-voice-over afweegt tegen het opnemen van talent, kan onze vergelijking van nasynchronisatie versus ondertitels voor video je helpen beslissen hoe ver je lokaliseert voordat je een hele catalogus vastlegt.
Veelgestelde vragen
Wat maakt een alles-in-één platform anders dan een enkele text-to-speech-tool?
Een enkele tool lost één stap op. Wij combineren Text to Speech, Voice Cloning, AI Dubbing, Speech to Text, Speech Separator, Text to Image en Image to Video in één werkruimte, zodat je van script of bronvideo naar volledig gelokaliseerde, multimodale content gaat zonder van app te wisselen of ertussen te hoeven exporteren.
Hoeveel talen kan ik realistisch ondersteunen?
Onze AI Dubbing ondersteunt nasynchronisatie vanuit 60+ brontalen naar 33+ doeltalen, ondersteund door een bibliotheek met 300+ stemmen en voice cloning. Die dekking maakt het praktisch voor een klein team om werkelijk wereldwijde kanalen te runnen.
Is dit alleen voor solomakers, of kunnen teams het gebruiken?
Beide. Wij bedienen individuele makers en bedrijven, inclusief professionele nasynchronisatieworkflows met menselijk toezicht en API's voor ontwikkelaars—zodat hetzelfde platform zowel een solo-YouTuber als een enterprise-trainingsteam past.
Kan ik het integreren in mijn eigen app of automatiseringsstack?
Ja. Onze AI Dubbing-, Text to Speech- en Voice Cloning-API's laten ontwikkelaars en bureaus schaalbare stem en lokalisatie rechtstreeks in hun producten en pijplijnen inbedden.
Hoe snel kan ik van één taal naar een meertalige aanwezigheid gaan?
Tijdlijnen hangen af van je catalogusgrootte en beoordelingsproces. Omdat transcriptie, vertaling, stemgeneratie en projectbewerking op één plek wonen, kan een klein team een paar kernassets in dagen of weken in plaats van maanden omzetten in vele gelokaliseerde versies. Voor een op maat gemaakte schatting, vertel ons je catalogusgrootte, doeltalen en beoordelingsvereisten en wij kunnen een realistisch plan uitstippelen.