Een AI-voice-over voor trainingsvideo's komt tot stand wanneer je een geschreven script combineert met een AI-stemmotor, optioneel de stem van je trainer kloont en in één of meerdere talen narratie genereert vanuit één platform. Dat is het korte antwoord op hoe je een AI-voice-over voor trainingsvideo's maakt, en het geldt zowel wanneer je een onboardingclip van twee minuten produceert als wanneer je een volledige compliance-bibliotheek lokaliseert. De grotere vraag is welke workflow past bij je content, je doelgroep en hoe vaak je verwacht het materiaal bij te werken.
Met DubSmart AI kiezen trainingsteams over het algemeen één van twee startpunten. Je genereert ofwel nieuwe narratie uit tekst, of je uploadt bestaande video's en laat het platform ze van begin tot eind nasynchroniseren door transcriptie, vertaling en stemgeneratie af te handelen. Beide routes bevinden zich binnen één op credits gebaseerde workflow, dus je hebt zelden een aparte transcriptie-app, vertaaldienst of stemtool nodig om een cursus af te ronden.
Inhoudsopgave
Welke beslissing neem je eigenlijk?
De echte keuze gaat niet alleen om welke knop je indrukt. Het gaat om welk soort voice-over-workflow past bij je trainingscontent en de mensen die ernaar kijken. Met DubSmart AI valt die beslissing meestal in drie categorieën, en elke categorie bepaalt hoe consistent je leerervaring aanvoelt en hoe snel je later cursussen kunt herzien.
- Gebruik standaard AI-vertellers uit een bibliotheek van meer dan 300 natuurlijk klinkende stemmen in meer dan 33 talen wanneer je simpelweg snelle, professionele trainingsnarratie nodig hebt.
- Kloon een specifieke trainer- of merkstem zodat leerlingen een vertrouwde spreker horen, zelfs wanneer cursussen worden gelokaliseerd naar meerdere talen.
- Automatiseer voice-overproductie via onze API's wanneer je cursustekst uit een LMS of app rechtstreeks naar audiogeneratie op grote schaal moet doorsturen.
Elke route beïnvloedt drie dingen tegelijk: hoe uniform de leerervaring klinkt, hoe snel je updates kunt doorvoeren, en hoe eenvoudig je uitbreidt naar meertalige training zonder alles opnieuw op te nemen. Een team dat vijf gepolijste cursussen per jaar produceert, weegt deze anders af dan een team dat enkele honderden rolgebaseerde modules onderhoudt, dus het helpt om je volume en updateritme te benoemen voordat je een tool kiest.
Hoe DubSmart AI voice-overs voor trainingsvideo's maakt
DubSmart is een alles-in-één platform voor AI-mediacreatie en -lokalisatie dat Tekst naar Spraak, Voice Cloning, AI Dubbing, Spraak naar Tekst, Speech Separator, Tekst naar Afbeelding en Afbeelding naar Video consolideert in één op credits gebaseerde workflow. Voor trainingsteams is die consolidatie het punt: je kunt van ruw script naar een voltooide, gelokaliseerde trainingsvideo gaan zonder halverwege van leverancier te wisselen.
Tekst-naar-spraak-narratie uit je script
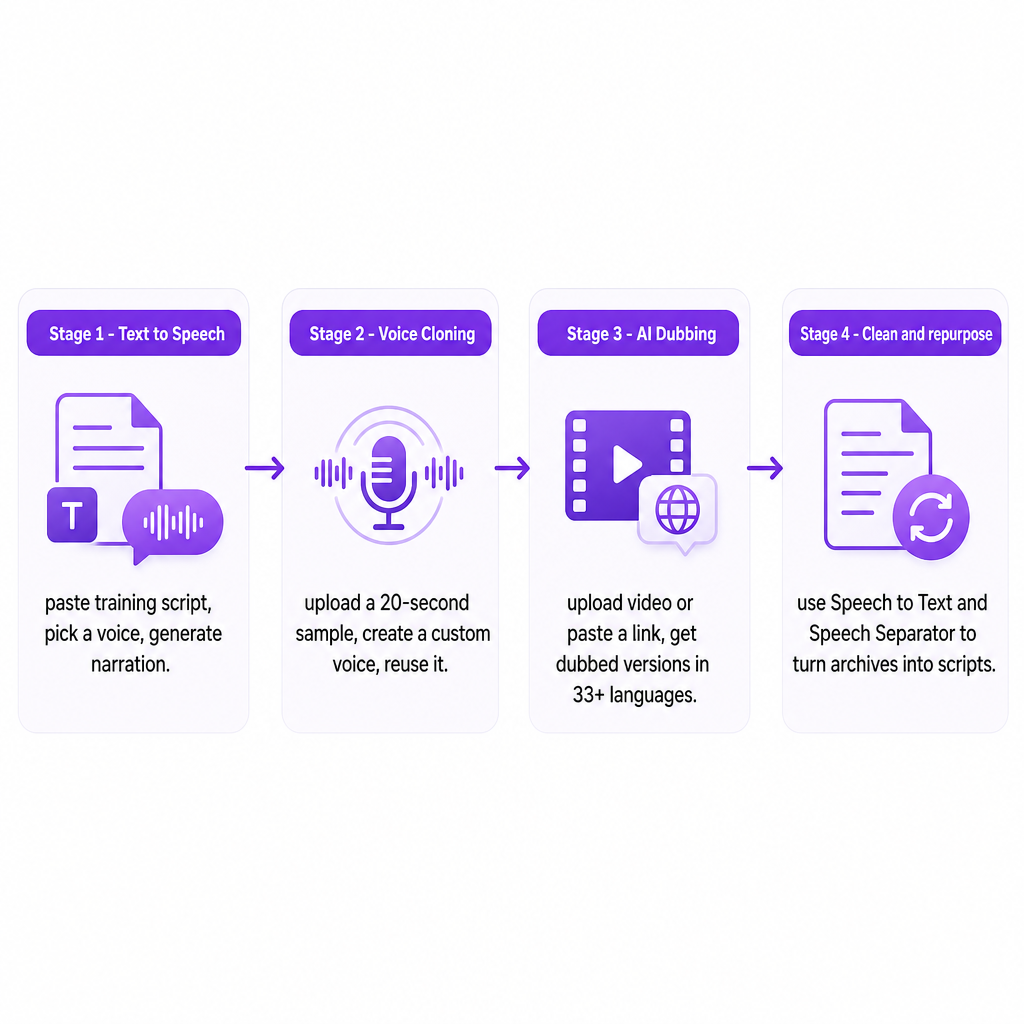
Voor de meeste cursussen is het startpunt een script: onboardingmodules, veiligheidsprocedures, compliance-uitleg of software-doorlopen. Onze Tekst-naar-Spraak-tool zet die tekst om in natuurlijke, mensachtige spraak in elke ondersteunde taal. Binnen de webapp blijft de flow toegankelijk voor niet-technische makers. Je opent de tool, plakt of typt je script, kiest een spreker uit de stembibliotheek en genereert de audio. Zodra het goed klinkt, kun je sprekers toevoegen of wijzigen, afzonderlijke segmenten herzien en het voltooide bestand in je gewenste formaat downloaden om in je video-editor te plaatsen.
Teams met een leerplatform of aangepaste app kunnen dezelfde mogelijkheid bereiken via onze Tekst-naar-Spraak-API. Je stuurt een verzoek met de cursustekst en stemvoorkeuren, en de API retourneert hoogwaardige audio die je programmatisch aan lessen of dynamisch gegenereerde content kunt koppelen.
Je trainer- of merkstem klonen
Wanneer je wilt dat de training klinkt als een specifieke persoon, bouwt Voice Cloning een synthetisch model van die stem zodat er nieuwe spraak kan worden gegenereerd uit tekst in dezelfde toon. Dit verschilt van generieke tekst-naar-spraak, waar je uit standaardvertellers kiest in plaats van je eigen spreker aan te leveren. In de makersvriendelijke route verzamel je een kort, schoon sample, meestal minstens 20 seconden, en upload je het naar de Voice Clone-sectie. Het systeem zet het om in een benoemde aangepaste stem die vervolgens verschijnt in zowel Tekst-naar-Spraak- als AI Dubbing-projecten. Van daaruit plak je scripts en laat je ze voorlezen in de gekloonde stem voor intro's, gedetailleerde uitleg of compliance-segmenten, zonder de trainer voor elke update terug te halen. Als je de onderliggende werking wilt weten, doorloopt onze uitleg over hoe AI elke stem nabootst het model in begrijpelijke termen.
Ontwikkelaars en bureaus kunnen dit formaliseren via de Voice Cloning API als een driestapspatroon. Vraag eerst een vooraf ondertekende URL aan en upload een audiobestand in een ondersteund formaat zoals MP3, WAV, AAC, M4A of FLAC. Maak ten tweede een aangepaste stem door een naam en de bestandssleutel van die upload te sturen. Verwijs ten derde naar de gekloonde stemidentificatie binnen Tekst-naar-Spraak- of AI Dubbing-projecten zodat elke trainingstekst of -video die stem automatisch gebruikt.
Meertalige nasynchronisatie voor wereldwijde doelgroepen
Wanneer je al opgenomen doorlopen, door instructeurs geleide sessies of live presentaties hebt, is deze rechtstreeks nasynchroniseren vaak beter dan opnieuw vanaf nul opbouwen. Onze AI Dubbing API en webtool zijn gebouwd voor spraak-naar-spraak-workflows: je uploadt een bron-video of -audiobestand, of plakt een link, en ontvangt nagesynchroniseerde versies in je doeltalen terwijl het platform transcriptie, vertaling en stemgeneratie afhandelt. Je kunt sprekers toevoegen, timings aanpassen en de gegenereerde tekstsegmenten bewerken zodat terminologie en tempo overeenkomen met je trainingsnormen voordat je downloadt. Omdat nasynchronisatie werkt in meer dan 33 talen en voice cloning integreert, kun je dezelfde trainerstem voor elke regio behouden of vertellers wisselen waar dat zinvol is, allemaal vanuit één account. Voor grote catalogi spiegelt de API deze flow programmatisch en retourneert nagesynchroniseerde tracks die je in een bestaande publicatiepijplijn kunt invoegen.
Bestaande audio opschonen en hergebruiken
Veel organisaties bezitten al bibliotheken met opgenomen webinars en workshops die gestructureerde modules zouden kunnen worden. Omdat DubSmart Spraak naar Tekst en een Speech Separator bevat naast klonen en nasynchroniseren, kunnen die archieven worden omgezet in herbruikbare assets. Spraak naar Tekst zet gesproken content om in transcripties die je kunt bewerken tot schone scripts, en een Speech Separator helpt stemmen te isoleren uit gemengde audio zodat je schonere samples voor klonen of betere input voor transcriptie krijgt. Die combinatie vermindert opnieuw opnemen en laat je verouderde content moderniseren met consistente narratie.
Belangrijke beslissingscriteria voor trainings- en e-learningteams
Zodra je de mechanismen begrijpt, komt de keuze neer op een handvol praktische factoren. De onderstaande tabel koppelt veelvoorkomende prioriteiten aan de route die doorgaans past, en de aantekeningen erna voegen de nuance toe die een tabel niet kan bevatten.
| Prioriteit | Best passende route | Waarom het past |
|---|---|---|
| Herkenbare instructeursstem | Voice cloning | Hergebruik één gekloonde stem over TTS-, nasynchronisatie- en API-workflows |
| Snelheid boven identiteit | Standaard TTS-stemmen | Meer dan 300 stijlen klaar zonder setup |
| Grote of vaak bijgewerkte catalogi | TTS- of Dubbing-API's | Automatiseer generatie in publicatieflows |
| Wereldwijd personeelsbestand | AI Dubbing + klonen | Nasynchroniseer naar meer dan 33 talen, behoud originele sfeer |
| Technische of gereguleerde content | Bewerkbare nasynchronisatieprojecten | Beoordeel terminologie voor afronding |
De consistentie van de leerervaring is vaak de doorslaggevende factor. Als je strategie leunt op een herkenbare instructeur- of bedrijfsstem, houdt klonen die identiteit intact over modules en talen heen, en dezelfde gekloonde stem kan verschijnen in cursussen die maanden uit elkaar zijn gegenereerd. Als snelheid belangrijker is dan één identiteit, laten de meer dan 300 standaardstemmen je de toon afstemmen op het contenttype, bijvoorbeeld een rustigere stem voor compliance en een lichtere voor onboarding.
Volume en updatefrequentie duwen de berekening richting automatisering. Een team dat een handvol cursussen produceert, kan comfortabel werken in de webapp en indien nodig voice-overs en nasynchronisatie genereren. Organisaties die grote catalogi of rolgebaseerde variaties onderhouden, profiteren van de API's, die tekst of video automatisch omzetten naar audio binnen geplande publicatieworkflows. Als je frequente beleidswijzigingen of software-updates verwacht, laten op tekst gebaseerde TTS en nasynchronisatie je narratie snel opnieuw genereren zonder studiotijd te boeken.
Taaldekking is het belangrijkst voor in de VS gevestigde bedrijven die wereldwijde teams opleiden. DubSmart ondersteunt nasynchronisatie van meer dan 60 brontalen naar minstens 33 doeltalen, gekoppeld aan klonen en TTS, zodat elke regio content in zijn primaire taal kan ontvangen met behoud van de look en feel van het origineel. Voor lichtere behoeften, zoals Amerikaans Engels met af en toe Spaanse modules, kunnen standaard-TTS-stemmen voldoende zijn en verminderen ze het setupwerk.
Technische en regelgevende content verdient extra zorg. Jargon, productnamen en juridische formuleringen moeten correct worden uitgesproken en vertaald, dus de mogelijkheid om transcripties en gegenereerde segmenten in nasynchronisatieprojecten te beoordelen en te bewerken geeft vakinhoudelijke experts echte controle. Bij gebruik van API's kun je voorkeursterminologie coderen in je scripts of voorbewerkingslogica zodat wat TTS of nasynchronisatie ontvangt al is gecontroleerd.
Data, toestemming en governance sluiten de lijst af. Klonen vereist spraaksamples van de doelspreker, dus verzeker je van toestemming en documenteer hoe de gekloonde stem zal worden gebruikt. Omdat ons kloonproces korte, schone opnames accepteert, verzamel je minder data terwijl je nog steeds een bruikbaar model produceert. Het centraliseren van klonen, TTS en nasynchronisatie in één platform vereenvoudigt ook audittrails vergeleken met het jongleren met afzonderlijke tools, en een op credits gebaseerd model met API's laat trainingsleiders het gebruik beheren vanuit één accountstructuur.
Risico's en waarborgen bij het gebruik van AI-voice-overs in training
AI-narratie is snel, maar een paar faalscenario's verdienen aandacht voordat je opschaalt.
Misalignment met merk- of instructiestijl is het meest voorkomend. AI-stemmen, inclusief gekloonde, kunnen worden gegenereerd op verschillende snelheden en intensiteiten die mogelijk niet overeenkomen met je huisstijl. Luister naar voorbeelduitvoer, pas waar mogelijk de weergaveparameters aan, en standaardiseer stemkeuzes per cursustype voordat je breed uitrolt.
Uitspraak- en vertaalnuances komen daarna. Geautomatiseerde narratie kan struikelen over namen of gespecialiseerde termen, en machinevertaling kan formuleringen produceren die accuraat maar pedagogisch onhandig zijn. De mogelijkheid om tekstsegmenten in nasynchronisatieprojecten te bewerken en audio opnieuw te genereren helpt, maar het vervangt geen menselijke beoordeling voor kritieke compliance- of veiligheidsmodules.
Overmatige afhankelijkheid van automatisering is een subtieler risico. Voor gevoelige onderwerpen zoals gedrag op de werkvloer, geestelijke gezondheid of wettelijke verplichtingen kunnen toonfouten binnensluipen, zelfs wanneer de feiten kloppen. Het combineren van AI-voice-overs met menselijke beoordeling, en af en toe een door mensen opgenomen segment voor de meest cruciale boodschap, brengt doorgaans een betere balans.
Verantwoord beheer van gekloonde stemmen sluit dit af. Een gekloonde stem is een herbruikbare asset, wat vragen oproept over reikwijdte en levenscyclus. Stel intern beleid op voor wie generatie met een bepaalde stem mag activeren, hoe lang samples worden bewaard, en hoe toegang wordt ingetrokken als een trainer vertrekt. Die vangrails houden de technologie ethisch en voorspelbaar.
Als je afweegt waar AI-narratie past en waar een mens in de lus moet blijven, begin dan met het benoemen van je cursusvolume, talen en hoe vaak de content verandert. Vertel ons die details en we kunnen je helpen de juiste mix van Tekst naar Spraak, voice cloning en nasynchronisatie voor je programma in kaart te brengen.
Veelgestelde vragen
Kan ik de stem van mijn trainer behouden en toch cursussen naar meerdere talen lokaliseren?
Ja. Je kunt de stem van je trainer klonen en die gekloonde stem vervolgens gebruiken in zowel Tekst-naar-Spraak- als AI Dubbing-projecten, inclusief nagesynchroniseerde versies in andere talen.
Hoeveel audio heb ik nodig om een stem te klonen voor trainingsnarratie?
Klonen werkt vanuit korte, schone samples, meestal minstens 20 seconden spraak. Veel makers gebruiken 20 tot 60 seconden voor een robuuster model.
Welke audioformaten kan ik gebruiken bij het uploaden van samples voor voice cloning?
De Voice Cloning API accepteert veelvoorkomende formaten zoals MP3, WAV, AAC, M4A en FLAC, geüpload via een vooraf ondertekende URL voordat het sample een aangepaste AI-stem wordt.
Kunnen ontwikkelaars voice-overs automatiseren vanuit LMS- of app-content?
Ja. Met de Tekst-naar-Spraak-API en AI Dubbing API kunnen backendsystemen trainingstekst of -video sturen en kant-en-klare audio of nagesynchroniseerde tracks ontvangen voor geautomatiseerde publicatieflows.
Is DubSmart geschikt voor compliance- en regelgevingstraining?
Onze combinatie van TTS, voice cloning, AI Dubbing en bewerkingscontroles ondersteunt gestructureerde, herhaalbare workflows, maar teams moeten nog steeds menselijke beoordeling en governance toepassen voor gevoelige of gereguleerde onderwerpen.