De snelste manier om een tekst-naar-spraak-API te integreren is deze als een REST-service te behandelen: authenticeer met een API-sleutel, verstuur je tekst plus steminstellingen als JSON, laat de service op de achtergrond spraak genereren en haal vervolgens de resulterende audiobestanden op en sla ze op voor afspelen waar je gebruikers ze ook nodig hebben. Onze Text to Speech API volgt precies dit patroon en biedt tegelijkertijd toegang tot 300+ natuurlijke stemmen en onbeperkt stemklonen, zodat je levensechte spraak kunt toevoegen aan websites, apps, videopijplijnen en leerplatformen. Deze gids behandelt wat je precies aansluit, hoe onze engine werkt en de beslissingen die bepalen of de integratie bij je product past.
Inhoudsopgave
Wat een tekst-naar-spraak-API doet in DubSmart
Een tekst-naar-spraak-API zet gestructureerde tekst op aanvraag om in gesproken audio, zodat je code narratie of dialoog kan opvragen op het moment dat een script klaar is in plaats van te wachten op handmatige opname. Onze Text to Speech-engine drijft zowel de browsergebaseerde Text to Speech-tool als de API aan, wat toegang geeft tot meer dan 300 AI-stemmen in verschillende talen, geslachten en stijlen, met prosodie afgestemd op narratie, uitlegvideo's en dialoog.
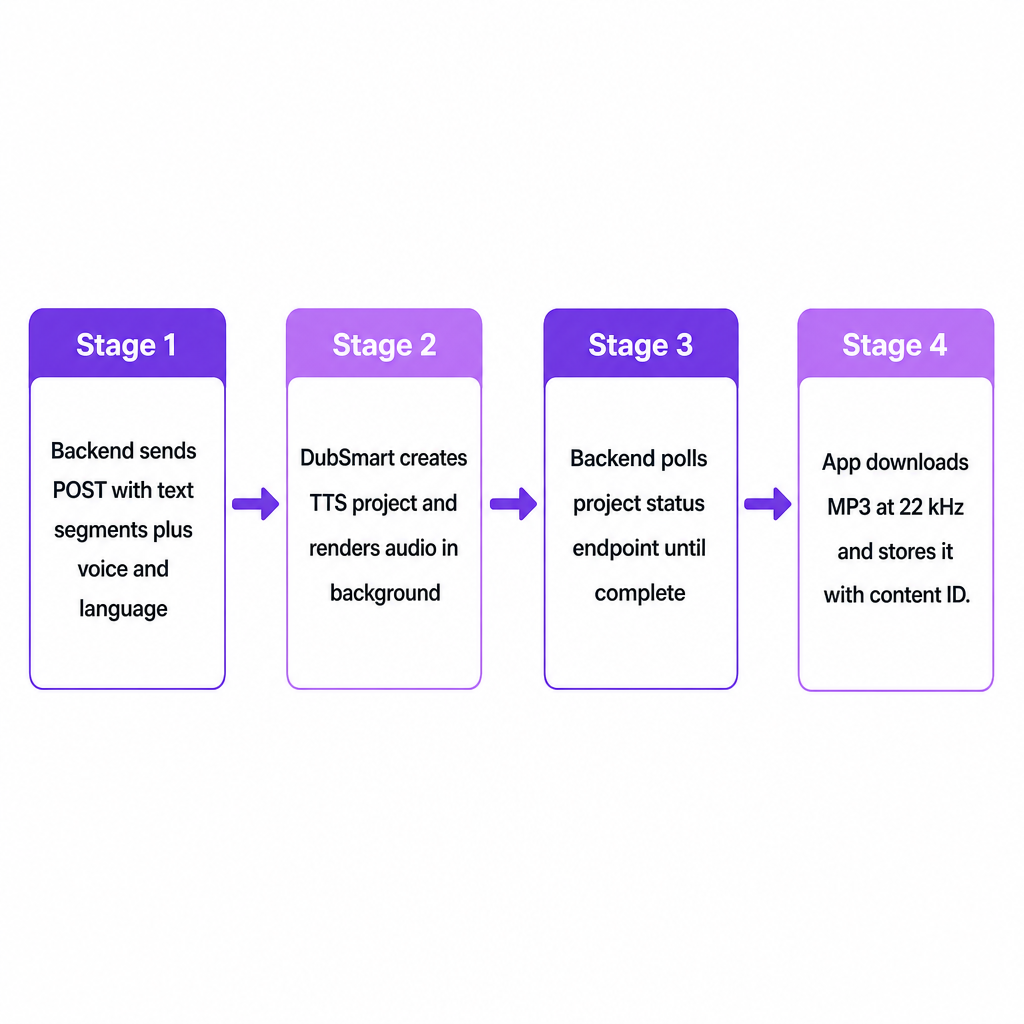
Op de API-laag stellen we deze engine beschikbaar als een RESTful service: je backend verstuurt een POST-verzoek met tekstsegmenten en stemparameters, en de service retourneert een projectobject waarvan je de status kunt pollen totdat de audio klaar is om te downloaden. De uitvoer wordt geleverd als audiobestanden van hoge kwaliteit, doorgaans MP3 op 22 kHz, geschikt voor direct gebruik in video-editors, podcastworkflows of webspelers zonder extra conversie.
Voor de makers en teams die wij bedienen—YouTubers, kleine bedrijven, e-learningproducenten, filmmakers en ontwikkelaarsbureaus—overbrugt de API contentplanning en publicatie. Zodra een script een CMS of leerplatform bereikt, kan de backend automatisch voice-overs genereren, wat de bottleneck van herhaalde handmatige opname wegneemt.
De integratiebeslissing: wat sluit je nu eigenlijk aan?
"Een tekst-naar-spraak-API integreren" klinkt algemeen, maar in de praktijk beslis je over drie dingen: waar in je workflow spraak gegenereerd moet worden, welke stemmen en talen je merk vertegenwoordigen, en hoe strak je het genereren en ophalen van audio automatiseert.
Voor een YouTube-maker die uitbreidt naar meertalige content betekent integratie vaak het koppelen van onze API aan een videoplanningstool of scriptdatabase, zodat elk afgerond script een voice-over wordt in de juiste taal en stijl. Voor kleine bedrijven en marketingteams zit de API doorgaans achter een CMS of marketingautomatiseringsplatform, waarbij blogposts, productuitleg en socialteksten worden omgezet in herbruikbare audio-assets. E-learning- en bedrijfstrainingsaanbieders koppelen de API vaak aan auteurstools, zodat lesmodules per dia of per onderwerp narratie kunnen opvragen en deze direct opnieuw kunnen genereren wanneer het materiaal wordt bijgewerkt.
Ontwikkelaars en bureaus die voice-AI dieper integreren kiezen meestal tussen twee patronen. Een batchmodel verzamelt scripts en verwerkt ze via geplande taken. Een transactioneel model activeert een onmiddellijk verzoek telkens wanneer nieuwe content of een gebruikersactie binnenkomt. Onze projectgebaseerde API werkt naadloos voor beide, omdat elk TTS-project tekst, stemkeuze, taal en resulterende audio inkapselt op een manier die aansluit bij je eigen content-eenheden—video's, lessen of podcastafleveringen. Als je het concept zelf nog aan het afwegen bent, behandelt onze aanvullende uitleg over wat een tekst-naar-spraak-API is en hoe deze werkt de basis voordat je je vastlegt op een ontwerp.
Hoe onze Text to Speech API onder de motorkap werkt
Onze Text to Speech API is opgebouwd rond projecten en segmenten, wat deze flexibeler maakt dan een enkel "tekst erin, audio eruit"-endpoint. Een TTS-project groepeert een of meer tekstsegmenten onder een titel en gedeelde configuratie zoals taal en standaardstem. Elk segment draagt zijn eigen tekst, stem-identifier en taalcode, waardoor je narratiestijlen of talen binnen één uitvoer kunt combineren.
Een typische JSON-payload naar het TTS-projecteindpunt bevat een leesbare projecttitel voor je dashboards en logs, plus een array van segmenten. Elk segment stelt text in (het script of de zin om uit te spreken), voice (ofwel een ingebouwde stem-ID of een aangepaste stem-ID gemaakt via de Voice Cloning API), en language (een code die de taal van het segment aangeeft).
Wanneer je backend deze payload naar het TTS-eindpunt verstuurt met een geldige API-sleutel in de Authorization-header, maken we het project aan en beginnen we op de achtergrond met het genereren van audio. De API stelt een projectstatus-eindpunt beschikbaar dat rapporteert of de verwerking nog bezig is of voltooid, samen met verwijzingen naar de gegenereerde audiobestanden zodra ze klaar zijn. Dit asynchrone ontwerp houdt je eigen verzoeken snel: log de project-ID, geef de controle terug aan de gebruiker en laat een achtergrondworker controleren op voltooiing en de audio ophalen wanneer beschikbaar.
Gegenereerde spraak komt aan als downloadbare bestanden in standaardformaten, met name MP3 op 22 kHz, wat gemakkelijk past in webspelers, mobiele apps en video-editingtijdlijnen. Omdat dezelfde engine onze browsergebaseerde tool aandrijft, kunnen ontwikkelaars interactief stemmen en scripts prototypen en vervolgens de winnende combinaties migreren naar geautomatiseerde API-oproepen. De volledige eindpuntreferentie staat op de Text to Speech API-pagina.
Stemklonen en AI-nasynchronisatie koppelen aan tekst-naar-spraak
Ons kenmerkende voordeel is dat Text to Speech, Voice Cloning en AI Dubbing één onderliggende stem-engine en workflow delen. Dat betekent dat de TTS API niet geïsoleerd is—het is de kern van een bredere lokalisatiepijplijn.
Met de Voice Cloning API kun je audiosamples van een spreker uploaden, een aangepaste AI-stem maken en naar die stem verwijzen in TTS-projecten. Zodra een aangepaste stem bestaat, wordt de identifier ervan het voice-veld in je Text to Speech-segmenten, zodat de narratie in de gekloonde stem afspeelt in plaats van een generieke voorraadstem. Die continuïteit is belangrijk voor presentatoren, podcasters en merkwoordvoerders die een consistente sonische identiteit willen behouden over talen en formaten heen. Als je van plan bent stemklonen toe te voegen, behandelt onze gids over het integreren van een stemkloon-API in je app de specifieke details.
De AI Dubbing API breidt dit verder uit door transcriptie, vertaling en tekst-naar-spraak te combineren in één pijplijn die video's nasynchroniseert naar meer dan 33 doeltalen. Hier zet de TTS-engine vertaalde scripts om in spraak met dezelfde bibliotheek van 300+ stemmen of je gekloonde stem, zodat nagesynchroniseerde versies toon en timing behouden. Voor meertalige makers en bedrijven wordt de Text to Speech API de bouwsteen voor zowel eentalige voice-overs als volledig gelokaliseerde nagesynchroniseerde content. Ons overzicht van hoe AI-lokalisatie werkt laat zien hoe deze onderdelen van begin tot eind samenkomen.
Belangrijke beslissingscriteria bij het integreren van onze TTS API
Het integreren van "een willekeurige" TTS API is niet genoeg; de keuzes rond implementatie bepalen hoe goed deze past bij je productie, merk en technische stack.
Behoeften voor schaal en automatisering. Als het contentvolume laag en sporadisch is, kan de browsergebaseerde tool volstaan. Zodra scripts regelmatig worden gegenereerd of gekoppeld aan contentkalenders, leerbeheersystemen of marketingautomatisering, wordt de API de juiste laag omdat deze programmatisch kan worden geactiveerd en met je backend kan worden opgeschaald.
Stem- en taalstrategie. Ons platform ondersteunt nasynchronisatie van meer dan 60 brontalen naar 33 doeltalen, aangedreven door dezelfde stem-engine die de TTS API gebruikt. Als je merk een onderscheidende woordvoerdersstem nodig heeft, houdt het koppelen van de Voice Cloning API aan TTS die stem consistent over talen en kanalen heen. Als je snelheid boven personalisatie stelt, houden ingebouwde stemmen de implementatie eenvoudiger.
Integratiepunt in je stack. Voor YouTube-kanalen is een natuurlijke plek de videopijplijn: scripts opgeslagen in een planningstool, verstuurd naar de TTS API wanneer afgerond, en teruggegeven als audio klaar voor editors. E-learningplatformen kunnen integreren op les- of dianiveau, waar elk contentblok overeenkomt met een segment en projecten hele cursussen vertegenwoordigen. Marketingteams integreren vaak op CMS-niveau, zodat elk artikel of elke productpagina een audioversie kan opvragen voor toegankelijkheid.
Governance, naleving en risico. Omdat stemklonen herkenbare stemmen kan repliceren, zijn toestemming, licenties en gebruiksbeleid van belang. Gekloonde stemmen worden geïdentificeerd door ID's en kunnen worden getagd met metadata, wat het gemakkelijker maakt om interne regels af te dwingen over waar specifieke stemmen mogen worden gebruikt. Beslis vooraf welke omgevingen gekloonde stemmen versus generieke stemmen mogen activeren, en voeg logging toe aan je eigen systemen.
Verwachtingen rond latentie en gebruikerservaring. Asynchrone verwerking biedt flexibiliteit maar voegt een timingoverweging toe. Voor workflows waar gebruikers onmiddellijk afspelen verwachten—zoals een scripteditor met directe preview—maak kleinere projecten of segmenten en toon voortgangsindicatoren terwijl audio wordt gerenderd. Voor batchlokalisatie over hele bibliotheken maakt latentie minder uit, en taken kunnen volgens schema's draaien met voltooide audio die achteraf aan contentrecords wordt gekoppeld.
| Beslissingsgebied | Batchmodel | Transactioneel model |
|---|---|---|
| Trigger | Geplande taken | Per content-item of gebruikersactie |
| Latentietolerantie | Hoog | Laag |
| Beste geschiktheid | Cursuscatalogi, videobibliotheken | Scripteditors, live previews |
| Stemstrategie | Goedgekeurde stem per taal | Goedgekeurde stem per taal |
Risico's en praktische waarborgen
Het integreren van een tekst-naar-spraak-API brengt een paar voorspelbare risico's met zich mee die met doordacht ontwerp kunnen worden beperkt.
Stemmen kiezen zonder te testen kan spraak opleveren die niet bij een merk of presentator past. Test stemmen eerst in de interactieve interface, en houd een goedgekeurde stemcatalogus in je eigen systemen bij, georganiseerd per taal en contenttype, voordat je stem-ID's vastlegt in API-oproepen.
Over-automatisering van gevoelige content is een andere valkuil. Automatisch spraak genereren voor nalevings-, medisch- of juridisch materiaal is mogelijk niet gepast. Omdat onze API werkt met afzonderlijke projecten en segmenten, kun je routeringsregels aanhouden die alleen goedgekeurde categorieën naar TTS sturen en gevoelige content in door mensen opgenomen workflows houden.
Operationele fouten—mislukte projecten of ontbrekende downloads—komen voor wanneer netwerkproblemen of ongeldige payloads de verwerking onderbreken. De projectstatus-eindpunten en gestructureerde reacties laten je bevestigen dat een project is voltooid en de uitvoer beschikbaar is voordat je publiceert. Koppel elke TTS-project-ID aan je eigen content-ID en implementeer herhaalpogingen of fallbacks wanneer statuscontroles fouten rapporteren.
Misbruik van gekloonde stemmen verdient expliciete controles. Aangepaste stemmen moeten worden gemaakt via speciale eindpunten en vervolgens per ID worden gerefereerd in TTS-projecten, wat je een duidelijke technische grens geeft om te bewaken. Beperk wie gekloonde stem-ID's kan maken of toewijzen, en log waar ze worden gebruikt.
Een praktische startroute is om TTS eerst te integreren voor standaard voice-overs, stemmen en foutafhandeling in productie te valideren, en vervolgens Voice Cloning en AI Dubbing toe te voegen zodra de kernintegratie stabiel is. Vertel ons je contentvolume, doeltalen en waar de API in je stack moet zitten, en we kunnen je wijzen op de juiste eindpunten en plan voor je workflow.
Veelgestelde vragen
Wat is het verschil tussen de Text to Speech API en de browsertool?
De browsertool is een visuele interface waar je tekst plakt, een stem kiest en handmatig audio downloadt. De API stelt dezelfde engine beschikbaar via REST-eindpunten, zodat je backend automatisch audio kan genereren en ophalen als reactie op scripts, schema's of gebruikersacties.
Kan de API in mijn eigen stem spreken, niet alleen in voorraadstemmen?
Ja. Door de Voice Cloning API te integreren, upload je audiosamples van een spreker, maak je een aangepaste AI-stem en verwijs je vervolgens naar de ID van die stem in je Text to Speech-segmenten, zodat alle gegenereerde spraak in de gekloonde stem afspeelt.
Hoe helpt dit bij meertalige YouTube-kanalen of podcasts?
Ons platform zet spraak of scripts van meer dan 60 brontalen om in nagesynchroniseerde uitvoer over 33 doeltalen, waarbij TTS de uiteindelijke audio genereert met 300+ stemmen of je gekloonde stem. Het koppelen van de TTS- en AI Dubbing-API's aan je publicatiepijplijn laat nieuwe video's of afleveringen voice-overs of volledige nasynchronisaties ontvangen zodra scripts of bronaudio klaar zijn.
Welke audioformaten ontvangt mijn app of editor?
De TTS API levert audiobestanden van hoge kwaliteit, waaronder MP3 op 22 kHz, geschikt voor de meeste web-, mobiele- en video-editingomgevingen zonder extra conversie.
Kan ik nu Text to Speech integreren en later AI Dubbing toevoegen?
Ja. Text to Speech, Voice Cloning en AI Dubbing delen een gemeenschappelijk API-ecosysteem, dus je kunt beginnen met TTS voor voice-overs en later Voice Cloning en AI Dubbing toevoegen om meertalige nasynchronisatie te automatiseren zonder je kernintegratie opnieuw op te bouwen.