Vraag hoe AI-voice-overs worden gemaakt en je vraagt eigenlijk hoe een geschreven script spraak wordt zonder dat iemand een studio in stapt. Het korte antwoord: een neuraal tekst-naar-spraakmodel zet je script om in synthetische audio, een optionele gekloonde stem laat die audio klinken als een specifiek persoon, en een nasynchronisatielaag stemt alles af op je video in verschillende talen. Bij DubSmart AI voeren we die volledige keten uit binnen één werkruimte, zodat je van een alinea tekst naar een afgewerkte, meertalige voice-over kunt gaan zonder van tool te wisselen of studiotijd te boeken.
Hoe dat proces er voor jou uitziet, hangt af van één beslissing, en de rest van deze gids loopt door de mechanismen, de opties en hoe je kiest.
Inhoudsopgave
De beslissing achter hoe AI-voice-overs worden gemaakt
Voordat er audio wordt gegenereerd, maak je twee keuzes die alles verderop vormgeven. De eerste is of je een kant-en-klare stem uit een bibliotheek wilt of een kloon van je eigen stem. De tweede is of je een voice-over in één taal nodig hebt of een volledig gelokaliseerde versie in veel talen.
Voor een YouTube-maker of een klein bedrijf is dat meestal snel beslist: kies een standaardstem voor snelheid, kloon een stem wanneer merkconsistentie belangrijk is, en grijp alleen naar nasynchronisatie wanneer je meertalig gaat. Voor ontwikkelaars en bureaus wordt diezelfde afsplitsing een architectuurvraag — roep je een tekst-naar-spraak-endpoint aan voor eenmalige audio, of koppel je stemklonen en nasynchronisatie samen tot een pipeline die vanzelf draait?
We bouwden DubSmart precies rond deze afsplitsingen. Text to Speech, Voice Cloning, Speech to Text, Speech Separator, Text to Image, Image to Video en AI Dubbing wonen allemaal in één platform, zodat je het niveau van automatisering en personalisatie omhoog of omlaag kunt draaien zonder aparte leveranciers aan elkaar te knopen.
De mechanismen: hoe AI-voice-overs echt worden gemaakt
Tekst naar spraak: script omzetten in geluid
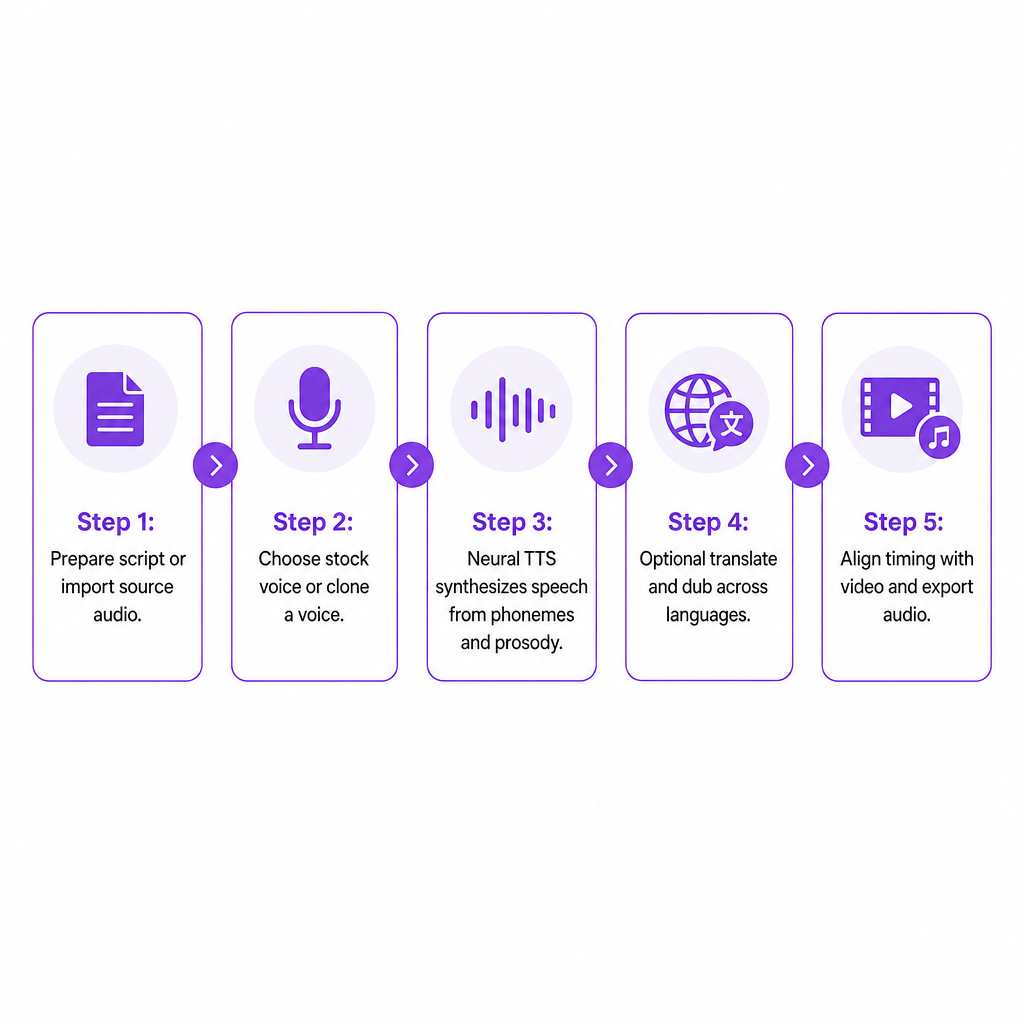
Tekst-naar-spraak (TTS) staat centraal in elke AI-voice-over. De engine analyseert eerst je script — tekst opsplitsen in fonemen, interpunctie en structuur lezen, en prosodie afleiden, dat is het ritme, de nadruk en de intonatie die spraak behoeden voor een vlakke klank. Neurale modellen synthetiseren die fonemen vervolgens tot audio en passen de prosodiepatronen toe die de weergave vloeiend laten klinken in plaats van robotachtig.
Onze Text to Speech-engine laat je tekst in elke taal plakken, een stem kiezen uit een bibliotheek van meer dan 300, en realistische spraak genereren in seconden. De stemmen klinken natuurlijk en menselijk, en ze zijn gecategoriseerd op taal, geslacht en stijl, zodat je de toon van wat je produceert kunt afstemmen. Voor ontwikkelaars wordt dezelfde engine ontsloten via een RESTful Text to Speech API: stuur een POST-verzoek met je tekst- en stemparameters, ontvang gebruiksklare audiobestanden terug. Gestructureerde tekst erin, levensechte audio eruit, zonder handmatige opname.
Stemmodellen en stembibliotheken
AI-voice-overs steunen op getrainde stemmodellen — neurale netwerken die leren hoe een bepaalde stem moet klinken bij verschillende woorden, talen en emoties. Een stembibliotheek is simpelweg een catalogus van die modellen. We onderhouden een bibliotheek van meer dan 300 natuurlijk klinkende stemmen die meerdere geslachten, accenten en spreekstijlen in veel talen bestrijken, en die beschikbaar is zowel in de webapp als via de API, zodat interne tools spraak op aanvraag kunnen genereren.
Stemklonen: de AI laten klinken als jij
Klonen is het mechanisme dat een voice-over laat klinken als een specifiek persoon in plaats van een generieke verteller. Het systeem analyseert een voorbeeldopname, leert het timbre, het toonbereik en de uitspraakpatronen van de spreker, en past die kenmerken vervolgens toe op nieuwe synthetische spraak.
In de praktijk upload je een audiobestand van minstens 20 seconden naar Voice Cloning — bij voorkeur schoon en vrij van achtergrondgeluid. We verwerken dat voorbeeld tot een aangepast stemprofiel dat je een naam kunt geven en kunt hergebruiken, waarbij klonen doorgaans slechts enkele seconden duurt. Eenmaal aangemaakt, komt de gekloonde stem beschikbaar binnen Text to Speech en AI Dubbing, zodat je scripts of nagesynchroniseerde versies in je eigen stem kunt genereren. Programmatisch weerspiegelt de Voice Cloning API dit: verkrijg een upload-URL, stuur je audio in een ondersteund formaat, maak een aangepaste stem aan op basis van de resulterende bestandssleutel, en gebruik die vervolgens in TTS- of nasynchronisatieprojecten.
Nasynchronisatie en meertalige voice-overs
Overstappen van een eentalige voice-over naar meertalige content voegt lokalisatie toe bovenop de basis-TTS. Het algemene patroon is consistent:
- Leg de originele spraak vast of importeer die.
- Transcribeer die naar tekst.
- Vertaal die tekst.
- Genereer nieuwe spraak in de doeltaal.
- Stem de timing af op de originele video of audio.
Onze AI Dubbing-workflow volgt precies dit patroon en combineert spraak-naar-tekst, machinevertaling en tekst-naar-spraak, waarbij optioneel een gekloonde stem wordt hergebruikt zodat het nagesynchroniseerde spoor overeenkomt met de originele spreker. Het zet gesproken content uit meer dan 60 brontalen om in nagesynchroniseerde versies in 33 doeltalen. Spraak-naar-spraaknasynchronisatie streeft ernaar toon en timing dicht bij de originele uitvoering te houden, wat het belangrijkst is voor e-learning, training en filmcontent waar lipsynchronisatie en tempo de ervaring dragen.
API's en geautomatiseerde workflows
Voor teams die op grote schaal voice-overs produceren, zijn API's wat stemcreatie invouwen in bestaande systemen. De TTS API verzorgt tekst-erin, audio-eruit; de Voice Cloning API voegt programmatische creatie en beheer van aangepaste stemmen toe; en de AI Dubbing API breidt beide uit met automatische vertaling en nasynchronisatie in meer dan 33 talen met toegang tot gekloonde stemmen. Samen laten ze je pipelines bouwen waarin scripts, ondertitels of transcripties die uit een contentsysteem worden gehaald automatisch voice-overs of nagesynchroniseerde sporen worden, zonder handmatige bestandsverwerking.
Jouw drie manieren om AI-voice-overs te maken in DubSmart
Binnen ons platform lost de vraag zich op in drie praktische startpunten.
Begin vanuit een script met Text to Speech. Plak je tekst, kies een standaard- of gekloonde stem, stel de taal en basisbedieningen in, en genereer spraak die je in standaardformaten kunt downloaden. Dit past bij trainingsvideo's, uitlegcontent, marketingspots en podcast-intro's waar je het script vanaf het begin bezit.
Begin vanuit bestaande media met AI Dubbing. Upload een bronvideo of audiobestand, laat het systeem transcriberen en vertalen, en genereer vervolgens nagesynchroniseerde sporen in je gekozen talen — waarbij gekloonde stemmen worden hergebruikt om de klank consistent te houden. Dit is de route voor kanalen die uitbreiden naar meertalige doelgroepen en voor bedrijven die webinars of productdemo's hergebruiken.
Begin vanuit je eigen systemen met API-gebaseerde generatie. Je app stuurt tekst- en stemparameters naar de TTS API, koppelt content optioneel aan een specifieke stem via de Voice Cloning API, en haalt audio op die klaar is om aan video's of e-learning-voice-overs voor trainingsmodules te koppelen. Dit past bij ontwikkelaars, bureaus en LMS-aanbieders die consistente, programmatische output nodig hebben.
Beslissingscriteria: je AI-voice-oversetup kiezen
Natuurlijkheid en audiokwaliteit
Natuurlijkheid is onmisbaar. Sterke engines modelleren prosodie en articulatie zodat spraak stroomt met passende pauzes en nadruk. Omdat generatie snel is, kun je een script itereren en audio opnieuw genereren tot de weergave goed aanvoelt, in plaats van genoegen te nemen met de eerste opname.
Taaldekking en lokalisatiediepte
Als meertalige kanalen of internationale training op je roadmap staan, bepaalt de dekking hoe ver je kunt reiken. Content uit meer dan 60 brontalen omzetten naar 33 doeltalen vanuit één workflow bepaalt de markten die je kunt bedienen, en spraak-naar-spraaknasynchronisatie helpt toon en timing consistent te houden in elke versie.
Stembranding en kloonvermogen
Een herkenbare stem is belangrijk voor bedrijven, makers en podcasts. Klonen laat je dezelfde stem meenemen over talen en kanalen heen. Kunnen klonen vanaf ongeveer 20 seconden schone audio en dat profiel hergebruiken binnen Text to Speech en AI Dubbing maakt een kenmerkende klank praktisch om op te zetten en te onderhouden.
Eenvoud van de workflow versus technische integratie
Makers willen vaak dat uploaden, bewerken en downloaden op één plek worden afgehandeld. Technische teams hebben vaak API's nodig. Wij bieden beide: gebruikersgerichte tools in een uniforme app en ontwikkelaars-API's die dezelfde engines ontsluiten. De keuze komt neer op of je team vooral in een browser werkt of voortbouwt op interne systemen.
Snelheid, schaalbaarheid en consistentie
Een voice-overtool zou de productie moeten verkorten en opschalen zonder dat de kwaliteit wegglijdt. Bijna directe TTS-generatie en klonen dat in seconden voltooid wordt, maken snelle iteratie en bulkoutput mogelijk, terwijl API's duizenden scripts of segmenten automatisch laten verwerken met consistente stemmen en instellingen.
Budgetstructuur en controle
In plaats van studiokosten per sessie gebruiken AI-voice-overtools over het algemeen gebruiksgebaseerde prijzen. Ons kredietgebaseerde model geeft je toegang tot AI Dubbing, Text to Speech, Voice Cloning, Speech to Text, Speech Separator, Text to Image en Image to Video onder één account, met een gratis tier en enterprise-abonnementen. Kredieten bieden voorspelbare gebruikslimieten terwijl doorrollen en opschalen beschikbaar blijven wanneer het volume stijgt. Als je kredieten wilt afstemmen op de looptijd, loopt onze uitsplitsing van AI-nasynchronisatiekosten per minuut door de berekening heen.
Compliance, toestemming en gegevensverwerking
Klonen en synthetische spraak dragen ethisch en juridisch gewicht. We vereisen dat je audio uploadt waarvan je de rechten hebt en bevelen schone opnamen aan voor de beste resultaten, wat toestemming en controle centraal houdt. Onze API-documentatie gebruikt veilige, presigned upload-URL's en standaard audioformaten, wat ontwikkelaars een duidelijk patroon geeft voor conform gebruik binnen applicaties.
Risico's om rekening mee te houden
Zelfs met capabele tools zijn er een paar faalmodi die het waard zijn om op te anticiperen.
Onnatuurlijke of robotachtige audio is meestal terug te voeren op slecht geïnterpuncteerde scripts of een stem die niet bij de content past. Kiezen uit een bibliotheek van natuurlijke stemmen en opnieuw genereren tot de weergave klopt, is de praktische oplossing, en snelle generatie maakt dat experimenteren goedkoop.
Verkeerde uitspraak duikt doorgaans op bij namen, technische termen en gelokaliseerde content. Een pipeline die transcriptie, vertaling en review doorloopt — in plaats van een blinde audio-naar-audioconversie — vangt meer van deze fouten op voordat ze de deur uitgaan.
Timingafwijkingen tussen gesynthetiseerde spraak en beelden op het scherm schaden de kijkervaring. Spraak-naar-spraaknasynchronisatie die dicht bij de originele toon en timing blijft, gekoppeld aan bewerking binnen de projectomgeving, geeft je betere controle over de afstemming.
Ethisch gezien nodigt het klonen van een stem zonder de juiste rechten ernstige problemen uit. Een schoon voorbeeld onder je controle vereisen, en klonen framen als een tool voor makers en bedrijven in plaats van anonieme imitatie, is wat de praktijk verantwoord houdt. Wanneer je bestaand beeldmateriaal lokaliseert, toont onze gids over hoe je de stemtaal in een video wijzigt het reviewvriendelijke pad.
Hoe verschillende makers dit in de praktijk brengen
Een YouTube-maker die uitbreidt naar het buitenland kan één Engelse video omzetten naar Spaanse, Portugese en Duitse versies met AI Dubbing en een gekloonde stem, zodat de host herkenbaar blijft in elke markt — allemaal binnen de pipeline van meer dan 60 bron- en 33 doeltalen.
Een klein bedrijf of marketingteam kan een productuitleg of advertentiescript opstellen in een document, het met Text to Speech naar audio omzetten, en een stem kiezen die past bij de merktoon — energiek, formeel of conversationeel. Diezelfde scripts kunnen later worden gelokaliseerd via AI Dubbing met een gekloonde merkstem.
Een e-learning- of bedrijfstrainingsproducent kan narratie voor diapresentaties en SCORM-pakketten automatiseren door lestekst via de TTS API te sturen en de teruggekregen audio aan elke module te koppelen, waarbij klonen de stem van de instructeur consistent houdt, zelfs over regionale versies heen.
Een onafhankelijke filmmaker of podcastmaker kan trailers, promo's of vertaalde dialogen produceren zonder in elke taal een studio te boeken, door Speech to Text, AI Dubbing en gekloonde stemmen te combineren om de karakteridentiteit stabiel te houden.
Ontwikkelaars en bureaus kunnen de TTS-, Voice Cloning- en AI Dubbing-API's inbedden in interne tools of klantplatforms, en alles automatiseren van korte social-voice-overs tot interactieve spraakagenten.
Veelgestelde vragen
Hoe verschillen AI-voice-overs van traditionele opgenomen voice-overs?
Traditionele voice-overs hebben een menselijke stemacteur, studiotijd en meerdere sessies nodig. AI-voice-overs worden gegenereerd door tekst-naar-spraak- en stemkloon-engines die scripts rechtstreeks omzetten in audio met getrainde neurale modellen in plaats van een live uitvoering.
Kan een AI-voice-over klinken als een specifiek persoon?
Ja. Stemklonen analyseert een kort voorbeeld van iemands stem en bouwt een aangepast model dat elk script in die stem kan uitspreken, beschikbaar in onze Voice Cloning-tool en API.
Hoeveel audio is er nodig om een stem te klonen?
We vragen om minstens 20 seconden schone audio, vrij van achtergrondgeluid, om een betrouwbaar gekloond stemprofiel te maken, waarbij klonen doorgaans in seconden klaar is.
Kan ik voice-overs in meerdere talen maken vanuit één bronvideo?
Ja. We combineren spraak-naar-tekst, vertaling en tekst-naar-spraak om content uit meer dan 60 brontalen om te zetten in nagesynchroniseerde output in 33 doeltalen, zodat één originele video veel gelokaliseerde voice-overs kan opleveren.
Is er een manier om voice-overcreatie te automatiseren in plaats van de interface te gebruiken?
Onze TTS API en Voice Cloning API laten apps en interne tools tekst- en audiovoorbeelden versturen, aangepaste stemmen aanmaken en synthetische spraak programmatisch ontvangen, zodat voice-overs automatisch op schaal kunnen worden gegenereerd.