AI-spraakscheiding is een deep-learningproces dat een menselijke stem uit een rommelige mix haalt en een schone spraaktrack teruggeeft, klaar voor transcriptie, nasynchronisatie of stemklonen. Die ene mogelijkheid beantwoordt de vraag die de meeste makers eigenlijk hebben: kan ik deze opname redden zonder hem opnieuw op te nemen? Begrijpen hoe AI-spraakscheiding werkt, helpt je beslissen wanneer je erop kunt vertrouwen, wanneer je beter meteen schoner opneemt, en hoe een schone stemtrack alles verderop stilletjes verbetert. Deze gids loodst je door het mechanisme, het verschil tussen het verbeteren van één spreker en het splitsen van meerdere, waar het proces past in een lokalisatiepijplijn, en wat het nog steeds niet kan oplossen.
Inhoudsopgave
De beslissing achter spraakscheiding
Elke echte opname legt veel meer vast dan alleen de spreker. Vlogs, webinars, trainingsvideo's en podcasts pikken straatlawaai, ruimtegeluid, muziekbedden, toetsenbordklikken en overlappend gebabbel op die de woorden die ertoe doen kunnen begraven. Een spraakscheider bestaat om die mix te ontwarren: het neemt één gemengd bestand en geeft een track terug die grotendeels menselijke spraak bevat, plus een optionele track met de overgebleven achtergrondaudio.
Die schone stemtrack wordt de basis voor alles wat daarna komt: nauwkeurige spraak-naar-tekst, meertalige nasynchronisatie, hoogwaardige stemklonen of gewoon een beter klinkend origineel. Dus de echte beslissing is niet technisch, maar praktisch. Vertrouw je je huidige audio genoeg om er meertalige content op te bouwen, of wil je dat AI de spraak eerst opschoont en scheidt? En wil je een losstaand opschoonhulpmiddel, of een scheider ingebed in een breder creatie- en lokalisatieplatform zodat je niet met meerdere apps hoeft te jongleren?
We hebben onze Spraakscheider ontworpen om te fungeren als de eerste AI-poort in een uniforme workflow. Hij zit vóór spraak-naar-tekst, tekst-naar-spraak, stemklonen en nasynchronisatie, zodat elk downstream-systeem het helderst mogelijke spraaksignaal ziet in plaats van welk lawaai er dan ook in de ruimte was over te nemen.
Het mechanisme: van golfvorm naar schone stem
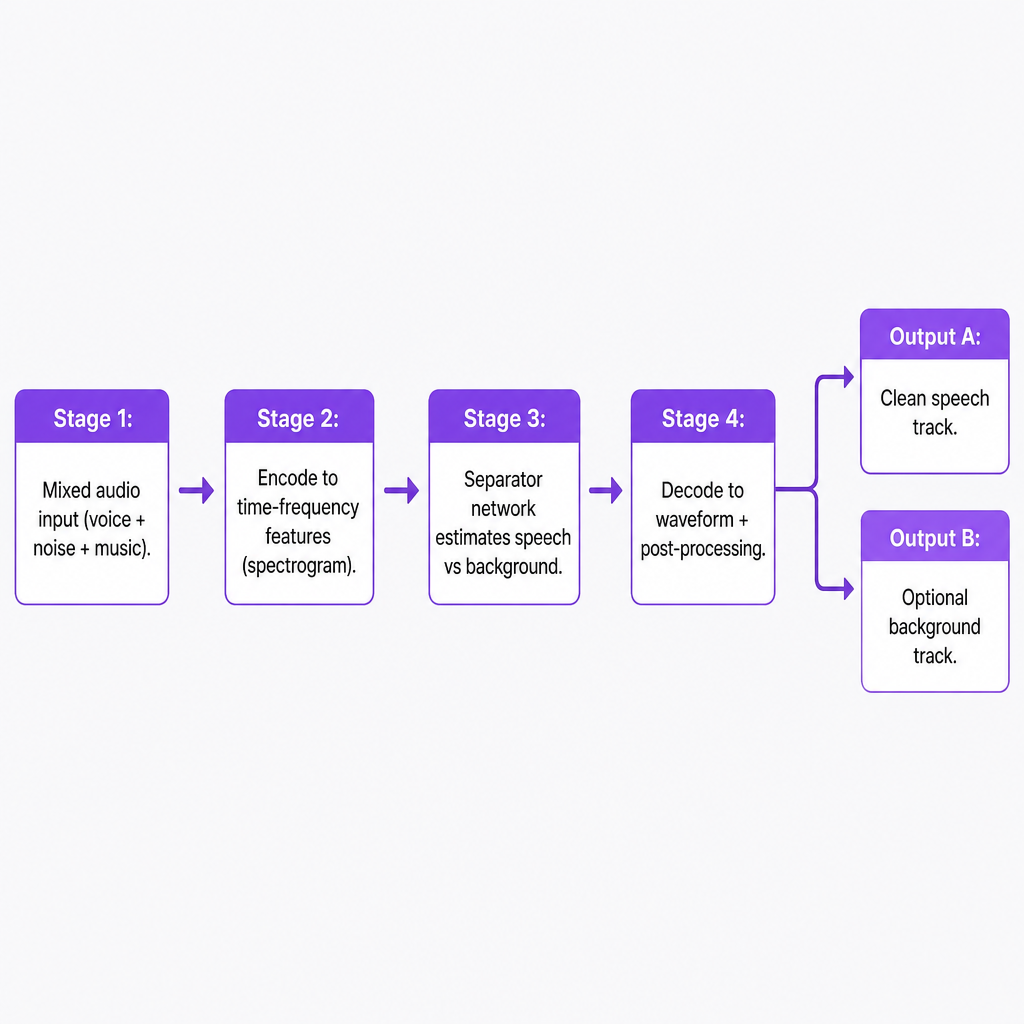
Moderne AI-spraakscheiding volgt een pijplijn van vier fasen: codeer het signaal, scheid bronnen in een aangeleerde kenmerkruimte, schat de schone spraak, en decodeer het terug naar audio.
Van golfvorm naar kenmerken
De meeste systemen zetten eerst de ruwe golfvorm van je microfoon om in een tijd-frequentierepresentatie zoals een spectrogram, dat toont hoe energie in verschillende frequentiebanden in de tijd verandert. Die weergave maakt het voor een neuraal netwerk gemakkelijker om de patronen te zien die overeenkomen met menselijke spraak versus ruis of muziek. Een codeernetwerk zet de invoer vervolgens om in een hoogdimensionale kenmerkruimte waarin verschillende geluidsbronnen beter te onderscheiden worden, waarbij spraakeigenschappen zoals formanten, harmonischen en temporele structuur worden benadrukt terwijl irrelevante achtergrondinhoud wordt onderdrukt.
Scheidernetwerken en maskers
De kern van het proces is het scheidernetwerk, een diep model dat is getraind om op elk tijd-frequentiepunt te beoordelen wat bij de stem hoort en wat niet. Twee strategieën domineren. Maskergebaseerde scheiding voorspelt een masker voor het spectrogram dat spraakenergie behoudt en al het andere dempt; wanneer toegepast op het originele spectrogram vallen achtergrondruis en muziek sterk weg terwijl spraak overblijft. Directe bronschatting voorspelt in plaats daarvan het schone spraakspectrogram zelf, en soms een resterende achtergrond, die vervolgens weer naar audio wordt gedecodeerd.
Er bestaan meer gespecialiseerde benaderingen voor moeilijkere gevallen. Deep clustering leert een embedding voor elke tijd-frequentiebin zodat bins van dezelfde bron samen clusteren, waarna standaardclustering spraak van andere bronnen scheidt. Andere modellen gebruiken permutatie-invariante training zodat ze meerdere sprekers kunnen scheiden zonder aan te nemen welke spreker uitvoer één versus uitvoer twee is.
Trainen met gesuperviseerde voorbeelden
Deze modellen leren van voorbeeldmixen gekoppeld aan grondwaarheid schone spraak, waarbij ze zichzelf aanpassen om het verschil tussen hun uitvoer en de referentie te minimaliseren. Trainingsdoelen kunnen maskers, schone spectrogrammen of gereconstrueerde golfvormen zijn, en de verliesfuncties zijn vaak gekoppeld aan perceptuele kwaliteitsmaten zoals de signaal-tot-vervormingsverhouding. Gevoed met veel uiteenlopende samples over accenten, microfoons en omgevingen internaliseert het netwerk robuuste aanwijzingen die menselijke spraak van achtergrondinhoud scheiden en generaliseert het naar opnames die het nooit heeft gezien.
Terugdecoderen naar audio
Ten slotte zet het systeem de gescheiden spraakrepresentatie terug naar een golfvorm in het tijddomein via een inverse transformatie, gevolgd door nabewerking zoals ruisonderdrukking en luidheidsnormalisatie. Het resultaat is een spraakdominerende track die op zichzelf kan staan of opnieuw kan worden gecombineerd met een gecontroleerde hoeveelheid achtergrond voor natuurlijkheid. Onze Spraakscheider volgt precies dit patroon: hij neemt je geüploade audio of video op, draait de scheidingspijplijn en geeft een spraakgerichte track plus optionele achtergrond terug, zodat jij bepaalt hoe droog of sfeervol de uiteindelijke mix moet zijn.
Enkele-sprekerverbetering versus meerdere-sprekerscheiding
Er ligt een belangrijke grens tussen het verbeteren van één dominante spreker en het echt splitsen van meerdere overlappende stemmen, en die bepaalt wat je realistisch kunt verwachten.
Enkele-sprekerverbetering isoleert één hoofdstem uit achtergrondruis, nagalm en niet-spraakgeluiden zodat de verstaanbaarheid sterk toeneemt. Dit werkt bijzonder goed voor vlogs, webinars, colleges en talking-head-content, waar het probleem omgevingsgeluid of een muziekbed is in plaats van overspraak. Onze Spraakscheider is voor dit geval geoptimaliseerd: hij behandelt menselijke spraak als de primaire bron en al het andere als achtergrond, en levert een opgeschoonde stemtrack en een optionele achtergrondtrack.
Meerdere-sprekerscheiding is een andere taak: een mix van meerdere mensen die tegelijk praten splitsen in afzonderlijke streams, één per stem. Onderzoeksmodellen hebben tot vijf stemmen uit één microfoon gescheiden door verschillende netwerken te trainen voor verschillende aantallen sprekers en voor elke sample de beste passing te kiezen. Technieken zoals deep clustering en multimicrofoon neurale beamforming duwen de prestaties verder in verre-veld- en meerkanaals-omgevingen, maar ze zijn complexer en rekenkundig zwaarder. In de praktijk richten deze systemen zich nog steeds op gespecialiseerde scenario's zoals vergadertranscriptie, callcenters en slimme apparaten in plaats van alledaagse makersworkflows. Voor de meeste van onze gebruikers, die YouTube-kanalen, marketingteams of cursusbibliotheken beheren, komt de grootste praktische winst uit sterke enkele-sprekerverbetering en spraak-versus-achtergrondscheiding, niet uit volledige meerstemmige splitsing.
Waar scheiding past in een lokalisatieworkflow
Scheiding is de brug tussen rommelige opnames uit de echte wereld en hoogwaardig AI-stemwerk. Een typisch pad loopt netjes door meerdere tools.
Een maker uploadt een audio- of videobestand, en de scheider isoleert de spraaktrack en optioneel de achtergrond. Die schone spraak voedt spraak-naar-tekst, zodat transcriptie en vertaling op een helder signaal werken, wat de nauwkeurigheid verbetert en gehallucineerde woorden veroorzaakt door zware muziek of ruis vermindert. De resulterende tekst en vertalingen gaan vervolgens naar tekst-naar-spraak en AI-nasynchronisatie, die nieuwe taalversies genereren met gekloonde of synthetische stemmen; omdat de bronspraak schoon was, is de temporele uitlijning nauwkeuriger en worden mengartefacten zoals pumping verminderd.
Stemklonen hangt af van dezelfde schone invoer. Modellen hebben relatief ruisvrije voorbeelden nodig om het timbre, de prosodie en de articulatie van een spreker betrouwbaar te leren, en scheiding vermindert de achtergrondvervuiling die een gekloonde stem kan vervormen. Onze Spaanstalige gids over scheiding vat de dagelijkse ervaring goed samen: upload een bestand, laat de AI stem van achtergrond splitsen, en download vervolgens de schone stemtrack of de geïsoleerde achtergrond voor verdere bewerking, nasynchronisatie of vertelling, allemaal binnen één workflow. Die consolidatie is waar het om draait voor kleine teams, die anders heen en weer springen tussen aparte ruisonderdrukkingsplug-ins, transcriptietools, nasynchronisatiediensten en kloonplatforms.
AI-spraakscheiding kiezen en gebruiken
Wanneer je beslist hoe je scheiding gaat toepassen, doet een handvol praktische criteria het meeste werk.
Audio-omstandigheden en contenttype. Met één primaire spreker en matige achtergrondruis of muziek is scheiding zeer effectief en laag in risico. Bij zware overlap, verre-veldmicrofoons of invoer van zeer lage kwaliteit moet je afnemende opbrengsten verwachten en de AI koppelen aan betere opname in plaats van erop te vertrouwen dat het alles redt.
Integratie met downstream-tools. Een scheider die direct doorstroomt naar transcriptie, tekst-naar-spraak en nasynchronisatie vermindert wrijving en cumulatieve artefacten vergeleken met exporteren en opnieuw importeren tussen apps. We verbinden de Spraakscheider met de rest van onze lokalisatietools om precies deze reden, wat belangrijker wordt wanneer je doel meertalig publiceren is in plaats van eenmalige ruisonderdrukking.
Controle over achtergrondaudio. Voor merkverhalen wil je vaak wat sfeer of muziek behouden voor emotionele impact. Systemen die zowel een schone spraaktrack als een geïsoleerde achtergrond uitvoeren geven editors meer ruimte dan tools die alleen een enkele ruisvrije mix produceren. Onze scheider ondersteunt dit spraak-plus-optionele-achtergrond-paradigma zodat je bewust kunt remixen.
Snelheid, eenvoud en schaal. Voor makers en kleine teams evenaart bruikbaarheid ruwe prestaties. Scheiding met één klik via een browser of API, met automatische verwerking van gangbare formaten, verslaat complexe plug-inketens die audio-engineeringexpertise veronderstellen. Zodra je honderden video's of cursusmodules beheert, houden batchverwerking en automatisering op luxes te zijn.
Betrouwbaarheid en artefacten. Een sterk model verbetert de verstaanbaarheid zonder duidelijke vervorming, metaalachtig gerinkel of ademhalingsartefacten toe te voegen. Demo's kunnen een systeem gunstiger doen lijken, dus test met je eigen representatieve opnames voordat je een scheider een vast onderdeel van je pijplijn maakt.
Privacy en naleving. Scheiding werkt direct op stemgegevens die gevoelige informatie kunnen bevatten. Enterprise-teams moeten bevestigen hoe audio wordt opgeslagen, of het wordt gebruikt voor modeltraining, en welke controles bestaan voor bewaring en toegang, vooral voor gereguleerde sectoren en interne trainingscontent.
Door deze criteria af te wegen tegen je daadwerkelijke gebruikssituaties, of het nu kanaaluitbreiding, training, marketing, verhalend werk of een API-product is, weet je of een geïntegreerde scheider met downstream-stemtools past bij hoe je werkt.
Risico's, grenzen en wat het niet kan oplossen
Zelfs sterke modellen hebben harde randen die de moeite waard zijn om te kennen voordat je je vastlegt.
- Extreem lawaai of zeer lage signaal-ruisverhouding. Wanneer spraak onder luid lawaai of muziek begraven ligt, kan het model er niet in slagen elk woord te herstellen, wat uitval of gedempte uitvoer oplevert.
- Zware sprekeroverlap. Mensen die precies op hetzelfde moment praten vormen een uitdaging voor zelfs geavanceerde meerdere-sprekersystemen en kunnen ervoor zorgen dat spraak tussen gescheiden streams doorbloedt.
- Overscheidingsartefacten. Agressief maskeren kan muzikale ruis of een robotachtig timbre introduceren, het duidelijkst bij aangehouden klanken en sisklanken.
- Discrepantie tussen training en realiteit. Modellen afgestemd op bepaalde microfoons, talen of omgevingen kunnen onderpresteren op zeer verschillende opnames, wat vervolgens de transcriptie- en nasynchronisatienauwkeurigheid omlaagtrekt.
- Ethiek en rechten. Schoon gescheiden spraak is gemakkelijker te transcriberen, analyseren en remixen, dus teams moeten toestemming en rechten respecteren bij het hergebruiken van stemmen in nieuwe talen of contexten.
De eerlijke conclusie is dat scheiding een krachtige verbetering is, geen vervanging voor redelijke opnamegewoonten. Goede microfoons, verstandige niveaus en bewuste locatiekeuzes lonen nog steeds, en AI vermenigvuldigt die keuzes vervolgens door de content veel flexibeler te maken voor lokalisatie en hergebruik. Als je verkent hoe je dit in een grotere publicatieopzet kunt inpassen, behandelt onze uitleg over wat een spraakscheider is de grondbeginselen dieper.
Veelgestelde vragen
Wat is AI-spraakscheiding in eenvoudige bewoordingen?
Het is een AI-proces dat een gemengde opname neemt en de menselijke spraak isoleert, waardoor je een schone stemtrack krijgt en, optioneel, een aparte achtergrondtrack die je kunt behouden of weggooien.
Hoe verschilt onze Spraakscheider van eenvoudige ruisonderdrukking?
Traditionele ruisonderdrukking dempt voornamelijk constant geluid. Onze scheider gebruikt deep learning om spraakpatronen te herkennen en ze uit een breed scala aan achtergrondgeluiden en muziek te trekken, wat meestal helderdere en natuurlijkere dialoog oplevert.
Kan het omgaan met meerdere sprekers?
Onze Spraakscheider is geoptimaliseerd voor het isoleren van menselijke spraak uit niet-spraakachtergronden, wat het best werkt met een primaire spreker in de mix. Het splitsen van meerdere overlappende stemmen is een actief onderzoeksgebied, en er bestaan gespecialiseerde modellen, maar die richten zich doorgaans op vergaderingen of callcenters in plaats van algemene makersworkflows.
Waarom is spraakscheiding belangrijk voor meertalige nasynchronisatie?
Lokalisatie steunt op nauwkeurige transcriptie en timing. Een schone spraaktrack vermindert herkenningsfouten en helpt vertaalde voice-overs uit te lijnen met de originele video, waardoor hoorbare artefacten worden verminderd wanneer nieuwe stemmen worden gemengd met behouden muziek en effecten.
Hoeveel technische kennis heb ik nodig om het te gebruiken?
Heel weinig. Je uploadt een audio- of videobestand, laat de AI het verwerken en downloadt de gescheiden spraak- en achtergrondtracks voor bewerking, nasynchronisatie of automatisering, zonder dat handmatige parameterafstemming nodig is.