Een nasynchronisatie-AI-stemveranderaar doet veel meer dan simpelweg de ene stem voor de andere inwisselen: het transcribeert de oorspronkelijke dialoog, vertaalt deze, genereert een nieuwe uitvoering in de doeltaal en kan zelfs de identiteit, timing en emotionele stijl van de oorspronkelijke spreker intact houden. Juist door die reeks taken heeft de vraag "welke optie moet ik gebruiken?" geen eenduidig antwoord. De juiste keuze hangt af van wat je wilt behouden.
Als je wilt dat de spreker herkenbaar blijft, past nasynchronisatie met stemklonen. Als je snelle, flexibele vertelstem wilt, is een standaard-AI-stem eenvoudiger te beheren. Als je één herbruikbare merkstem over veel projecten wilt, is een aangepaste stemkloon de asset om op te bouwen. En als de use case een live gesprek is, hoort een realtime stemveranderaar in een andere categorie dan welk nabewerkingsnasynchronisatietool dan ook. Voor de meeste YouTube-makers, e-learningteams, marketeers en onafhankelijke producenten is opgenomen AI-nasynchronisatie het praktische startpunt, omdat het veel meer controle geeft dan een live veranderaar en vanuit één master meerdere gelokaliseerde versies kan opleveren.
Inhoudsopgave
Wat een nasynchronisatie-AI-stemveranderaar daadwerkelijk doet
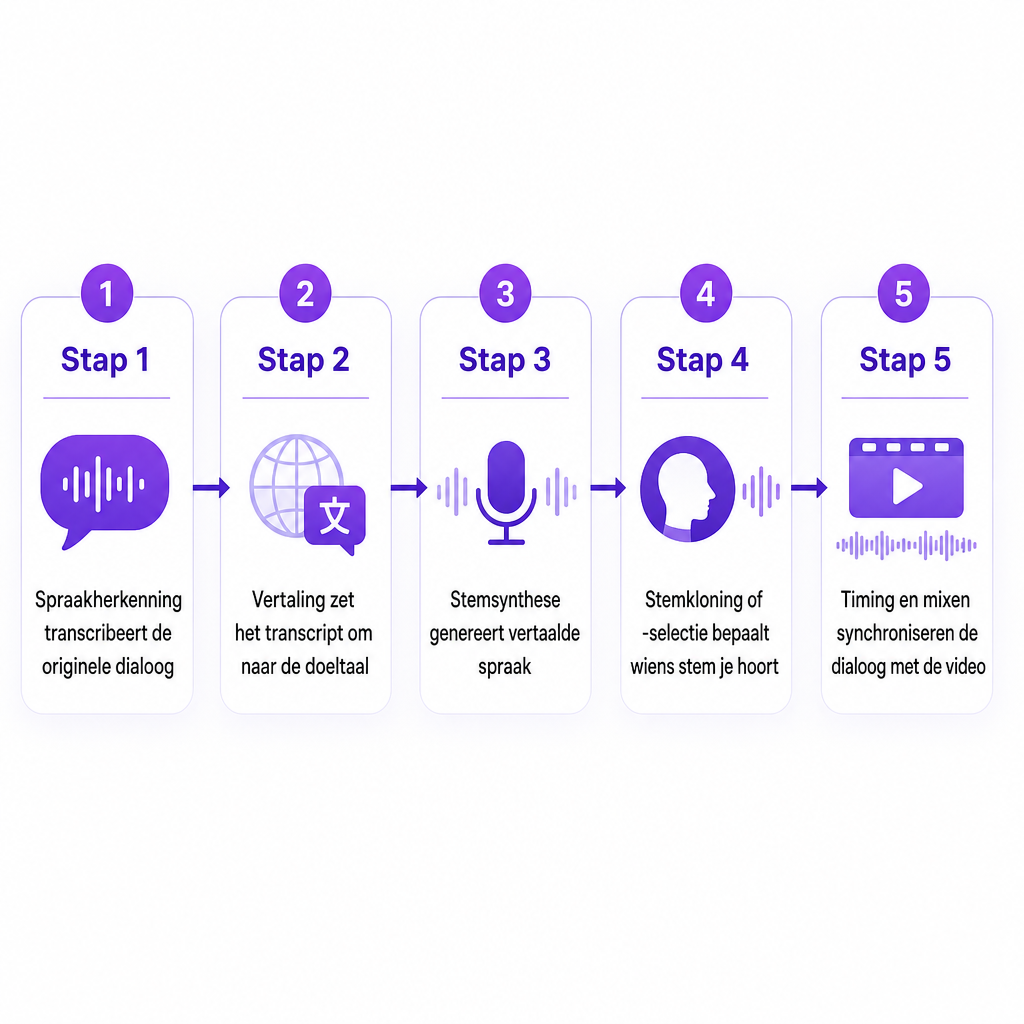
Een nasynchronisatie-AI-stemveranderaar verandert zowel de gesproken taal als de stem van opgenomen audio of video. Dat is een keten van afzonderlijke technologieën die na elkaar werken, geen enkel effect. Spraakherkenning transcribeert de oorspronkelijke dialoog. Vertaling zet die transcriptie om in de doeltaal. Spraaksynthese genereert de vertaalde spraak. Een kloon- of selectiestap bepaalt wiens stem het publiek hoort. Ten slotte zorgen timing en mixing ervoor dat de nieuwe dialoog aansluit op de video, de sprekers en de achtergrondaudio.
Die reeks is wat het onderscheidt van een conventionele stemveranderaar. Een eenvoudige veranderaar past toonhoogte, timbre of karakter aan tijdens een live gesprek en verlaat nooit het audiodomein. Een nasynchronisatiesysteem moet spraak begrijpen, deze vertalen, de juiste spreker aan elke regel toewijzen en een gesynchroniseerde vervangende track bouwen die binnen de oorspronkelijke scène past.
Onze AI-nasynchronisatieworkflow accepteert een geüpload audio- of videobestand, of een YouTube-link, en laat je vervolgens sprekers, tekst en timings bewerken voordat je het resultaat downloadt. Het verwerkt content vanuit meer dan 60 brontalen naar 33 doeltalen, dus de vertaalrichting die je nodig hebt wordt meestal al gedekt voordat er een stembeslissing wordt genomen. Ben je nieuw met het onderliggende concept, dan loopt onze complete beginnersgids voor AI-nasynchronisatie uitgebreider door de pijplijn.
De vier opties, en voor wie elke optie geschikt is
Er zijn vier realistische benaderingen, en ze verschillen vooral op één as: of je de oorspronkelijke spreker behoudt en of vertaling überhaupt deel uitmaakt van de taak.
AI-nasynchronisatie met stemklonen analyseert kenmerken zoals toonhoogte, toon, accent en spreekstijl, en genereert vervolgens vertaalde spraak met een synthetische versie van de oorspronkelijke stem. Het is de beste match wanneer een herkenbaar persoon de content draagt: YouTube-kanalen die rond een presentator zijn opgebouwd, docenten van cursussen, merkwoordvoerders, consistente podcasthosts, films met terugkerende personages en productdemo's waarbij continuïteit van de spreker belangrijk is. De kracht ligt in het behoud van identiteit over talen heen en een consistente stem voor een meertalige bibliotheek, wat de noodzaak vermindert om stemacteurs in te huren en te coördineren. De beperkingen zijn echter ook reëel. Een slechte bronopname levert een slechte kloon op, en accenten, emotie, overlappende dialoog, muziek en achtergrondgeluid verslechteren allemaal de kwaliteit. De toestemming en commerciële rechten van de spreker moeten eerst worden geregeld, en een gekloonde stem kan minder natuurlijk klinken wanneer de vertaalde regel heel andere timing of emotionele intentie draagt.
AI-nasynchronisatie met standaardstem wijst een geselecteerde synthetische stem toe aan elke spreker of vertellertrack in plaats van de bron te klonen. Het past bij gevallen waarin de oorspronkelijke spreker niet herkenbaar hoeft te blijven: een merk dat één consistente verteller over veel video's wil, bronaudio die te luidruchtig is om schoon te klonen, uitleg- en onboardingcontent, of vroege tests van verschillende stemstijlen voordat je een keuze maakt. Het is ook de veiligere weg wanneer je simpelweg geen toestemming hebt om de stem van een persoon na te bootsen. De afweging is dat de gelokaliseerde versie minder verbonden kan aanvoelen met de oorspronkelijke content.
Aangepast stemklonen wordt één keer gemaakt en hergebruikt in tekst-naar-spraak-vertelling, nasynchronisatie, trainingsmateriaal en andere goedgekeurde content. In tegenstelling tot het apart klonen van een stem voor elke video bouwt dit een herbruikbare stem-asset. Het past bij een marketingteam dat dezelfde merkstem wil in productvideo's, helpcentrumcontent, e-learningmodules, sociale aanpassingen, meertalige aankondigingen en audioversies van geschreven content. Een aangepaste kloon vereist duidelijke eigendomsregels: wie deze mag gebruiken, welke talen en kanalen zijn toegestaan, of externe bureaus toegang krijgen, en wat er gebeurt als de spreker toestemming intrekt.
Realtime AI-stemverandering wijzigt spraak terwijl deze wordt geproduceerd of verzonden, met prioriteit voor lage latentie zodat het publiek de veranderde stem live hoort. Het is het juiste gereedschap voor live gesprekken, streams, gaming, virtuele evenementen en interactieve demo's, maar zelden het juiste gereedschap voor gepolijste meertalige lokalisatie. Realtimesystemen hebben weinig ruimte om vertalingen te herzien, timing te corrigeren, fouten te verwijderen of afzonderlijke segmenten te verfijnen, en ze kunnen latentie of artefacten introduceren. Onze uitleg over de realtime AI-stemveranderaar behandelt waar die latentieafweging een harde grens wordt.
| Optie | Het beste voor | Behoudt oorspronkelijke identiteit? | Vertaling inbegrepen? | Belangrijkste risico |
|---|---|---|---|---|
| Nasynchronisatie met stemklonen | Meertalige content met presentator | Ja | Ja | Ongeautoriseerde of onnatuurlijke replicatie |
| Nasynchronisatie met standaardstem | Uitlegvideo's, training, merkvertelling | Nee | Ja | Stem kan losstaan van de bron aanvoelen |
| Aangepaste stemkloon | Herbruikbare merk- of makersstem | Ja | Meestal, afhankelijk van workflow | Toestemming, licenties, toegangsbeheer |
| Realtime stemveranderaar | Live streams, gesprekken, gaming | Soms | Niet noodzakelijk | Latentie, artefacten, beperkte correctie |
| Menselijke nasynchronisatie met AI-ondersteuning | Film en reclame met hoge inzet | Kan geregeld worden | Ja | Hogere kosten, langere doorlooptijden |
Hoe te kiezen zonder te veel nadruk te leggen op stemrealisme
De meest voorkomende fout is het kiezen van een tool omdat een korte stempreview indrukwekkend klinkt. Een realistisch voorbeeld betekent weinig als de voltooide dialoog niet in de scène past. Werk de beslissing in volgorde af.
Begin met de identiteitsvereiste. Vraag je af of kijkers de herkenbare stem van de oorspronkelijke spreker moeten horen. Zo ja, gebruik nasynchronisatie met stemklonen of een vooraf goedgekeurde aangepaste stem. Zo nee, dan is een standaardstem sneller, eenvoudiger en makkelijker te beheren. Een taaldocent die een YouTube-kanaal uitbreidt heeft baat bij een kloon van de stem van de docent; een softwarebedrijf dat een generieke producttutorial vertaalt, geeft meestal de voorkeur aan een professionele standaardverteller.
Stem de tool af op het contentformaat. Kortere content, podcasts, tutorials en productvideo's werken vaak goed met geautomatiseerde nasynchronisatie. Een grondiger controle is gerechtvaardigd wanneer een project meerdere sprekers, frequente onderbrekingen, grappen of idiomen, sterke regionale accenten, muziek over dialoog, emotioneel acteerwerk, snelle dialoog of juridische, medische en financiële terminologie bevat.
Evalueer taaldekking per richting in plaats van per totaalaantal. Een tool kan Engels, Spaans en Frans als doeltalen vermelden terwijl deze verschillende stemkwaliteit of dialectdekking biedt in elke richting. Bevestig of het platform je brontaal automatisch detecteert, het regionale accent dat je nodig hebt ondersteunt, namen en terminologie behoudt, meertalige spraak verwerkt, ondertitels of alleen audio produceert, en meerdere doeltalen in één project toestaat. Onze consumentgerichte AI-nasynchronisatie ondersteunt meer dan 60 brontalen en 33 doeltalen, terwijl onze API-documentatie afzonderlijk meer dan 33 doeltalen en verwerking vanuit meer dan 99 brontalen beschrijft, dus controleer het toepasselijke product of plan voordat je aan een grote klus begint.
Controleer timing en synchronisatie. Een vertaalde zin is zelden even lang als het origineel, dus een kwaliteitssysteem zou je moeten laten begin- en eindtijden van segmenten, spreeksnelheid, pauzes, spreker-toewijzing, achtergrondvolume en individuele opnieuw gegenereerde regels aanpassen. Voor content met focus op de lippen controleer je mondbewegingen en scènetiming handmatig; een natuurlijke stem kan er toch niet-kloppend uitzien als de vertaling te lang duurt of de gegenereerde pauzes afwijken van het beeld.
Houd rekening met productievolume. Een enkele incidentele video is prima in een online studio. Een kanaal, bureau of softwareproduct dat continu lokaliseert, moet zoeken naar batch- of meertalige ondersteuning, herbruikbare aangepaste stemmen, projectbewerking, API-toegang, downloadbare segmenten, gebruiksmonitoring, voorwaarden voor commercieel gebruik en betrouwbare ondersteuning. Als je specifiek voor vertelling tussen een standaardstem en klonen kiest, brengt onze vergelijking van TTS versus stemklonen voor vertelling die keuze in detail in kaart.
Kwaliteits- en rechtenrisico's om te controleren voordat je publiceert
Geautomatiseerde nasynchronisatie is een productieversneller, geen vervanging voor redactioneel oordeel. Een handvol risico's verdient een directe controle bij elk project.
Vertaling kan woord voor woord accuraat zijn en toch context, humor, culturele verwijzingen of de bedoelde formaliteit missen. Controleer namen, maateenheden, oproepen tot actie, producttermen en veiligheidsinstructies met een moedertaalspreker. Stem en emotie kunnen ook uiteenlopen: een gekloonde stem kan vocale kenmerken behouden zonder de exacte acteerprestatie te reproduceren, dus controleer of nadruk, urgentie, warmte en pauzes nog steeds bij de scène passen.
Achtergrondomstandigheden zijn belangrijk voor de nauwkeurigheid. Klonen en transcriberen zijn het betrouwbaarst met één duidelijke spreker, terwijl muziek, galm in de ruimte, geluidseffecten en overlappende dialoog de kwaliteit van transcriptie en spreker-toewijzing verminderen. Wat de rechten betreft: kloon nooit een stem alleen maar omdat je toegang hebt tot een opname. Verkrijg toestemming van de spreker en documenteer het beoogde gebruik, de talen, kanalen, duur en commerciële rechten, wat vooral belangrijk is voor acteurs, werknemers, publieke figuren, klanten en overleden personen.
Een realistisch stemvoorbeeld is het eenvoudigst te beoordelen en de minst betrouwbare voorspeller van een bruikbaar resultaat.
Vertrouwen van het publiek is de laatste laag. Sommige platforms en publieken verwachten openheid wanneer realistische synthetische media worden gebruikt, en zelfs waar het niet strikt vereist is, vermindert transparantie verwarring en beschermt het de geloofwaardigheid. Laat voor de publicatie een beoordelaar naar de voltooide track luisteren, deze vergelijken met de bron, de vertaling bevestigen en de synchronisatie controleren.
Waar DubSmart in deze workflow past
Wij combineren AI-nasynchronisatie, stemklonen en tekst-naar-spraak in één platform in plaats van bij elke stap een apart gereedschap af te dwingen. Ons AI-nasynchronisatieproduct ondersteunt geautomatiseerde lokalisatie, gekloonde sprekers, bewerkbare segmenten, timingwijzigingen en regel-voor-regel-regeneratie, zodat je één onjuiste zin kunt corrigeren in plaats van een heel project opnieuw op te bouwen.
Onze stemkloon-workflow accepteert een audiovoorbeeld van minimaal 20 seconden, en de resulterende stem wordt beschikbaar voor zowel tekst-naar-spraak als AI-nasynchronisatie, wat ervoor zorgt dat één goedgekeurde merkstem herbruikbaar is over veel talen en formaten. Een schone opname zonder achtergrondgeluid levert de beste kloon op, en wij behandelen toestemming en verantwoord gebruik als een vereiste in plaats van een bijzaak.
Voor teams die lokalisatie inbouwen in software of een intern productiesysteem bieden we ook een AI-nasynchronisatie-API met meertalige projecten, aangepaste stemmen, sprekerbediening en bewerking op segmentniveau, naast bestandsupload, projectaanmaak, selectie van doeltaal, regeneratie en downloaden van resultaten. De sterkste match wordt nooit bepaald door het meest dramatische stemeffect. Het komt neer op de vraag of een workflow de taalrichting, identiteit, synchronisatie, redactionele controle, rechtenbeheer en productieschaal kan leveren die je content daadwerkelijk nodig heeft. Als je je brontaal, doeltalen en of je de oorspronkelijke stem wilt behouden kent, wordt dat antwoord meestal snel vanzelfsprekend.
Veelgestelde vragen
Is een nasynchronisatie-AI-stemveranderaar hetzelfde als een gewone AI-stemveranderaar?
Nee. Een gewone AI-stemveranderaar wijzigt een stem meestal in realtime of verandert vocale kenmerken. Een nasynchronisatie-AI-stemveranderaar vertaalt opgenomen spraak en bouwt een vervangende uitvoering die moet passen bij de oorspronkelijke content, sprekers en timing.
Wat is de beste optie voor YouTube-makers?
AI-nasynchronisatie met stemklonen is meestal het sterkst wanneer de identiteit van de maker centraal staat in het kanaal. Een standaardstem is vaak beter voor anonieme vertelling, uitlegvideo's of content waarbij snelheid en consistentie belangrijker zijn dan de identiteit van de spreker.
Kan DubSmart een stem klonen vanuit een korte opname?
Ja. Stemklonen vereist minimaal 20 seconden audio, en een schone opname zonder achtergrondgeluid levert het beste resultaat op. De gekloonde stem kan vervolgens worden gebruikt in tekst-naar-spraak en AI-nasynchronisatie.
Moet ik realtime stemverandering gebruiken voor videolokalisatie?
Meestal niet. Realtime verandering past bij live gesprekken, streams en interactieve ervaringen. Voor meertalige video's geeft opgenomen AI-nasynchronisatie veel meer ruimte om het eindresultaat te vertalen, bewerken, synchroniseren en beoordelen.
Heb ik toestemming nodig om iemands stem te klonen?
Ja. Verkrijg de juiste toestemming en bevestig de commerciële rechten voordat je de stem van een herkenbaar persoon kloont of verspreidt, en zorg ervoor dat de toestemming de beoogde talen, content, kanalen en gebruiksduur dekt.