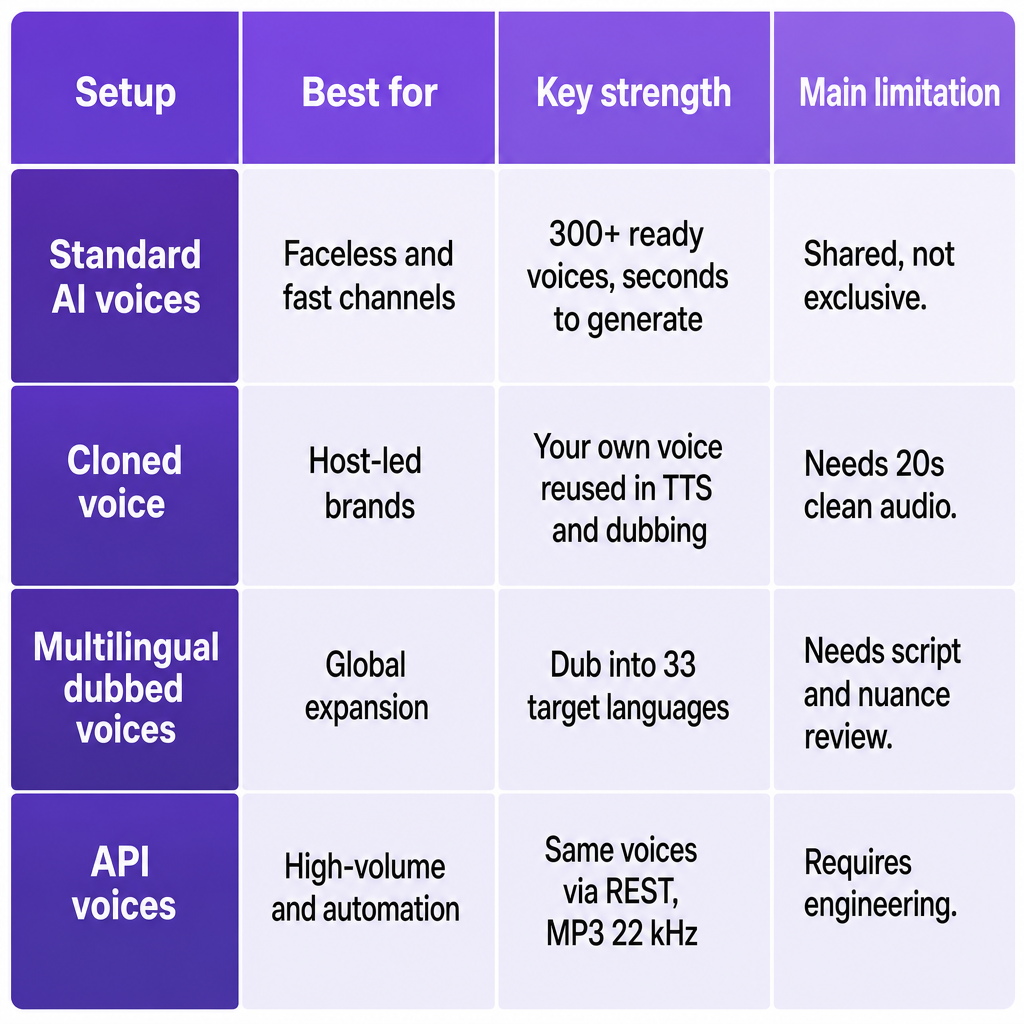
Het kiezen van de beste tekst-naar-spraakstemmen voor YouTube draait minder om het najagen van één "perfecte" stem en meer om het afstemmen van de juiste steminstelling op de niche van je kanaal, je taalplannen en hoe je daadwerkelijk video's produceert. Bij DubSmart AI komt die keuze neer op vier praktische opties binnen één werkomgeving: onze bibliotheek met 300+ kant-en-klare AI-stemmen, een stem die je kloont vanuit je eigen audio, dezelfde stemmen toegepast op meertalige nasynchronisatie, en API-gestuurde stemmen voor geautomatiseerde pijplijnen. Elk lost een ander probleem op, en de beste keuze combineert meestal een paar ervan naarmate je kanaal groeit.
Deze gids bespreekt wat elke steminstelling goed doet, waar deze past en waar deze tekortschiet, zodat je met vertrouwen kunt beslissen in plaats van te gokken op basis van een generieke ranglijst.
Inhoudsopgave
Hoe wij de beste tekst-naar-spraakstemmen voor YouTube kiezen
Wij selecteren stemmen en steminstellingen die standhouden op een echt YouTube-kanaal, niet voor abstracte marktranglijsten. Vijf criteria bepalen elke keuze hieronder.
Natuurlijkheid telt het eerst, omdat de meeste kijktijd op telefoons plaatsvindt bij wisselend volume. Een stem moet menselijk klinken en helder blijven door gecomprimeerde audio en achtergrondgeluid onderweg. Taal- en accentdekking komt daarna: een stem is alleen nuttig voor groei als je deze kunt meenemen naar nieuwe regio's zonder je bestaande catalogus opnieuw op te nemen. Merkconsistentie is het derde filter, aangezien dezelfde stem herbruikbaar moet zijn in zowel onze Text to Speech-studio als nasynchronisatie, inclusief een gekloonde stem die als jou klinkt. Workflow-geschiktheid bepaalt of een stem praktisch te genereren, bewerken en exporteren is binnen een echt productieschema. Tot slot bepaalt automatiseringspotentieel of ontwikkelaars en bureaus dezelfde stemmen via API's kunnen aanroepen voor sjabloonmatige of grootschalige output.
Elk item hieronder krijgt één sectie met zijn onderscheid, zijn beste geschiktheid op YouTube en zijn eerlijke beperkingen, gebaseerd op hoe deze tools daadwerkelijk werken binnen ons platform.
Standaard AI-stembibliotheek: snelle, publicatieklare voice-over
De snelste weg naar een afgewerkte voice-over is onze Text to Speech-engine: plak een script in jouw taal, kies uit meer dan 300 AI-stemmen, bekijk een voorbeeld en genereer realistische spraak in enkele seconden. Je kunt een spreker selecteren, basisinstellingen aanpassen en standaardaudio exporteren die je rechtstreeks in een YouTube-montage plakt. Dezelfde catalogus is beschikbaar via onze TTS-API, zodat elke kant-en-klare stem zowel in de webstudio als in programmatische workflows bestaat.
Deze instelling past bij faceless- en commentaarkanalen die snelheid en consistentie waarderen boven één herkenbare persoonlijkheid. Het is geschikt voor nieuwsanalyses, lijstjes, uitlegvideo's en diavoorstellingen die nette voice-over nodig hebben binnen een strak schema, plus e-learning-, bedrijfs- en marketingkanalen die een neutrale professionele toon verkiezen. Een maker kan een script plakken, een stem kiezen, genereren en downloaden voor een editor zoals Premiere of Final Cut zonder opnameapparatuur aan te raken. Voor technische teams retourneert onze Text to Speech API MP3-bestanden op 22 kHz na een eenvoudig verzoek met tekst en stemvoorkeuren, wat naadloos past in sjabloon- of datagestuurde videopijplijnen. Als je de diepere mechaniek wilt, behandelt onze uitleg over hoe neurale tekst-naar-spraak werkt wat er achter elke render gebeurt.
De afweging is exclusiviteit. Standaardstemmen worden gedeeld tussen gebruikers, dus een sterk gebrand, persoonlijkheidsgedreven kanaal wil uiteindelijk misschien iets onderscheidender. Je kunt taal, spreker en sommige parameters afstemmen, maar je krijgt niet de subtiele eigenaardigheden van je eigen stem zonder klonen. En omdat de catalogus breed is, kost het vinden van de stem die echt bij je publiek past nog steeds een paar luistertests in plaats van één gelukkige keuze.
Gekloonde makerstem: een herkenbare presentator op schaal
Wanneer je geluid deel uitmaakt van je merk, verandert klonen de rekensom. Onze stemkloning bouwt een aangepaste AI-stem vanuit een korte sample en maakt die stem vervolgens selecteerbaar overal waar standaardstemmen verschijnen, in zowel Text to Speech als nasynchronisatie. Je uploadt ten minste 20 seconden schone audio zonder achtergrondgeluid, en het systeem produceert een herbruikbare kloon. We ondersteunen het klonen van een willekeurig aantal stemmen, dus een merk is niet gebonden aan één presentator: je kunt naar behoefte meerdere woordvoerders of karakterstemmen klonen.
Een gekloonde stem is de sterkste keuze voor persoonlijkheidsgedreven kanalen waar kijkers zich abonneren vanwege een specifieke persoon. Het past ook bij makers die hun eigen stem willen behouden terwijl ze delen van de productie automatiseren, zoals B-roll-voice-over, alternatieve taalsporen of gescripte shorts. En het is de ruggengraat van meertalige kanalen die één consistente sprekersidentiteit over talen heen willen wanneer het gekoppeld is aan nasynchronisatie. Eenmaal gekloond wordt je stem een normale optie in de studio, klaar voor gescripte voice-over of voor het opnieuw inspreken van volledige video's in andere talen met behoud van je identiteit.
Kwaliteit hangt af van je bronaudio. Een rumoerige of galmende sample levert een zwakkere kloon op en kan artefacten introduceren, dus veel makers nemen een toegewijde schone sample op in plaats van livestream- of vlogaudio te hergebruiken. Over talen heen volgen accent en prosodie het synthesemodel, dus de uitspraak komt mogelijk niet perfect overeen met een moedertaalspreker in elke doeltaal. Klonen voegt ook een installatiestap toe vóór het eerste gebruik, wat het het beste maakt voor kanalen die zich inzetten voor consistentie op lange termijn in plaats van een eenmalige test.
Meertalige nagesynchroniseerde stemmen: van één kanaal naar vele
De meest directe route naar een wereldwijd kanaal is nasynchronisatie. Met onze AI Dubbing upload je een video, vertaal je deze en spreek je hem opnieuw in naar een van de 33 doeltalen, en pas je optioneel een gekloonde stem toe op die nagesynchroniseerde sporen. Het belangrijkste detail is dat nasynchronisatie put uit dezelfde stemcatalogus en gekloonde stemmen die voor Text to Speech worden gebruikt, dus je "beste" nasynchronisatiestemmen zijn simpelweg je gekozen stemmen geconfigureerd voor vertaalde scripts. Omdat de werkomgeving ook Speech to Text, een Speech Separator en beeld- en videotools bundelt, vermijd je het aan elkaar knopen van afzonderlijke leveranciers voor transcriptie, vertaling, voice-over en beelden.
Dit past bij kanalen die al succesvol zijn in één taal en klaar zijn om uit te breiden zonder opnieuw te filmen. Tutorials, productreviews, documentaires en langere content met hoge herhalingswaarde rechtvaardigen de inspanning, net als bedrijven, e-learning-aanbieders en marketingteams die consistente gebrande voice-over over regio's heen nodig hebben. Je kunt starten vanuit bestaande video's, vertaalde scripts genereren en ofwel een standaardstem ofwel je gekloonde stem toepassen op de nagesynchroniseerde audio, waarmee je lokale versies van je kanaal creëert die dezelfde persoonlijkheid behouden. Door Text to Speech en nasynchronisatie in één werkomgeving te houden, is het eenvoudig om de voice-overstijl tussen originele en vertaalde versies op elkaar af te stemmen. Als je localisatieformaten afweegt, helpt onze analyse van nasynchronisatie versus ondertiteling de beslissing kaderen.
Nasynchronisatie voegt werk toe dat eentalige voice-over niet heeft. Zelfs met sterke vertaling en synthese moet je nog steeds scripts controleren op culturele nuance, voorbeelden aanpassen en bevestigen dat de stemstijl bij de doelgroep past. Het verbruikt ook meer credits en exportbeheer dan een eenmalige clip. Gekloonde stemmen behouden de identiteit, maar lipsynchronisatie en timing komen mogelijk niet perfect overeen met de originele beelden bij snelpratende of sterk geanimeerde content, dus verwacht wat handmatige bewerkingen in je videobewerker.
API-gestuurde stemmen: geautomatiseerde productie op grote schaal
Voor teams die op grote schaal produceren, zijn dezelfde stemmen programmatisch beschikbaar via drie endpoints. Onze Text to Speech API zet tekst om in natuurlijke spraak met gebruik van de volledige set van 300+ stemmen en retourneert downloadbare MP3-bestanden op 22 kHz wanneer de verwerking is voltooid. Onze Voice Cloning API laat je samples uploaden en aangepaste stemmen maken die bruikbaar zijn in TTS of nasynchronisatie. Onze AI Dubbing API laat ontwikkelaars en bureaus video's programmatisch vertalen en nasynchroniseren, waarbij deze mogelijkheden rechtstreeks in contentpijplijnen of een CMS worden ingebed.
Deze instelling past bij kanalen die veel vergelijkbare video's genereren, zoals terugkerende nieuwsoverzichten, datagestuurde samenvattingen of sjabloonmatige uitlegvideo's waar scripts worden gegenereerd of gevuld vanuit gestructureerde data. Het is geschikt voor bureaus die meerdere klantkanalen beheren en een herhaalbare, geautomatiseerde stemworkflow nodig hebben, en voor softwareproducten die autopublicatiefuncties bieden en op grote schaal kwalitatieve voice-overs nodig hebben. Omdat gekloonde stemmen naast standaardstemmen via ID kunnen worden gerefereerd, kost automatisering je geen merkconsistentie: elke render gebruikt dezelfde bedoelde stem over video's en kanalen heen.
De kostenpost is engineering. API-workflows vereisen vertrouwdheid met RESTful-services plus infrastructuur om audio op te slaan, na te bewerken en aan videobestanden te koppelen. Kleinere makers die volledig in de webeditor werken, profiteren meestal niet totdat ze een betekenisvolle schaal bereiken. Geautomatiseerde pijplijnen hebben ook waarborgen nodig rond scriptkwaliteit, timing en compliance, omdat zwakke input nog steeds zwakke output oplevert, hoe goed de stem ook is.
Hoe je de juiste steminstelling voor je kanaal kiest
Vier vragen beslechten de meeste beslissingen. Beantwoord ze op volgorde en je stemopstelling valt op zijn plaats.
Publiek en format. Als je kanaal faceless, nieuwsgericht of lijstjesgedreven is, begin dan met standaard AI-stemmen voor snelle doorlooptijden en eenvoudig toontesten. Als kijkers zich specifiek vanwege jou abonneren, investeer dan in het klonen van je stem en gebruik deze in zowel Text to Speech als nasynchronisatie.
Taalstrategie. Als je in één taal publiceert, zoek dan een of twee stemmen die bij je toon passen en commit je daaraan voor consistentie. Als je van plan bent wereldwijd te gaan, ontwerp dan rond nasynchronisatie: kies een primaire gekloonde stem en koppel deze aan nagesynchroniseerde sporen in maximaal 33 doeltalen.
Productievolume. Voor wekelijkse uploads of incidentele series zijn de webgebaseerde Text to Speech- en AI Dubbing-tools voldoende. Voor content op grote schaal of datagestuurde content, plan een API-first-workflow waarbij nieuwe scripts en bestanden automatisch stemgeneratie activeren.
Merkcontrole en risico. Gebruik standaardstemmen voor risicoarme pilots en kanalen waar stemidentiteit niet centraal staat. Gebruik gekloonde stemmen met duidelijke interne regels over wie ze kan activeren en waar ze mogen verschijnen, wat het belangrijkst is voor bedrijfs- of gebrande kanalen.
Het afstemmen van je stemmen op de verwachtingen van je publiek, taalplannen en workflow is hoe je de veelvoorkomende missers vermijdt: inconsistente voice-over, onverwachte stemwisselingen tussen video's en overbewerkte pijplijnen die moeilijk te onderhouden zijn. Een praktisch pad is om eerst een paar standaardstemmen te testen, een gekloonde stem toe te voegen zodra je identiteit ertoe doet, en API's en meertalige nasynchronisatie te introduceren wanneer je operatie handmatig renderen ontgroeit.
Veelgestelde vragen
Kan ik de AI-stemmen van DubSmart gebruiken op mijn YouTube-video's?
Onze Text to Speech- en AI Dubbing-tools zijn gebouwd voor makers en bedrijven om voice-overs te produceren voor openbare content, inclusief YouTube, onder een creditgebaseerd gebruiksmodel. Jij blijft verantwoordelijk voor het naleven van de voorwaarden van YouTube, advertentiebeleid en lokale regelgeving, maar ons platform is ontworpen voor commercieel mediagebruik.
Hoeveel audio heb ik nodig om mijn stem te klonen?
Je hebt ten minste 20 seconden schone spraak zonder achtergrondgeluid nodig om een bruikbare gekloonde stem te maken. Hoe schoner de opname, hoe nauwkeuriger en natuurlijker het resultaat, dus een toegewijde stille sample is beter dan rumoerige hergebruikte audio.
Werkt mijn gekloonde stem in meerdere talen?
Ja. Een gekloonde stem is bruikbaar in zowel Text to Speech als AI Dubbing, die veel talen en 33 doeltalen voor nasynchronisatie ondersteunen. Je behoudt dezelfde stemidentiteit over scripts in verschillende talen, hoewel uitspraak en accent in elk geval het synthesemodel volgen in plaats van natuurlijke menselijke spraak.
Kan ik later overstappen van standaardstemmen naar een gekloonde stem?
Ja. Wij behandelen gekloonde stemmen als herbruikbare stemmen in dezelfde catalogus als standaard AI-stemmen, dus je kunt beginnen met standaardstemmen en projecten later overzetten naar een gekloonde stem met dezelfde Text to Speech- en AI Dubbing-interfaces of API's, zonder je workflow opnieuw op te bouwen.
Hoe helpen de API's bij YouTube-productie?
Met onze Text to Speech-, Voice Cloning- en AI Dubbing-API's kun je scripts omzetten in spraak, stemmen klonen en video's nasynchroniseren via RESTful-endpoints. Dat maakt het praktisch om terugkerende formats te automatiseren, voice-overs in een bestaand CMS of montagepijplijn in te pluggen en op te schalen over veel kanalen of talen heen zonder elke render handmatig te activeren.