音声から音声への翻訳(スピーチ・トゥ・スピーチ翻訳)は、ある言語で話された言葉を別の言語の聞き取れる音声に変換するもので、聴き手は翻訳を読むのではなく耳で聞くことができます。英語でレッスンを録画した講師が、何も録り直さずにスペイン語版を必要とする場面を想像してみてください。システムは英語を書き起こし、その意味を翻訳し、代わりにスペイン語の音声を生成します。この「読む」から「聞く」への転換こそが本質であり、それによって多言語コンテンツの企画・レビュー・公開の方法が変わります。
本当の問いは、この技術が機能するかどうかであることはめったにありません。問題は、どのバージョンが必要かということです。動画、コース、ポッドキャスト向けの録音翻訳、会議やイベント向けのほぼリアルタイム翻訳、元の話者のアイデンティティを保つ音声保持型の出力、あるいは自分のアプリケーションに組み込めるAPIなど。これらの選択肢はそれぞれ品質、遅延、レビューの労力において異なるトレードオフを抱えており、本ガイドはそれらを整理して、あなたが納得して選べるようにします。
目次
音声から音声への翻訳の仕組み
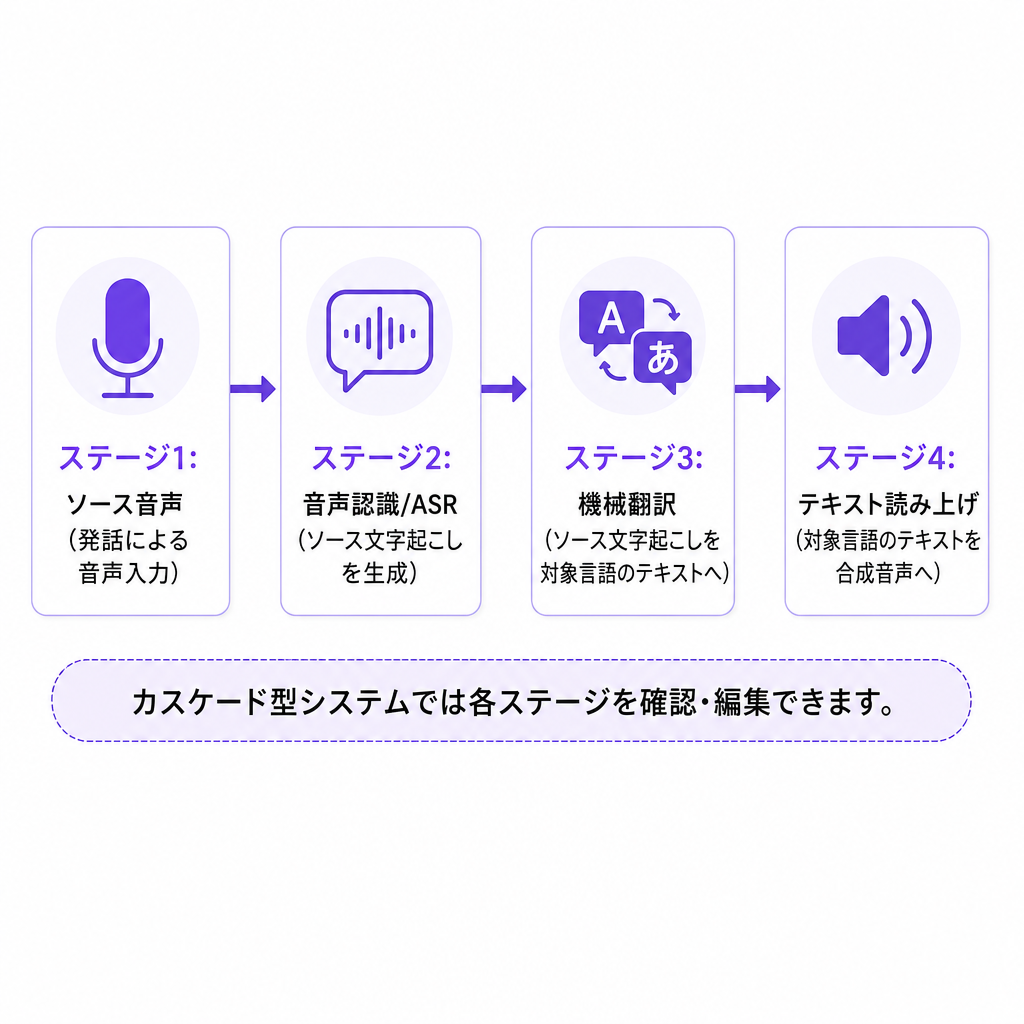
ほとんどのシステムは、3つの技術をつなげたパイプラインで動作します。まず、自動音声認識(ASR)が元の音声を分析し、書き起こしを生成します。次に、機械翻訳がその元言語のテキストを対象言語に変換します。最後に、テキスト音声合成が翻訳されたテキストを話し言葉の音声に変えます。この流れは、元の音声、認識、翻訳テキスト、合成音声という具合に明快に読み取れます。
元の音声 → 音声認識 → 翻訳テキスト → 合成音声
この階層的な設計はカスケード型の音声から音声への翻訳と呼ばれ、音声翻訳評価に関するNISTの刊行物でも同じ構造が説明されています。ASRが元の書き起こしを作り、機械翻訳が対象言語のテキストを生成し、テキスト音声合成が話された出力を生成します。カスケードの利点は、各段階を検査できることにあり、音声が生成される前に書き起こしや翻訳を修正できます。
より新しいアプローチでは、個別の書き起こしと合成の段階を表に出さずに、元の音声を対象言語の音声に直接マッピングするエンドツーエンドモデルを訓練します。直接音声翻訳に関するDTIC技術報告書で共有されている研究では、これを遅延を減らし、元の話者の声をより多く保持する方法として位置づけつつ、依然として速度、文脈、言語カバー範囲、出力品質のトレードオフがあることにも触れています。実際には、カスケードはより多くの編集上の制御を与えてくれ、エンドツーエンドのアプローチは低遅延と声の連続性を追求します。
音声から音声への翻訳と関連タスクの違い
人々はしばしば音声から音声への翻訳を、書き起こし、テキスト翻訳、吹き替えと混同しますが、それぞれ最終的な成果物が異なります。テキスト翻訳は書かれた出力で終わります。音声から音声への翻訳は、カスケード型システムが内部で中間表現としてテキストを使っていても、話された出力で終わります。入力と出力を整理しておくことで、仕事に合わないツールを選んでしまうのを防げます。
| 技術 | 入力 | 出力 | 典型的な用途 |
|---|---|---|---|
| 音声からテキスト | 話された音声 | 書かれた書き起こし | 字幕、メモ、検索可能なコンテンツ |
| テキスト翻訳 | 書かれたテキスト | 翻訳されたテキスト | 文書、字幕、ウェブページ |
| テキスト音声合成 | 書かれたテキスト | 合成音声 | ナレーション、アクセシビリティ、音声インターフェース |
| 音声から音声への翻訳 | 話された音声 | 翻訳された音声 | 会話、吹き替え、多言語メディア |
吹き替えには独自の区別があります。音声から音声への翻訳は、話される言語を変えることだけに狭く焦点を当てています。吹き替えは、その周りを包む、より広範なメディアローカライゼーションのワークフローです。すなわち、セリフの翻訳、話者の割り当て、新しい声の生成、タイミングの調整、翻訳された声と音楽・背景音のミキシング、そして完成したプロジェクトの書き出しです。録画されたYouTube動画、オンラインコース、ポッドキャスト、映画にとって、吹き替えは翻訳の上にこれらの編集上の制御を加えるため、通常はより実用的な形式です。音声と画面上のテキストのどちらにするか検討している場合は、動画における吹き替えと字幕の比較に関する解説でその具体的な選択を説明していますし、より広範な仕組みはAI吹き替えとは何か、その仕組みに関するガイドにまとめられています。
品質を決める3つの構成要素
出力品質は単一の数値ではありません。それぞれ固有の失敗モードを持つ3つの段階の積であるため、全体的な印象を信じるのではなく、それらを個別に評価するのが有効です。
自動音声認識は元の録音内の言葉を識別しますが、その精度は背景音楽、話者の重なり、強いアクセント、速い話し方や不完全な発話、分野特有の用語、質の悪いマイク、言語間のコードスイッチングによって低下します。ここでよく使われる指標が単語誤り率(WER)で、自動書き起こしを人間による基準と比較し、置換、削除、挿入の数を数えます。同じNISTの刊行物はWERを認識のベンチマークとして用いていますが、WERが低いからといって、後の翻訳が意味や調子を保持したことが確認できるわけではありません。元の音声がノイジーな場合は、翻訳が始まる前に、まず当社のスピーチセパレーターのようなツールでクリーンな音声を分離しておくと、認識精度を高められます。
機械翻訳は個々の単語以上のものを解釈しなければなりません。文の構造、文脈、代名詞と性別、慣用句、ユーモア、形式性、文化的な言及、専門用語、語順の違いを扱います。逐語的な翻訳は文法的に正しくても不自然に聞こえたり、意図した意味をひそかに変えてしまったりすることがあり、これは広告表現、法的指示、医療情報、金融コンテンツ、教育素材において特にリスクが高くなります。
音声合成は最終的な対象言語の声を生成し、発音、間、話す速度、イントネーション、強調、感情の調子、声のアイデンティティ、アクセントや言語の変種を制御します。当社のテキスト音声合成製品は、300を超えるAI音声、多言語生成、33言語にわたるボイスクローニングを提供し、話す速度、強調、数字の読み方、感情表現の制御が可能です。技術的に正確な翻訳であっても、その表現がそれが属するブランド、コース、ドキュメンタリーに合わなければ、うまく響かないことがあります。
翻訳音声におけるボイスクローニング
ボイスクローニングは任意ですが、翻訳されたコンテンツを、見知らぬ人が台本を読んでいるのではなく、同じ制作者によるものだと感じさせるものです。すべての言語に無関係なストック音声を割り当てる代わりに、システムは元の話者の声のアイデンティティをモデルにした対象言語のパフォーマンスを構築できます。この連続性は、複数の言語にわたって1つの認識可能な声を保ちたいチャンネル、有名なプレゼンターを擁する企業、講師主導の長いコース、吹き替え版全体で一貫性を必要とする映像作家、翻訳されたエピソードで馴染みのある音を保ちたいポッドキャストのホストにとって重要です。
これは保証ではありません。クローニングは声のアイデンティティを保持しますが、感情、ユーモア、テンポ、発音、文化的文脈は、公開前に依然として人間による確認が必要です。同じく重要なのが承認です。責任あるワークフローでは、録音を提供した人物がクローニングに同意していること、そして生成された声が意図された商業的、公共的、または地理的な配信に使用してよいことを確認します。この背後にある仕組みに興味がある場合は、ボイスクローニングの仕組みに関する概要でより深く掘り下げており、ボイスクローニングツールが制作側を示します。
録音翻訳とリアルタイム翻訳の違い
これはほとんどのチームが実際に直面する決断であり、この2つのモードを同じ物差しで判断すべきではありません。
録音翻訳は通常、作業する時間を与えてくれるため、メディア制作にはより適しています。書き起こしを修正し、用語を編集し、翻訳をレビューし、話者を識別し、タイミングを調整し、声を再生成し、背景音をミキシングし、公開前に人間による品質保証を行うことができます。これにより、YouTubeチャンネル、eラーニング、企業研修、ポッドキャスト、製品動画、独立系映画に非常に適しています。
リアルタイム翻訳はより厳しい制約の下で動作します。話者が文を話し終える前に出力を生成し始めなければなりません。より多くの文脈は翻訳品質を向上させますが遅延を増やし、一方で短い遅延は予測や部分的な翻訳を強いり、音声がすでに再生されてしまった後では誤りを撤回するのが困難です。DTICの報告書は、以前のカスケード型システムがしばしば4〜5秒の遅延で動作し、段階をまたいで誤りを蓄積し、パーソナライゼーションが限られていたこと、そしてモデルの先読みを増やすと品質は上がるがやり取りがより即時的でなく感じられるようになることを指摘しています。ライブ会議機能と洗練された多言語吹き替えは異なる問題を解決しているため、それぞれ異なる基準で評価してください。
音声から音声へのワークフローを評価する方法
きれいに整ったデモ文ではなく、代表的なサンプルでテストしてください。以下のチェックリストはコンテンツが直面する実際の条件を反映しており、評価を誠実なものに保ちます。
- 言語と方言のカバー範囲:「スペイン語対応」は、聴き手が期待するアクセント、語彙、地域的な好みを意味しないかもしれません。米国英語かその他の英語か、ラテンアメリカ系かヨーロッパ系のスペイン語か、カナダ系かヨーロッパ系のフランス語かを含め、元言語と対象言語の変種を確認してください。
- 書き起こしの精度:名前、数字、製品用語を取り違えた書き起こしを、翻訳が確実に修正することはできません。音声を生成する前に書き起こしを検査・編集できるかを確認してください。
- 意味と文脈:慣用句、冗談、行動喚起、製品表現、業界用語を意図的にテストしてください。流暢さは正確さではありません。
- 話者の扱い:インタビュー、パネルディスカッション、映画では、複数の話者を識別でき、人々が互いに割り込む場合も含めて声の一貫性を保てるかを確認してください。
- タイミングと同期:翻訳された文が元の長さと一致することはめったにありません。タイミングや話速の制御に加え、セリフの編集、背景音の保持、音量調整、セグメントの再生成、必要に応じた視覚的な整合を探してください。
- 声の自然さ:発音、間、強調、感情の幅、不自然なリズムを聴き取ってください。
- 遅延:ライブ用途では、話者から音声までの遅延を測定してください。録音用途では、純粋な処理速度よりも編集の柔軟性を優先してください。
- レビューと書き出しの制御:本番対応のツールは、テキストの修正、個々のセグメントの再生成、タイミングの調整、公開ワークフローが受け入れる形式での書き出しを可能にします。
これらのサンプルを候補リストに通し、書き起こしの精度、翻訳の意味、発音、声の自然さ、話者の一貫性、タイミング、背景音の品質、レビューの労力、そして想定する処理量での総コストを比較してください。最も優れたシステムは、最も多くの声や言語を持つものではありません。チームが実際に持続できるレビュー負荷で、特定のコンテンツに対して許容できる結果を生み出すものです。
計画に入れておくべきリスクと限界
すべての段階が独自の種類の誤りをもたらし、自然に聞こえる声はそれらすべてを覆い隠してしまいます。AIは曖昧な表現、名前、慣用句、専門用語を誤訳することがあるため、正確さが法的、安全上、金銭的、または評判上の重みを持つところでは、どこでも人間によるレビューが不可欠であり続けます。認識の誤りは問題を複合させます。ノイズ、話者の声の混線、アクセント、質の悪い録音は、システムが元の音声を聞き間違える原因となり得るため、翻訳を承認する前に書き起こしをレビューすることは譲れません。
文化的な意味は失われやすいものです。直訳は、逐語的な処理ではなく書き直しでしか生き残らないユーモア、礼儀、言及を落としてしまうことがあります。ボイスクローニングは同意となりすましのリスクを加えるため、誰が声を承認したか、使用範囲、地域、期間、そして広告や合成された公的発言に登場してよいかを文書化してください。聴き手の信頼という側面もあります。DTICの報告書は、ある翻訳体験が、翻訳された音声が合成的に生成されたものであることをユーザーに知らせる仕組みを説明しており、これは自らの開示において計画しておくべき合理的な期待です。
リストを締めくくるのは、2つのより静かなリスクです。音声が個人情報、機密の議論、顧客データ、未公開のコンテンツを含む場合は常にプライバシーが重要になるため、アップロードする前にプロバイダーのデータ取り扱い、保持、アクセス、削除の条件をレビューしてください。そして、誤った自信は何よりも陰険な失敗です。洗練された声は誤った翻訳を権威あるものに聞こえさせるため、流暢さを事実の正確さの証拠として扱ってはいけません。
DubSmartが適する場面
当社は、普遍的なライブ会話翻訳をうたうのではなく、AI吹き替えを通じた録音された音声から音声への翻訳に最も直接的に関連しています。当社の吹き替えワークフローは、音声・動画のアップロードとYouTubeリンクを受け付け、60を超える元言語と33の対象言語をサポートし、翻訳版のために各話者の声をクローンし、テキスト、話者、タイミングの編集、セグメントの再生成、背景音の音量調整、完成プロジェクトのダウンロードを可能にします。この編集上のレイヤーこそが、録音メディア制作が必要とするものそのものです。
独自のパイプラインを構築するチーム向けに、当社はAI吹き替え、テキスト音声合成、ボイスクローニングのAPIも提供しており、これらは多言語音声制作を自動化する必要のあるエージェンシー、メディアワークフロー、アプリケーションに適しています。適切な選択は、プロジェクトが完成されたメディアエディターを望むのか、API駆動のパイプラインを望むのか、あるいはその両方かに帰着します。短く、重要度の高いメッセージには、プロの人間による翻訳と録音が依然として勝るかもしれません。大規模で頻繁に更新されるコンテンツライブラリには、最もリスクの高い素材に集中した人間のレビューを伴うAIワークフローの方が、よりよく拡張できます。
よくある質問
音声から音声への翻訳は通訳と同じですか?
いいえ。人間による通訳は、訓練を受けた人がその場で聞き、理解し、意味を伝えることに依存します。音声から音声への翻訳は自動化されており、速く拡張性がありますが、レビューを必要とする場合があり、プロの通訳者が自然に扱うニュアンスに苦労することがあります。
常にリアルタイムで機能しますか?
いいえ。一部のシステムは完全な編集制御のもとで録音された音声を処理し、他のシステムはライブまたはほぼリアルタイムの出力を提供します。ライブシステムは、翻訳の文脈、遅延、精度を常にバランスさせています。
元の話者の声を保持できますか?
場合によります。ボイスクローニングや音声保持型の合成を使用するシステムは、元の話者のアイデンティティをモデル化できますが、結果は技術、言語ペア、音声品質、そしてその声を使用する承認によって異なります。
AI吹き替えは音声から音声への翻訳の一形態ですか?
はい。AI吹き替えは、音声から音声への翻訳の録音メディア向けの応用であり、中核となる翻訳の上に、編集、話者管理、タイミング、ミキシング、書き出しの機能を加えたものです。
どのくらい正確ですか?
正確さは言語、録音品質、用語、話者、システムによって異なります。単一の正確さの割合を信じるのではなく、書き起こし、翻訳、生成された音声を個別に評価してください。