AIダビングAPIは、動画を1本手作業で吹き替えることと、すでに公開しているあらゆるものに吹き替え機能を直接組み込むことの違いを生み出します。わかりやすく言えば、これはアプリケーションが動画や音声ファイルを送信し、1つ以上のターゲット言語や音声設定を選択し、人間がダッシュボードをクリックするのではなく、APIリクエストを通じてローカライズされたバージョンを受け取ることを可能にする開発者向けインターフェースです。したがって、AIダビングAPIとは何かという問いの背後にある本当の疑問は、単なる定義の話ではめったにありません。それは、たまに使う吹き替えツールが必要なのか、それともローカライズを繰り返し、大規模に、そして自社製品やコンテンツのパイプライン内で行う必要があるのか、ということです。
このガイドは、その意思決定の開発者側のハブです。ダビングAPIが実際に何をするのか、そのワークフローがどのように構成されているのか、単純なテキスト読み上げ呼び出しとどう違うのか、そしてスタックに組み込む価値があるかどうかをどう判断するのかを扱います。役立つ場合は、ここで繰り返す代わりに、より詳細な解説記事を案内します。
目次
ダビングAPIが実際に行うこと
ダビングAPIは、本来なら別々のツールを必要とするいくつかのメディア処理ステップをまとめて提供します。単一のパイプラインから、発話された言葉を捉える音声認識、テキストへの文字起こし、選択した言語への翻訳、話者検出と分離、音声選択またはクローニング、新しい言語での音声合成、タイミングと同期、そして最終的にローカライズされた動画や音声ファイルをダウンロード用にレンダリングするまでを処理します。
このまとまりこそが、基本的なテキスト読み上げAPIとの違いです。Text to Speech APIは、すでに手元にあるテキストから始まり、音声を返します。ダビングAPIは録音されたメディアから始まり、その周辺のローカライズチェーン全体を担うため、アプリケーションが文字起こし、翻訳、音声生成を自前でつなぎ合わせる必要がありません。完成した台本だけを入力するのであれば、テキスト読み上げ呼び出しのほうが軽量な選択肢です。既存の映像から始めるのであれば、ダビングAPIは裏側ではるかに多くの作業を行っています。
ダビングワークフローの4つのレイヤー
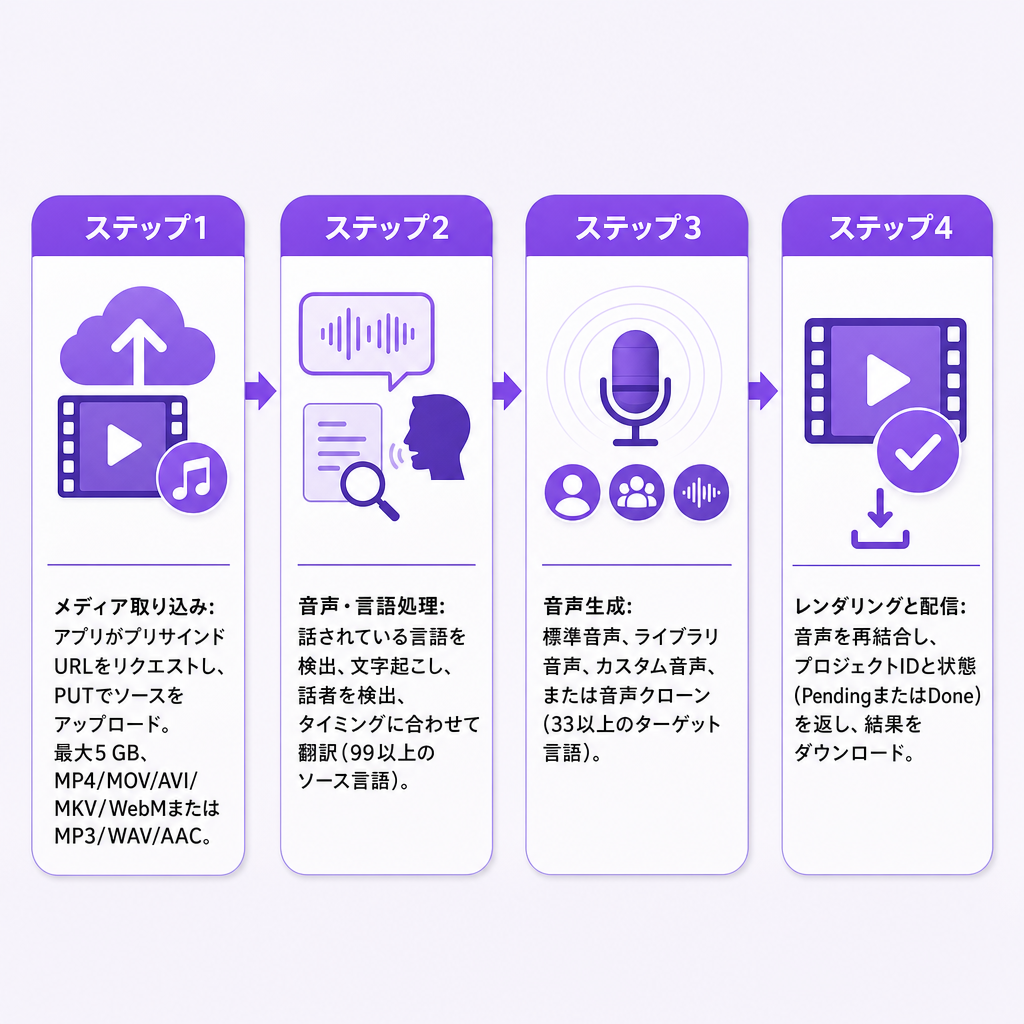
実装はさまざまですが、ほぼすべてのAPIベースのダビングフローは4つの論理的なレイヤーに分かれており、それらを理解することで、どこで物事がうまくいくか、あるいはうまくいかないかがわかります。
メディアの取り込み。 アプリケーションがソースファイルをサービスに送信します。一部のAPIは直接アップロードを受け付け、他のAPIは公開メディアURLや一時的なアップロードリンクを使用します。私たちの公開されているワークフローは署名付きアップロードURLを使用します。アプリケーションがURLをリクエストし、その後PUTリクエストでファイルをアップロードします。私たちのドキュメント化されたAPIは、MP4、MOV、AVI、MKV、WebMといった一般的な動画形式に加え、MP3、WAV、AACを含む音声形式を、最大5 GBのファイルサイズまで受け付けます。
音声と言語の処理。 サービスは、何が話されたか、どの言語が話されたか、各フレーズがいつ出現するか、誰が話しているかを割り出し、その後利用可能なタイミングに合わせて文字起こしを翻訳します。これは、名前、専門用語、ジョーク、文化的な言及、ブランド用語について、依然として人間のレビューが効果を発揮するレイヤーです。
音声生成。 翻訳されたテキストは、標準的な合成音声、ライブラリ音声、カスタム音声、または元の話者のクローンを使って音声になります。私たちのAIダビングAPIは、トーン、ピッチ、アクセント、話し方を33以上のターゲット言語にわたって保持することを目的とした音声クローニングに対応し、99以上のソース言語に対するソース言語検出を備えています。クローニングが自動的に正しい選択というわけではありません。ネイティブのターゲット言語音声のほうが一部の視聴者にとってより自然に聞こえる場合もあれば、クローン音声が繰り返し登場する発表者や教育者により強い一貫性を与える場合もあります。
レンダリングと配信。 APIは生成された音声を元のメディアと再結合し、吹き替えされた動画、分離された音声、または個別のセグメントを返します。私たちのワークフローはプロジェクトを作成し、プロジェクトIDとPendingやDoneといった処理状態を進捗情報とともに返し、レンダリングが完了するとダウンロード可能な結果URLを公開します。
APIとダッシュボード型ダビングツールの比較
オンラインダビングツールは、画面の前にいる人のために作られています。アップロードし、設定を選び、レビューし、ダウンロードする。ダビングAPIはソフトウェアのために作られているため、開発者は吹き替えを動画アップロードプラットフォーム、コンテンツや学習管理システム、ローカライズパイプライン、YouTube制作ワークフロー、モバイルやWebアプリ、あるいは代理店のバッチシステムに接続できます。基盤となるAIは同一でありうるものの、制御性と体験は同じではありません。
選択は通常、頻度と作業がどこで行われるかに帰着します。
| ユースケース | より良い出発点 |
|---|---|
| たまに1本の動画を吹き替える | Webベースのダビングツール |
| 新しいアップロードをすべてローカライズする | ダビングAPIまたは自動連携 |
| アプリ内に言語選択を追加する | ダビングAPI |
| 数本のトレーニング動画を制作する | 自動化が重要でない限りWebベースのツール |
| 多数のファイルや言語を繰り返し処理する | ダビングAPI |
| 構築前に音声品質をテストする | Webベースのツールまたは小規模なAPIパイロット |
答えが「私は時々手作業で動画を吹き替えている」であれば、ブラウザでAI Dubbingから始め、ボリュームがエンジニアリングの時間を正当化するようになってから初めてAPIに移行してください。
ダビングが即時呼び出しではなくジョブである理由
文字起こし、翻訳、合成、同期、レンダリングはすべて実際に時間がかかり、多くの場合、通常のWebリクエストが待てる時間よりも長くかかります。本番環境の連携では、ダビングを即座に完成した動画を返す関数としてではなく、非同期ジョブとして扱うべきです。
信頼できるパターンは次のとおりです。メディアと設定を送信し、プロジェクトまたはジョブIDを受け取り、後でステータスを確認するか、Webhookがあれば完了通知を受け入れ、完成したメディアと関連ファイルを取得し、その後失敗したジョブ、再試行、期限切れのダウンロードリンクを処理します。私たちの公開APIは、プロジェクト作成、プロジェクト状態、進捗追跡、プロジェクトIDによるステータス取得をドキュメント化しており、単一のリクエストで複数のターゲット言語を扱うことができ、スペイン語、フランス語、ドイツ語といった言語のグループ化されたプロジェクトを一度に作成できます。
プロバイダーを比較する際には、見出しの言語数よりもこうした運用上の詳細のほうが重要です。ポーリング、Webhook、再試行のガイダンス、冪等性、明確な失敗状態を確認してください。これらこそが本番環境でパイプラインを安定させるものだからです。
ダビングAPIか、個別の音声APIか
ダビングAPIはエンドツーエンドのローカライズ製品です。メディアを渡すと、最小限のオーケストレーションで別の言語を受け取れます。チェーンのより多くの部分を自前で所有する必要がある場合は、個別のAPIが理にかないます。翻訳せずに文字起こしするにはSpeech to Textステップを、既存の文字起こしに対する翻訳ステップを、完成した台本をナレーションするためのテキスト読み上げステップを、カスタム音声を作成して再利用するためのVoice Cloning APIを、処理前に音楽から音声を分離するためのSpeech Separatorを使用してください。
判断のルールはシンプルです。スピードとシンプルさが勝る場合は、統合されたダビングAPIを選びましょう。文字起こし、翻訳メモリ、音声パイプライン、タイミングモデル、または最終レンダリングレイヤーを制御する必要がある場合は、個別のサービスを選びましょう。多くのチームは統合された状態で始め、特定のステージ(通常は翻訳レビューや音声ミキシング)がボトルネックになってから初めてパイプラインを分割します。
APIを通じて制御できること
ダビングAPIが公開する設定によって、パイプラインを離れずにどれだけの仕上がりを実現できるかが決まります。有用なAPIレベルの制御には、ソース言語または自動検出、1つ以上のターゲット言語、音声選択とクローニング、話者数と話者から音声への割り当て、背景音量、編集可能な翻訳テキスト、セグメントのタイミング、字幕生成、選択したセグメントの再生成、そして出力形式とダウンロードオプションが含まれます。
私たちの公開された例には、言語、性別、アクセントでフィルタリングされた音声取得、カスタム音声の取得、話者管理、セグメント編集、背景音量の調整、プロジェクト全体または選択したセグメントのみの再生成が含まれます。最後の機能は十分に役立ちます。単一の名前、文、発音、または翻訳が間違っている場合、セグメントレベルの再生成によって、動画全体を再レンダリングする代わりにその一部分だけを修正できます。それがなければ、一語の修正に完全なレンダリングのコストがかかりかねません。
構築前にダビングAPIを評価する方法
きれいなクリップを1本吹き替えるだけの概念実証は、本番環境の信頼性についてほとんど何も教えてくれません。エンジニアリングの時間を投じる前に、7つの領域をストレステストしてください。
言語カバレッジ。 生の総数は無視し、視聴者が必要とする正確な言語と地域バリアントを確認してください。ソース言語を検出できますか。方言と必要な書記体系はサポートされていますか。すべてのターゲット言語で音声が利用可能で、クローン音声と標準音声で機能は同一ですか。私たちは33以上のターゲット言語と99以上のソース言語(英語、スペイン語、ポルトガル語、フランス語、ドイツ語、中国語、日本語、韓国語、ロシア語、アラビア語、ヒンディー語を含む)を公に宣伝していますが、依存する前に現在のリストと音声の利用可能性を確認してください。
音声の品質とアイデンティティ。 翻訳が完璧でも、音声が平板に聞こえれば失敗します。短い文と長い文、質問、速い発話、間、複数の話者、感情表現、固有名詞、そして複数の動画にわたる同じ話者をテストしてください。音声をクローンする場合は、特に商業利用や識別可能な人物については、そのクローン作成と配布についての文書化された許可があることを確認してください。
翻訳と編集の制御。 最終レンダリング前に翻訳された台本をレビューおよび修正する方法を探し、完全な再生成なしに1つの文やタイミング範囲を変更できるセグメントレベルの編集があるかを確認してください。
入力と出力の制限。 最大ファイルサイズと長さ、サポートされる形式、URLかファイルアップロードか、出力形式、ダウンロードリンクの有効期限、保持ポリシー、バッチの制限を確認してください。私たちの公開ページには最大5 GBのファイルサイズが記載されており、一般的な動画と音声の形式をサポートしています。
統合設計。 使えるAPIは1つのエンドポイント以上のものです。認証、アップロード処理、プロジェクト作成、ステータス取得、エラー状態、再試行、ページネーション、音声の発見、セグメント編集、結果のダウンロード、使用状況レポート、そしてWebhookまたはその他の完了メカニズムをレビューしてください。認証情報はサーバー上に保持し、ブラウザやモバイルアプリのコードには決して置かないでください。
コストモデル。 実際のコストは、ソースの長さ、ターゲット言語の数、話者数、クローニング、再レンダリング、ストレージ、文字起こしの使用、API呼び出し、優先処理に依存します。吹き替えられた1分が完全なローカライズプロジェクトに等しいと想定しないでください。改訂を含めて、レンダリングされる言語バージョンの数を見積もってください。私たちの公開APIページは機能セットを説明していますが、そこにAPIの価格は掲載していないため、予算を組む前に現在の商用条件を問い合わせてください。
プライバシー、権利、セキュリティ。 メディアを第三者に送信する前に、保持期間、ファイルがモデルを学習させるかどうか、データがどこで処理されるか、削除がどのように機能するか、生成された音声を誰が所有するか、クローン音声にどのような権利が適用されるか、商業利用が許可されているかどうか、エンタープライズ制御が存在するかどうかを明確にしてください。APIは、無許可の録音、台本、演技、または音声を法的に使用可能にすることはできません。使い始める時点で権利が必要です。
リスクと、APIが誤った選択となる場合
自動化は出力をスケールさせるのと同じくらい効率的にミスをスケールさせるため、失敗モードを知っておきましょう。AI翻訳は文脈、ユーモア、慣用句、文化的な言及を見落としても、流暢に聞こえることがあります。翻訳された音声は元のものより長かったり短かったりすることが多く、不自然な間、急いだ発話、重なりを生み出します。クローン音声は感情の細部や発音を失うことがあり、ノイズの多い音声、重なる話者、音楽、または非常に短いサンプルで劣化します。音楽や効果音は文字起こしと話者分離の精度を低下させるため、よりクリーンなソース音声のほうが良い結果を生みます。同意のないクローニングは実際のなりすましリスクを生み出します。だからこそ、文書化された許可とカスタム音声への制限付きアクセスが重要なのです。
APIが誤った選択となるのは、短い動画が1本だけ必要な場合、コンテンツが繊細な演技を要求する場合、ソース録音がノイズが多いか分離が不十分な場合、APIがサポートしていない方言が必要な場合、組織が外部処理業者にメディアを送信できない場合、またはすべてのセリフに専門的な言語レビューと演技レビューが必要な場合です。最も信頼できる構成は通常ハイブリッドです。文字起こし、翻訳、音声生成、レンダリングを自動化し、その後、何かを公開する前に台本と最終音声を人間に担当させ、教育、広告、医療、金融、法務のコンテンツについてはそのレビューチェックポイントを必須に保ちます。
DubSmart AIダビングAPIが適している場面
私たちのAIダビングAPIは、手作業の吹き替えよりも統合を正当化できるほど頻繁にメディアをローカライズするチーム向けに作られています。公開されているAPIは、33以上のターゲット言語、99以上のソース言語に対する検出と処理、話者の特徴を保持する音声クローニング、1つのプロジェクトリクエストでの複数ターゲット言語、署名付きファイルアップロード、ベアラートークン認証、プロジェクト作成とステータス取得、話者とセグメントの編集、選択的な再生成、動画と音声のダウンロード、一般的な形式のサポート、最大5 GBのファイルサイズ、そして各プランでの商業利用をカバーしています。
これをより広いAPIの全体像に照らし合わせているのであれば、私たちの「Voice AI APIとは?初心者向けガイド」は5つのAPIタイプを整理しており、「Text to Speech APIとは何か、どのように機能するか」はナレーションのみのケースを扱っています。いざ接続する準備ができたら、AIダビングAPIのページに現在の例と機能があります。隣接するサービスのクイックスタートパターンについては、Voice Cloning APIの統合方法に関する私たちの解説が、ダビングでも見覚えのあるアップロード・作成・生成のリズムを示しています。
よくある質問
AIダビングAPIとは何ですか?
それは、話されたメディアを翻訳し、吹き替えされた音声や動画を自動的に生成するソフトウェアインターフェースで、通常は文字起こし、翻訳、音声合成、同期、メディアレンダリングを1つのワークフローに組み合わせたものです。
AIダビングAPIはテキスト読み上げと同じですか?
いいえ。テキスト読み上げは、与えられたテキストを音声に変換します。ダビングAPIは録音された動画や音声から始まり、その周辺で文字起こし、翻訳、音声生成、同期を管理します。
AIダビングAPIは元の話者の声をクローンできますか?
できるものもあります。私たちの公開されているAIダビングAPIには、文書化された同意を条件として、ターゲット言語で元の話者の特徴を保持することを目的とした音声クローニングが含まれています。
動画を一度に複数の言語に吹き替えることはできますか?
一部のAPIは、単一のプロジェクトリクエストで複数のターゲット言語をサポートしています。私たちの公開されたワークフローは、1つのリクエストでスペイン語、フランス語、ドイツ語のグループ化されたプロジェクトを作成する様子を示しています。
ダビングジョブを送信した後、アプリケーションは何を受け取りますか?
通常はまずプロジェクトまたはジョブの識別子です。その後、アプリケーションは処理を監視し、完成した動画、音声、文字起こし、字幕、またはセグメントが準備でき次第、それらを取得します。