ボイスクローニングAPIとは、許可された音声サンプルを再利用可能な合成音声に変換する開発者向けのインターフェースです。これにより、アプリケーションはテキストを送信したり、自動吹き替え処理を実行したりして、元の話者に似た新しい音声を取得できます。カタログから固定された音声を選ぶのではなく、コードが固有のIDに紐づいた音声アイデンティティを作成し、それをスクリプト、製品、言語をまたいで再利用します。この変化—音声を選ぶことからプログラム的に音声を所有することへの変化—こそが、この技術をクリエイター、ブランド、そして大規模に開発を行う開発者にとって興味深いものにしています。
ボイスクローニングAPIとは何かという問いへの短い答えはこうです。それは、オーディオのアップロード、音声の作成、音声の生成という3つの連携した機能を、ソフトウェアが呼び出せるエンドポイントとして公開するものです。これらの要素がどのように組み合わさるかを理解することが、スムーズな本番パイプラインと苛立たしいパイプラインを分けるのです。そこで、この解説の残りの部分では、その仕組み、トレードオフ、そして一つのファイルが公開される前に解決しておくべき権利の問題について説明していきます。
目次
ボイスクローニングAPIが実際に行うこと
ボイスクローニングAPIは、クローニングを、オーディオエディターやウェブダッシュボードに埋もれた手動機能としてではなく、プログラム可能なサービスとして公開します。アプリケーションがサンプルをアップロードすると、プロバイダーはそれを独自のIDを持つカスタム音声に変換します。それ以降、そのIDがテキスト読み上げや吹き替えのリクエストに渡すハンドルとなります。
このパターンはプロバイダー間で一貫しています。オーディオサンプルがカスタム音声IDになり、それがテキストや翻訳されたスクリプトから新しい音声となり、それが完成したオーディオファイルになります。機械学習の処理—トーン、発音パターン、音域、リズム、音色の分析—はエンドポイントの裏側で行われ、生成された音声モデルは、参照話者の認識可能な特徴を保ちながら、まったく新しいスクリプトを話すことができます。
何よりも重要な区別が一つあります。APIは元の録音を再生するのではなく、新しい音声を合成します。クローン音声は、ソースサンプルに一度も含まれていなかった言葉を話すことができます。これこそが、この技術が強力である理由であり、同時に責任を伴う理由でもあります。
API の裏側でボイスクローニングがどのように機能するか
プロバイダーによってモデルの実装は異なりますが、ほとんどのシステムは同じ大まかな段階を共有しており、それらを知ることで信頼性の高い統合を設計するのに役立ちます。
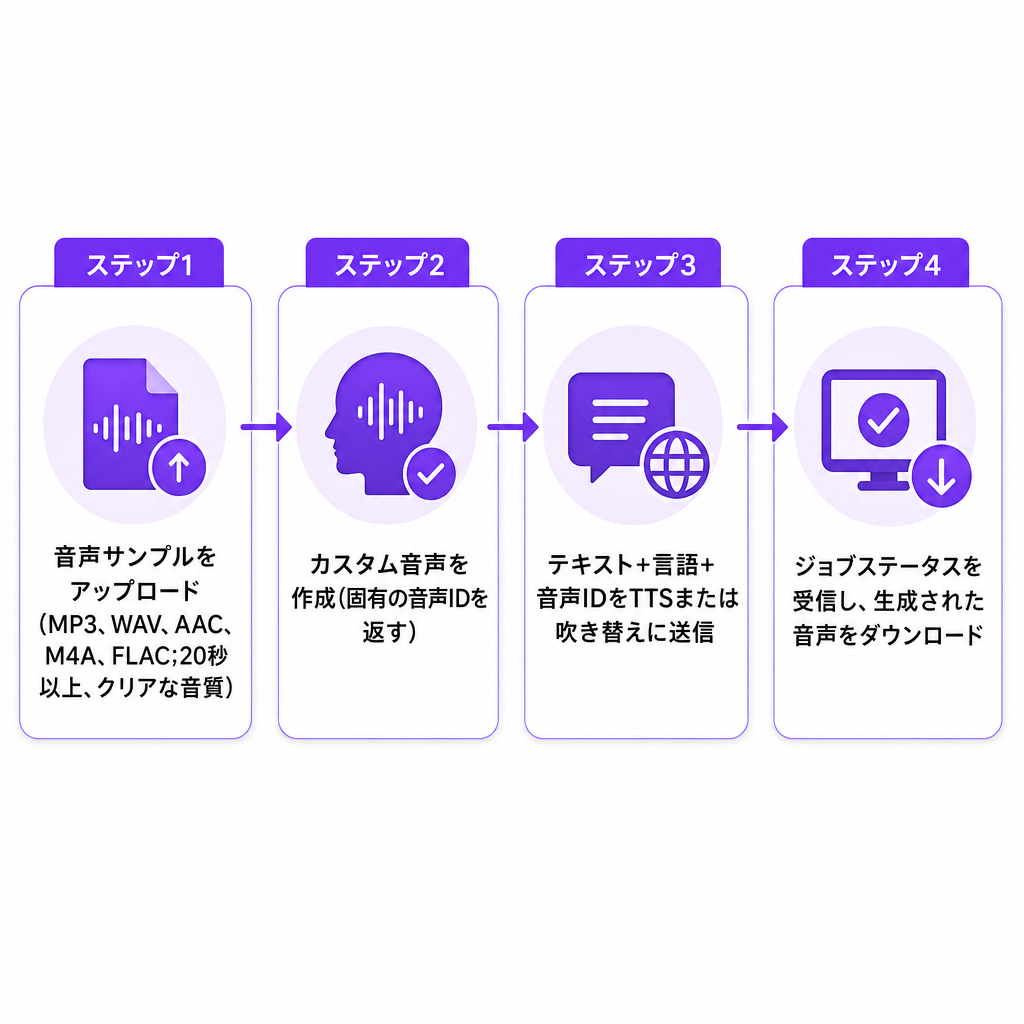
まず、システムが音声サンプルを受け取ります。開発者は一般的に、事前署名付きアップロードURLを通じてアップロードします。これにより、アプリケーションは大きなオーディオペイロードを音声作成リクエストに詰め込む代わりに、ファイルを直接ストレージに送信できます。ここではクリーンなソースオーディオが重要です。なぜなら、モデルは話者とともに不要な音も学習してしまう可能性があるからです。音楽、部屋の反響、複数の話者の重なり、歪み、過度なノイズ除去はすべて、クローンの一貫性を低下させます。当社のボイスクローニングAPIは、MP3、WAV、AAC、M4A、FLACのサポートを記載しており、最良の結果を得るためにはバックグラウンドノイズのない少なくとも20秒のオーディオを推奨しています。
次に、プロバイダーがカスタム音声を作成します。アップロード後、アプリケーションは保存されたファイルの場所と名前を送信し、サービスは識別子を持つ音声オブジェクトを返します。その識別子が、その後のすべての鍵となります—アプリケーションは、それをユーザー、プロジェクト、キャラクター、またはブランドのレコードと一緒に独自のデータベースに保存します。当社のドキュメントは、作成エンドポイントに加えて、ページネーション付きでカスタム音声を一覧表示するエンドポイントと、IDでカスタム音声を削除するエンドポイントで、このパターンに従っています。
第三に、アプリケーションが新しい音声を生成します。カスタム音声が存在すると、コードはテキスト、言語、カスタム音声IDをテキスト読み上げエンドポイントに送信します。サービスはプロジェクトまたはジョブの識別子を返します。その後、アプリケーションは処理が完了するまでジョブのステータスをポーリングし、生成されたオーディオURLを取得します。当社のTTS APIは、保留中、処理中、完了、失敗のステータスを持つプロジェクトベースの生成を記載しており、個々のセグメントレベルで音声、言語、速度、ピッチの値を公開しています。
生成側のより詳細な仕組みを知りたい場合は、テキスト読み上げAPIとは何か、そしてどのように機能するかに関する当社の解説が、クローン音声が最終的に動かす合成パイプラインを詳しく説明しています。
ボイスクローニングAPIとテキスト読み上げ・吹き替えAPIの比較
これら3つのAPIは関連していますが、異なる問題を解決しており、それらを混同すると誤ったアーキテクチャにつながります。
| APIの種類 | 主な入力 | 主な出力 | 最適な用途 |
|---|---|---|---|
| テキスト読み上げAPI | テキストと選択した音声 | 合成音声 | ナレーション、アラート、アシスタント、スクリプト化されたオーディオ |
| ボイスクローニングAPI | オーディオサンプル | カスタム音声ID | 再利用可能な音声アイデンティティの作成 |
| AI吹き替えAPI | 動画またはオーディオと言語設定 | 翻訳・吹き替えされたメディア | 多言語の動画・オーディオのローカライゼーション |
実際には、ボイスクローニングAPIが単独で機能することはめったにありません。クローニングエンドポイントが音声を作成し、テキスト読み上げエンドポイントがその音声IDを使って新しいテキストを話します。同じ音声IDは吹き替えワークフローにも流れることができ、そこではシステムが元の対話を翻訳し、選択されたカスタム音声で翻訳されたパフォーマンスを生成します。当社はカスタム音声をTTSとAI吹き替えの両方のプロジェクトで使用可能なものとして説明しており、これにより一つの20秒のサンプルが、同じアイデンティティからナレーションとローカライゼーションの両方に役立ちます。吹き替えに特化したアーキテクチャについては、AI吹き替えAPIとは何かに関する当社の関連解説を、音声エンドポイントのより広いファミリーについては、音声AI APIとは何かに関する当社のガイドをご覧ください。
それを使って構築できるもの
ボイスクローニングAPIは、多くのスクリプト、製品、言語をまたいで、同じ音声を繰り返し生成する必要がある場合にその真価を発揮します。いくつかの具体的なパターンが、それがどこに適合するかを示しています。
YouTubeクリエイターは、一つの音声サンプルを録音し、その結果得られた音声を動画のローカライズ版に再利用でき、スクリプトを一つ一つ再録音することなく、さまざまな言語市場向けのナレーションを生成できます。クローンは翻訳レビューの必要性を排除するものではありません—名前、慣用句、ジョーク、文化的な言及には依然として人間のチェックが必要です—が、録音のボトルネックを取り除きます。
企業は、キャンペーンごとに異なる音声を割り当てるのではなく、製品解説、オンボーディング動画、広告、ヘルプコンテンツのために一貫したナレーターを作成できます。制作前の実用的な対応策は、音声利用ポリシーです。どの部署が音声を使用できるか、どのコンテンツに承認が必要か、そして合成ナレーションを開示する必要があるかどうかです。
トレーニングチームは、ポリシー、製品の詳細、または手順が変更されたときにレッスンを迅速に更新できる能力を得て、大規模なコースライブラリ全体で連続性を保ちます。デリケートな主題については、生成された音声はスクリプトが間違っていても自信ありげに聞こえるため、人間のレビューが不可欠です。ポッドキャストのプロデューサーは、イントロ、訂正、要約、または別言語版のために、一貫したホストやキャラクターの音声を維持でき、これは小さな編集のために丸ごと新しいセッションが必要になる場合に便利です。そして、ゲーム、教育アプリ、アクセシビリティツール、ガイド付き体験を構築する開発者は、すべての応答に対して手作業でオーディオをエクスポートする代わりに、音声を既存のワークフローの一部にすることができます。
ボイスクローニングAPIの評価方法
適切なプロバイダーは、単一のデモがどれだけ洗練されて聞こえるかではなく、あなたの制作要件によって決まります。コミットする前に、以下の各観点を検討してください。
オーディオ入力要件。 サポートされているファイル形式、最小または推奨されるサンプルの長さ、複数の話者が拒否されるかどうか、バックグラウンドノイズがどのように扱われるか、アップロードが直接受け入れられるかどうか、そしてクローニング後に参照ファイルを削除できるかどうかを確認してください。当社はMP3、WAV、AAC、M4A、FLACをサポート形式として記載しており、少なくとも20秒のクリーンなサンプルを推奨しています。
音声の品質と一貫性。 複数の文で音声をテストしてください。短い文と長い文、数字と日付、固有名詞、疑問文と感嘆文、専門用語、そして発音が難しい単語を含めてください。短いデモで魅力的なクローンも、長いナレーションや慣れない言語ではブレることがあります。
言語とローカライゼーションのサポート。 多言語出力が目標の場合、サポートされているソース言語とターゲット言語、カスタム音声がそれぞれを話せるかどうか、アクセントと発音の挙動、そして言語をまたいで音声が認識可能なままかどうかを確認してください。当社のTTS APIは、英語、ポルトガル語、スペイン語、フランス語、ドイツ語、中国語、日本語を含む33以上の言語と方言にわたる300以上のAI音声を公に表明しています。そのページには完全な言語カタログを公開していないため、本番ワークフローを固定する前に、正確な音声と言語の組み合わせを確認してください。
APIアーキテクチャ。 本番対応のAPIは、認証、アップロード、音声作成、一覧表示、削除、プロジェクトステータス、リトライ、検証エラー、ページネーション、オーディオ取得、使用状況の監視について、予測可能な処理を提供すべきです。当社は例の中でBearerトークン認証を示しており、音声管理エンドポイントとプロジェクトベースのTTS処理の両方を記載しています。
同期生成と非同期生成。 短いリクエストは素早く返されるかもしれませんが、長いコンテンツはジョブとして処理する方が適しています。リクエストを送信し、ジョブIDを受け取り、ステータスをポーリングまたは受信し、それからオーディオをダウンロードします。非同期設計は、長いナレーションや大量のセグメントのバッチがレンダリングされている間に、ウェブリクエストがタイムアウトするのを防ぎます。当社のTTSドキュメントはプロジェクトステータスと進捗値を使用しており、完了したプロジェクトはセグメントごとのオーディオURLとともにオーディオURLを返します。
出力と編集の制御。 出力形式と品質、サンプルレートが設定可能かどうか、速度とピッチが調整できるかどうか、個々のセグメントをダウンロードできるかどうか、プロジェクト全体を再実行せずに失敗したセグメントを再生成できるかどうか、そしてオーディオURLが一時的か永続的かを確認してください。当社はTTS API向けに22 kHzでのMP3出力を記載しており、セグメントレベルで速度とピッチの制御を公開しています。
削除とデータの制御。 プロバイダーは、アップロードされた参照オーディオ、生成されたカスタム音声、生成されたオーディオファイル、および関連するプロジェクトデータを削除できるようにすべきです。当社のボイスクローニングAPIには、カスタム音声用の削除エンドポイントが含まれており、ユーザーがカスタム音声と関連するオーディオを削除できることを明記しています。機密性の高い、または商業的にデリケートな録音をアップロードする前に、現行のプライバシー条項と保持に関するコミットメントを確認してください。
権利、なりすまし、責任ある利用
音声をクローニングすることは、技術的な判断であると同時に、権利、プライバシー、なりすましに関する判断でもあり、それを単なるコードとして扱うことがチームをトラブルに陥れる原因となります。
許可から始めましょう。録音を使用するのは、その話者の音声をクローニングし使用する権利がある場合のみにしてください。ビジネスワークフローでは、書面による同意が、合成音声の作成、商業利用、言語と地域、ライセンス期間、広告や政治的コンテンツ、トレーニングやカスタマーサービスでの利用、音声がサブライセンス可能かどうか、そしてそれがどのように削除または廃止されるかを対象とすべきです。オンラインで録音を見つけたからといって、それをクローニングする権利が与えられるわけではありません。
なりすましに対して警戒してください。なぜなら、合成音声は不正なリクエストを信じられるものに聞こえさせることができるからです。FTCは、詐欺師が親族や経営者の音声をクローニングして、人々にお金を送らせたり情報を共有させたりするよう圧力をかける可能性があると警告しています。賢明な安全対策には、カスタム音声を作成またはアクセスできる人を制限すること、生成されたオーディオを公開する前に承認を要求すること、生成活動をログに記録すること、開発用と本番用の認証情報を分離すること、レート制限を適用すること、高リスクのコンテンツカテゴリをブロックすること、そして金融関連のリクエストに対して第二の検証チャネルを要求することが含まれます。
米国の対象者にとって、発信コールは法的な重みを増します。FCCは、AI生成の音声が人工的または事前録音された音声に関する電話消費者保護法の制限の対象となると述べており、そのようなコールは例外が適用されない限り、一般的に事前の明示的な同意が必要です。ボイスクローニングAPIは、テレマーケティング、債権回収、政治的コール、または身元に敏感なコミュニケーションを自動化するためのライセンスではありません。AI生成のロボコール音声に関するFCCの裁定と、ボイスクローニングに関するFTCの消費者警告を直接お読みいただけます。
最後に、クローニングは伝達方法を変えるのであって、真実を変えるものではありません。リアルな音声は不正確な発言を権威あるものに聞こえさせるため、公開前に名前と数字、翻訳、医療・金融・法律に関する主張、製品の指示、発音、タイミング、画面上のテキストを確認してください。多言語動画については、翻訳されたスクリプトと最終的なオーディオの両方を確認してください—優れたクローンでも誤訳を救うことはできません。
ボイスクローニングAPIはあなたのプロジェクトに適しているか?
ボイスクローニングAPIは、多くのファイルにわたって同じ音声が必要な場合、すでに信頼できるテキスト、翻訳、またはメディアのパイプラインを持っている場合、時折の手動エクスポートではなくプログラム的な生成を望む場合、参照音声を使用する文書化された許可を保持している場合、ローカライズまたはパーソナライズされたコンテンツを大規模に制作する場合、そして公開前に生成されたオーディオをテストしレビューできる場合に、強く適合します。
速度、シンプルさ、低い法的リスクがブランドの連続性を上回る場合は、プリセットのTTS音声の方が役立つかもしれません。プロの声優は、フラッグシップキャンペーン、ニュアンスのあるパフォーマンス、デリケートな話題、または完全な人間のディレクションが必要な作業にとって、しばしば正しい選択です。カスタム音声とローカライゼーションの両方を一箇所で必要とするチームのために、当社はクローニング、TTS、AI吹き替えを連携したAPI機能として提供しています。当社のボイスクローニングAPIはサンプルからカスタム音声を構築し、当社のTTS APIは音声IDを使ってプロジェクトワークフロー内で音声を生成します。それを組み込む準備ができたら、ボイスクローニングAPIの統合方法に関する当社の解説が、アップロード・作成・生成のステップを詳しく説明しています。
最も有用な評価は、管理されたテストです。クリーンで許可されたサンプルを使用し、意図した言語で同じスクリプトを生成し、品質とレイテンシを検査し、APIのライフサイクルと削除の制御を確認し、何かを公開する前に人間の承認を要求してください。
よくある質問
ボイスクローニングAPIはAI音声ジェネレーターと同じですか?
いいえ。AI音声ジェネレーターは通常、既存の合成音声を選んでテキストから音声を生成します。ボイスクローニングAPIは、オーディオサンプルからカスタム音声を作成し、それを生成のために再利用できます。
音声をクローニングするにはどれくらいのオーディオが必要ですか?
要件はプロバイダーとモデルによって異なります。当社は少なくとも20秒のクリーンなオーディオを推奨しており、MP3、WAV、AAC、M4A、FLACの入力形式をサポートしています。
クローン音声は別の言語を話せますか?
場合によります。それはプロバイダーのモデル、そのサポートする言語、そして音声が言語をまたいで転移する能力に依存します。すべてのクローンがどこでも同じようにうまく機能すると仮定するのではなく、正確な音声と言語の組み合わせを確認してください。
AI吹き替えにクローン音声を使用できますか?
はい、プロバイダーがクローニングと吹き替えを連携させている場合に可能です。当社は、音声IDを参照することで、カスタム音声をAI吹き替えプロジェクトで使用することを許可しています。
ボイスクローニングは合法ですか?
技術そのものが自動的に違法になるわけではありませんが、許可なく誰かの音声を使用することは、プライバシー、パブリシティ権、契約、詐欺、消費者保護の問題を引き起こす可能性があります。許可を得て、適用される法律に従い、欺瞞的ななりすましを避けてください。