音声AI APIとは、自分で構築する必要のないAIモデルを使って、アプリケーションが音声の作成、理解、変換、またはローカライズを行えるようにするプログラム可能な接続のことです。テキスト、音声、または動画をエンドポイントに送信すると、有用な成果物が返ってきます。合成されたナレーション、文字起こし、カスタム音声、または完全に吹き替えられた動画などです。始める際に本当に問うべきなのは、「AIボイス」が必要かどうかではなく、あなたの製品が実際にどの音声機能を必要とするかです。なぜなら、音声生成、音声認識、ボイスクローニング、吹き替えは、たまたまカテゴリー名を共有しているだけの、それぞれ異なる製品だからです。
このガイドでは、この用語の意味、主なAPIの種類とその違い、リクエストがパイプラインをどのように通過するか、良い適合と高くつく失敗を分ける判断基準、そして出荷前に管理すべきリスクについて解説します。これは当社の開発者向けおよびAPIシリーズのハブであり、役立つ場合にはより詳細な統合ガイドへのリンクも掲載しています。
目次
「音声AI API」が実際に意味するもの
このフレーズは3つの概念を束ねています。音声AIとは、人間の音声を扱ったり、合成音声を生成したりする人工知能のことです。APIとは、アプリケーションプログラミングインターフェース、つまり2つのソフトウェアシステムがリクエストとレスポンスをやり取りするための定義された方法です。この組み合わせは、重いモデル処理をプロバイダー側で行い、一方であなたのアプリケーションはユーザー体験、ビジネスルール、最終的なコンテンツを扱うことを意味します。
リクエストは、読み上げたいテキスト、音声識別子、言語コードを含む短いJSONペイロードのように単純なものでも構いません。レスポンスは通常、プロジェクト識別子、処理ステータス、そして準備ができた生成音声へのURLを返します。動画ローカライズの場合、リクエストは代わりにアップロードされたファイルと対象言語のリストを参照します。
その構造こそが、APIをブラウザベースの音声生成ツールと区別するものです。ウェブアプリは、人が手作業で1回ずつ操作するために作られています。APIは、ソフトウェアが繰り返し、自動的に、大規模に呼び出すために作られています。たまにナレーションを1つ作るだけなら、ウェブツールのほうが速いことが多いでしょう。公開するすべての動画をローカライズするなら、APIが肝心です。
主な5種類の音声AI API
「音声AI API」は1つの技術ではなくカテゴリーです。この5つの一般的なタイプは、それぞれ異なる入力を受け取り、異なる出力を返します。間違ったものを選ぶと統合時間が無駄になります。以下の表は、開始材料と望む結果を照合できるようにマッピングしたものです。
| APIの種類 | 入力 | 出力 | 典型的な用途 |
|---|---|---|---|
| テキスト読み上げ | 書かれたテキスト | 合成音声オーディオ | ナレーション、アクセシビリティ、アプリのプロンプト、トレーニング |
| 音声認識(文字起こし) | 音声または動画 | 書き起こしテキスト | 字幕、検索、議事録、再利用 |
| ボイスクローニング | 許諾済みの音声サンプル | カスタム合成音声 | ブランドボイス、定期的なプレゼンター、多言語ナレーション |
| AI吹き替え | 動画または音声 | 翻訳され音声化されたメディア | YouTubeローカライズ、コース、映画、ポッドキャスト |
| 音声から音声 | 録音された音声 | 変換または翻訳された音声 | 音声変換、多言語制作 |
選択のルールは単純明快です。すでにスクリプトがあるなら、テキスト読み上げがたいてい最もシンプルな道です。文字起こしが必要な録音があるなら、音声認識(文字起こし)が必要です。複数の言語にわたって同じプレゼンターのアイデンティティを保ちたいなら、ボイスクローニングや吹き替えがより適しています。TTS側だけに絞った解説については、テキスト読み上げAPIとは何かに関する姉妹ガイドが合成パイプラインをより深く掘り下げています。
注目に値する区別:ボイスクローニングはボイスチェンジャーではありません。ボイスチェンジャーは既存のパフォーマンスをその場で変換しますが、クローニングはテキストや他の制御された入力から新しい音声を生成する再利用可能な音声モデルを作成します。
リクエストがパイプラインをどう通過するか
実装はさまざまですが、ほとんどの音声APIは同じ4つの段階に従います。フローの形を理解しておくと、予期しないステータスが返ってきたときに何時間もの推測を省けます。
まず、アプリケーションが認証します。リクエストヘッダーにAPIキーまたはベアラートークンを送信します。たとえばDubSmartのTTS APIは、ベースURL https://dubsmart.ai/api/v1 に対して、ベアラートークン認証とJSONリクエストを使用するRESTエンドポイントを使います。聞こえる以上に重要なルール:プライベートキーをブラウザ側のJavaScriptや配布されるモバイルアプリに決して置かないこと。セキュアなサーバーに保管し、クライアントにそのサーバーを呼び出させます。
次に、アプリケーションがコンテンツと設定を送信します。リクエストは通常、テキストまたはファイル参照、ソース言語と対象言語、音声ID、速度やピッチ、話者情報、出力設定、プロジェクトメタデータなどを組み合わせて含みます。単純なTTSでは、コンテンツはテキストです。吹き替えでは、APIはまず動画のアップロードを必要とし、その後プロジェクトを作成するための別のリクエストを必要とすることがよくあります。
3番目に、サービスがコンテンツを処理します。タスクに応じて、テキストの正規化と解釈、発音と韻律の予測、話された内容の翻訳、話者の分離や背景音声からの音声の分離、標準またはカスタム音声での音声生成、結果の動画タイムラインへの同期などを意味します。長いジョブは非同期で実行されます。完成したファイルを返す代わりに、APIはプロジェクトIDを返します。
4番目に、アプリケーションが結果を取得します。音声または動画のURL、個別のセグメントURL、文字起こし、翻訳されたテキスト、タイミングデータ、ステータスまたはエラーフィールドなどです。DubSmartのTTS APIは、pending、processing、completed、failed などのプロジェクト状態を文書化しており、完了したプロジェクトはプロジェクトレベルまたはセグメントレベルでMP3 URLを返すことができます。
同期 vs 非同期:構築を左右する違い
APIがどのように結果を返すかによって、その周りの設計方法が決まります。したがって、統合コードを書く前にこれを決めましょう。
同期APIは、処理が完了するまでリクエストを開いたままにし、その後結果を返します。これは短いテキスト、簡単な音声プロンプト、小さな音声スニペット、そしてインタラクティブで低遅延な機能にうまく機能します。その弱点は、長いジョブがリクエストのタイムアウトを超える可能性があることです。
非同期APIは、すぐにプロジェクトまたはジョブIDを返します。その後、アプリケーションはステータスエンドポイントをポーリングするか、ジョブが完了したときにWebhookを受け取ります。このモデルは、長いナレーション、動画吹き替え、複数の対象言語、バッチ生成、大きなファイルに適しています。DubSmartの文書化されたTTSと吹き替えのワークフローは、プロジェクト状態と結果取得を使用しており、これはメディアジョブ向けに作られた非同期パターンです。
選択肢を評価する際は、Webhookをサポートしているか確認しましょう。数秒ごとのポーリングは実装が簡単ですが、Webhookは不要なリクエストを削減し、一度に多くのジョブを実行するようになるとよりうまくスケールします。
決定する前に評価すべきこと
適切なAPIはジョブ次第ですが、ほぼすべてのプロジェクトに当てはまる少数の基準があります。短いデモを信頼するのではなく、意図的にこれらを確認してください。
機能の適合性。 APIが正確なタスク(テキスト読み上げ、音声認識、ボイスクローニング、吹き替え、複数話者、音声のみまたは動画出力、リアルタイムまたはバッチ)をサポートしていることを確認します。「音声AI」として宣伝されているものがこれらすべてを含むと仮定してはいけません。
言語カバレッジ。 ソース言語と対象言語の両方を確認します。「30言語をサポート」は、30のTTS音声、30の翻訳対象、または言語と方言の組み合わせを意味するかもしれません。多言語チャンネルの場合、アクセントの品質、名前や場所の発音、地域的な語彙、言語ごとの音声の利用可能性、そして1つのクローン音声が複数の言語にわたって通用するかどうかも考慮してください。
出力とメディアのサポート。 音声フォーマット、動画コンテナ、サンプルレートとビットレート、セグメントレベルのダウンロード、完全にレンダリングされた動画、文字起こしまたは字幕の利用可能性、最大ファイルサイズを確認します。これらは編集ワークフローとストレージコストを左右します。
品質と制御性。 自然なポーズ、正しい発音、安定した音量、一貫した話者のアイデンティティ、適切な強調、正確なタイミングに耳を傾けます。音声は10秒のサンプルでは完璧に聞こえても、専門用語、長い段落、数字、珍しい名前でつまずくことがあります。ベンダーが選び抜いたクリップではなく、代表的なコンテンツをテストしてください。
レイテンシとスループット。 実際のワークロードに対して時間を測定します。短いナレーション1つと、何百ものローカライズされた動画は異なる問題です。処理がリアルタイムか非同期か、レート制限は何か、ジョブが並行して実行されるか、優先処理が存在するか、失敗がどのように再試行されるかを尋ねてください。DubSmartは、典型的な5分の動画の処理に約1分かかると述べており、タイミングは長さとファイルサイズに依存すると注記しています。
料金モデル。 音声APIは、文字数、単語数、音声または動画の長さ、クレジット、リクエスト、ストレージ、または同時ジョブで課金される場合があります。吹き替えでは、対象言語の数が実効コストを倍増させます。最初の呼び出しだけでなく、再試行、再生成されたセグメント、翻訳レビュー、ストレージを含む完全なワークフローを計算してください。音声AI APIの料金に関する当社の分析では、クレジットの計算を詳しく解説しています。
早期に管理すべきリスク
音声AIは、通常のメディアツールには存在しない障害モードをもたらします。設計段階でそれらに対処するほうが、公の失敗の後よりもはるかに安く済みます。
無許可の音声使用。 許可なく人の声をクローンすることは、法的、倫理的、評判上のリスクを生みます。録音の所有者が誰か、何を生成してよいか、どこで音声を使用してよいか、商用利用が許可されているか、音声をどのように削除するか、契約終了時に何が起こるかを明記した書面による同意プロセスを使用してください。
不正確な翻訳または発音。 生成された音声は、名前、略語、住所、業界用語を誤って扱うことがあります。公開向けコンテンツには人間のレビューを組み込んでください。翻訳スクリプトの読み上げ、ネイティブスピーカーによる試聴、発音のスポットチェック、タイミングと口の動きのパス、エクスポートされたメディアの最終レビューなどです。
なりすましと詐欺。 合成音声は詐欺や虚偽の推薦に悪用される可能性があります。実在の人物が言っていないことを言ったと合理的な聞き手に信じさせる可能性のあるものは生成しないでください。機密性の高いコミュニケーションには、開示、承認管理、監査ログを追加してください。
音声とデータのプライバシー。 サンプルには個人データが含まれている可能性があります。アップロードする前に、同意、保持ルール、アクセス制限、削除手順、ベンダーのデータ処理条件、二次利用ポリシーを定めてください。DubSmartは、アップロードされたクローニングファイルは暗号化され、ユーザーがカスタム音声と関連する音声データを削除できると述べていますが、チームは依然として特定のプランの現在の条件と管理を確認すべきです。
ベンダーとモデルの変更。 音声ID、言語サポート、出力フォーマット、レート制限は変わる可能性があります。APIを外部依存として扱ってください。可能な場所では設定を固定し、ソーススクリプトを保存し、承認された音声を保存し、エラー率を監視し、フォールバックワークフローを維持し、大きなベンダー更新後に再テストしてください。可動部分を減らしたいチームには、オールインワンAI動画ツールに関する当社の概説が、これらの機能を統合することのトレードオフを説明しています。
APIが手動ワークフローに勝る場合
音声AI APIは、再現可能でプログラム的な制作が必要なときに、その統合コストに見合う価値があります。クリエイターがすべての動画のローカライズ版を公開する場合、小規模ビジネスが複数言語で製品ナレーションを生成する場合、eラーニング企業が何百ものレッスンを更新する場合、ポッドキャストが翻訳版を出荷する場合、ソフトウェア製品が音声アクセシビリティを追加する場合、エージェンシーが音声生成をコンテンツ管理システムに組み込む場合に、強く適合します。
手動のスタジオワークフローが特定のケースで依然として勝る場合もあります。プロジェクトが非常にニュアンスのある人間のパフォーマンスにかかっている場合、法的承認がプロの俳優を必要とする場合、コンテンツが機密性の高い主張を含む場合、1回限りの録音が統合を構築するより速い場合、または結果が多くの芸術的ディレクションを必要とする場合などです。要点は、すべての人間の声を置き換えることではありません。一貫性、速度、規模、または多言語出力が最も重要な部分を自動化することです。
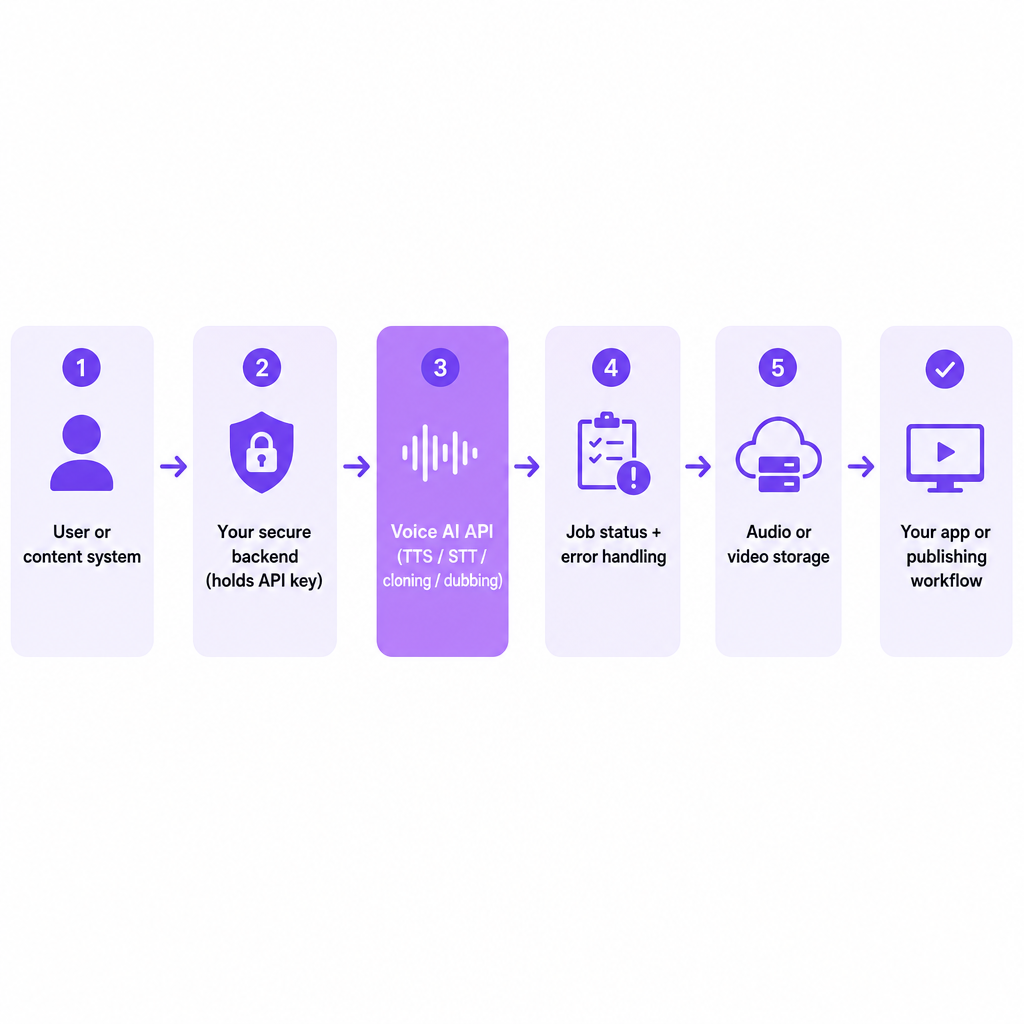
小規模な構築では、アーキテクチャをシンプルに保ってください。セキュアなバックエンドが、ユーザーまたはコンテンツシステムと音声APIの間に位置します。そのバックエンドは、認証情報を非公開に保ち、入力を検証し、プロジェクトを作成し、ジョブIDを保存し、ステータスをポーリングまたはWebhookを受信し、一時的な失敗を再試行し、結果URLとメタデータを保存し、使用制限を適用し、クローンされた音声の同意を記録します。クリエイター向けのバージョンは、完成した英語の動画を受け入れ、選択された言語の吹き替えエンドポイントに送信し、完了を待ち、結果をレビューフォルダーに振り分け、承認後にのみ公開するかもしれません。
DubSmartの位置づけ
当社はいくつかの音声関連のAPI機能を1つのAIメディアプラットフォームに統合しています。これは、各ジョブを手作業で実行するのではなく、生成とローカライズを既存のワークフローに接続したいときに最も重要になります。
当社のText to Speech APIは、ニューラル音声、ボイスクローニング、多言語サポート、プロジェクトステータス追跡、MP3結果を備えたプログラム的な音声生成を提供します。そのリクエスト例では、音声ID、言語、速度、ピッチを持つテキストセグメントを使用します。当社のVoice Cloning APIは3ステップのパターンに従います。事前署名されたアップロードURLをリクエストし、音声サンプルをアップロードし、その後アップロードされたファイルキーからカスタム音声を作成します。MP3、WAV、AAC、M4A、FLACを受け入れ、より良い結果のために少なくとも20秒のクリーンな音声を推奨します。当社のAI Dubbing APIは、多言語プロジェクト作成、話者設定、翻訳されたセグメント、ダウンロード可能な吹き替え出力を備えた動画ローカライズを扱い、MP4、MOV、AVI、MKV、WebMなどの入力を最大5GBまで受け入れます。
どのエンドポイントから始めるべきか迷っている場合は、コンテンツに合わせてください。スクリプト化されたナレーションはTTSを指し、許可された定期的な音声はクローニングを指し、多言語動画は吹き替えを指します。
よくある質問
音声AI APIとは簡単に言うと何ですか?
それは、ソフトウェアが独自のAI音声システムを構築することなく、音声を生成、認識、クローン、翻訳、変換できるようにする接続です。アプリがリクエストを送信し、処理された音声、テキスト、または動画を受け取ります。
音声AI APIはテキスト読み上げと同じですか?
いいえ。テキスト読み上げは音声AI APIの1つのタイプです。このカテゴリーには、音声認識、ボイスクローニング、吹き替え、音声から音声への機能も含まれます。
使用するにはコーディング経験が必要ですか?
通常はある程度必要です。APIには認証、HTTPリクエスト、JSON、ファイルアップロード、ステータス処理が関係するからです。たまの手動ジョブには、ノーコードのウェブアプリのほうが簡単なことが多いです。
音声AI APIはYouTube動画を翻訳できますか?
吹き替えAPIは、必要なソース言語と対象言語、ファイルフォーマット、出力ワークフローをサポートしていれば、動画を翻訳して新しい音声を生成できます。公開する前に結果をレビューしてください。
誰の声でもクローンできますか?
技術的に可能であることは、法的または倫理的に許可されていることと同じではありません。適切な許可がある場合にのみ音声をクローンし、プロバイダーのルール、契約、適用されるプライバシーおよびパブリシティの要件に従ってください。