スピーチセパレーターは、雑然とした録音から話し声を取り出すために使われます。交通音、音楽、部屋の反響、あるいは別の人の話し声から引き離し、文字起こし、編集、吹き替え、再利用ができるよりクリーンな音声トラックを手に入れることができます。この単一の仕事は、意外なほど多くの日常的な制作業務の土台になっています。YouTuberはインタビューから街のノイズを取り除きます。ポッドキャストのプロデューサーは、賑やかなカフェで録音した対話を救い出します。マーケティングチームは、音声をクローン化する前にクリーンなサンプルを用意します。このツールは一つのことを上手にこなし、それが正確に何であるかを理解することで、本来作られていない仕事を頼んでしまうのを防げます。
これは創造のレイヤーというより、クリーンアップのレイヤーと考えてください。翻訳はしませんし、新しいナレーションを生成することもなく、話者を偽装することもありません。すでにスピーチを含む音声を受け取り、その周囲の干渉を減らしたスピーチを返します。以下では、それが実際にどこで役立つのか、基盤となるモデルが問題にどうアプローチするのか、そしていつ別のツールに手を伸ばすべきかを順を追って説明します。
目次
スピーチセパレーターの実際の仕組み
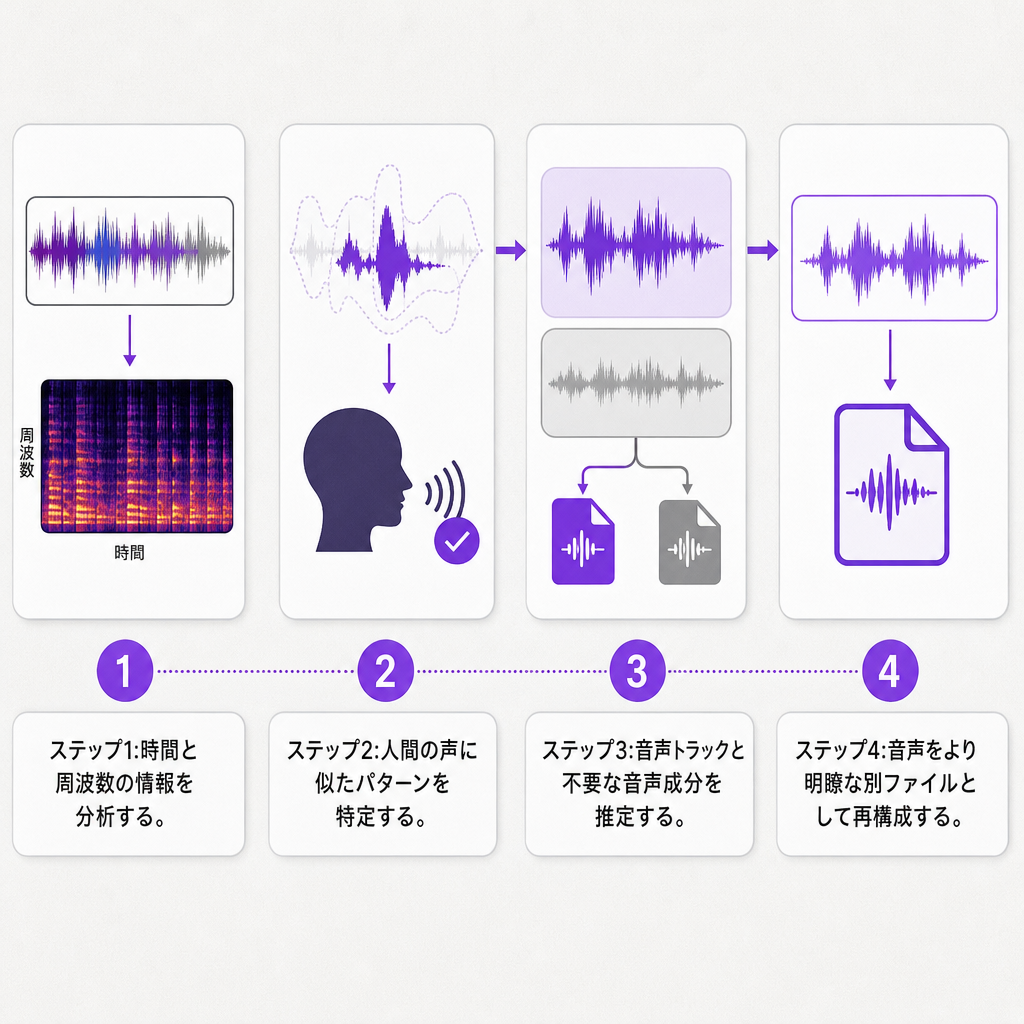
ボタンの下にあるのは、人間のスピーチを特徴づけるパターンを認識し、それをミックス内の他のすべてと区別するように訓練されたAIモデルです。録音の時間と周波数の情報を読み取り、信号のどの部分が音声でどの部分が不要な音かを推定し、スピーチを別個のよりクリーンなファイルとして再構築します。多くのシステムはマスクベースのアプローチを使います。信号のうちスピーチに関連する部分を通過させ、他の要素を低減するのです。より高度なパイプラインは、ノイズ抑制、話者分離、残響除去を組み合わせて積み重ねます。Microsoftの研究は、これらの段階を組み合わせて複数の話者をノイズと残響から引き出すリアルタイムのシングルチャンネルシステムについて説明しています。
重要な注意点は再構築という言葉にあります。出力は、本来録れていればよかったと思うオリジナルのクリーンな録音ではありません。それは干渉が取り除かれた状態でスピーチがどう聞こえるべきかというAIの推定であり、複雑な混合物はアーティファクト(金属的な音、脱落した子音、ワーブリング、不自然な遷移)を生み出すことがあります。実世界の録音に関するスピーチ分離の研究が記録しているように、現実的な遠距離かつ残響のある条件でもパフォーマンスは低下します。マイクが話者から離れ、部屋の反響が大きいほど、モデルの仕事は難しくなります。
分離とノイズ除去の違い:ラベルが重要な理由
これらの用語は互換的に使われますが、あなたが実際に必要とするタスクによって、どのツールが適合するかが変わります。ノイズ除去は不要な背景音を下げます。スピーチ強調は既存の声を聞き取りやすくします。スピーチ分離は、本当に混合された信号から声を取り出します。話者分離はさらに一歩進んで、2人が同時に話すときに別個のトラックを生成しようとします。そしてボーカル分離は音楽のステムを分割するもので、対話ではなく楽曲を対象とした別の分野です。
| タスク | 主な目的 | 例 |
|---|---|---|
| ノイズ除去 | 不要な背景音を低減する | 交通音やエアコンのうなりを下げる |
| スピーチ強調 | スピーチの明瞭度を改善する | 静かなインタビューを聞き取りやすくする |
| スピーチ分離 | 混合信号からスピーチを抽出する | 音楽や環境音から対話を分離する |
| 話者分離 | 各話者に別個のトラックを与える | 同時に話す2人を分割する |
| ボーカル分離 | 音楽要素をステムに分割する | インストゥルメンタルからボーカルを抽出する |
当社のスピーチセパレーターは、その表の中でもスピーチ分離と背景ノイズ除去の側に位置します。その仕事は、よりクリーンな音声トラックを提供することであり、製品ページには映画、ポッドキャスト、インタビュー、ボイスオーバー、音声クローンの準備が、このツールが中心とするワークフローとして挙げられています。MP3、WAV、AACなどの一般的な音声形式に加え、動画ファイルも受け付けます。どの列にいるかを知っておくことで、音声からノイズを取り除くクリーンアップ用に調整されたツールに話者ごとのステムを期待してしまうのを防げます。
人々がスピーチセパレーターを使う8つの仕事
これらのユースケースは重なり合いますが、それぞれが少しずつ異なる問題を解決します。これらを別々の仕事として読むことで、分離が最初の正しい一手なのか、それともチェーンのより早い段階に別のツールが属するのかを判断しやすくなります。
インタビュー録音のクリーンアップ。 インタビューが音響処理された部屋で行われることはめったにありません。オフィス、街路、イベント、家庭、すべてがテイクに音を漏らします。分離はその妨害を減らし、編集、キャプション付け、吹き替えの前に対象者を聞き取りやすくします。できないのは、まったく録れていなかったスピーチを作り出すことです。マイクが遠すぎたり、大きなバンドが声を埋め尽くしたりしていれば、回復できるクリーンなものが何もない場合があります。
ポッドキャスト音声の改善。 キーボードのカタカタ音、ファン、ヒス、部屋の反響、これらすべてが会話を混み合わせます。よりクリーンなトラックは後の作業を楽にします。間を切り詰める、話者のバランスを取る、クリップを切り出す、ショーノートを書く、といった作業です。複数人が同時に話す場合、結果はオーバーラップの量に大きく依存し、オーバーラップした話者向けに調整されたモデルは独自の処理アーティファクトを生み出すことがあります。
音声認識用の音声準備。 文字起こしエンジンは、言葉が明瞭で干渉が少ないときに最高の仕事をします。先に分離を実行することで、文字起こし、字幕、キャプションのパスが改善されることがよくあります。当社のSpeech to Textツールは音声と動画を文字起こしし、複数言語の字幕を生成しますが、その精度は依然として音声品質、アクセント、録音条件によって変動します。分離は保証ではなく準備ステップとして扱ってください。場合によっては強調のアーティファクトが実際に認識精度を低下させることがあるため、重要なものについてはクリーンアップしたトラックとオリジナルを比較する価値があります。
動画ポストプロダクション用の対話クリーンアップ。 編集者は日常的に風、交通音、うなり、マイクの取り扱い音、背景音楽からのブリードと戦っています。使える対話トラックは、その後エフェクトや差し替えのボイスオーバーとリミックスでき、その結果からそのシーンがポストで救えるのか、新たに録音し直す必要があるのかが分かることがよくあります。積極的な処理は自然なルームトーンを剥ぎ取ることがあるため、プロのリリースには依然として編集者の耳が必要です。
音声クローン入力の改善。 クローンモデルはサンプルから話者の特徴を学習しますが、ノイズ、音楽、反響はそれを難しくします。よりクリーンな入力はより良い結果を生み出す傾向があり、これがスピーチセパレーターのページでクローンの準備ステップとして分離を紹介している理由です。これは、唯一のサンプルが音楽入りの動画、電話録音、ライブ配信から来ている場合に最も重要になります。サンプルは法的かつ倫理的に使用可能でなければなりません。所有している音声、または処理の許可を得た音声のみをアップロードし、クローンを作成または展開する前に話者の同意を得てください。
より明瞭なボイスオーバーの作成。 録り直しが不便だが、ナレーションのテイクに中程度のノイズがある場合、分離はそれを十分にクリーンにして動画に重ねたり、音楽と組み合わせたり、ショートフォームに切り出したりできます。新しいナレーションを生成することはありません。テイクが本当に使い物にならない場合は、テキスト読み上げや音声クローンのルートの方が適しています。
ローカライズと吹き替えのサポート。 動画を翻訳する前に、背景を保持またはリミックスしながら文字起こし、キャプション付け、吹き替えができるよう、クリーンな対話トラックが欲しいことがよくあります。コンテンツのローカライズのためにAI吹き替えも提供していますが、分離と吹き替えは異なる仕事をします。分離はソース音声をクリーンにし、吹き替えは別の言語でスピーチを生成します。
ノイズの多いアーカイブからのスピーチ回復。 古い映像、ウェビナー、録画された会議、ユーザー生成クリップは、理解や大まかな文字起こしに十分なほど明瞭になることがあります。法的、医療、金融、またはコンプライアンスに敏感な資料については、AI処理が単語を変更または脱落させることがあるため、出力をオリジナルと照合してください。
使うべき場合と録り直すべき場合
分離が力を発揮するのは、声は存在するが中程度の干渉でマスクされている場合、編集のためによりクリーンな対話トラックが必要な場合、文字起こしやクローンの前に入力を改善している場合、あるいは録り直しが単に現実的でない場合です。共通するのは、回復可能なスピーチがファイル内に存在するということです。
苦戦するのは、声が非常に小さいか聞き取れない場合、複数人が連続して同時に話す場合、音楽が声を完全にマスクしている場合、あるいは録音がひどい反響や歪みを帯びている場合です。また、フォレンジックレベルや放送レベルの修復が必要な場合、あるいは正確な一字一句の精度が不可欠で誰も結果を確認しない場合には、適切でないツールです。干渉が深刻なほど、可聴アーティファクトの可能性が高まります。そしてマイク距離、残響、複数話者といった実世界の要因はすべて分離性能を低下させます。オリジナルのテイクが歪んでいたり埋もれていたりする場合、通常は救い出せる何よりも新たな録音の方が自然に聞こえます。
導入前にスピーチセパレーターを評価する方法
クリーンなデモクリップではなく、修正したい特定の録音に対してツールを選んでください。いくつかの基準が、良い適合と苛立たしい適合を分けます。
- 分離の種類。 ノイズからスピーチを、音楽から対話を、ある話者を別の話者から、あるいはインストゥルメンタルからボーカルを取り出す必要があるかを決めてください。スピーチ分離用に作られたツールは、会話内のすべての声に対して別個のトラックを生成しないかもしれません。
- 入力形式と制限。 ツールがあなたのソースファイルを受け付けるか確認してください。当社のスピーチセパレーターはMP3、WAV、AAC、動画ファイルをサポートしています。それでも大規模プロジェクトの前には最大ファイルサイズとエクスポート形式を確認してください。
- 実際の条件下での音声品質。 プロジェクトの中で最悪の背景を含むサンプルをテストし、最も簡単なケースではなく最も難しいケースでツールを判断してください。
- 出力アーティファクト。 金属的な音、欠落した子音、途切れた音節、音楽のブリード、オーバーラップするスピーチ中のワーブリングに耳を傾けてください。重要なコンテンツについては、処理された出力をオリジナルと比較し、文字起こしを手作業で確認してください。
- ワークフローの互換性。 次のステップが何を必要とするか確認してください。文字起こしが続く場合は、出力が使用可能な形式でダウンロードされることを確認してください。クローンや吹き替えが続く場合は、無意味な変換なしにファイルが移行できることを確認してください。
- プライバシーと同意。 音声には個人データや識別可能な声が含まれる場合があります。それをアップロードして処理する許可があることを確認し、クリーンアップされたサンプルは声を再現しやすくするため、クローンサンプルは特に慎重に扱ってください。
分離がDubSmartのローカライズワークフローにどう組み込まれるか
分離が単独で機能することはめったにありません。それはより長いチェーンの最前列にあるクリーンアップレイヤーであり、周囲のツールがどれだけの価値を加えるかを決めます。インタビューをローカライズするクリエイターにとって、理にかなった順序は次のようになります。
- スピーチセパレーターを実行して対話を分離・クリーンアップする。
- クリーンアップした音声を音声認識に送り、編集可能な文字起こしを得る。
- 名前、専門用語、数字、不明瞭な部分を確認する。
- 承認されたテキストを翻訳または適応させる。
- 適切な音声ワークフローを通じて吹き替えまたはナレーション音声を生成する。
- 最終音声をオリジナルと、意味、トーン、タイミングについて比較する。
このパターンは、YouTubeチャンネル、ポッドキャスト、オンラインコース、マーケティング動画、インディペンデント映画のいずれにも適しています。セパレーターは得意な一つの仕事をこなします。文字起こし、翻訳、編集、同意管理に取って代わるものではありません。これらの役割を明確に分けておくと、各ツールが公平な入力を得て、完成した結果がしっかりしたものになります。
よくある質問
スピーチセパレーターは背景音楽を除去できますか?
背景音楽からスピーチを低減または分離できますが、結果は音楽がどれだけ大きく、複雑で、声に似ているかによります。出力に頼る前に、音楽のブリードとスピーチのアーティファクトに必ず耳を傾けてください。
スピーチ分離は文字起こしを改善できますか?
通常はできます。干渉をクリーンにすることで、文字起こしエンジンがスピーチを読み取りやすくなります。しかし、強調が時折精度を損なうアーティファクトを持ち込むことがあるため、重要な文字起こしには依然として人間による確認パスが必要です。
音声クローンの前にスピーチセパレーターを使えますか?
はい。よりクリーンなサンプルはクローンモデルにより良い入力を与えます。所有している音声、または処理の許可を得た音声のみを使用し、クローンを作成または展開する前に話者の同意を得てください。
同時に話す2人を分離しますか?
一部のスピーチ分離システムはこれを試みますが、オーバーラップする話者は通常のノイズ除去よりはるかに難しいものです。結果は、マイク品質、話者の類似性、部屋の反響、声がどれだけオーバーラップするかによって変動します。
スピーチセパレーターはボイスチェンジャーと同じですか?
いいえ。セパレーターはすでに存在するスピーチをクリーンにするか分離します。ボイスチェンジャーは話者の声のアイデンティティを変換します。分離はまた、音声認識、テキスト読み上げ、音声クローン、AI吹き替えとも異なります。これらは異なる問題を解決する関連ツールです。