マイクが交通音、カフェのざわめき、あるいはセリフの真上に乗った音楽を拾ってしまった場合、問題は録音が使えるかどうかではなく、どうやって音声だけをきれいに取り出すかということです。それこそがスピーチセパレーターの役割です。平たく言えば、スピーチセパレーターとは、録音の中から人間の音声を、それ以外のすべて——背景ノイズ、音楽、その他の音——から分離するAI搭載のオーディオツールであり、書き起こし、吹き替え、クローン化、リミックスに使えるクリーンな音声トラックを手に入れられます。多言語コンテンツを制作するすべての人にとって、そのクリーンなトラックは、プロフェッショナルに聞こえる吹き替えと「まあまあ」に聞こえる吹き替えとの違いを生みます。
このガイドでは、スピーチセパレーターが実際に何であるか、その内部でどのように動作するか、本当に必要になるのはどんなときか、そしてツールを導入する前に何を検討すべきかを説明します。私たちがSpeech SeparatorをDubSmart AIのワークフローに組み込んでいるのは、まさにクリーンな音声こそが他のすべての土台になるからです。
目次
スピーチセパレーターとは本当は何か
オーディオ研究において、スピーチ分離とは、混合された録音の中から対象の音声を背景の干渉から分離するタスクとして定義されます。より高度なシステムはさらに進んで、複数の話者を互いに分離し、それぞれの声について独立したトラックを生成します。
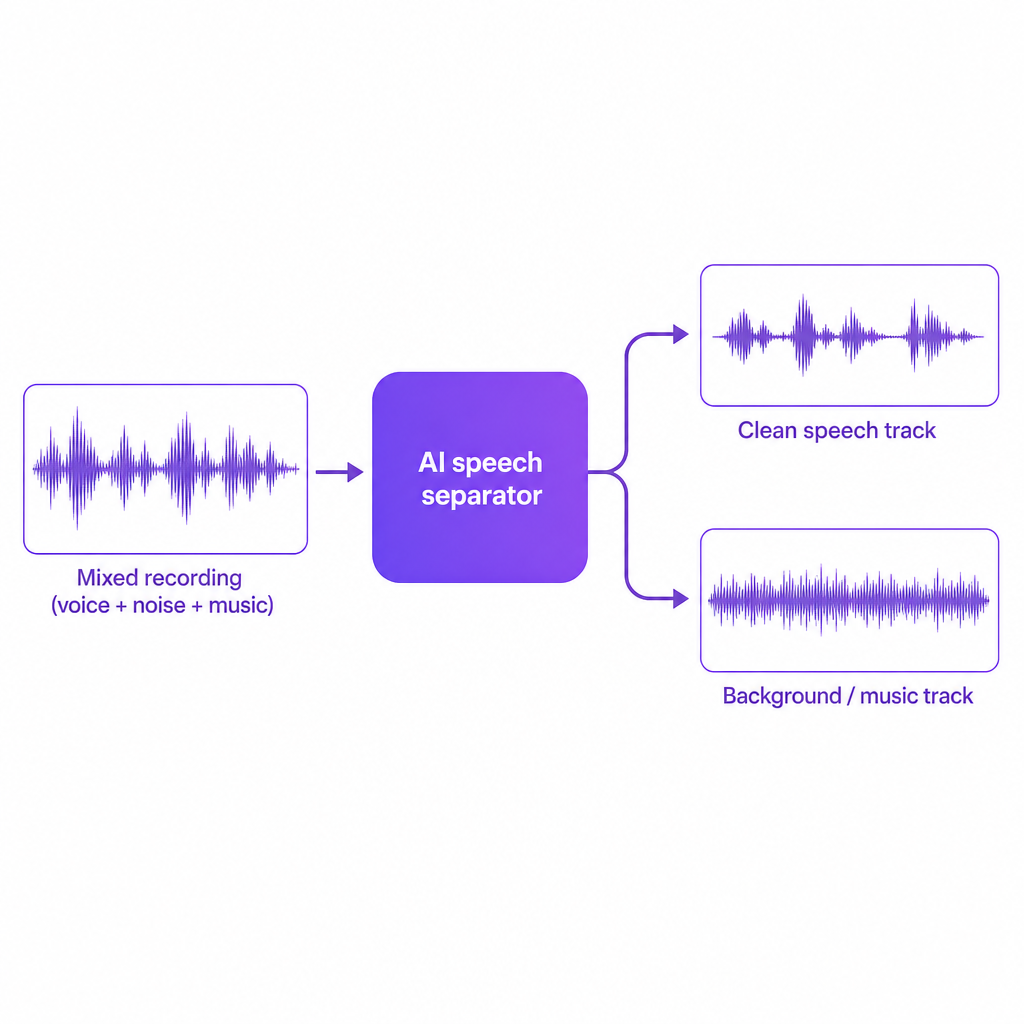
日常の制作作業に置き換えると、スピーチセパレーターは混合されたオーディオファイル——セリフとノイズや音楽——を受け取り、音声のみを含む1つまたは複数のトラックと、残りの背景オーディオを保持するオプションのトラックを出力します。私たちのSpeech Separatorは、あらゆる録音から背景ノイズを除去し音声を分離するように作られており、映画、ポッドキャスト、インタビューのポストプロダクションに非常に適しています。オーディオファイルとビデオファイルの両方で動作します。ノイズの多い環境の録音をノイズ除去したり、ボーカルをバッキングトラックから分離したりして、最終的に音声と背景の個別のステムを得ることができます。
ここでよくある誤解が人々を混乱させます。スピーチセパレーターは従来のノイズリダクションと同じものではありません。ノイズリダクションは不要な音の音量を下げます。スピーチセパレーターは信号の中で音声が存在する場所を能動的に特定し、それを別の、よりクリーンなストリームとして再構築します。この違いこそが、セパレーターが音楽の下に埋もれた声を救い出せる一方で、ノイズゲートはほとんど録音全体を静かにするだけである理由です。
あなたに本当に必要か?
本当の判断ポイントは、あなたの作業が、マイクがたまたま拾ったものではなく、信頼できるクリーンな音声オーディオに依存しているかどうかです。もしそうなら、専用のセパレーターは「あれば便利」なものではなくなり、基礎的なステップになります。
いくつかの状況では、そのアップグレードが明白になります。YouTubeクリエイターや小規模ビジネスは、反響のある部屋、カフェ、路上で録音された古い映像を再利用することが多く、そこではノイズによって音声が聞き取りにくく、書き起こしも難しくなります。eラーニングやトレーニングチームは、ライブのウェビナーや講義から多言語コースを構築しますが、そこでは下流のすべての書き起こしと吹き替えが元の音声の品質を受け継ぎます。映画製作者やポッドキャストプロデューサーは、不完全な条件で収録された素晴らしいパフォーマンスを、音楽やサウンドデザインと再ミックスする前に救い出す必要が頻繁にあります。そして、ユーザーオーディオを書き起こし、ボイスクローン、吹き替えのパイプラインに供給する開発者やエージェンシーは、ノイズの多い入力がモデルの精度を直接的に低下させることを知っています。
いくつかの具体的なきっかけが、セパレーターを導入する価値があることを示しています:
- 複数の言語にローカライズしていて、一貫した明瞭な吹き替えと字幕を求めている場合。クリーンな音声は、私たちのAI吹き替えや音声文字起こしエンジンに、ノイズの多いミックスよりもはるかに確実に供給されます。
- ブランドやキャラクターの声のためにボイスクローンを利用していて、ノイズ除去されアーティファクトのないサンプルで学習させることで最良の結果を得たい場合。
- 自分でコントロールできなかったユーザー生成録音やフィールド録音を定期的に受け取り、それでも放送準備が整った状態にする必要がある場合。セパレーターは、すべてのファイルを手作業で調整する代わりに、繰り返し可能なクリーンアップ段階を提供します。
正直な例外:オーディオがすでに音響処理されたスタジオで、セリフと音楽が別々のステムとして録音されている場合、セパレーターは必須ではなく利便性のためのものです。現実の音を扱う他のすべての人にとっては、パイプラインの中に恒久的な位置を得ることになります。
スピーチ分離の内部での仕組み
現代のスピーチ分離は、単純なEQやフィルターではなく、ディープラーニングとソース分離の研究の上に構築されています。基本となるタスクは、述べるのは簡単で、解くのは難しいものです。複数のソースを含む混合信号が与えられたとき、それらを事前に知らずに個々の音声信号を復元するというものです。
現在のほとんどのシステムは、エンコーダー・セパレーター・推定器・デコーダーというパイプラインに従っています。エンコーダーは、生の波形やスペクトログラムを、フォルマントや倍音のような音声関連のパターンが検出しやすくなる高次元の特徴空間にマッピングします。セパレーター——ニューラルネットワーク——はそれらの特徴を処理し、音声対ノイズであれ、ある話者対別の話者であれ、異なる音源に属する情報を切り離すことを学習します。推定段階では、非音声成分をフィルタリングするマスクを予測するか、各音源の特徴表現を直接推定します。最後に、デコーダーがそれらの分離された表現を時間領域のオーディオに変換し、1つまたは複数のクリーンな音声トラックと、オプションで残余の背景トラックを生成します。
これらのモデルは、音声とノイズの混合で満たされた大規模なデータセットで学習され、ラベル付けされた例から音声、話者、干渉の識別パターンを学びます。より新しい研究では、セパレーターを話者埋め込みやプロンプトで条件づけしており、混雑したオーディオの中の特定の声に分離を狙いを定めることが可能になります。
クリエイターにとっての実用的な要点は、現代のセパレーターは大げさなノイズゲートではないということです。それは、多くの条件にわたって音声がどのように見え、どのように聞こえるかを学習したモデルであり、音楽、群衆のノイズ、部屋の反響の下に埋もれていても声を再構築できます。
主な2つの分離タスク
実際には、スピーチ分離の2つのタイプに出会うことになり、プラットフォームはしばしばそれらを組み合わせます。
1つ目は、単一話者の音声対背景です。ノイズ、音楽、環境音から1つの一貫した音声トラックを抽出します。これは私たちのSpeech Separatorが映画、ポッドキャスト、インタビューのために中心に据えているタスクであり、ほとんどのクリエイターが日々必要とするものに直接対応するからです。
2つ目は複数話者の分離で、システムが会話の各話者について別々のトラックを生成します。これは、誰が言ったかが何を言ったかと同じくらい重要となる長時間の会議やパネルディスカッションにおける話者ダイアライゼーションや分析に特に役立ちます。
コンシューマー向けツールは、これらをシンプルなインターフェースにまとめる傾向があります——曲をアップロードしてボーカルとインストゥルメンタルの別々のトラックを得たり、編集のためにビデオ内のセリフを分離したりします。私たちの実装は、音声対背景の分離を重視しています。それは吹き替え、書き起こし、クローンのワークフローにとって最も即座に価値のあるタスクだからです。
セパレーターを選ぶ前に検討すべきこと
セパレーターがプロフェッショナルなニーズを満たすかどうかを評価する際、マーケティングの文言よりも重要な、いくつかの基準があります。
まず音声品質とアーティファクトから始めましょう。優れたセパレーターは、声を金属的に、水中のように、あるいは位相のずれたように聞こえさせるのではなく、声の自然な音色を保ちます。そして、音楽のような強い背景要素を取り除く際に、ミュージカルノイズや耳障りな歪みを持ち込むことを避けます。学術的な調査では、残留干渉とアーティファクトが主要な課題として指摘されており、特に非定常ノイズにおいてそうです。最も信頼できるテストは、依然として自分自身の素材でサンプル出力を確認することです。
次は現実世界のノイズへの堅牢性です。クリーンなラボデータで学習されたモデルは、交通音、風、群衆のざわめき、反響のある部屋、そして音声が大きな音楽や効果音と重なるコンテンツに苦労することがあります。最先端の研究はまさにこれらの複雑な混合を対象としていますが、パフォーマンスは録音条件によって依然としてばらつきます——だからこそ、オフィスから路上、ホームスタジオまで、実際に録音する環境全体でテストしてください。
音楽と混合コンテンツの取り扱いは、頻繁に生じる具体的なニーズです。再吹き替えのためにサウンドトラックを取り除いたり、Bロールからナレーションを分離したりするには、音楽と音声の分離を明示的にサポートし、1つのくぐもった結果ではなく2つの使えるファイルを出力するツールが必要です。私たちの分離パイプラインは、ボーカル周波数を検出し、それを音楽から分離し、別々の高品質ファイルを生成します。1つはクリーンなボーカルで、もう1つは音楽ベッドです。これは、他の言語にリミックス、再スコアリング、再吹き替えする予定があるときに特に役立ちます。
下流ツールとの統合は、セパレーターが実際にどれだけの時間を節約するかを決定します。分離が単独で存在することはめったにありません——それは、よりクリーンな入力が単語誤り率を下げる書き起こしモデル、ノイズのないサンプルを歓迎するボイスクローンエンジン、そして元の音声を翻訳されたトラックと整合させる吹き替えシステムに供給されます。私たちのプラットフォームは、Speech Separator、音声文字起こし、テキスト読み上げ、ボイスクローン、AI吹き替えを1か所にまとめる統一されたワークフローを中心に構築されているため、1つのクリーンアップされた録音が、毎回パイプラインを再構築することなく、多言語で、クローンされた声の、完全にローカライズされたコンテンツになることができます。
レイテンシ、スケール、自動化は、バックログを抱えるすべての人にとって重要です。長時間のポッドキャスト、コース、アーカイブには、複数時間のファイルを扱うバッチ処理、妥当なファイルあたりの処理時間、そして分離があなた自身のシステムの中に組み込まれる自動化フックが必要です。私たちはテキスト読み上げ、ボイスクローン、AI吹き替えのAPIを提供しており、開発者は音声処理をエンドツーエンドのパイプラインに組み込むことができます。
最後に、オーディオがクリーンになってもプライバシーとコンプライアンスは消えません。音声を背景から分離しても、機密性のある会話を含む可能性のある録音に対するあなたの責任や、ライセンス素材から声を抽出して再利用する際に権利を尊重することは免除されません。エンタープライズチームは、データの保持と使用に関する明確なポリシーを確認し、あらゆる分離ワークフローを社内のコンプライアンスガイドラインに沿わせるべきです。
限界があるところ
スピーチセパレーターは録音を一変させることができますが、魔法ではありません。そうでないふりをすると、誤った判断につながります。
過剰なノイズ除去が最も一般的な落とし穴です。攻撃的な分離は、微妙な音声の手がかり——柔らかい子音、自然な部屋のトーン——を取り除いてしまい、声を不自然に、あるいは聞き疲れするものにしてしまう可能性があります。残留アーティファクトはその裏返しです。困難な条件では、モデルが音声トラックに音楽やノイズの痕跡を残したり、ミュージカルノイズを生成したりすることがあり、特に干渉が強く常に変化している場合にそうです。
また、考慮すべき話者と言語のバイアスもあります。特定の言語、アクセント、話し方に偏って学習されたモデルは、代表性の低い声ではパフォーマンスが劣ることがあります。そして、クリーンに見える波形は誤った安心感を生み出す可能性があります。それは、法医学的分析や厳格なコンプライアンスの文脈のような重要なタスクにオーディオが適していることを保証するものではありません。
クリエイティブやローカライズの作業においては、これらの限界は管理可能ですが、ベンダーのデモを信頼するのではなく、自分自身の素材の代表的なサンプルでテストすべきだという強い論拠になります。
私たちのワークフローの中のSpeech Separator
私たちはSpeech Separatorを、この技術の実用的でクリエイターに優しい実装として扱っており、後付けではなく、DubSmart AIプラットフォームの他の部分と緊密に統合されています。
使用時には、あらゆる録音から背景ノイズを除去し音声を分離して、映画、ポッドキャスト、インタビューのポストプロダクションに適したクリーンな声を生成します。混合トラックから明瞭なボーカルを抽出し、音声と背景音楽のための別々の高品質ファイルを生成するため、元のミックスと格闘することなく編集、再吹き替え、リミックスができます。オーディオとビデオの両方のソースで動作します——ファイルをアップロードするかリンクを使用し、それらをパイプラインで処理し、完成したトラックをダウンロードします。そして重要なことに、それらの出力は私たちの他のツールに供給されるように最適化されているため、1つのクリーンアップされた録音を、多言語で、クローンされた声の、完全にローカライズされたコンテンツに変えることができます。
YouTubeクリエイター、小規模ビジネス、トレーナー、映画製作者、ポッドキャスター、開発者チームにとって、その統合は分離自体の役割を変えます。それは孤立した「オーディオを修正する」作業であることをやめ、より大きな、自動化されたコンテンツ制作とローカライズのライフサイクルにおける最初の標準化されたステップになります。多言語チャンネルやコースライブラリを構築しているなら、そこでこそ本当の時間の節約が積み重なっていきます。
よくある質問
スピーチセパレーターとは、簡単に言うと何ですか?
これは、ノイズの多い混合された録音を受け取り、ほとんど人間の声だけが聞こえるトラックと、保持または破棄できるオプションの背景トラックを出力するAIツールです。
スピーチセパレーターはノイズリダクションと同じですか?
いいえ。ノイズリダクションは単に不要な音を下げるだけです。スピーチ分離は音声を明示的に別個のソースとして特定し再構築し、通常はより高い明瞭さと結果に対するより多くのコントロールを伴います。
スピーチセパレーターは複数の話者を扱えますか?
多くの研究レベルのシステムと一部の製品は、複数の話者を個別のトラックに分離できますが、品質は重なり具合や録音条件によってばらつきます。私たちのSpeech Separatorは、主に一般的なクリエイターのワークフローのために背景から音声を分離することに焦点を当てています。
スピーチセパレーターを使うと、吹き替えやボイスクローンの結果が改善しますか?
はい。よりクリーンな入力オーディオは、一般的に音声認識、整合、ボイスクローンの品質を向上させ、多言語吹き替えとクローンされた声をより自然で一貫したものにします。
スピーチ分離は言語に関係なく機能しますか?
ほとんどのセパレーターモデルはテキストではなく音響パターンで動作するため、多くの言語を扱うことができます。パフォーマンスは依然として、学習データとあなたのアクセントがどれだけよく代表されているかに依存します。