クリップにキャプションを読み上げる、あの平坦で少しロボットのようなナレーターの声は、ショート動画で最も認識されやすいサウンドの一つになりました。人々はそれを耳にした瞬間、自分がどんな種類のコンテンツを見ているのかを正確に理解します。もしあなたが、あの tiktok voice text to speech 効果を、他のあらゆる場所に投稿する動画に取り入れる信頼できる方法を探しているなら、朗報です。それを実現するために単一のアプリのエディタに縛られ続ける必要はありません。私たちの Text to Speech ツールを使えば、スクリプトを書き、望むトーンに合った声を選び、オーディオを生成し、それを TikTok、YouTube Shorts、Reels、あるいはあなたが公開するどこの映像にも同期させることができます。
これが重要な理由は、トレンドを真似するという枠を超えています。独特のナレーター声は、あなたのチャンネルのアイデンティティの一部です。一度認識されるようになれば、視聴者はすべてのプラットフォームであなたとその声を結びつけます。アプリの組み込みナレーターだけに頼ることの問題は、そのアプリ、その短い声のリスト、そしてそのルールに制限されてしまうことです。私たちは、あなたが気に入った同じ声があらゆる場所であなたのコンテンツに寄り添い、準備ができたときには他の言語にも展開できるよう、ワークフローを構築しました。
目次
- なぜ TikTok のナレーター声はストーリーテリングのツールになったのか
- 私たちの Text to Speech ツールで効果を再現する
- ボイスクローニングでストックボイスを超える
- 一つの声を言語やフォーマットを越えて運ぶ
- 私たちの API で TikTok スタイルのナレーションを自動化する
- あなたの道を選ぶ:ストックボイス、クローンボイス、それとも API
- よくある質問
なぜ TikTok のナレーター声はストーリーテリングのツールになったのか
組み込みナレーターは便利機能として始まりました。クリップにテキストを追加し、タップして音声に変換し、いくつかの声から選ぶと、アプリがあなたのキャプションを読み上げてくれます。ウェブ上のチュートリアルは初心者にまさにその手順を案内しています:テキストを追加し、それを長押しするか声のアイコンをタップし、ナレーターを選ぶ。このプロセスがとても簡単なため、クリエイターはコメディの一場面、ステップバイステップの解説、ストーリータイム投稿、製品の詳細解説にこれを取り入れました。
ユーティリティをトレンドに変えたのは反復です。何百万ものクリップが同じ中立的で均等なペースのナレーションを使うと、そのサウンドは特定のスタイルのコンテンツを表す略記号になります。視聴者はそれを機械の音として聞くのをやめ、ショートフォームのストーリーテリングの声として聞き始めます。その馴染み深さこそが、今や多くのクリエイターが公開するすべてのプラットフォームで同じ効果を望み、固定された声リストが許す以上のコントロールを望む理由です。
実用的な限界にはすぐに直面します。アプリの組み込みナレーターは短い声のメニューしか提供せず、すべてをその一つのアプリの中に留めます。動画を別のプラットフォーム向けに再利用すると、ナレーションを失うか、録り直すことになります。リストにない声が欲しくても、行き詰まります。そして同じアイデアを別の言語で公開する予定があっても、組み込みツールはあなたのナレーターを持ち運んではくれません。こうしたギャップこそ、専用の Text to Speech ワークフローがその価値を発揮する場所であり、一度ナレーションを生成すれば、投稿するどこでも再利用できるのです。
私たちの Text to Speech ツールで効果を再現する
私たちの Text to Speech ツールは、画面上のナレーター効果を直接再現する要素です。あるアプリにキャプションを打ち込んでそのナレーターが合うことを願う代わりに、スクリプトを貼り付け、300以上の自然な声のライブラリから選び、どんな動画にも入れられるクリーンなオーディオを生成します。出力はダウンロード可能なファイルなので、それは単一のプラットフォームのエディタではなく、あなたのプロジェクトに属します。
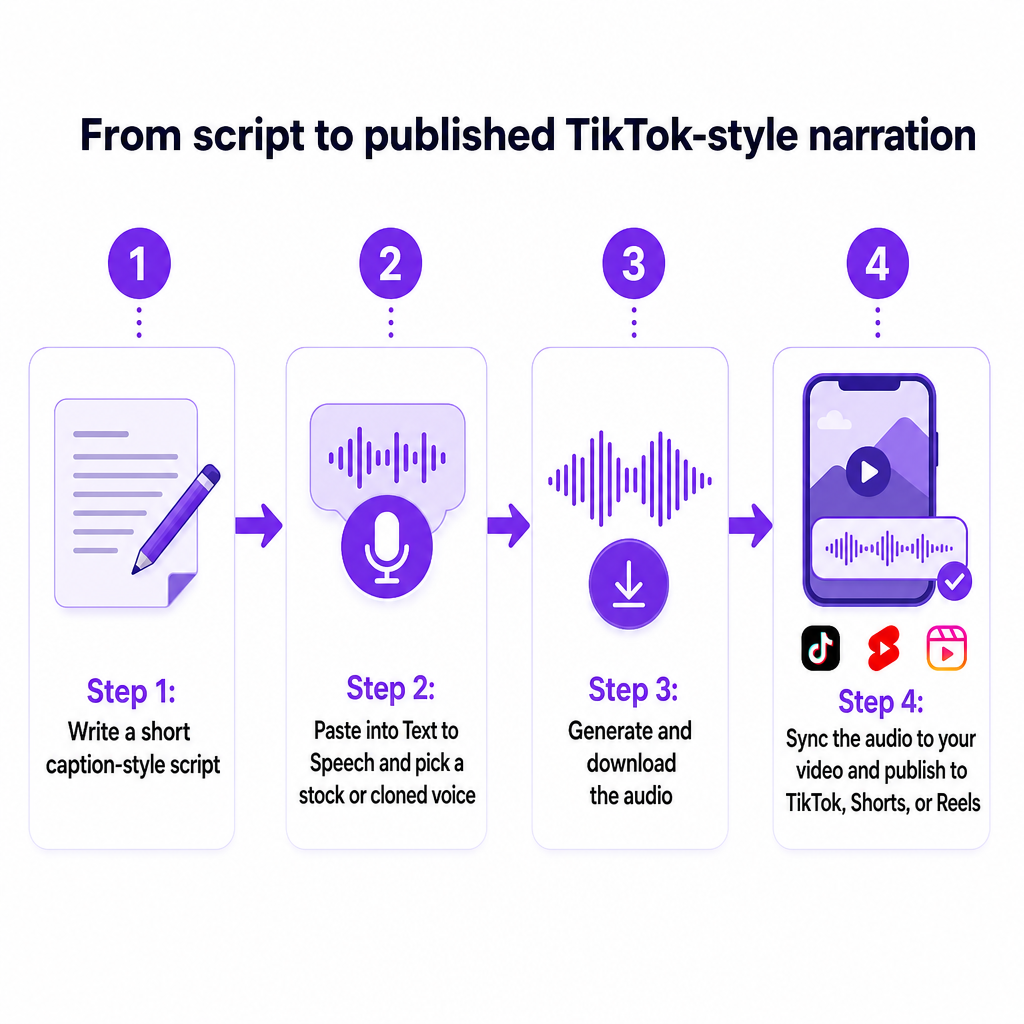
ウェブアプリは4つの分かりやすいステップに従います。第一に、Text to Speech を選びます。第二に、テキストを入力しスピーカーを選択して音声を作成します。第三に、プロジェクトを編集し、スピーカーを追加したりテキストを調整したりできます。第四に、必要なフォーマットで完成したプロジェクトをダウンロードします。技術的なことは何もありません。それが要点です:あなたはソフトウェアと格闘するのではなく、スクリプトと編集にエネルギーを注ぐべきなのです。
ショートフォーム動画に応用すると、この流れはさらに具体的になります。まず、短いキャプション調のスクリプト、つまりクリップに読み上げてほしい言葉を正確に書くことから始めます。歯切れよく保ちましょう。ナレーター効果は引き締まったリズミカルな行で最もよく機能します。そのスクリプトを Text to Speech に貼り付け、狙っているムードに合ったトーンの声を選びます。それが無表情なものであれ、明るいものであれ、事務的なものであれ。オーディオを生成し、それを好みのエディタに取り込んで、TikTok、Shorts、または Reels に公開する前に映像と合わせます。
ナレーションを単一のアプリの外で生成しているため、同じオーディオファイルが投稿ローテーション内のすべてのプラットフォームで機能します。一度録れば、どこでも再利用できます。それだけで、アプリの組み込みナレーターに関する最大の不満が解消されます:もはや3つの投稿先のために同じボイスオーバーを3回作り直す必要はありません。
ナレータースタイルに合ったスクリプトを書く
声は多くの仕事をこなしますが、ペースを設定するのはスクリプトです。短い断定的な文はきれいに読まれ、視聴者がトレンドと結びつけるあの歯切れの良いリズムで着地します。数字、リスト、そして「first(まず)」「then(次に)」「finally(最後に)」のような明確な転換は、声に自然な区切りのポイントを与えるため、合成音声にうまく変換されます。声に出して読んだときにぎこちなく聞こえる行は、声が読んでもぎこちなく聞こえるので、生成前に素早く口に出して確認しておくと、後の再生成の手間を大幅に省けます。
ボイスクローニングでストックボイスを超える
ライブラリから選ぶのは速い道であり、多くのクリエイターにとってよく選ばれたストックボイスがあれば十分です。しかし、他のみんなと同じように聞こえることには限界があります。もしあなたの目標が紛れもなくあなたのものであるナレーターなら、私たちの Voice cloning は、あなた自身の声、または同意を得たブランドボイスを、テキストから駆動できる再利用可能なモデルに変えます。
この区別は重要です。一般的な text to speech はプリセットのナレーターから選ぶことを意味します。ボイスクローニングは特定の一人の話者の合成モデルを構築するので、その声での新しい音声を、あなたが入力するどんなテキストからでも生成できます。ウェブアプリでは、背景ノイズが最小限のクリーンな音声を少なくとも20秒分収録したオーディオファイルをボイスクローンセクションにアップロードします。その短く静かなサンプルから、私たちは他の声と同じように Text to Speech プロジェクトで使えるカスタムボイスを作成します。
20秒のクリーンなオーディオは、制作にかける労力としては低いハードルです。静かな部屋、スマートフォンまたは基本的なマイク、そして短い朗読があれば、何度でも再利用できる特徴的なナレーターを生成するのに十分です。それが一度存在すれば、あなたはもはや無名のストックボイスの間で選ぶことはありません。あらゆるクリップにあなたのアイデンティティを運ぶ声を持ち、今日公開しようが6か月後に公開しようが一貫性が保たれます。
ここが、認識されやすいナレーターが一回限りの効果ではなくブランド資産になる分岐点です。クローンされた声は、あなたが実際に録音していないスクリプトを読み上げ、コンテンツカレンダー全体でその特徴を保ち、環境を変えたからといって再録音セッションを必要とすることは決してありません。長期的なチャンネルアイデンティティを構築するクリエイターにとって、その一貫性こそが、入れ替わり立ち替わりのアプリ音声メニューに対する真のアップグレードです。
一つの声を言語やフォーマットを越えて運ぶ
一つの言語でしか機能しないナレーター声は、国際的に成長したいと思った瞬間にあなたのリーチを制限します。私たちのプラットフォームは33のターゲット言語にわたる多言語吹き替えをサポートし、あなたが選んだ言語のテキストから音声を生成できるので、英語で機能する同じトレンドを他の地域の視聴者向けに再現できます。
これらの要素がどのように組み合わさるかは次の通りです。Text to Speech がナレーションを提供します。ボイスクローニングがそのナレーションを単一の認識可能な声に保ちます。私たちの AI Dubbing は、text to speech、speech to text、そしてボイスクローニングを一つのワークフロー内で動画とオーディオを処理することによって、同じコンテンツを他の言語へと拡張します。各市場ごとに別々のナレーターを雇う代わりに、一つの声のアイデンティティを保ち、プラットフォームにそれをバージョン間で運ばせます。
このワークフローは短いクリップを超えてスケールもします。より長いコンテンツについては、動画やオーディオファイル全体をアップロードし、スピーカー設定を調整し、言語を選び、エクスポート前にプロジェクト内で好みの声を選択できます。ですから、15秒のクリップにバイラルスタイルのナレーターを追加するのに使うのと同じアプローチが、解説動画、レッスン、あるいはフルエピソードにも適用できます。ショートフォームはトレンドが息づく場所ですが、その基盤となるツールはショートフォームで止まりません。
グローバルな成長を計画するクリエイターにとって、これはローカライゼーションの経済性を変えます。一つのスクリプトが、英語のショート、スペイン語版、そしてさらなる言語版になり、そのすべてが一貫した声でナレーションされ、毎回オーディオをゼロから作り直す必要がありません。認識されやすいナレーター効果は、幸運な一回限りのものではなく、繰り返し運用できるシステムとして機能するものになります。
私たちの API で TikTok スタイルのナレーションを自動化する
個人のクリエイターは上記のすべてをブラウザで行えます。エージェンシー、より大きなチャンネル、そして過去のコンテンツを抱えるチームは通常、同じ結果を大量に必要とし、そこで私たちの API が登場します。Text to Speech API は、テキストを自然な音声に変換する RESTful サービスです:テキストと声の設定を含む POST リクエストを送信すると、すぐに使えるオーディオファイルが返ってきます。これはアプリで利用可能なのと同じ300以上の声とボイスクローニングをサポートしています。
カスタムナレーターをプログラムから利用可能にするために、私たちの Voice Cloning API はコンパクトな3ステップのパターンに従います。第一に、オーディオファイルをアップロードしてファイルキーを受け取ります。第二に、名前とそのファイルキーを提供してカスタムボイスを作成します。第三に、プラットフォームの TTS プロジェクトエンドポイントを通じて、生成されたクローンボイスを Text to Speech プロジェクト内で使用します。声が一度存在すれば、それは一回限りのエクスポートではなく、アプリケーションが呼び出せる再利用可能な資産になります。
まとめると、これによってチームは効果を工業化できます。いくつかのクライアントチャンネルを管理するエージェンシーを想像してください:クライアントごとに一つのクローンブランドボイスを維持し、スクリプトを API に通し、毎回手動でテキストをツールに貼り付ける人がいなくても、何十もの動画向けにナレーション付きオーディオを生成できます。同じパターンは、コンテンツが制作されるにつれてクローンボイスがオンデマンドで呼び出される学習システムやローカライゼーションパイプラインもサポートします。
ビジュアルも生成する、または静止素材の周りに短い動画を構築したいチームのために、私たちの image-to-video ツールは同じエコシステムに存在するので、オーディオとビジュアルの制作がバラバラの接続されていないアプリに散らばるのではなく、一つの場所に存在します。目標は単一のワークフローです:書く、声を当てる、ローカライズする、組み立てるための一つのプラットフォーム。
期待についての注記:私たちはこれらの API を機能的な用語で説明しています。なぜならそれがワークフローが依存するものだからです。レート制限、スループット、またはプラン固有のセットアップについての詳細をお求めの場合は、予想されるボリュームとユースケースをお知らせください。あなたのワークロードに合った推奨事項を準備します。
あなたの道を選ぶ:ストックボイス、クローンボイス、それとも API
ほとんどの読者は3つのニーズのうちの一つを抱えて訪れます。そして正しい出発点は、そのうちのどれがあなたを表しているかによって決まります。以下の表は、各状況を最も速く役立つ最初の一手に対応させています。
| あなたの状況 | 最適な出発点 | なぜそれが合うのか |
|---|---|---|
| 効果を素早くテストする | Text to Speech のストックボイス | 300以上の声から選び、数分でオーディオを生成、録音不要 |
| 特徴的なチャンネルボイスを構築する | ボイスクローニング | 20秒のクリーンなサンプルを再利用可能なカスタムナレーターに変える |
| 大規模に、または複数のクライアント向けに制作する | TTS および Voice Cloning API | 多数の動画や多言語版にわたってナレーションを自動化する |
もし迷っているなら、シンプルに始めましょう。次の投稿のために短いキャプション調のスクリプトを下書きし、ブラウザで Text to Speech を開き、あなたのトーンに合ったストックボイスでそれを生成します。効果が気に入ったけれど自分の声のように聞こえてほしいなら、クリーンな20秒のサンプルをアップロードしてあなたの声をクローンし、同じクリップで両者を比較しましょう。その一回の比較で、今後バイラルスタイルのストックナレーターが欲しいのか、それともユニークなブランドボイスが欲しいのかという問いが、たいてい決着します。
複数のチャンネルや大きな過去のコンテンツを運用するチームや開発者は、API アクセスからより多くの価値を得るでしょう。手動のブラウザフローは何百もの資産にはスケールしないからです。あなたのボリュームに合うものがどれであれ、その基盤となる能力は同じです:あなたの条件で、あなたが公開するすべてのプラットフォームで、認識されやすいナレーター。あなたのチャンネル計画、カタログのサイズ、そして言語ターゲットを正しいアプローチに対応させる手助けが欲しい場合は、それらの詳細を私たちと共有してください。適切なセットアップを提案します。
心に留めておく価値のある実用的な注意点が一つあります:声をクローンするときは、自分自身の声か、使用する明確な許可を得たものを使い、公開するどのプラットフォームの投稿ルールにも従ってください。それがあなたの認識されやすいナレーター戦略を、リスクを伴うものではなく持続可能なものに保ちます。
よくある質問
DubSmart AI には「TikTok voice」と表示されたプリセットがありますか?
私たちの焦点は、特定の独自プリセットを模倣することではなく、効果を再現することにあります。あの馴染みのある画面上のナレーターの雰囲気は、300以上の声のライブラリから Text to Speech でオーディオを生成し、望むスタイルに合ったトーンの声を選ぶことで得られます。あなただけのナレーターのためにカスタムボイスをクローンすることもできます。特定のトーンやブランドボイスを念頭に置いている場合は、お知らせください。ふさわしいアプローチを提案します。
TikTok 以外の動画にナレーター効果を追加するにはどうすればいいですか?
短いキャプション調のスクリプトを書き、私たちの Text to Speech ツールに貼り付け、スピーカーを選択し、オーディオを生成します。ファイルをダウンロードし、任意のエディタで映像に合わせ、その後 Shorts、Reels、またはその他の場所に公開します。オーディオが独立したファイルであるため、一つのナレーションがあなたが投稿するすべてのプラットフォームで機能します。
自分の声をクローンするには何が必要ですか?
背景ノイズが最小限のクリーンな音声を少なくとも20秒分収録したオーディオファイルをボイスクローンセクションにアップロードします。その短く静かなサンプルから、私たちは他の声と同じように Text to Speech プロジェクト内で使えるカスタムボイスモデルを作成します。
異なる言語で同じ声を使えますか?
はい。私たちのプラットフォームは33のターゲット言語にわたる多言語吹き替えをサポートしており、Text to Speech、ボイスクローニング、そして AI Dubbing を組み合わせることで、同じコンテンツのバージョン間で一つの認識可能な声を保つことができます。そのため、英語のショートとその他の言語版が一貫したナレーターを共有します。
多数の動画に対してこれを一度に自動化する方法はありますか?
開発者やエージェンシーは、私たちの Text to Speech API を使ってテキストをプログラムからオーディオに変換でき、Voice Cloning API を使ってサンプルをアップロードし、名前付きのカスタムボイスを作成し、TTS プロジェクト内でそれを呼び出せます。これにより、動画ごとの手作業なしで、大規模なカタログや複数のチャンネルにわたってナレーションを生成できます。
ストックボイスを選ぶべきか、自分の声をクローンすべきか?
ストックボイスは効果をテストする最も速い方法であり、多くのクリエイターにとってうまく機能します。クローニングは、あなたのブランドと紛れもなく結びつき、時間が経っても一貫性を保つナレーターが欲しいときのより良い選択です。同じクリップで両方を試すのが、どちらを好むか決める最も速い方法です。