研修動画向けのAIボイスオーバーは、書き起こしたスクリプトとAI音声エンジンを組み合わせ、任意でトレーナーの声をクローンし、1つのプラットフォームから1つまたは複数の言語でナレーションを生成することで完成します。これが「研修動画向けAIボイスオーバーの作り方」に対する端的な答えであり、2分間のオンボーディング動画を制作する場合でも、コンプライアンス関連の全ライブラリをローカライズする場合でも当てはまります。より大きな問いは、あなたのコンテンツ、視聴者、そして素材をどのくらいの頻度で更新する見込みかに、どのワークフローが適しているかということです。
DubSmart AIでは、研修チームは通常2つの出発点のいずれかを選びます。テキストから新しいナレーションを生成するか、既存の動画をアップロードして、書き起こし・翻訳・音声生成をすべて処理するプラットフォームに一貫してダビングさせるかです。どちらの方法も1つのクレジットベースのワークフロー内で完結するため、コースを仕上げるのに別途の書き起こしアプリ、翻訳サービス、音声ツールが必要になることはほとんどありません。
目次
実際にはどのような決断をしているのか?
本当の選択は、単にどのボタンを押すかということではありません。それは、あなたの研修コンテンツと、それを視聴する人々にどのようなボイスオーバーのワークフローが合っているかということです。DubSmart AIでは、その決断は通常3つのカテゴリーに分けられ、それぞれが学習者体験の一貫性の感じ方や、後からコースをどれだけ素早く修正できるかを左右します。
- プロフェッショナルな研修ナレーションを素早く用意したいだけの場合は、33以上の言語にわたる300以上の自然な音声のライブラリから標準AIナレーターを使用します。
- 特定のトレーナーやブランドの声をクローンすることで、コースが複数の言語にローカライズされても、学習者が馴染みのある話者の声を聞けるようにします。
- LMSやアプリからコーステキストを大規模に音声生成へ直接パイプで送る必要がある場合は、APIを通じてボイスオーバー制作を自動化します。
それぞれの経路は同時に3つのことに影響します。学習者体験がどれだけ均一に聞こえるか、更新をどれだけ素早く反映できるか、そしてすべてを録り直すことなく多言語研修にどれだけ容易に拡大できるか、です。年に5本の洗練されたコースを制作するチームは、数百のロール別モジュールを維持するチームとは、これらを異なる重みで判断するでしょう。したがって、ツールを選ぶ前に、自分のボリュームと更新の頻度を明確にしておくと役立ちます。
DubSmart AIが研修動画向けボイスオーバーを作成する方法
DubSmartは、テキスト読み上げ、音声クローン、AIダビング、音声文字起こし、音声分離、テキストから画像、画像から動画を、1つのクレジットベースのワークフローに統合したオールインワンのAIメディア作成・ローカライゼーションプラットフォームです。研修チームにとって、この統合こそが重要なポイントです。途中でベンダーを切り替えることなく、生のスクリプトから完成済みでローカライズされた研修動画まで進めることができます。
スクリプトからのテキスト読み上げナレーション
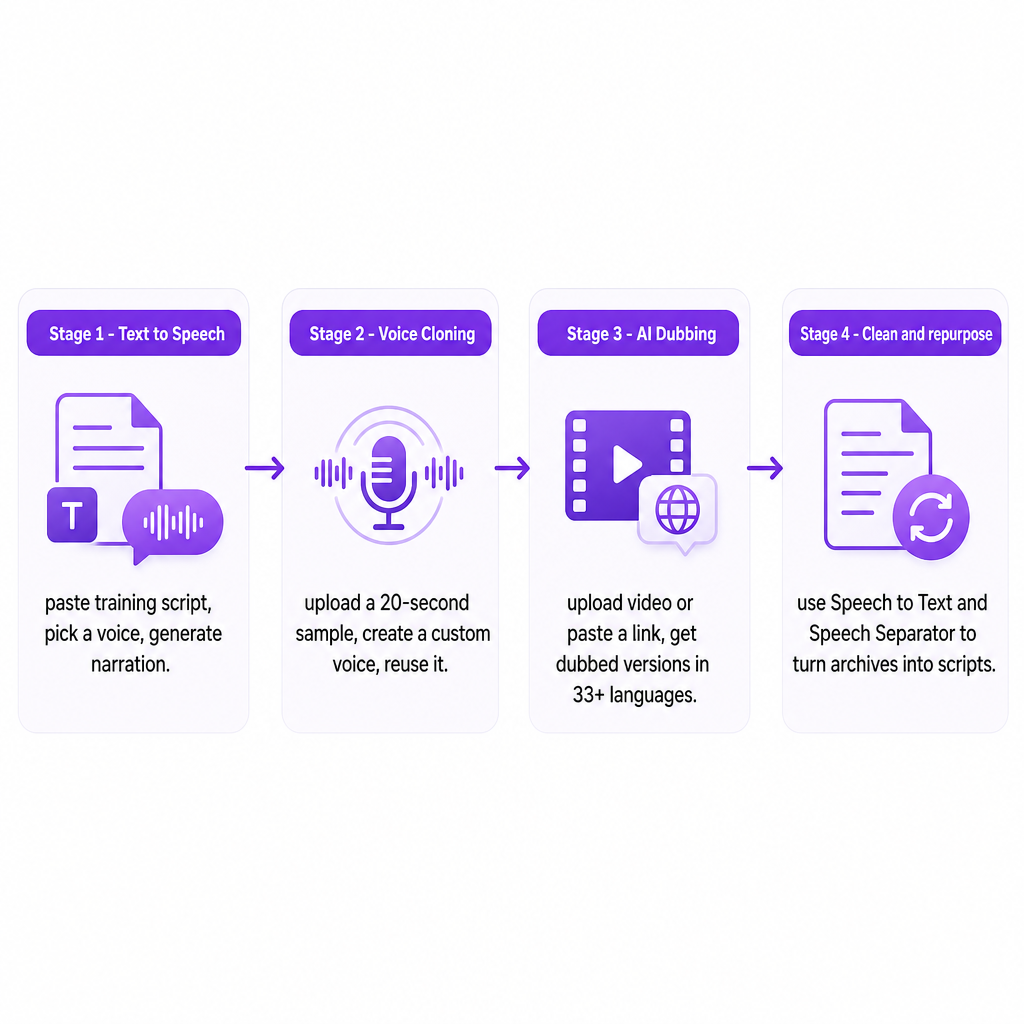
ほとんどのコースでは、出発点はスクリプトです。オンボーディングモジュール、安全手順、コンプライアンスの説明、ソフトウェアのウォークスルーなどです。当社のテキスト読み上げツールは、そのテキストをサポート対象のあらゆる言語で自然で人間らしい音声に変換します。ウェブアプリ内では、技術に詳しくないクリエイターにも扱いやすいフローになっています。ツールを開き、スクリプトを貼り付けるか入力し、音声ライブラリから話者を選び、音声を生成します。良い仕上がりになったら、話者を追加・変更したり、個々のセグメントを修正したり、完成したファイルをお好みの形式でダウンロードして動画エディターに取り込むことができます。
学習プラットフォームやカスタムアプリを持つチームは、当社のテキスト読み上げAPIを通じて同じ機能を利用できます。コーステキストと音声の設定を含むリクエストを送信すると、APIは高品質な音声を返し、それをプログラムでレッスンや動的に生成されたコンテンツに添付できます。
トレーナーやブランドの声のクローン作成
研修を特定の人物の声に聞かせたい場合、音声クローンはその声の合成モデルを構築し、同じトーンでテキストから新しい音声を生成できるようにします。これは、自分の話者を用意するのではなく既製のナレーターから選ぶ一般的なテキスト読み上げとは異なります。クリエイター向けの経路では、通常20秒以上の短くクリーンなサンプルを集めて、音声クローンのセクションにアップロードします。システムはそれを名前付きのカスタム音声に変換し、それがテキスト読み上げとAIダビングの両方のプロジェクト内に表示されます。そこからスクリプトを貼り付け、イントロ、詳細な説明、コンプライアンスセグメントをクローン音声で読み上げさせることができ、更新のたびにトレーナーを再度呼び戻す必要はありません。基盤となる仕組みを知りたい場合は、AIがどのようにあらゆる声を再現するかについての解説記事で、モデルをわかりやすく説明しています。
開発者やエージェンシーは、これを音声クローンAPIを通じて3ステップのパターンとして体系化できます。まず、事前署名済みURLをリクエストし、MP3、WAV、AAC、M4A、FLACなどのサポート形式で音声ファイルをアップロードします。次に、名前とそのアップロードのファイルキーを送信してカスタム音声を作成します。第三に、テキスト読み上げまたはAIダビングのプロジェクト内でそのクローン音声の識別子を参照し、研修テキストや動画がその音声を自動的に使用するようにします。
グローバルな視聴者向けの多言語ダビング
すでに録画済みのウォークスルー、講師主導のセッション、ライブプレゼンテーションがある場合、それらを直接ダビングする方が、ゼロから再構築するよりも効率的なことがよくあります。当社のAIダビングAPIとウェブツールは、スピーチ・トゥ・スピーチのワークフロー向けに構築されています。ソース動画または音声ファイルをアップロードするか、リンクを貼り付けると、プラットフォームが書き起こし・翻訳・音声生成を処理しながら、ターゲット言語でダビング済みバージョンを提供します。話者を追加したり、タイミングを調整したり、生成されたテキストセグメントを編集して、ダウンロードする前に用語やペースを研修基準に合わせることができます。ダビングは33以上の言語にわたって機能し、音声クローンを統合しているため、すべての地域で同じトレーナーの声を維持することも、意味のある箇所でナレーターを切り替えることも、すべて1つのアカウントから行えます。大規模なカタログの場合、APIがこのフローをプログラムで再現し、既存の公開パイプラインに挿入できるダビング済みトラックを返します。
既存音声のクリーニングと再利用
多くの組織は、すでに録画済みのウェビナーやワークショップのライブラリを所有しており、それらを構造化されたモジュールにできる可能性があります。DubSmartはクローンやダビングに加えて音声文字起こしと音声分離を備えているため、それらのアーカイブを再利用可能な資産に変えることができます。音声文字起こしは、話された内容を編集してクリーンなスクリプトにできるトランスクリプトに変換し、音声分離はミックスされた音声から声を分離するのに役立つため、クローン用のよりクリーンなサンプルや、文字起こしのためのより良い入力を得られます。この組み合わせにより、録り直しを減らし、一貫したナレーションでレガシーコンテンツを現代化できます。
研修・eラーニングチームの主要な意思決定基準
仕組みを理解すれば、選択はいくつかの実用的な要素に絞られます。以下の表は、よくある優先事項を適合しやすい経路にマッピングしており、その後の注記が表では表現しきれないニュアンスを補足しています。
| 優先事項 | 最適な経路 | 適合する理由 |
|---|---|---|
| 認識しやすい講師の声 | 音声クローン | 1つのクローン音声をTTS、ダビング、APIワークフロー全体で再利用 |
| アイデンティティより速度 | 既製のTTS音声 | セットアップ不要で300以上のスタイルが利用可能 |
| 大規模または頻繁に更新されるカタログ | TTSまたはダビングAPI | 公開フロー内で生成を自動化 |
| グローバルな従業員 | AIダビング + クローン | 33以上の言語にダビングし、オリジナルの雰囲気を維持 |
| 技術的または規制対象のコンテンツ | 編集可能なダビングプロジェクト | 最終化前に用語を確認 |
学習者体験の一貫性が決め手になることがよくあります。戦略が認識しやすい講師や企業の声に依存している場合、クローンによってそのアイデンティティをモジュールや言語をまたいで保つことができ、同じクローン音声を数か月離れて生成されたコースにも使用できます。単一のアイデンティティよりも速度が重要な場合、300以上の既製音声によって、コンテンツの種類にトーンを合わせられます。たとえばコンプライアンスには落ち着いた声を、オンボーディングには軽やかな声を、といった具合です。
ボリュームと更新頻度は、計算を自動化の方向へと押し進めます。数本のコースを制作するチームは、必要に応じてボイスオーバーを生成しダビングを行いながら、ウェブアプリで快適に作業できます。大規模なカタログやロール別のバリエーションを維持する組織は、スケジュール化された公開ワークフロー内でテキストや動画を自動的に音声に変換するAPIから恩恵を受けます。頻繁なポリシー変更やソフトウェア更新が見込まれる場合、テキストベースのTTSとダビングにより、スタジオの予約なしに素早くナレーションを再生成できます。
言語カバレッジは、グローバルチームを研修する米国拠点の企業にとって最も重要です。DubSmartは60以上のソース言語から少なくとも33のターゲット言語へのダビングをサポートし、クローンおよびTTSと組み合わせることで、各地域がオリジナルのルックアンドフィールを保ちながら、それぞれの主要言語でコンテンツを受け取ることができます。米国英語に時折スペイン語モジュールを加える程度の軽めのニーズであれば、既製のTTS音声で十分であり、セットアップ作業を減らせます。
技術的および規制対象のコンテンツには、より一層の注意が必要です。専門用語、製品名、法的な表現は正しく発音・翻訳されなければならないため、ダビングプロジェクトでトランスクリプトや生成されたセグメントを確認・編集できる機能により、専門家が真の制御を得られます。APIを使用する場合、好みの用語をスクリプトや前処理ロジックにエンコードして、TTSやダビングが受け取るものがすでに精査済みであるようにできます。
データ、同意、ガバナンスがリストを締めくくります。クローンには対象話者からの音声サンプルが必要なため、同意を確保し、クローン音声がどのように使用されるかを文書化してください。当社のクローンプロセスは短くクリーンな録音を受け付けるため、使用可能なモデルを作成しつつ、収集するデータを少なく抑えられます。クローン、TTS、ダビングを1つのプラットフォームに集約することで、別々のツールをやりくりするよりも監査証跡が簡素化され、APIを備えたクレジットベースのモデルにより、研修責任者は単一のアカウント構造から使用状況を管理できます。
研修でAIボイスオーバーを使用する際のリスクと安全対策
AIナレーションは高速ですが、スケールする前に注意すべき失敗モードがいくつかあります。
ブランドや指導スタイルとの不一致が最も一般的です。AI音声は、クローンされたものも含め、あなたのハウススタイルに合わない可能性のあるさまざまな速度や強度で生成されることがあります。サンプル出力を聞き、可能な場合は配信パラメータを調整し、広く展開する前にコースの種類ごとに音声の選択を標準化してください。
発音や翻訳のニュアンスがその次です。自動ナレーションは名前や専門用語でつまずくことがあり、機械翻訳は正確ではあっても教育的にぎこちない表現を生み出すことがあります。ダビングプロジェクトでテキストセグメントを編集して音声を再生成できる機能は役立ちますが、重要なコンプライアンスや安全モジュールについては人間によるレビューに取って代わるものではありません。
自動化への過度の依存は、より微妙なリスクです。職場での行動、メンタルヘルス、法的義務といったセンシティブなトピックでは、事実が正しくてもトーンの誤りが忍び込むことがあります。AIボイスオーバーを人間によるレビューと組み合わせ、最も重要なメッセージには時折人間が録音したセグメントを加えることで、よりよいバランスを取れる傾向があります。
クローン音声を責任を持って管理することが、これを締めくくります。クローン音声は再利用可能な資産であり、範囲とライフサイクルの問題を提起します。特定の音声で誰が生成をトリガーできるか、サンプルをどのくらい保持するか、トレーナーが退職した場合にアクセスをどのように取り消すかについて、社内ポリシーを設定してください。こうしたガードレールが、テクノロジーを倫理的で予測可能なものに保ちます。
AIナレーションがどこに適合し、どこで人間が関与し続けるべきかを検討している場合は、まずコースのボリューム、言語、コンテンツの更新頻度を明確にすることから始めてください。それらの詳細をお知らせいただければ、あなたのプログラムに合わせたテキスト読み上げ、音声クローン、ダビングの適切な組み合わせをマッピングするお手伝いができます。
よくある質問
トレーナーの声を維持したまま、コースを複数の言語にローカライズできますか?
はい。トレーナーの声をクローンし、そのクローン音声を、他言語でのダビング済みバージョンを含め、テキスト読み上げとAIダビングの両方のプロジェクトで使用できます。
研修ナレーション用に音声をクローンするには、どれくらいの音声が必要ですか?
クローンは短くクリーンなサンプル、通常は20秒以上の音声から機能します。多くのクリエイターは、より堅牢なモデルのために20〜60秒を使用します。
音声クローン用のサンプルをアップロードする際、どの音声形式を使用できますか?
音声クローンAPIは、MP3、WAV、AAC、M4A、FLACなどの一般的な形式を受け付け、サンプルがカスタムAI音声になる前に事前署名済みURL経由でアップロードされます。
開発者はLMSやアプリのコンテンツからボイスオーバーを自動化できますか?
はい。テキスト読み上げAPIとAIダビングAPIにより、バックエンドシステムが研修テキストや動画を送信し、自動化された公開フロー向けにすぐに使える音声やダビング済みトラックを受け取ることができます。
DubSmartはコンプライアンスや規制関連の研修に適していますか?
TTS、音声クローン、AIダビング、編集コントロールの組み合わせは、構造化され再現可能なワークフローをサポートしますが、チームはセンシティブまたは規制対象のトピックについては依然として人間によるレビューとガバナンスを適用すべきです。