テキスト読み上げAPIを統合する最も手っ取り早い方法は、それをRESTサービスとして扱うことです。つまり、APIキーで認証し、テキストと音声設定をJSONとして送信し、サービスがバックグラウンドで音声をレンダリングするのを待ち、生成された音声ファイルを取得・保存して、ユーザーが必要とする場所で再生できるようにします。当社のText to Speech APIはまさにこのパターンに従いつつ、300以上のナチュラルな音声と無制限の音声クローンを提供するので、ウェブサイト、アプリ、動画パイプライン、学習プラットフォームにリアルな音声を組み込むことができます。このガイドでは、実際に何を接続しているのか、当社のエンジンがどのように動作するのか、そして統合が製品に適合するかどうかを決定する判断について解説します。
目次
テキスト読み上げAPIがDubSmartで果たす役割
テキスト読み上げAPIは、構造化されたテキストをオンデマンドで音声に変換するので、手動録音を待つ代わりに、スクリプトが準備できた瞬間にコードがナレーションや対話をリクエストできます。当社のText to Speechエンジンは、ブラウザベースのText to SpeechツールとAPIの両方を支えており、言語、性別、スタイルを問わず300以上のAI音声にアクセスでき、ナレーション、解説、対話に合わせて韻律が調整されています。
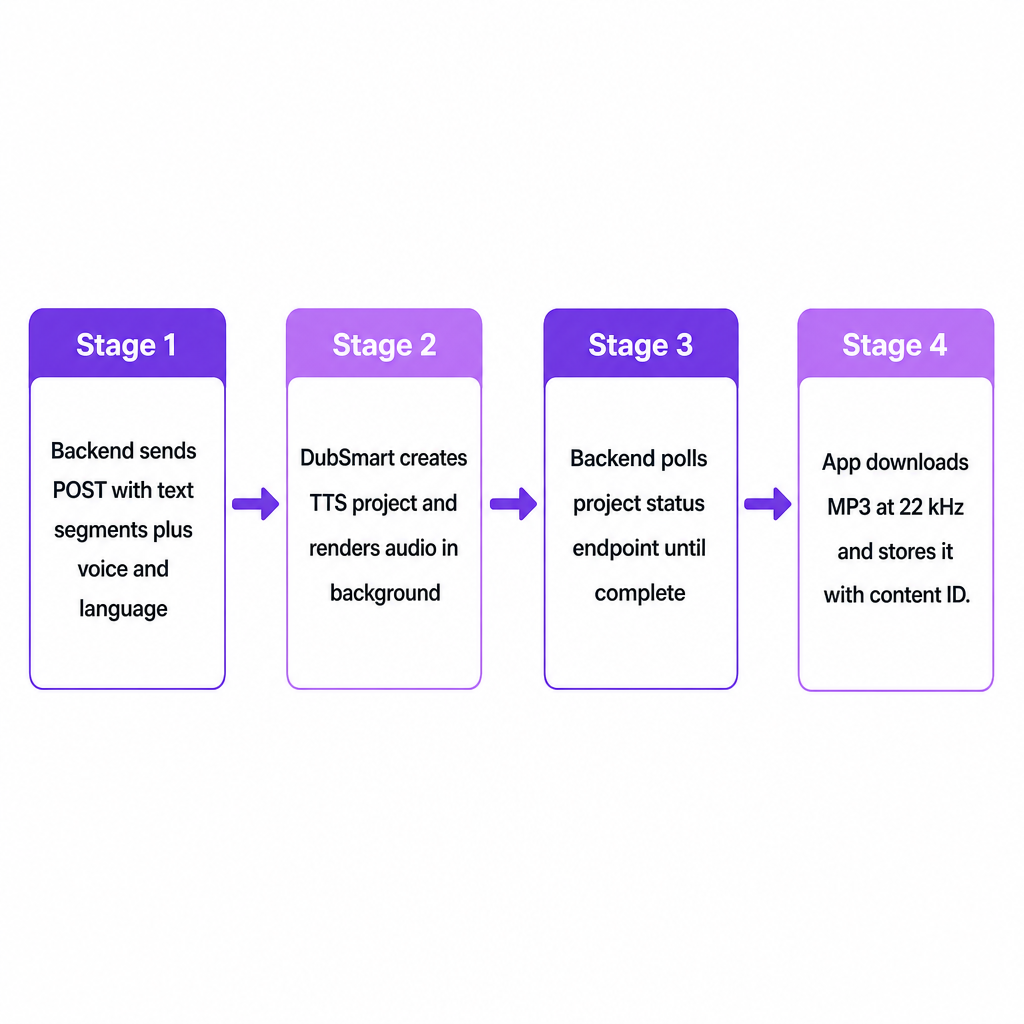
APIレイヤーでは、このエンジンをRESTfulサービスとして公開しています。バックエンドがテキストセグメントと音声パラメータを含むPOSTリクエストを送信すると、サービスはプロジェクトオブジェクトを返し、そのステータスを音声のダウンロード準備が整うまでポーリングできます。出力は高品質な音声ファイルとして提供され、通常は22 kHzのMP3で、余分な変換なしに動画エディタ、ポッドキャストワークフロー、ウェブプレーヤーで直接使用できます。
当社がサービスを提供するクリエイターやチーム——YouTuber、中小企業、eラーニング制作者、映画製作者、開発者エージェンシー——にとって、APIはコンテンツ計画と公開をつなぐ架け橋となります。スクリプトがCMSや学習プラットフォームに到達するとすぐに、バックエンドが自動的にボイスオーバーを生成できるので、繰り返しの手動録音というボトルネックがなくなります。
統合の判断:実際に何を接続しているのか?
「テキスト読み上げAPIを統合する」という表現は一般的に聞こえますが、実際には次の3つを決めています。ワークフローのどこで音声を生成すべきか、どの音声と言語がブランドを代表するか、そして音声の生成と取得をどれほど緊密に自動化するか、です。
多言語コンテンツに展開するYouTubeクリエイターにとって、統合とは多くの場合、当社のAPIを動画計画ツールやスクリプトデータベースに連携させ、完成した各スクリプトが適切な言語とスタイルのボイスオーバーになるようにすることです。中小企業やマーケティングチームにとって、APIは通常CMSやマーケティングオートメーションプラットフォームの背後に位置し、ブログ記事、製品解説、ソーシャル投稿文を再利用可能な音声アセットに変換します。eラーニングや企業研修プロバイダーは、レッスンモジュールがスライドごとまたはトピックごとにナレーションをリクエストし、素材が更新されると即座に再生成できるように、APIをオーサリングツールに組み込む傾向があります。
音声AIをより深く統合する開発者やエージェンシーは、通常2つのパターンから選択します。バッチモデルはスクリプトを収集し、スケジュールされたジョブで処理します。トランザクションモデルは、新しいコンテンツやユーザーアクションが発生するたびに即座にリクエストをトリガーします。当社のプロジェクトベースのAPIはどちらでも問題なく機能します。各TTSプロジェクトがテキスト、音声の選択、言語、および生成された音声を、動画、レッスン、ポッドキャストエピソードといった独自のコンテンツ単位にマッピングする形でカプセル化するからです。まだコンセプト自体を検討している段階であれば、設計に着手する前に、テキスト読み上げAPIとは何か、どのように動作するかを解説した関連記事が基礎を網羅しています。
当社のText to Speech APIの内部動作
当社のText to Speech APIは、プロジェクトとセグメントを中心に構築されており、単一の「テキスト入力、音声出力」エンドポイントよりも柔軟です。TTSプロジェクトは、1つ以上のテキストセグメントを、タイトルと言語やデフォルト音声などの共有設定の下にグループ化します。各セグメントは独自のテキスト、音声識別子、言語タグを持ち、1つの出力内でナレーションスタイルや言語を混在させることができます。
TTSプロジェクトエンドポイントへの典型的なJSONペイロードには、ダッシュボードやログ用の人間が読めるプロジェクトタイトルと、セグメントの配列が含まれます。各セグメントはtext(話すスクリプトまたは文)、voice(組み込みの音声IDまたは音声クローンAPI経由で作成されたカスタム音声ID)、language(セグメントの言語を示すコード)を設定します。
バックエンドがこのペイロードを有効なAPIキーをAuthorizationヘッダーに含めてTTSエンドポイントに送信すると、当社はプロジェクトを作成し、バックグラウンドで音声のレンダリングを開始します。APIはプロジェクトステータスエンドポイントを公開しており、処理がまだ進行中か完了しているかを報告し、準備が整うと生成された音声ファイルへの参照も報告します。この非同期設計により、自分自身のリクエストは高速に保たれます。プロジェクトIDをログに記録し、制御をユーザーに返し、バックグラウンドワーカーに完了を確認させて、利用可能になったら音声を取得させます。
生成された音声は、標準フォーマット、特に22 kHzのMP3のダウンロード可能なファイルとして届き、ウェブプレーヤー、モバイルアプリ、動画編集タイムラインに簡単に収まります。同じエンジンがブラウザベースのツールを支えているため、開発者は音声とスクリプトをインタラクティブにプロトタイプし、勝ち残った組み合わせを自動化されたAPI呼び出しに移行できます。完全なエンドポイントリファレンスはText to Speech APIページにあります。
音声クローンとAI吹き替えをテキスト読み上げに接続する
当社を特徴づける機能は、Text to Speech、音声クローン、AI吹き替えが単一の基盤となる音声エンジンとワークフローを共有していることです。つまり、TTS APIは孤立したものではなく、より広範なローカライゼーションパイプラインの中核です。
音声クローンAPIを使うと、話者の音声サンプルをアップロードし、カスタムAI音声を作成して、その音声をTTSプロジェクトで参照できます。カスタム音声が存在すると、その識別子がText to Speechセグメントのvoiceフィールドになり、汎用のストック音声ではなくクローンされた音声でナレーションが再生されます。この連続性は、言語やフォーマットを問わず一貫した音のアイデンティティを望むホスト、ポッドキャスター、ブランドスポークスパーソンにとって重要です。クローンを追加する予定であれば、アプリに音声クローンAPIを統合する方法に関する当社のガイドが詳細を網羅しています。
AI吹き替えAPIは、文字起こし、翻訳、テキスト読み上げを単一のパイプラインで組み合わせ、33以上のターゲット言語に動画を吹き替えることで、これをさらに拡張します。ここでは、TTSエンジンが翻訳されたスクリプトを、同じ300以上の音声ライブラリまたはクローンされた音声を使って音声に変換するので、吹き替え版はトーンとタイミングを保ちます。多言語のクリエイターや企業にとって、Text to Speech APIは、単一言語のボイスオーバーと完全にローカライズされた吹き替えコンテンツの両方の構成要素となります。当社のAIローカライゼーションの仕組みの概要は、これらの要素がどのようにエンドツーエンドで組み合わさるかを示しています。
当社のTTS APIを統合する際の主要な判断基準
「どんな」TTS APIを統合しても十分ではありません。実装をめぐる選択が、それが制作、ブランド、技術スタックにどれだけ適合するかを決定します。
スケールと自動化のニーズ。 コンテンツ量が少なく散発的であれば、ブラウザベースのツールで十分かもしれません。スクリプトが定期的に生成される、あるいはコンテンツカレンダー、学習管理システム、マーケティングオートメーションに紐づくようになると、APIがプログラムからトリガーでき、バックエンドとともにスケールできるため、適切なレイヤーになります。
音声と言語の戦略。 当社のプラットフォームは、TTS APIが使うのと同じ音声エンジンを活用して、60以上のソース言語から33のターゲット言語への吹き替えをサポートします。ブランドに独自のスポークスパーソン音声が必要であれば、音声クローンAPIとTTSを組み合わせることで、その音声を言語やチャネルを問わず一貫させられます。パーソナライゼーションよりも速度を優先する場合は、組み込み音声を使うと実装がシンプルになります。
スタック内の統合ポイント。 YouTubeチャンネルの場合、自然な位置は動画パイプラインです。スクリプトを計画ツールに保存し、完成したらTTS APIに送信し、エディター向けに準備された音声として返します。eラーニングプラットフォームは、レッスンまたはスライドレベルで統合する場合があり、各コンテンツブロックがセグメントにマッピングされ、プロジェクトがコース全体を表します。マーケティングチームは、各記事や製品ページがアクセシビリティのために音声版をリクエストできるよう、CMSレベルで統合することがよくあります。
ガバナンス、コンプライアンス、リスク。 音声クローンは認識可能な音声を複製できるため、同意、ライセンス、使用ポリシーが重要になります。クローンされた音声はIDで識別され、メタデータでタグ付けできるので、特定の音声が使用される場所に関する内部ルールを施行しやすくなります。どの環境でクローン音声と汎用音声をトリガーできるかを事前に決め、自分のシステムにログ記録を追加してください。
レイテンシとユーザー体験への期待。 非同期処理は柔軟性を提供しますが、タイミングに関する考慮事項が加わります。ユーザーが即座の再生を期待するワークフロー——即時プレビュー付きのスクリプトエディターなど——では、小さなプロジェクトやセグメントを作成し、音声がレンダリングされる間に進捗インジケーターを表示してください。ライブラリ全体にわたるバッチローカライゼーションでは、レイテンシの重要性は低く、ジョブをスケジュールで実行し、完了した音声を後でコンテンツレコードに添付できます。
| 判断領域 | バッチモデル | トランザクションモデル |
|---|---|---|
| トリガー | スケジュールされたジョブ | コンテンツ項目またはユーザーアクションごと |
| レイテンシ許容度 | 高い | 低い |
| 最適な用途 | コースカタログ、動画ライブラリ | スクリプトエディター、ライブプレビュー |
| 音声戦略 | 言語ごとの承認済み音声 | 言語ごとの承認済み音声 |
リスクと実践的な予防策
テキスト読み上げAPIを統合すると、いくつかの予測可能なリスクが生じますが、慎重な設計でそれらを軽減できます。
テストせずに音声を選ぶと、ブランドやホストにそぐわない音声が生成される可能性があります。まずインタラクティブなインターフェースで音声を試し、API呼び出しに音声IDを組み込む前に、言語やコンテンツタイプごとに整理された承認済み音声カタログを自分のシステム内に保持してください。
センシティブなコンテンツの過度な自動化はもう1つの落とし穴です。コンプライアンス、医療、法律関連の素材について自動的に音声を生成することは適切でない場合があります。当社のAPIは個別のプロジェクトとセグメントで動作するため、承認されたカテゴリーのみをTTSに送るルーティングルールを維持しつつ、センシティブなコンテンツは人間が録音するワークフローに残すことができます。
運用エラー——失敗したプロジェクトやダウンロードの欠落——は、ネットワークの問題や無効なペイロードが処理を中断したときに発生します。プロジェクトステータスエンドポイントと構造化されたレスポンスにより、公開前にプロジェクトが完了し、その出力が利用可能であることを確認できます。各TTSプロジェクトIDを自分のコンテンツIDと組み合わせ、ステータスチェックがエラーを報告したときのリトライやフォールバックを実装してください。
クローン音声の悪用には明示的な制御が必要です。カスタム音声は専用のエンドポイントで作成し、TTSプロジェクトでIDによって参照する必要があるので、監視のための明確な技術的境界が得られます。誰がクローン音声IDを作成または割り当てられるかを制限し、それらが使用される場所をログに記録してください。
実践的な出発点としては、まず標準的なボイスオーバー向けにTTSを統合し、本番環境で音声とエラー処理を検証し、コアの統合が安定したら音声クローンとAI吹き替えを重ねていくことです。コンテンツ量、ターゲット言語、そしてAPIをスタックのどこに配置すべきかをお知らせいただければ、適切なエンドポイントと、ワークフローに合ったプランをご案内できます。
よくある質問
Text to Speech APIはブラウザツールとどう違いますか?
ブラウザツールは、テキストを貼り付け、音声を選び、手動で音声をダウンロードするビジュアルインターフェースです。APIは同じエンジンをRESTエンドポイント経由で公開しているので、バックエンドがスクリプト、スケジュール、ユーザーアクションに応じて自動的に音声を生成・取得できます。
APIはストック音声だけでなく、自分の声で話せますか?
はい。音声クローンAPIを統合することで、話者の音声サンプルをアップロードし、カスタムAI音声を作成し、その音声のIDをText to Speechセグメントで参照できるので、生成されたすべての音声がクローンされた音声で再生されます。
これは多言語のYouTubeチャンネルやポッドキャストにどう役立ちますか?
当社のプラットフォームは、60以上のソース言語からの音声やスクリプトを、33のターゲット言語にわたる吹き替え出力に変換し、TTSが300以上の音声またはクローンされた音声を使って最終音声を生成します。TTSとAI吹き替えのAPIを公開パイプラインに組み込むことで、スクリプトやソース音声が準備でき次第、新しい動画やエピソードにボイスオーバーや完全な吹き替えを付けられます。
アプリやエディターはどの音声フォーマットを受け取りますか?
TTS APIは、22 kHzのMP3を含む高品質な音声ファイルを提供し、余分な変換なしにほとんどのウェブ、モバイル、動画編集環境に適しています。
今Text to Speechを統合して、後でAI吹き替えを追加できますか?
はい。Text to Speech、音声クローン、AI吹き替えは共通のAPIエコシステムを共有しているので、まずボイスオーバー向けにTTSから始め、後で音声クローンとAI吹き替えを追加して、コアの統合を再構築することなく多言語吹き替えを自動化できます。