音声をクローンするのにどれくらいの音声が必要かという質問への正直な答えは、多くの人が予想するよりも短いものです。DubSmart AI では、1人の話者からの少なくとも20秒のクリーンな録音が必要です。この最小限で使えるクローンの土台はできますが、それがすべてを物語っているわけではありません。実際に録音すべき長さは、その声がどこで使われるか——単発のソーシャルクリップ、繰り返し登場するチャンネルのナレーター、多言語のコースライブラリ、あるいは何十もの動画で同じ声に聞こえなければならないブランドのスポークスパーソンか——によって異なります。以下では、絶対的な最小限と実用的な目標を分けて説明し、モデルが実際に何を聞き取っているのかを解説し、録音ボタンを押す前に適用できる判断ルールをお伝えします。
目次
最小限と実用的な目標の違い
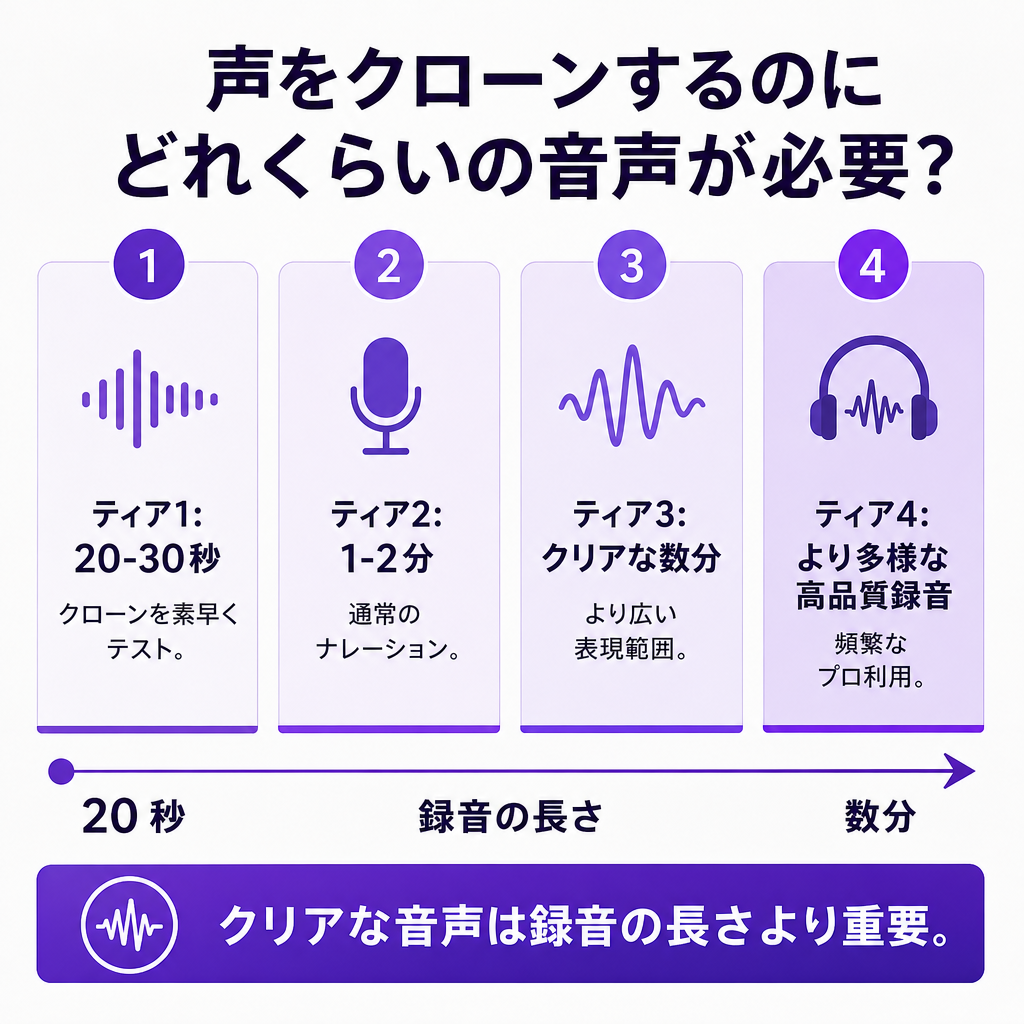
20秒は下限であって、ゴールラインではありません。最小限の長さのサンプルは話者の基本的な特徴を捉えており、クイックテストや単発のクリップには十分なことが多いです。しかし、モデルに与える素材の量は、クローンが多様なスクリプトをどれだけうまく扱えるかに直接影響します。適切な目標は、出力がどれだけ要求が高く、繰り返し使われるかに応じて変わります。
| 目的 | 実用的な音声の目標 |
|---|---|
| クローンを素早くテストする | 20~30秒 |
| 定期的なナレーションを作成する | 1~2分 |
| より幅広い話し方の範囲を捉える | 数分のクリーンな音声 |
| 頻繁なプロ用途の声を構築する | より多様で高品質な録音 |
表全体の根底にある原則は率直です。クリーンで一貫した音声は、通常、ノイズ、エコー、音楽、複数の話者であふれた長い録音よりも価値があります。整った30秒のクリップは、乱雑な10分のものを上回ることができます。サンプルがどのように再利用可能な声になるかの広範な仕組みを知りたい場合は、音声クローニングがどのように声を再現するかに関する解説で、全体のパイプラインを扱っています。
「十分な音声」が実際に意味すること
「十分」というのは実際にはストップウォッチの数字ではなく、モデルがあなたの望む声を再構築するのに十分な有用な音声を持っているかどうかの問題です。声をクローンするとき、AIは録音を分析して一連の特徴を特定し、それらを使ってテキストや翻訳された台詞から新しい音声を生成します。
これらの特徴には次のものが含まれます:
- 声のトーンと音色
- ピッチと話すリズム
- 発音とアクセント
- 間とリズム
- エネルギー、強調、感情的な表現
短いサンプルは話者の中核的な特徴を固定します。より長く、より多様なサンプルは、その人が説明したり、質問したり、強調したり、間を置いたり、感情的なトーンを変えたりするときにどのように聞こえるかという情報を追加します。したがって、本当の目標は代表的な音声です——後で求められるような種類のことを声が行っている様子をモデルに示す素材です。
20秒以上を録音すべきとき
クローンした声が繰り返し登場する、ブランドを代表する、または長編コンテンツを担う場合は、常に最小限を超えて録音しましょう。これらのケースでは、1~2分のクリーンな音声が実用的な出発点となり、より幅広い話し方のスタイルを再現する必要がある場合はさらに追加します。
より長いサンプルは、ナレーションの多い作業で効果を発揮します:YouTube動画、ポッドキャスト、オンラインコース、企業研修、オーディオブック風のコンテンツ、製品説明、多言語吹き替え、キャラクターの台詞、繰り返しのマーケティングキャンペーンなど。落ち着いた導入部分だけを録音するクリエイターは、その1つの落ち着いた音域で最もよく機能するクローンを得る傾向があります。説明、質問、強調、自然な間を録音するクリエイターは、実際に動作している声のはるかに多くの例をモデルに渡すことになります。目的は決して最大の分数を投入することではありません——声が実際にどのように振る舞うかを代表する音声を提供することです。
クリーンな音声が長い音声に勝る理由
より多くの音声が役立つのは、追加の素材が高品質で関連性がある場合に限られます。部屋のエコー、キーボードのカチャカチャ音、背景音楽、マイクの切り替わり、複数の話者がある10分の録音は、短くてクリーンなクリップよりも役に立たないことがあります。大きなノイズも依然としてノイズなので、ゲインを上げても悪いサンプルは決して救えません。
追加の音声がその価値を発揮するのは、それが次の条件を満たすときです:
- 1人の人物によってはっきりと話されている
- 音量とマイクとの距離が一貫している
- 音楽、効果音、重なる声がない
- 静かでエコーの少ない環境で録音されている
- 自然なペースで話されている
- 生成したいスタイルを代表している
いくつかの録音の習慣は、どんな長さの目標よりも品質を守ります。クリップには1人の話者だけを含めてください。他の声は分析を混乱させます。反射を減らすために、大きな空っぽの部屋よりも小さな家具のある部屋を選び、全体を通してマイクとの距離を一定に保ちましょう。ある部分を近くで、別の部分を部屋の向こうから録音しないでください。また、長い無音や無関係な音声でファイルを水増しするのは避けましょう。唯一のソースがノイズの多い動画である場合は、長さで補えることを期待するのではなく、まずそれをクリーンにしてください——音声から背景音楽を除去する方法のガイドで、そのクリーンアップを解説しています。
サンプルが実際に話すべき内容
内容は状態と同じくらい重要です。録音には、孤立した音や激しく切り刻まれたフレーズではなく、明瞭で自然な音声が含まれているべきです。優れたサンプルは、短い文と長い文、さまざまな母音と子音の音、数字と日付、名前と一般的な用語、質問、強調的な発言、自然な間を組み合わせます——理想的には、最終的なコンテンツで使用されるのと同じ種類の言語で。
実際にそれがどのようなものになるかはクリエイターによって異なります。YouTuberは短い導入、説明、行動喚起、そしてさまざまな強調レベルのいくつかの行を録音するかもしれません。eラーニングの制作者は、指導的な言い回し、定義、リスト、つなぎを含めることができます。ビジネスのスポークスパーソンは、ブランド用語や顧客向けコンテンツで使われる会話調のスタイルを織り込むと効果的です。そもそもここでクローンが必要かどうかを判断するのは正当な質問です。クローン音声とストックTTS音声の比較は、ライブラリの声がより速く仕事をこなせる場合に役立ちます。
多言語クローニングとノイズの多いソース音声
多言語プロジェクトでは、出発点となる要件は依然として元の音声サンプルの品質です。生成された音声を他の言語に翻訳しても、明瞭なソース録音の必要性がなくなるわけではありません——不明瞭な英語のクリップは、すべてのターゲット言語で不明瞭なクローンを生み出します。
ローカライズを計画する際は、元の声の明瞭さ、名前やブランド用語の発音、各言語での意図したトーン、話者のスタイルがフォーマル、フレンドリー、エネルギッシュ、会話調のいずれであるべきか、そして吹き替え前に翻訳スクリプトがレビューされているかに注意を払いましょう。大規模なローカライズプロジェクトでは、フル動画を処理する前に各ターゲット言語で短いセクションをテストしてください。これにより、発音、ペース配分、文化的適応の問題が早期に明らかになります。DubSmartのAI吹き替えワークフローは翻訳コンテンツにクローン音声を使用でき、クローン音声はText to SpeechとAI吹き替えの両方で使用できます。
ソースの品質がこの問題のもう半分です。動画から音声を抽出できることはよくありますが、背景音楽、効果音、部屋の環境音、風、観客のノイズ、重なる音声、圧縮アーティファクトはすべて、クリップを不十分な出発点にします。ソースが価値があるがノイズが多い場合は、まず音声を分離してください。Speech Separatorは他の音声要素から声トラックを引き離し、そのトラックがクリーンであればあるほど、クローンの信頼性が高まります。
同意と声をクローンする権利
他人の声をクローンできるのは、適切な許可と権利を持っている場合のみです。音声クローニングには実際の法的、倫理的、プライバシー、なりすましのリスクが伴うため、他人の録音をアップロードする前に、その人のインフォームドコンセントを得て、声がどのように使用、配布、保持されるかを確認してください。米国連邦取引委員会(FTC)の音声クローニングチャレンジのルールでは、参加者は声をクローンされる本人の同意がある場合にのみ声をクローンすることが求められました。
商業的な作業では、誰が声を所有または管理しているか、どの録音が使用できるか、どのコンテンツタイプと言語が許可されているか、商業利用が許可されているか、許可がどのくらい続くか、その人が撤回できるか、そして適切な場合に合成コンテンツがどのように開示されるかを文書化してください。単に録音にアクセスできるからといって、公人、従業員、顧客、俳優、家族をクローンしないでください。アクセスは許可ではありません。
クリエイタータイプ別の録音量
同じ最小限が全員に適用されますが、実用的な目標は制作のリスクによって変わります。スピードが重要なとき——初期のクリエイティブテスト、ショートフォームのクリップ、社内のプロトタイプ、シンプルなアナウンス——には最小限を使い、多くの動画や言語にわたって声が一貫している必要があるときは、常にそれ以上を録音しましょう。
| クリエイター | 推奨サンプル |
|---|---|
| YouTubeクリエイター | テストには20秒;繰り返し使うナレーターには1~2分のクリーンで表現力豊かな音声 |
| 中小企業/マーケティング | キャンペーン用語とエネルギーを含む一貫したスポークスパーソンのクリップ;まず短いナレーションをテスト |
| eラーニング/研修 | 定義、指示、質問、つなぎをカバーする、より長く多様なサンプル |
| ポッドキャスター | ホストの通常のペースを反映したサンプル;名前とスポンサーの発音を確認 |
| 映像制作者 | ささやき、激しさ、その他の劇的な特性を含む、キャラクターの演出に合ったサンプル |
| 開発者/代理店 | クライアントのサンプルを受け入れる前に適用される再現可能な音声基準 |
その表の背後には2つの実用的な注意点があります。ニュートラルなサンプルは、ささやき、皮肉、恐怖に依存するパフォーマンスを再現しないため、映像制作者は声だけでなくキャラクターを捉えるべきです。そしてAPI駆動のパイプラインでは、固定の受け入れ基準がクライアント間での一貫性のない結果を防ぎます。私たちのVoice Cloning APIは音声サンプルからカスタム音声を作成し、それらをText to SpeechとAI吹き替えで利用可能にします。
アップロード前の短いチェックが結果を予測可能に保ちます。サンプルが少なくとも20秒あること、1人の話者であること、音楽や重なる声がないこと、エコーと背景ノイズが最小限であること、マイクの位置とレベルが一定であること、長い無音ではなく自然な音声が含まれていること、意図したスタイルに合っていること、そして意図した用途に同意した話者からのものであることを確認してください。
コンセプトをテストするには20秒、信頼できる日常的なナレーションには1~2分、そして声が長編や多言語コンテンツにわたって一貫してパフォーマンスしなければならない場合は、より多様なクリーンな音声を使用してください。
最小限はスタートを切らせてくれます。録音品質、話者の一貫性、表現の幅、そして許可が、その結果が公開できる状態かどうかを決めます。
よくある質問
声をクローンするのにどれくらいの音声が必要ですか?
DubSmartでは少なくとも20秒の音声が必要です。話者の話し方をよりよくカバーするには、1~2分のクリーンで自然な音声を目指しましょう。
10秒で声をクローンするのに十分ですか?
一部のシステムでは十分かもしれませんが、DubSmartが定める最小限を下回ります。DubSmartのクローンには少なくとも20秒をアップロードしてください。
音声クローニングに1分で十分ですか?
クリーンで一貫しており、自然に話されていれば、日常的なナレーションには多くの場合十分です。表現力豊かな用途やプロ用途には、より大きく多様なサンプルが役立ちます。
録音が長いほどクローンは正確になりますか?
自動的にそうなるわけではありません。追加の長さが役立つのは、それが声のクリーンで関連性のある例を加えるときだけです。ノイズ、エコー、音楽、複数の話者は追加音声の価値を下げます。
声をクローンするのに許可が必要ですか?
はい。他人の声をクローンする前に、意図した用途、配布、商業活動を含めて、同意を得て該当する権利を確認してください。FTCの音声クローニングチャレンジのルールでも、声をクローンされる本人の同意が求められました。
音声クローンをAI吹き替えに使用できますか?
はい。作成した音声はText to SpeechとAI吹き替えの両方で使用できます。