AIナレーションがどのように作られるのかを尋ねるということは、実際には、書かれたスクリプトがブースに入ることなくどうやって音声になるのかを尋ねているのです。手短に言えば、ニューラルなテキスト読み上げモデルがあなたのスクリプトを合成音声に変換し、オプションのクローン音声がその音声を特定の人物のように聞こえさせ、吹き替えレイヤーがすべてを言語をまたいで動画に合わせます。DubSmart AIでは、そのチェーン全体を1つのワークスペース内で実行するため、ツールを切り替えたりスタジオの時間を予約したりすることなく、テキストの一段落から完成した多言語ナレーションまで進むことができます。
そのプロセスがあなたにとってどのように見えるかは、1つの決定にかかっており、このガイドの残りの部分では、その仕組み、選択肢、そして選び方について説明します。
目次
AIナレーションの作られ方の背後にある決定
音声が生成される前に、以降のすべてを形作る2つの選択をします。1つ目は、ライブラリからの既製の音声が欲しいのか、それとも自分自身のクローンが欲しいのか。2つ目は、単一言語のナレーションが必要なのか、それとも複数言語にわたる完全にローカライズされたバージョンが必要なのかということです。
YouTubeクリエイターや小規模ビジネスにとっては、これはたいていすぐに決まります。スピード重視ならストック音声を選び、ブランドの一貫性が重要ならば音声をクローンし、多言語展開するときだけ吹き替えに手を伸ばします。開発者やエージェンシーにとっては、同じ分岐がアーキテクチャの問題になります。単発の音声のためにテキスト読み上げエンドポイントを呼び出すのか、それとも音声クローンと吹き替えを組み合わせて自動で動くパイプラインにするのか。
私たちはまさにこれらの分岐を中心にDubSmartを構築しました。テキスト読み上げ、音声クローン、音声認識、音声セパレーター、テキストから画像、画像から動画、そしてAI吹き替えのすべてが1つのプラットフォームに存在するため、別々のベンダーをつなぎ合わせることなく、自動化とパーソナライゼーションのレベルを上下させることができます。
仕組み:AIナレーションが実際にどう作られるか
テキスト読み上げ:スクリプトを音声に変える
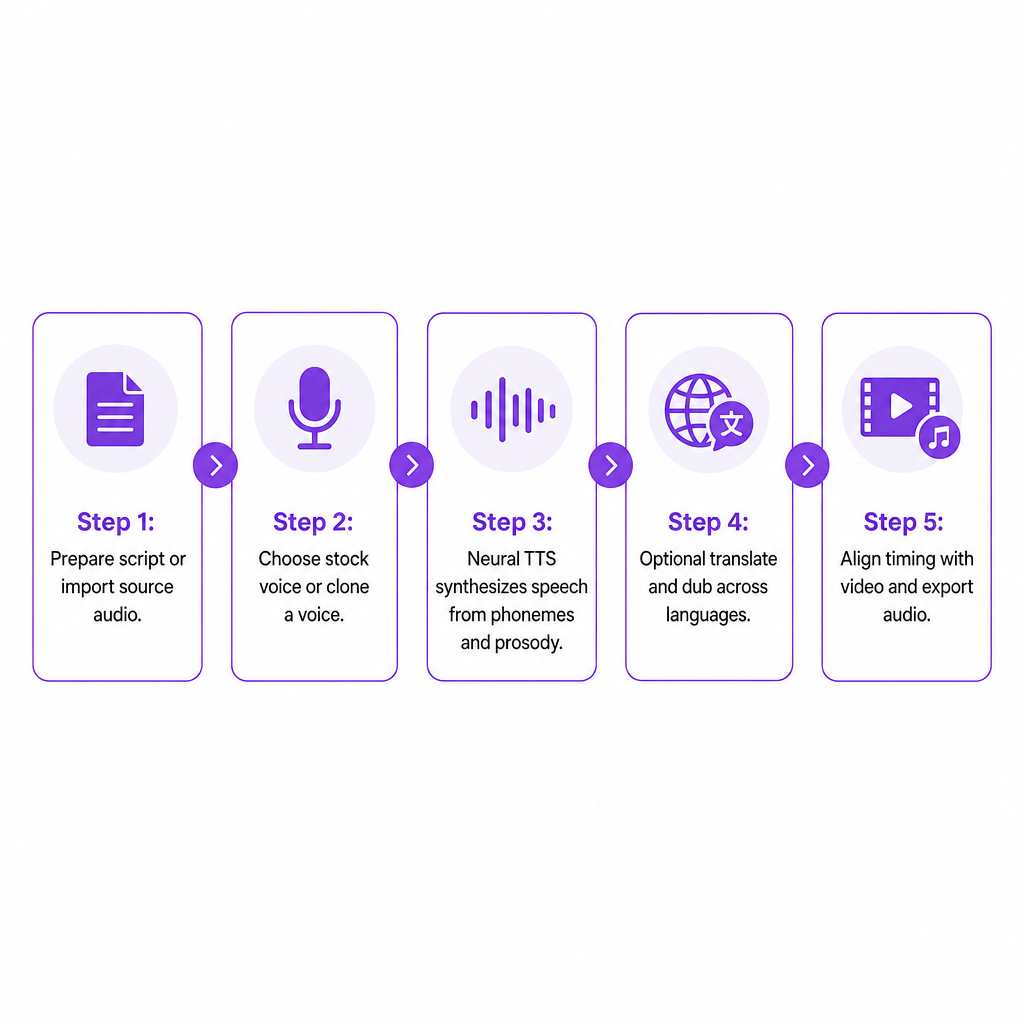
テキスト読み上げ(TTS)は、すべてのAIナレーションの中心に位置します。エンジンはまずあなたのスクリプトを分析します——テキストを音素に分解し、句読点や構造を読み取り、韻律を推測します。韻律とは、音声が平坦に聞こえないようにするリズム、強調、イントネーションのことです。次にニューラルモデルがそれらの音素を音声に合成し、ロボット的ではなく流暢に聞こえるようにする韻律パターンを適用します。
私たちのテキスト読み上げエンジンでは、任意の言語でテキストを貼り付け、300以上のライブラリから音声を選び、数秒でリアルな音声を生成できます。音声は自然で人間らしく、言語、性別、スタイルごとに分類されているので、制作しているものの雰囲気に合わせることができます。開発者にとっては、同じエンジンがRESTfulなテキスト読み上げAPIを通じて公開されています。テキストと音声パラメータを含むPOSTリクエストを送信すると、すぐに使える音声ファイルが返ってきます。構造化されたテキストを入力すると、リアルな音声が出力され、手動録音は不要です。
音声モデルと音声ライブラリ
AIナレーションは、訓練された音声モデルに依存しています——これは、特定の音声がさまざまな単語、言語、感情にわたってどう聞こえるべきかを学習するニューラルネットワークです。音声ライブラリとは、単にそれらのモデルのカタログです。私たちは、多くの言語にわたって複数の性別、アクセント、話し方をカバーする300以上の自然な音声のライブラリを維持しており、Webアプリとオンデマンドで音声を生成できるように内部ツール向けのAPIの両方で利用可能です。
音声クローン:AIをあなたのように聞こえさせる
クローンは、ナレーションを汎用的なナレーターではなく特定の人物のように聞こえさせる仕組みです。システムはサンプル録音を分析し、話者の音色、ピッチ範囲、発音パターンを学習し、それらの特性を新しい合成音声に適用します。
実際には、少なくとも20秒の音声ファイルを音声クローンにアップロードします——理想的にはクリーンで背景ノイズのないものです。私たちはそのサンプルを、名前を付けて再利用できるカスタム音声プロファイルに処理し、クローンは通常わずか数秒で完了します。作成されると、クローン音声はテキスト読み上げとAI吹き替えの中で利用可能になり、あなた自身の声でスクリプトや吹き替えバージョンを生成できます。プログラム的には、音声クローンAPIがこれを反映します。アップロードURLを取得し、サポートされる形式で音声を送信し、結果として得られたファイルキーからカスタム音声を作成し、それをTTSまたは吹き替えプロジェクトで使用します。
吹き替えと多言語ナレーション
単一言語のナレーションから多言語コンテンツへ移行することは、基本的なTTSの上にローカライゼーションを追加します。一般的なパターンは一貫しています:
- 元の音声をキャプチャまたはインポートする。
- それをテキストに書き起こす。
- そのテキストを翻訳する。
- ターゲット言語で新しい音声を生成する。
- 元の動画または音声とタイミングを合わせる。
私たちのAI吹き替えワークフローはまさにこのパターンに従い、音声認識、機械翻訳、テキスト読み上げを組み合わせ、オプションでクローン音声を再利用して吹き替えトラックが元の話者に一致するようにします。60を超える元言語からの音声コンテンツを、33のターゲット言語にわたる吹き替えバージョンに変換します。音声から音声への吹き替えは、元のパフォーマンスに近いトーンとタイミングを保つことを目指しており、これはリップシンクとペースが体験を左右するeラーニング、トレーニング、映画コンテンツで最も重要です。
APIと自動化されたワークフロー
大規模にナレーションを制作するチームにとって、APIは音声作成を既存のシステムに組み込むものです。TTS APIはテキスト入力・音声出力を処理し、音声クローンAPIはカスタム音声のプログラム的な作成と管理を追加し、AI吹き替えAPIはその両方を、クローン音声へのアクセスを伴う33以上の言語にわたる自動翻訳と吹き替えに拡張します。これらを組み合わせることで、コンテンツシステムから取得したスクリプト、字幕、または書き起こしが手動でのファイル操作なしに自動的にナレーションや吹き替えトラックになるパイプラインを構築できます。
DubSmartでAIナレーションを作る3つの方法
私たちのプラットフォーム内では、この問題は3つの実用的な出発点に解決されます。
テキスト読み上げでスクリプトから始める。テキストを貼り付け、ストックまたはクローン音声を選び、言語と基本的なコントロールを設定し、標準形式でダウンロードできる音声を生成します。これは、最初からスクリプトを所有しているトレーニング動画、解説コンテンツ、マーケティング広告、ポッドキャストのイントロに適しています。
AI吹き替えで既存のメディアから始める。ソース動画または音声ファイルをアップロードし、システムに書き起こしと翻訳をさせ、選択した言語で吹き替えトラックを生成します——クローン音声を再利用してサウンドの一貫性を保ちます。これは、多言語のオーディエンスに拡大するチャンネルや、ウェビナーや製品デモを再利用するビジネスのためのルートです。
APIベースの生成で自分自身のシステムから始める。あなたのアプリがテキストと音声パラメータをTTS APIに送信し、オプションで音声クローンAPIを通じてコンテンツを特定の音声に結び付け、トレーニングモジュール用の動画やeラーニングナレーションに添付する準備ができた音声を取得します。これは、一貫したプログラム的な出力を必要とする開発者、エージェンシー、LMSプロバイダーに適しています。
判断基準:AIナレーションのセットアップを選ぶ
自然さと音質
自然さは譲れません。強力なエンジンは韻律と発音をモデル化し、音声が適切な間と強調をもって流れるようにします。生成が高速なため、最初のテイクで妥協するのではなく、配信がしっくりくるまでスクリプトを反復して音声を再生成できます。
言語カバレッジとローカライゼーションの深さ
多言語チャンネルや国際的なトレーニングがロードマップにあるなら、カバレッジがどこまで届くかを決めます。60以上の元言語からのコンテンツを1つのワークフローで33のターゲット言語に変換することが、あなたがサービスを提供できる市場を定義し、音声から音声への吹き替えがすべてのバージョンでトーンとタイミングを一貫させるのに役立ちます。
音声ブランディングとクローン機能
認識可能な音声は、企業、クリエイター、ポッドキャストにとって重要です。クローンにより、言語やチャンネルをまたいで同じ音声を持ち運ぶことができます。約20秒のクリーンな音声からクローンでき、そのプロファイルをテキスト読み上げとAI吹き替えの中で再利用できることが、シグネチャーサウンドを確立し維持することを実用的にします。
ワークフローのシンプルさ対技術的な統合
クリエイターは、アップロード、編集、ダウンロードが1か所で処理されることを望むことが多いです。技術チームはAPIを必要とすることが多いです。私たちは両方を提供します。統合されたアプリのユーザー向けツールと、同じエンジンを公開する開発者向けAPIです。選択は、チームが主にブラウザで作業するのか、内部システム上に構築するのかにかかっています。
速度、スケーラビリティ、一貫性
ナレーションツールは、制作を短縮し、品質を落とさずにスケールすべきです。ほぼ瞬時のTTS生成と数秒で完了するクローンにより、迅速な反復と大量出力が可能になり、APIにより数千のスクリプトやセグメントが一貫した音声と設定で自動的に処理されます。
予算構造とコントロール
セッションごとのスタジオ料金の代わりに、AIナレーションツールは一般的に使用量ベースの価格設定を使用します。私たちのクレジットベースのモデルは、1つのアカウントでAI吹き替え、テキスト読み上げ、音声クローン、音声認識、音声セパレーター、テキストから画像、画像から動画へのアクセスを提供し、無料プランとエンタープライズプランがあります。クレジットは予測可能な使用上限を提供し、ボリュームが増えたときにはロールオーバーとスケーリングが利用可能なままです。ランタイムに対してクレジットのサイズを決めたい場合は、AI吹き替えの1分あたりのコストの内訳が計算方法を説明しています。
コンプライアンス、同意、データ処理
クローンと合成音声には倫理的および法的な重みがあります。私たちは、あなたが権利を持つ音声をアップロードすることを要求し、最良の結果のためにクリーンな録音を推奨しており、これが同意とコントロールを中心に保ちます。私たちのAPIドキュメントは、安全な事前署名付きアップロードURLと標準的な音声形式を使用しており、開発者にアプリケーション内でのコンプライアンスに準拠した使用のための明確なパターンを提供します。
計画に織り込む価値のあるリスク
有能なツールを使っても、いくつかの失敗モードは予想しておく価値があります。
不自然またはロボット的な音声は、通常、句読点が不適切なスクリプトやコンテンツに合わない音声にさかのぼります。自然な音声のライブラリから選び、配信が合うまで再生成することが実用的な解決策であり、高速な生成がその実験を安価にします。
発音ミスは、名前、専門用語、ローカライズされたコンテンツで表面化する傾向があります。盲目的な音声から音声への変換ではなく、書き起こし、翻訳、レビューを実行するパイプラインは、これらのエラーがリリースされる前により多くを捉えます。
合成音声と画面上のビジュアルの間のタイミングのミスマッチは、視聴者体験を損ないます。元のトーンとタイミングに近い音声から音声への吹き替えと、プロジェクト環境内での編集を組み合わせることで、位置合わせをより良くコントロールできます。
倫理的には、適切な権利なしに音声をクローンすることは深刻な問題を招きます。あなたのコントロール下にあるクリーンなサンプルを要求し、クローンを匿名のなりすましではなくクリエイターやビジネスのためのツールとして位置づけることが、この慣行を責任あるものに保ちます。既存の映像をローカライズする場合、動画内の音声言語を変更する方法に関する私たちのガイドが、レビューしやすい道筋を示しています。
さまざまなクリエイターがこれをどう実践するか
海外展開するYouTubeクリエイターは、AI吹き替えとクローン音声を使って1本の英語動画をスペイン語、ポルトガル語、ドイツ語のバージョンに変えることができ、ホストがすべての市場で認識可能なままになります——すべて60以上の元言語と33のターゲット言語のパイプライン内で。
小規模ビジネスやマーケティングチームは、製品の解説や広告スクリプトをドキュメントで下書きし、テキスト読み上げで音声に変換し、ブランドのトーンに合う音声を選ぶことができます——エネルギッシュ、フォーマル、または会話的なもの。それらの同じスクリプトは、後でクローンされたブランド音声を使ってAI吹き替えを通じてローカライズできます。
eラーニングや企業研修の制作者は、レッスンのテキストをTTS APIを通じて送信し、返された音声を各モジュールに添付することで、スライドデッキやSCORMパッケージのナレーションを自動化でき、クローンにより地域ごとのバージョンをまたいでも講師の声を一貫させます。
独立系映画製作者やポッドキャストクリエイターは、すべての言語でスタジオを予約することなく、予告編、プロモ、翻訳された対話を制作でき、音声認識、AI吹き替え、クローン音声を組み合わせてキャラクターのアイデンティティを安定して保ちます。
開発者やエージェンシーは、TTS、音声クローン、AI吹き替えのAPIを内部ツールやクライアントプラットフォームに組み込むことができ、ショート形式のソーシャルナレーションからインタラクティブな音声エージェントまであらゆるものを自動化できます。
よくある質問
AIナレーションは従来の録音されたナレーションとどう違いますか?
従来のナレーションには、人間の声優、スタジオの時間、複数のセッションが必要です。AIナレーションは、ライブパフォーマンスの代わりに訓練されたニューラルモデルを使ってスクリプトを直接音声に変えるテキスト読み上げおよび音声クローンエンジンによって生成されます。
AIナレーションを特定の人物のように聞こえさせることはできますか?
はい。音声クローンは誰かの声の短いサンプルを分析し、その声で任意のスクリプトを話せるカスタムモデルを構築します。私たちの音声クローンツールとAPIで利用可能です。
音声をクローンするにはどれくらいの音声が必要ですか?
信頼できるクローン音声プロファイルを作成するために、背景ノイズのないクリーンな音声を少なくとも20秒お願いしており、クローンは通常数秒で完了します。
1本のソース動画から複数言語のナレーションを作れますか?
はい。私たちは音声認識、翻訳、テキスト読み上げを組み合わせて、60以上の元言語からのコンテンツを33のターゲット言語にわたる吹き替え出力に変換するため、1本の元動画から多くのローカライズされたナレーションを制作できます。
インターフェースを使う代わりにナレーション作成を自動化する方法はありますか?
私たちのTTS APIと音声クローンAPIにより、アプリや内部ツールがテキストと音声サンプルを送信し、カスタム音声を作成し、合成音声をプログラム的に受け取ることができるため、ナレーションを大規模に自動生成できます。