AI音声分離とは、ノイズの混ざった音声から人間の声を抽出し、文字起こし、吹き替え、ボイスクローンにすぐ使えるクリーンな音声トラックを返してくれるディープラーニング処理です。この一つの機能こそが、多くのクリエイターが実際に抱える疑問に答えてくれます。つまり「撮り直さずにこの録音を救えるのか?」という疑問です。AI音声分離の仕組みを理解すれば、いつそれに頼るべきか、そもそもいつよりクリーンに録音すべきか、そしてクリーンな音声トラックがいかにその後の工程すべてをさりげなく改善するかを判断できるようになります。このガイドでは、その仕組み、単一話者の音声を強調することと複数の声を分離することの違い、この処理がローカライゼーションのパイプラインのどこに位置するのか、そしてそれでも解決できないことは何かを解説します。
目次
音声分離の背後にある判断
あらゆる実際の録音は、話者の声だけではなくそれ以上のものを捉えています。Vlog、ウェビナー、トレーニング動画、ポッドキャストは、街の騒音、部屋の環境音、BGM、キーボードのクリック音、そして重なり合うおしゃべりを拾ってしまい、肝心の言葉を埋もれさせてしまうことがあります。音声分離ツールは、そうした混合を解きほぐすために存在します。1つの混合ファイルを受け取り、主に人間の声を含むトラックと、残りの背景音を含むオプションのトラックを返します。
そのクリーンな音声トラックは、次に来るあらゆる工程の基盤となります。正確な音声からテキストへの変換、多言語吹き替え、高忠実度のボイスクローン、あるいは単に元の音声をより良く聴かせることです。つまり、本当の判断は技術的なものではなく、実践的なものです。多言語コンテンツを構築するのに十分な信頼を今の音声に置けるのか、それともまずAIで音声をクリーンにして分離したいのか。そして、単体のクリーンアップツールがほしいのか、それとも複数のアプリを行き来せずに済むよう、より広範な制作・ローカライゼーションプラットフォームに組み込まれた分離ツールがほしいのか、ということです。
私たちは音声分離ツール(Speech Separator)を、統合されたワークフローにおける最初のAIゲートとして機能するよう設計しました。音声からテキストへの変換、テキストから音声への変換、ボイスクローン、吹き替えの前に位置するため、あらゆる下流のシステムは、部屋にあったノイズをそのまま受け継ぐのではなく、可能な限り明瞭な音声信号を受け取ります。
仕組み:波形からクリーンな声へ
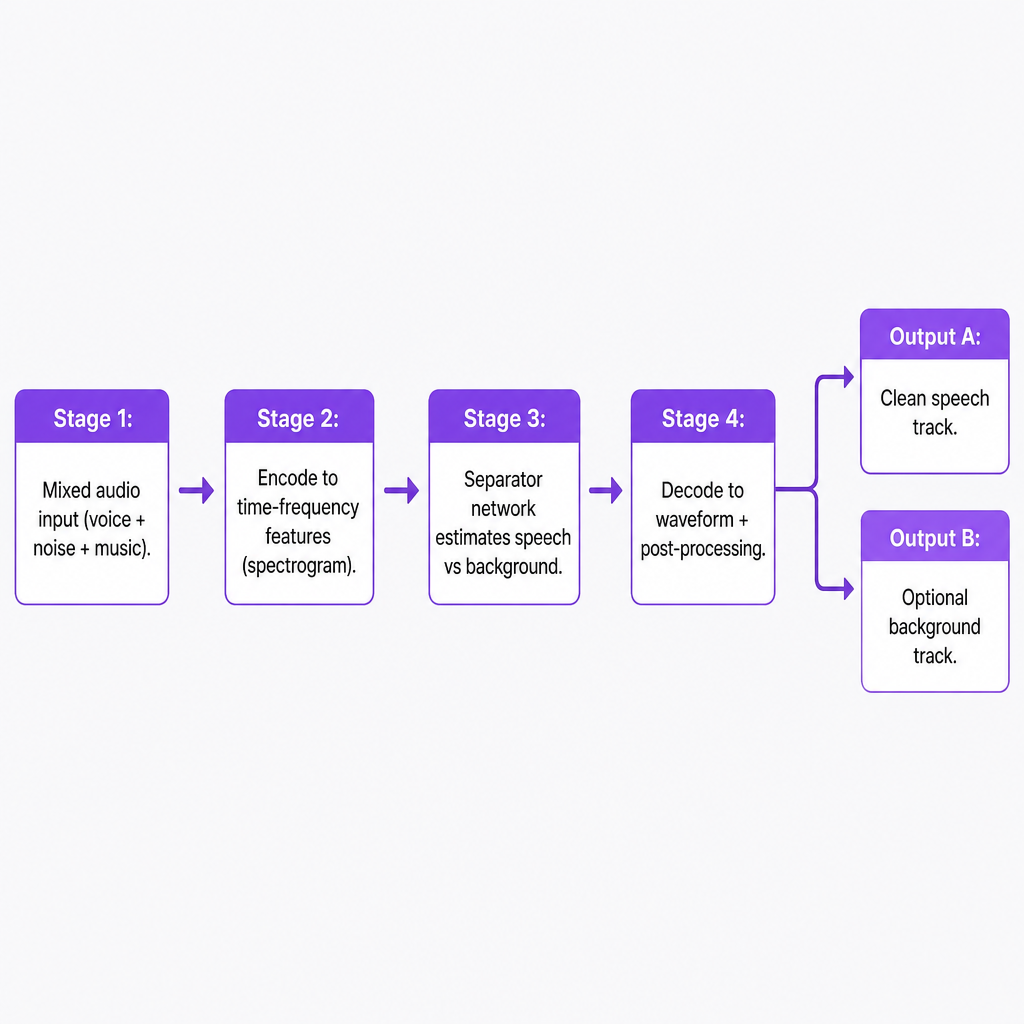
現代のAI音声分離は、4つの段階からなるパイプラインに従います。信号をエンコードし、学習された特徴空間で音源を分離し、クリーンな音声を推定し、それを音声にデコードして戻す、という流れです。
波形から特徴量へ
ほとんどのシステムは、まずマイクからの生の波形を、スペクトログラムのような時間周波数表現に変換します。これは、異なる周波数帯域のエネルギーが時間とともにどう変化するかを示すものです。この表現により、ニューラルネットワークは人間の音声とノイズや音楽に対応するパターンを見分けやすくなります。次にエンコーダーネットワークが入力を高次元の特徴空間にマッピングし、異なる音源がより区別しやすくなり、フォルマント、倍音、時間構造といった音声の特性を強調しつつ、無関係な背景コンテンツを抑制します。
分離ネットワークとマスク
この処理の核心は分離ネットワークです。これは、各時間周波数ポイントで何が声に属し何がそうでないかを判断するよう訓練されたディープモデルです。主に2つの戦略があります。マスクベースの分離は、音声エネルギーを保持しそれ以外のすべてを減衰させるマスクをスペクトログラムに対して予測します。これを元のスペクトログラムに適用すると、背景ノイズと音楽が大幅に減少し、音声が残ります。一方、直接音源推定は、クリーンな音声スペクトログラム自体を予測し、場合によっては残りの背景も予測して、それを音声にデコードして戻します。
より難しいケースには、より専門的なアプローチがあります。ディープクラスタリングは、各時間周波数ビンの埋め込みを学習し、同じ音源からのビンがクラスターとしてまとまるようにします。その後、標準的なクラスタリングによって音声を他の音源から分離します。他のモデルは順列不変訓練(permutation-invariant training)を使い、どの話者が出力1でどの話者が出力2かを仮定することなく、複数の話者を分離できます。
教師あり例による訓練
これらのモデルは、正解となるクリーンな音声とペアになった混合音声の例から学習し、出力と参照との差を最小化するよう自らを調整します。訓練の目標はマスク、クリーンなスペクトログラム、または再構成された波形であり、損失関数はしばしば信号対歪み比のような知覚品質の指標に結びついています。アクセント、マイク、環境にわたる多様なサンプルを大量に与えられることで、ネットワークは人間の音声を背景コンテンツから分離する頑健な手がかりを内在化し、これまで見たことのない録音にも汎化します。
音声へのデコード
最後にシステムは、分離された音声表現を逆変換によって時間領域の波形にマッピングし、その後にノイズ除去やラウドネス正規化といった後処理を行います。その結果、音声が主体となったトラックが得られ、単独で使うことも、自然さのために一定量の背景と再結合させることもできます。私たちの音声分離ツールはまさにこのパターンに従っています。アップロードされた音声または動画を取り込み、分離パイプラインを実行し、音声に焦点を当てたトラックとオプションの背景を返すので、最終的なミックスをどれだけドライにするか、あるいはアンビエントにするかをあなたが決められます。
単一話者の強調と複数話者の分離
1人の主要な話者を強調することと、複数の重なり合う声を本当に分離することの間には重要な線引きがあり、それが現実的に何を期待できるかを左右します。
単一話者の強調は、背景ノイズ、残響、非音声の音から1つの主要な声を分離するので、明瞭度が跳ね上がります。これは、問題が声の重なりではなく環境ノイズやBGMであるVlog、ウェビナー、講義、トーキングヘッド型のコンテンツで特にうまく機能します。私たちの音声分離ツールはこのケースに最適化されており、人間の音声を主音源として扱い、それ以外のすべてを背景として扱い、クリーンにされた音声トラックとオプションの背景トラックを提供します。
複数話者の分離は別のタスクです。複数の人が同時に話している混合音声を、声ごとに1つずつ個別のストリームに分割します。研究モデルでは、話者数ごとに異なるネットワークを訓練し、各サンプルに最も合うものを選ぶことで、1本のマイクから最大5つの声を分離しています。ディープクラスタリングやマルチマイクのニューラルビームフォーミングといった技術は、遠距離場やマルチチャンネルの設定でさらに性能を押し上げますが、より複雑で計算負荷が高くなります。実際には、これらのシステムは依然として、日常のクリエイターのワークフローよりも、会議の文字起こし、コールセンター、スマートデバイスといった専門的なシナリオを対象としています。YouTubeチャンネルの運営、マーケティングチーム、コースライブラリなどを扱う私たちのユーザーの多くにとって、最大の実用的な効果は、完全な複数音声の分割ではなく、強力な単一話者の強調と音声対背景の分離から得られます。
ローカライゼーションのワークフローにおける分離の位置づけ
分離は、ノイズの多い現実世界の録音と高品質なAI音声作業とをつなぐ橋渡しです。典型的な流れは、いくつかのツールをスムーズに通っていきます。
クリエイターが音声または動画ファイルをアップロードすると、分離ツールが音声トラックを、そしてオプションで背景を分離します。そのクリーンな音声は音声からテキストへの変換に送られ、文字起こしと翻訳が明瞭な信号に対して行われるため、精度が向上し、大きな音楽やノイズによって引き起こされる幻聴的な単語(ハルシネーション)が減少します。得られたテキストと翻訳は次にテキストから音声への変換とAI吹き替えに進み、クローンまたは合成された声を使って新しい言語版を生成します。元の音声がクリーンだったため、時間的なアラインメントがより正確になり、ポンピングのようなミックスのアーティファクトが減少します。
ボイスクローンも同じクリーンな入力に依存します。モデルは、話者の音色、抑揚、発音を確実に学習するために比較的ノイズの少ない例を必要とし、分離はクローン音声を歪ませかねない背景の汚染を減らします。スペイン語の分離ガイドは、日常的な体験をうまく捉えています。ファイルをアップロードし、AIに声を背景から分離させ、その後クリーンな音声トラックまたは分離された背景をダウンロードして、さらなる編集、吹き替え、ナレーションに使う、これらすべてを1つのワークフローの中で行えるのです。この統合こそが、そうでなければ個別のノイズ除去プラグイン、文字起こしツール、吹き替えサービス、クローンプラットフォームの間を行き来することになる小規模チームにとってのポイントです。
AI音声分離の選び方と使い方
分離をどう取り入れるかを判断する際、いくつかの実践的な基準がほとんどの仕事をこなしてくれます。
音声の状態とコンテンツの種類。主要な話者が1人で、背景ノイズや音楽が中程度の場合、分離は非常に効果的でリスクも低くなります。声が大きく重なっている場合、遠距離場のマイク、または非常に低品質な入力の場合は、効果が逓減することを覚悟し、すべてを救うことをAIに頼るのではなく、より良い録音とAIを組み合わせましょう。
下流ツールとの統合。文字起こし、テキストから音声への変換、吹き替えへと直接流れる分離ツールは、アプリ間でエクスポートと再インポートを行うのに比べて、摩擦と累積するアーティファクトを減らします。私たちがまさにこの理由で音声分離ツールを残りのローカライゼーションツールと連携させているのは、あなたの目標が一度きりのノイズ除去ではなく多言語での公開である場合により重要になります。
背景音のコントロール。ブランドのストーリーテリングでは、感情的なインパクトのために環境音や音楽をある程度残したいことがよくあります。クリーンな音声トラックと分離された背景の両方を出力するシステムは、1つのノイズ除去済みミックスしか生成しないツールよりも編集者に余地を与えます。私たちの分離ツールはこの「音声+オプションの背景」というパラダイムをサポートしているので、意図的にリミックスできます。
速度、シンプルさ、スケール。クリエイターや小規模チームにとって、使いやすさは純粋な性能に匹敵します。一般的なフォーマットを自動処理し、ブラウザやAPIを通じてワンクリックで分離できることは、音声エンジニアリングの専門知識を前提とする複雑なプラグインチェーンに勝ります。数百本の動画やコースモジュールを管理するようになれば、バッチ処理と自動化はもはや贅沢ではなくなります。
信頼性とアーティファクト。優れたモデルは、明らかな歪み、金属的なリンギング、呼吸のアーティファクトを加えることなく明瞭度を向上させます。デモはシステムをよく見せることがあるので、どんな分離ツールもパイプラインの固定部分にする前に、あなた自身の代表的な録音でテストしましょう。
プライバシーとコンプライアンス。分離は、機密情報を含む可能性のある音声データを直接扱います。企業チームは、音声がどのように保存されるか、モデルの訓練に使われるかどうか、保持とアクセスにどのような管理が存在するかを、特に規制のある業界や社内トレーニングコンテンツについて確認すべきです。
これらの基準を、チャンネル拡大、トレーニング、マーケティング、ナラティブ作業、あるいはAPI製品など、あなたの実際のユースケースと照らし合わせて検討すれば、下流の音声ツールを備えた統合型の分離ツールがあなたの運用方法に合うかどうかがわかります。
リスク、限界、そして解決できないこと
強力なモデルでさえ、導入する前に知っておく価値のある明確な限界があります。
- 極端なノイズ、または非常に低い信号対雑音比。音声が大きなノイズや音楽の下に埋もれている場合、モデルはすべての言葉を復元できず、ドロップアウトやこもった出力を生じることがあります。
- 激しい話者の重なり。人々がまったく同時に話すことは、高度な複数話者システムでさえ困難にし、音声が分離されたストリーム間で漏れ出す原因になり得ます。
- 過剰分離によるアーティファクト。積極的なマスキングは、持続する音や歯擦音で最も顕著に、音楽的ノイズやロボットのような音色を招くことがあります。
- 訓練と現実のミスマッチ。特定のマイク、言語、環境に調整されたモデルは、まったく異なる録音では性能が落ちることがあり、それが文字起こしや吹き替えの精度を引き下げます。
- 倫理と権利。クリーンに分離された音声は、文字起こし、分析、リミックスがしやすくなるため、チームは新しい言語や文脈で声を再利用する際に同意と権利を尊重しなければなりません。
正直な結論は、分離は強力な強化であって、合理的な録音習慣の代わりにはならないということです。良いマイク、適切なレベル、慎重なロケーション選びは今なお報われ、AIはコンテンツをローカライゼーションと再利用のためにはるかに柔軟にすることで、それらの選択を何倍にもしてくれます。これをより大きな公開の仕組みにどう組み込むか探っているなら、音声分離ツールとは何かを解説した記事が基本をより詳しく取り上げています。
よくある質問
AI音声分離とは簡単に言うと何ですか?
これは、混合された録音を受け取って人間の音声を分離し、クリーンな音声トラックと、オプションで残すか破棄できる別の背景トラックを提供するAI処理です。
私たちの音声分離ツールは、基本的なノイズ除去とどう違うのですか?
従来のノイズ除去は主に定常ノイズを減衰させます。私たちの分離ツールはディープラーニングを使って音声パターンを認識し、幅広い背景音や音楽からそれを抜き出すため、通常はよりクリーンで自然な対話が得られます。
複数の話者に対応できますか?
私たちの音声分離ツールは、非音声の背景から人間の音声を分離することに最適化されており、ミックスの中に主要な話者がいる場合に最もうまく機能します。複数の重なり合う声を分割することは活発な研究分野であり、専門的なモデルも存在しますが、それらは通常、一般的なクリエイターのワークフローではなく会議やコールセンターを対象としています。
音声分離は多言語吹き替えにとってなぜ重要なのですか?
ローカライゼーションは正確な文字起こしとタイミングに依存します。クリーンな音声トラックは認識エラーを減らし、翻訳されたボイスオーバーが元の動画と揃うのを助け、新しい声が保持された音楽や効果音とミックスされる際の耳に付くアーティファクトを削減します。
使うのにどれくらいの技術的知識が必要ですか?
ほとんど必要ありません。音声または動画ファイルをアップロードし、AIに処理させ、分離された音声と背景のトラックをダウンロードして、編集、吹き替え、自動化に使うだけで、手動でのパラメータ調整は不要です。