La traduzione da voce a voce converte le parole pronunciate in una lingua in parlato udibile in un'altra, così che il tuo pubblico ascolti la traduzione invece di leggerla. Immagina un docente che ha registrato una lezione in inglese e ora ha bisogno di una versione in spagnolo senza registrare nuovamente nulla: il sistema trascrive l'inglese, traduce il significato e genera l'audio in spagnolo al suo posto. Quel passaggio dalla lettura all'ascolto è l'intero scopo, e cambia il modo in cui pianifichi, revisioni e pubblichi contenuti multilingue.
La vera domanda raramente è se la tecnologia funziona. È quale versione ti serve: traduzione registrata per video, corsi e podcast; traduzione quasi in tempo reale per riunioni ed eventi; output che preserva la voce e mantiene l'identità dell'oratore originale; o un'API che puoi integrare nella tua applicazione. Ciascuno di questi percorsi comporta diversi compromessi in termini di qualità, latenza e impegno di revisione, e questa guida li mappa in modo che tu possa scegliere con consapevolezza.
Indice
Come funziona la traduzione da voce a voce
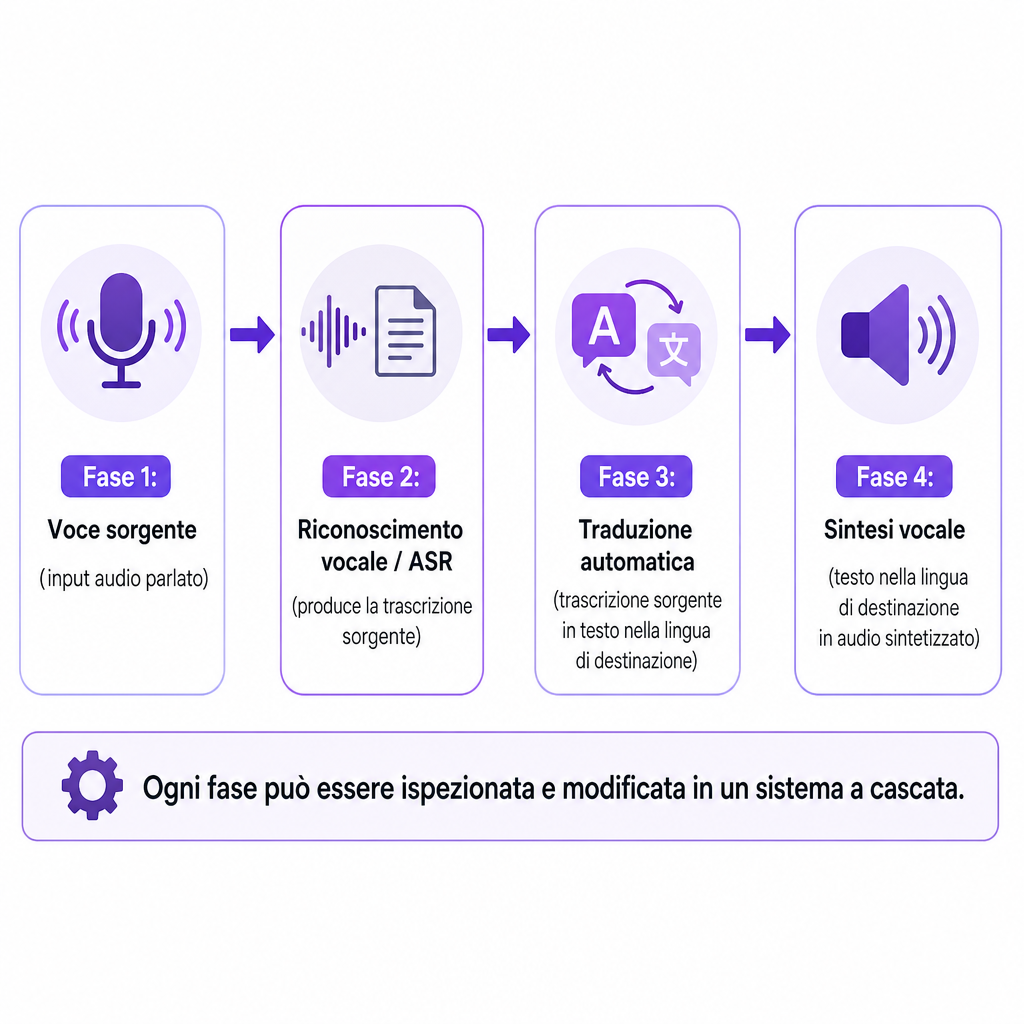
La maggior parte dei sistemi utilizza una pipeline connessa di tre tecnologie. Innanzitutto, il riconoscimento vocale automatico (ASR) analizza l'audio sorgente e produce una trascrizione. Poi, la traduzione automatica converte quel testo nella lingua di origine nella lingua di destinazione. Infine, la sintesi vocale trasforma il testo tradotto in audio parlato. Il flusso si legge chiaramente come parlato sorgente, poi riconoscimento, poi testo tradotto, poi parlato sintetizzato.
Parlato sorgente → riconoscimento vocale → testo tradotto → parlato sintetizzato
Questo design a livelli è chiamato traduzione da voce a voce a cascata, e la pubblicazione NIST sulla valutazione della traduzione vocale descrive la stessa struttura: l'ASR costruisce la trascrizione sorgente, la traduzione automatica produce il testo nella lingua di destinazione e la sintesi vocale genera l'output parlato. Il vantaggio di una cascata è che ogni fase è ispezionabile, quindi puoi correggere una trascrizione o una traduzione prima che l'audio venga mai generato.
Un approccio più recente addestra un modello end-to-end a mappare direttamente l'audio sorgente nell'audio della lingua di destinazione senza esporre fasi separate di trascrizione e sintesi. La ricerca condivisa tramite il rapporto tecnico DTIC sulla traduzione vocale diretta lo inquadra come un modo per ridurre il ritardo e preservare di più la voce dell'oratore originale, pur rilevando che comporta comunque compromessi in termini di velocità, contesto, copertura linguistica e qualità dell'output. In pratica, la cascata ti offre un maggiore controllo editoriale; l'approccio end-to-end punta a una minore latenza e alla continuità della voce.
La traduzione da voce a voce rispetto a compiti correlati
Le persone spesso confondono la traduzione da voce a voce con la trascrizione, la traduzione di testo e il doppiaggio, ma ciascuno termina con un risultato diverso. La traduzione di testo si ferma all'output scritto. La traduzione da voce a voce termina con l'output parlato, anche se un sistema a cascata utilizza comunque il testo internamente come rappresentazione intermedia. Chiarire gli input e gli output ti evita di scegliere lo strumento sbagliato per il lavoro.
| Tecnologia | Input | Output | Uso tipico |
|---|---|---|---|
| Da voce a testo | Audio parlato | Trascrizione scritta | Sottotitoli, note, contenuti ricercabili |
| Traduzione di testo | Testo scritto | Testo tradotto | Documenti, sottotitoli, pagine web |
| Sintesi vocale | Testo scritto | Parlato sintetico | Narrazione, accessibilità, interfacce vocali |
| Traduzione da voce a voce | Audio parlato | Parlato tradotto | Conversazioni, doppiaggio, media multilingue |
Il doppiaggio merita una distinzione propria. La traduzione da voce a voce si concentra strettamente sul cambiamento della lingua parlata. Il doppiaggio è il flusso di lavoro più ampio di localizzazione dei media che lo avvolge: traduzione dei dialoghi, assegnazione degli oratori, generazione di nuove voci, regolazione della sincronizzazione, missaggio delle voci tradotte con musica e audio di sottofondo ed esportazione di un progetto finito. Per un video YouTube registrato, un corso online, un podcast o un film, il doppiaggio è solitamente il formato più pratico perché aggiunge quei controlli editoriali oltre alla traduzione. Se stai valutando l'audio rispetto al testo su schermo, la nostra spiegazione su doppiaggio rispetto ai sottotitoli per video esamina quella scelta specifica, e i meccanismi più ampi si trovano nella nostra guida su cos'è il doppiaggio AI e come funziona.
I tre componenti che determinano la qualità
La qualità dell'output non è un singolo numero. È il prodotto di tre fasi, ciascuna con le proprie modalità di errore, quindi è utile valutarle separatamente piuttosto che affidarsi a un'impressione complessiva.
Il riconoscimento vocale automatico identifica le parole nella registrazione sorgente, e la sua accuratezza diminuisce con la musica di sottofondo, gli oratori sovrapposti, gli accenti marcati, il parlato veloce o incompleto, i termini specifici del settore, i microfoni scadenti e il passaggio da una lingua all'altra (code-switching). Una metrica comune qui è il tasso di errore sulle parole (WER), che confronta una trascrizione automatica con un riferimento umano contando sostituzioni, cancellazioni e inserimenti. La stessa pubblicazione NIST utilizza il WER come benchmark di riconoscimento, anche se un basso WER non conferma che la traduzione successiva abbia preservato il significato o il tono. Se il tuo audio sorgente è rumoroso, isolare prima il parlato pulito con uno strumento come il nostro separatore vocale può aumentare l'accuratezza del riconoscimento prima ancora che la traduzione inizi.
La traduzione automatica deve interpretare più delle singole parole. Gestisce la struttura della frase, il contesto, i pronomi e il genere, le espressioni idiomatiche, l'umorismo, la formalità, i riferimenti culturali, la terminologia tecnica e le differenze nell'ordine delle parole. Una traduzione letterale può essere grammaticalmente corretta ma suonare innaturale o cambiare silenziosamente il significato inteso, cosa particolarmente rischiosa per affermazioni pubblicitarie, istruzioni legali, informazioni mediche, contenuti finanziari e materiale didattico.
La sintesi vocale genera la voce finale nella lingua di destinazione, controllando pronuncia, pause, velocità di eloquio, intonazione, enfasi, tono emotivo, identità vocale e accento o variante linguistica. Il nostro prodotto Text to Speech offre più di 300 voci AI, generazione multilingue e clonazione vocale in 33 lingue, con controlli per velocità di eloquio, enfasi, lettura dei numeri e resa emotiva. Una traduzione tecnicamente accurata può comunque risultare poco efficace se la resa non si adatta al marchio, al corso o al documentario a cui appartiene.
La clonazione vocale nel parlato tradotto
La clonazione vocale è opzionale, ma è ciò che fa sembrare il contenuto tradotto opera dello stesso creatore piuttosto che di uno sconosciuto che legge un copione. Invece di assegnare una voce di repertorio estranea a ogni lingua, un sistema può costruire una performance nella lingua di destinazione modellata sull'identità vocale dell'oratore originale. Quella continuità conta per un canale che vuole una voce riconoscibile in tutte le lingue, un'azienda con un presentatore noto, un lungo corso tenuto da un docente, un regista che necessita di coerenza tra le versioni doppiate, o un conduttore di podcast che mantiene un suono familiare negli episodi tradotti.
Non è una garanzia. La clonazione preserva l'identità vocale, ma emozione, umorismo, ritmo, pronuncia e contesto culturale necessitano comunque di una revisione umana prima della pubblicazione. Altrettanto importante è l'autorizzazione: un flusso di lavoro responsabile conferma che chi ha fornito la registrazione abbia acconsentito alla clonazione e che la voce risultante possa essere utilizzata per la distribuzione commerciale, pubblica o geografica prevista. Se sei curioso dei meccanismi alla base di questo, la nostra panoramica su come funziona la clonazione vocale approfondisce l'argomento, e lo strumento di Clonazione Vocale mostra il lato produttivo.
Traduzione registrata rispetto alla traduzione in tempo reale
Questa è la decisione che la maggior parte dei team deve effettivamente affrontare, e le due modalità non dovrebbero essere giudicate con lo stesso metro.
La traduzione registrata è solitamente la scelta migliore per la produzione di media perché ti dà tempo per lavorare. Puoi correggere la trascrizione, modificare la terminologia, revisionare la traduzione, identificare gli oratori, regolare la sincronizzazione, rigenerare le voci, missare l'audio di sottofondo ed eseguire un controllo qualità umano prima che qualsiasi cosa venga pubblicata. Questo la rende adatta a canali YouTube, e-learning, formazione aziendale, podcast, video di prodotto e film indipendenti.
La traduzione in tempo reale opera sotto un vincolo più rigido: deve iniziare a produrre output prima che l'oratore finisca una frase. Un maggiore contesto migliora la qualità della traduzione ma aumenta il ritardo, mentre ritardi più brevi costringono a previsioni o traduzioni parziali, e gli errori sono difficili da ritrattare una volta che l'audio è già stato riprodotto. Il rapporto DTIC rileva che i precedenti sistemi a cascata spesso funzionavano con ritardi da quattro a cinque secondi, accumulavano errori attraverso le fasi e avevano una personalizzazione limitata, e che aumentare l'anticipo (lookahead) di un modello può aumentare la qualità rendendo l'interazione meno immediata. Una funzione di conferenza dal vivo e un doppiaggio multilingue rifinito risolvono problemi diversi, quindi valutali secondo standard diversi.
Come valutare un flusso di lavoro da voce a voce
Testa con un campione rappresentativo, non con una frase da demo ordinata. La lista di controllo qui sotto rispecchia le condizioni reali che il tuo contenuto incontrerà e mantiene la valutazione onesta.
- Copertura linguistica e dialettale: "Supporta lo spagnolo" potrebbe non significare l'accento, il vocabolario o le preferenze regionali che il tuo pubblico si aspetta. Conferma le varianti sorgente e di destinazione, inclusi l'inglese statunitense rispetto ad altri, lo spagnolo latinoamericano rispetto a quello europeo e il francese canadese rispetto a quello europeo.
- Accuratezza della trascrizione: Una traduzione non può correggere in modo affidabile una trascrizione che storpia nomi, numeri o termini di prodotto. Verifica se puoi ispezionare e modificare la trascrizione prima di generare l'audio.
- Significato e contesto: Testa deliberatamente espressioni idiomatiche, battute, inviti all'azione, affermazioni di prodotto e terminologia di settore. La fluidità non è accuratezza.
- Gestione degli oratori: Per interviste, panel e film, verifica che lo strumento possa identificare più oratori e mantenere coerenti le loro voci, anche quando le persone si interrompono a vicenda.
- Sincronizzazione temporale: Le frasi tradotte raramente corrispondono alla durata originale. Cerca controlli di sincronizzazione o velocità di eloquio, oltre a modifiche dei dialoghi, preservazione dell'audio di sottofondo, regolazione del volume, rigenerazione dei segmenti e allineamento visivo dove necessario.
- Naturalezza della voce: Ascolta pronuncia, pause, enfasi, gamma emotiva e ritmo innaturale.
- Latenza: Per l'uso dal vivo, misura il ritardo da oratore ad audio. Per l'uso registrato, dai priorità alla flessibilità di modifica rispetto alla velocità di elaborazione pura.
- Controlli di revisione ed esportazione: Uno strumento pronto per la produzione ti consente di correggere il testo, rigenerare singoli segmenti, regolare la sincronizzazione ed esportare in un formato che il tuo flusso di lavoro di pubblicazione accetta.
Esegui questi campioni attraverso la tua rosa di candidati e confronta accuratezza della trascrizione, significato della traduzione, pronuncia, naturalezza della voce, coerenza degli oratori, sincronizzazione, qualità dell'audio di sottofondo, impegno di revisione e costo totale al volume previsto. Il sistema più forte non è quello con più voci o lingue. È quello che produce risultati accettabili per il tuo contenuto specifico con un carico di revisione che il tuo team può effettivamente sostenere.
Rischi e limitazioni da considerare
Ogni fase introduce il proprio tipo di errore, e una voce dal suono naturale può mascherarli tutti. L'AI può tradurre erroneamente espressioni ambigue, nomi, modi di dire e termini specializzati, quindi la revisione umana rimane essenziale ovunque l'accuratezza abbia un peso legale, di sicurezza, finanziario o reputazionale. Gli errori di riconoscimento aggravano il problema: rumore, sovrapposizioni vocali, accenti e registrazioni scadenti possono far sì che il sistema fraintenda la sorgente, ed è per questo che revisionare la trascrizione prima di approvare la traduzione non è negoziabile.
Il significato culturale è facile da perdere. Una traduzione diretta può eliminare umorismo, cortesia o riferimenti che sopravvivono solo con una riscrittura piuttosto che con una resa parola per parola. La clonazione vocale aggiunge il rischio di consenso e impersonificazione, quindi documenta chi ha autorizzato la voce, l'ambito d'uso, il territorio, la durata e se può apparire in pubblicità o in dichiarazioni pubbliche sintetiche. C'è anche una dimensione di fiducia del pubblico: il rapporto DTIC descrive come una certa esperienza di traduzione informi gli utenti che l'audio tradotto è generato sinteticamente, un'aspettativa ragionevole da pianificare nelle tue stesse divulgazioni.
Due rischi più silenziosi completano l'elenco. La privacy conta ogni volta che l'audio contiene informazioni personali, discussioni riservate, dati dei clienti o contenuti non ancora pubblicati, quindi esamina i termini di gestione, conservazione, accesso ed eliminazione dei dati di un fornitore prima di caricare. E la falsa fiducia è il fallimento più insidioso di tutti: una voce rifinita fa suonare autorevole una traduzione errata, quindi non considerare mai la fluidità come prova di accuratezza fattuale.
Dove si inserisce DubSmart
Siamo più direttamente rilevanti per la traduzione da voce a voce registrata attraverso l'AI Dubbing, piuttosto che per qualsiasi pretesa di traduzione conversazionale dal vivo universale. Il nostro flusso di lavoro di doppiaggio accetta caricamenti di audio e video e link YouTube, supporta più di 60 lingue sorgente e 33 lingue di destinazione, clona la voce di ciascun oratore per la versione tradotta e ti consente di modificare testo, oratori e sincronizzazioni, rigenerare segmenti, regolare il volume del suono di sottofondo e scaricare il progetto finito. Quel livello editoriale è esattamente ciò di cui ha bisogno la produzione di media registrati.
Per i team che costruiscono le proprie pipeline, offriamo anche le API di AI Dubbing, Text to Speech e Voice Cloning, adatte ad agenzie, flussi di lavoro media e applicazioni che necessitano di automatizzare la produzione vocale multilingue. La scelta giusta dipende dal fatto che il tuo progetto voglia un editor di media finito, una pipeline guidata da API, o entrambi. Per un messaggio breve e ad alto rischio, la traduzione e la registrazione professionale umana possono ancora vincere; per una libreria di contenuti ampia e frequentemente aggiornata, un flusso di lavoro AI scala meglio con la revisione umana concentrata sul materiale a più alto rischio.
Domande frequenti
La traduzione da voce a voce è la stessa cosa dell'interpretariato?
No. L'interpretariato umano si basa su una persona addestrata che ascolta, comprende e trasmette il significato nel momento. La traduzione da voce a voce è automatizzata: veloce e scalabile, ma può richiedere revisione e può avere difficoltà con le sfumature che un interprete professionista gestisce naturalmente.
Funziona sempre in tempo reale?
No. Alcuni sistemi elaborano audio registrato con pieno controllo di modifica, mentre altri forniscono output dal vivo o quasi in tempo reale. I sistemi dal vivo bilanciano costantemente contesto di traduzione, latenza e accuratezza.
Può preservare la voce dell'oratore originale?
A volte. I sistemi che utilizzano la clonazione vocale o la sintesi che preserva la voce possono modellare l'identità dell'oratore originale, ma il risultato dipende dalla tecnologia, dalla coppia linguistica, dalla qualità audio e dall'autorizzazione all'uso di quella voce.
Il doppiaggio AI è una forma di traduzione da voce a voce?
Sì. Il doppiaggio AI è un'applicazione per media registrati della traduzione da voce a voce che aggiunge funzioni di modifica, gestione degli oratori, sincronizzazione, missaggio ed esportazione oltre alla traduzione di base.
Quanto è accurato?
L'accuratezza varia in base a lingua, qualità della registrazione, terminologia, oratore e sistema. Valuta la trascrizione, la traduzione e l'audio generato separatamente piuttosto che affidarti a una singola percentuale di accuratezza.