Una piattaforma di creazione multimediale con IA è un unico ambiente in cui generi, doppi, localizzi ed esporti contenuti multimediali—audio, video, immagini e testo—utilizzando l'intelligenza artificiale, invece di combinare strumenti separati e passaggi manuali. Quindi, quando ti chiedi cos'è una piattaforma di creazione multimediale con IA, la risposta breve è che sostituisce un insieme frammentato di app di trascrizione, strumenti vocali, servizi di traduzione ed editor con un unico flusso di lavoro connesso. In DubSmart AI, abbiamo costruito la nostra piattaforma proprio attorno a questa idea: passare da uno script grezzo o da un video sorgente a contenuti multilingue completamente doppiati senza mai uscire dall'area di lavoro.
Questa consolidazione è importante perché la parte difficile del lavoro sui contenuti moderni raramente è un singolo compito. Consiste nel mantenere le voci coerenti, la sincronizzazione allineata e i file in movimento in modo pulito tra i vari passaggi. Una piattaforma che gestisce l'intera pipeline elimina l'attrito che divora ore tra registrazione, doppiaggio e pubblicazione.
Indice dei contenuti
Cosa conta davvero come piattaforma di creazione multimediale con IA
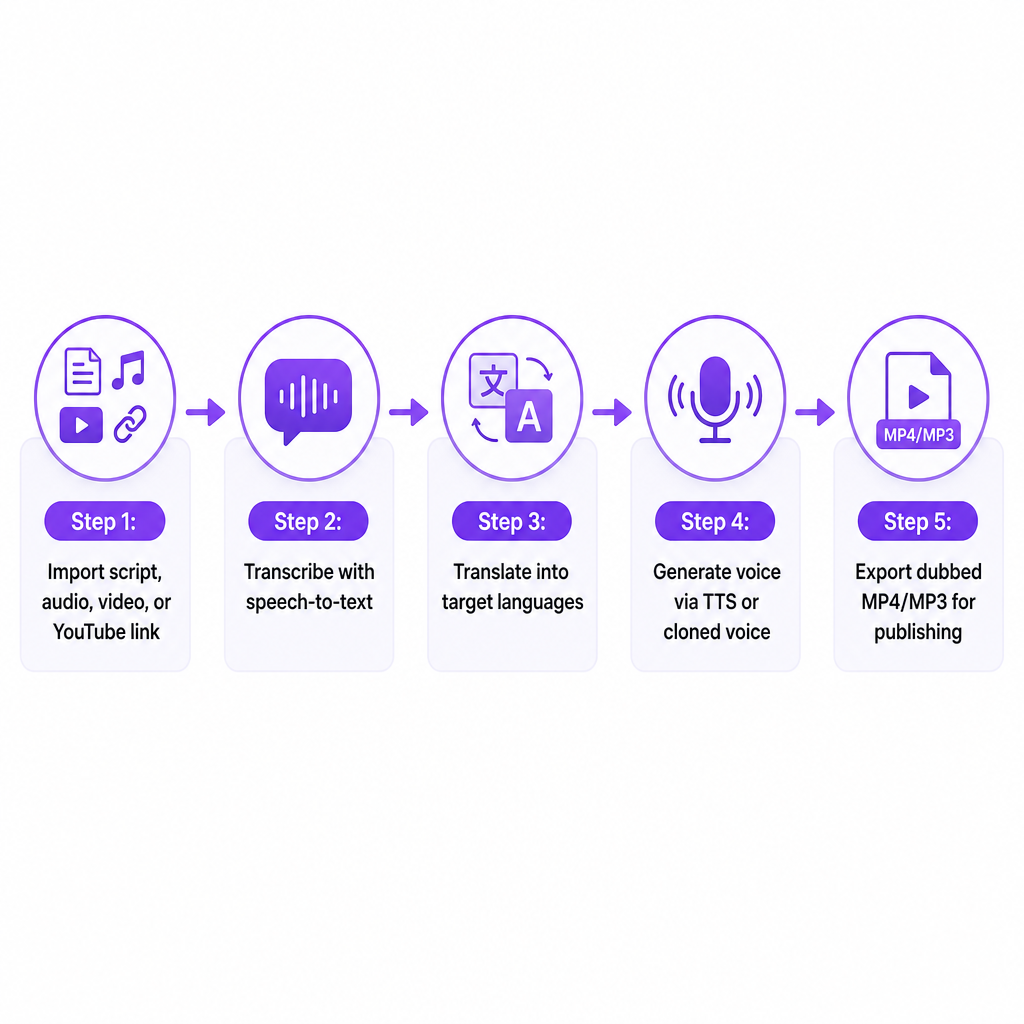
La caratteristica distintiva è il flusso di lavoro, non il numero di funzionalità. Un insieme di capacità IA diventa una piattaforma solo quando quelle capacità condividono un unico ambiente: importi i contenuti multimediali una volta, li trasformi attraverso diversi passaggi IA ed esporti un asset finito senza esportare e reimportare tra gli strumenti.
Da parte nostra, questo significa che text-to-speech, clonazione vocale, doppiaggio IA, speech-to-text, un separatore vocale, text-to-image e image-to-video vivono tutti nello stesso posto. Un creatore di YouTube, un team di marketing o un produttore di e-learning può partire da uno script o da un video sorgente e raggiungere un output multilingue completamente doppiato all'interno di un unico sistema. Il compito della piattaforma è gestire il lavoro di connessione—la trascrizione che alimenta la traduzione, la traduzione che alimenta la generazione vocale, la generazione vocale che alimenta un doppiaggio sincronizzato—in modo che nessun passaggio diventi un esercizio manuale di spostamento file.
Questa è la linea pratica tra uno strumento monouso e una piattaforma. Un generatore text to speech autonomo produce audio e si ferma. Una piattaforma tratta quell'audio come una fase in una pipeline più lunga che termina con un file localizzato e pubblicabile.
Ne hai bisogno o vanno bene strumenti separati
La vera decisione è se continuare a gestire contenuti e localizzazione con fornitori sparsi e abbonamenti SaaS, oppure centralizzare quel lavoro dove la generazione di voce, video e immagini si connette direttamente. Per la maggior parte dei team, la risposta dipende da quanto spesso si presenta la questione.
Alcuni scenari rendono concreta la scelta:
- Un canale YouTube che ha avuto successo in inglese vuole versioni in spagnolo, portoghese o hindi senza ri-registrare ogni video.
- Un piccolo team di marketing ha bisogno di una localizzazione conveniente per campagne, demo di prodotti ed esplicativi con una programmazione ricorrente.
- Un gruppo di e-learning o formazione aziendale deve offrire corsi estesi in modo coerente in diverse lingue per il personale globale.
- Un regista indipendente o un podcaster vuole il doppiaggio multilingue ma non può giustificare sessioni di studio ripetute e i compensi dei doppiatori.
- Un team di sviluppo o un'agenzia ha bisogno di IA vocale esposta tramite API per alimentare il proprio prodotto o la propria pipeline di localizzazione.
Se il tuo processo attuale si basa sulla registrazione manuale, su studi esterni, su diverse app scollegate o su script personalizzati solo per spostare file tra i sistemi, la questione smette di riguardare l'aggiunta di un altro strumento. Diventa una questione di efficienza, scala e controllo. Se localizzi un video all'anno, gli strumenti separati vanno bene. Se localizzi settimanalmente, i passaggi manuali sono dove si perdono il tuo tempo e la tua coerenza.
Come funzionano queste piattaforme dietro le quinte
Le implementazioni differiscono, ma la maggior parte delle piattaforme di creazione multimediale con IA condivide una manciata di meccanismi. Ecco come si integrano nel nostro flusso di lavoro.
Un'area di lavoro multimediale centralizzata
Tutto inizia con l'importazione: script, audio, file video o un link di YouTube. Da lì organizzi i progetti per lingua, oratore e canale, applichi trasformazioni IA su una timeline condivisa ed esporti nel formato di cui ha bisogno la tua destinazione—MP4 o MP3 per YouTube, file pronti per la modifica per la post-produzione, audio per un LMS. La nostra interfaccia è costruita in modo che tu carichi video locali o colleghi contenuti online, configuri oratori e tempistiche e scarichi i progetti localizzati finiti dalla stessa area di lavoro.
Creazione e clonazione vocale come tessuto connettivo
La voce è solitamente la spina dorsale della pipeline. Trattiamo la clonazione vocale come tessuto connettivo piuttosto che come una novità: carichi un campione vocale pulito, lo elaboriamo in una voce personalizzata con nome in pochi secondi e riutilizzi quella voce tra text-to-speech e doppiaggio. La meccanica è breve—registra o fornisci almeno 20 secondi di parlato pulito, caricalo nella sezione di clonazione vocale, quindi applica il profilo risultante ovunque ne abbia bisogno. Quella stessa voce clonata può generare introduzioni e voci fuori campo per la formazione in TTS, e preservare l'identità di un oratore attraverso le lingue nel doppiaggio. Una libreria di oltre 300 voci base dal suono naturale copre i casi in cui vuoi voci diverse per mercati diversi.
Text to speech e doppiaggio speech-to-speech
Il text to speech converte script e sottotitoli in audio dal suono naturale e, poiché si collega direttamente al doppiaggio e alla generazione di sottotitoli, un singolo progetto può passare dal testo al video localizzato senza uscire dal flusso di lavoro. Il doppiaggio speech-to-speech funziona diversamente: prende una voce registrata esistente, analizza tono, intonazione, stile di parlato e tempistiche, quindi ricrea quella voce che parla una nuova lingua di destinazione. La nostra pipeline di doppiaggio IA utilizza questo per preservare le caratteristiche dell'oratore originale invece di inserire una narrazione generica—utile quando l'autenticità è il punto centrale. Se vuoi la meccanica più approfondita, il nostro articolo esplicativo sul doppiaggio speech-to-speech illustra il flusso dall'analisi alla rigenerazione.
La pipeline di localizzazione multilingue
Il valore di una piattaforma dipende fortemente dalla copertura linguistica e da come la traduzione si connette alla voce. Il nostro stack di doppiaggio supporta il doppiaggio da oltre 60 lingue di origine in 33 lingue di destinazione, permettendoti di scegliere lingue di destinazione, oratori e stili per progetto. In pratica: importa un video o un link, scegli uno o più obiettivi come dall'inglese allo spagnolo e al portoghese, seleziona voci clonate o predefinite per lingua e lascia che il sistema gestisca trascrizione, traduzione, generazione vocale e ri-sincronizzazione in un doppiaggio pronto per il caricamento. Poiché la clonazione è integrata, la stessa voce del conduttore può accompagnare ogni lingua, mantenendo il pubblico su un terreno familiare.
API per sviluppatori e agenzie
Quando i team costruiscono i propri prodotti, hanno bisogno di capacità esposte programmaticamente. Pubblichiamo una API di clonazione vocale che rispecchia il flusso in-app: richiedi un URL di caricamento presignato, carica un campione audio (MP3, WAV, AAC, M4A o FLAC), crea una voce personalizzata inviando la chiave del file restituita con un nome vocale, quindi fai riferimento a quella voce nelle chiamate successive. L'API di doppiaggio IA consente agli sviluppatori di creare progetti di doppiaggio, impostare le lingue di destinazione e le impostazioni vocali e attivare l'analisi della voce dell'oratore originale prima di generare parlato che mantiene quelle qualità nella nuova lingua. Ciò significa che le agenzie possono integrare voce e doppiaggio nei propri prodotti senza ricostruire i modelli sottostanti.
Tre approcci generali alla creazione multimediale con IA
Anche all'interno delle piattaforme integrate, il mercato si divide in alcuni tipi di opzioni, e ciascuno si adatta a un acquirente diverso.
Le piattaforme creator-first, orientate al flusso di lavoro enfatizzano un'interfaccia accessibile, l'organizzazione dei progetti e la localizzazione end-to-end per video, audio e immagini. Qui si colloca la nostra app web, che copre TTS, clonazione, doppiaggio, speech-to-text, separazione vocale, text-to-image e image-to-video in un'unica interfaccia.
Le piattaforme incentrate sulle API puntano prima di tutto agli sviluppatori, concentrandosi su endpoint e payload piuttosto che su un'interfaccia non tecnica. Le nostre API di clonazione vocale, TTS e doppiaggio IA estendono il prodotto creator-first per i team che necessitano di controllo programmatico.
Gli strumenti ristretti, a singola capacità fanno una cosa sola—TTS di base o semplice trascrizione—senza la pipeline circostante. Possono adattarsi a un compito molto mirato, ma avrai bisogno di strumenti aggiuntivi per raggiungere un asset finito e localizzato.
Per la maggior parte dei creatori e delle aziende con sede negli Stati Uniti, la scelta si riduce a una piattaforma di flusso di lavoro che un team di marketing o di contenuti può usare direttamente, rispetto a un approccio API che gli sviluppatori integrano nei sistemi esistenti. Ci rivolgiamo deliberatamente a entrambe le estremità: un prodotto basato su crediti con flussi di lavoro dell'interfaccia utente più API per l'integrazione.
Come scegliere: i criteri che contano
Quando valuti se adottare una piattaforma, e quale, una manciata di criteri fa la maggior parte del lavoro.
| Criterio | Cosa verificare | Come lo affrontiamo |
|---|---|---|
| Copertura del flusso di lavoro | Copre dallo script o video sorgente ai contenuti localizzati finiti? | TTS, clonazione, doppiaggio, speech-to-text, separatore vocale, text-to-image, image-to-video in un'unica pipeline |
| Qualità della lingua e della voce | Copertura di origine e destinazione più il realismo vocale | Oltre 60 lingue di origine in 33 destinazioni, oltre 300 voci naturali, clonazione per un'identità autentica |
| Velocità e scala | Quanto velocemente l'input diventa output; capacità batch | Clonazione da campioni brevi elaborata in secondi; doppiaggio pensato per progetti ricorrenti |
| Modello di prezzo | Costo prevedibile e flessibile legato al volume | Basato su crediti con un piano gratuito, crediti riportabili e piani enterprise |
| Integrazione | API per collegare LMS, CMS o strumenti interni esistenti | API di clonazione vocale, TTS e doppiaggio IA che espongono le capacità principali |
Due di questi meritano uno sguardo più attento. Sulla velocità, la nostra clonazione funziona da circa 20 secondi di audio e restituisce una voce utilizzabile in pochi secondi, quindi i tempi di consegna non dipendono dalla registrazione di lunghi set di dati. Sul prezzo, un modello basato su crediti con riporto significa che il saldo inutilizzato viene trasferito e il costo si allinea al volume dei contenuti piuttosto che a soli posti fissi—il che si adatta a creatori e team di formazione il cui output aumenta e diminuisce.
Rischi, vincoli e uso responsabile
La scala comporta obblighi, e la versione onesta di questa risposta li nomina.
- Diritti vocali e consenso. Clonare una voce senza adeguata autorizzazione solleva preoccupazioni legali ed etiche. Incoraggiamo campioni puliti e con consenso e trattiamo le voci clonate come asset professionali, non come strumenti di impersonificazione. La nostra guida agli usi della clonazione vocale per i creatori si basa su casi legittimi come canali multilingue e formazione.
- Autenticità e divulgazione. Il pubblico potrebbe voler sapere se una voce è sintetica. Per marketing, formazione e film, essere trasparenti sull'uso dell'IA protegge la fiducia—soprattutto quando una voce doppiata suona quasi identica all'oratore originale attraverso le lingue.
- Sfumature linguistiche e culturali. Anche una traduzione e un doppiaggio solidi beneficiano di una revisione umana. Modi di dire locali, formulazioni normative e sensibilità culturali significano che l'output IA dovrebbe essere trattato come una prima bozza per contenuti ad alto rischio come messaggi di conformità, medici o finanziari.
- Sicurezza dei dati. Audio, script e video sono spesso proprietari. Flussi di lavoro di caricamento controllati e organizzazione basata su progetti—come il nostro modello di URL presignato—sono importanti per i team che gestiscono materiale sensibile.
Gestiti con politiche e revisione, questi rischi non annullano il valore di una piattaforma di creazione multimediale con IA. Definiscono come i team professionali dovrebbero strutturare il loro utilizzo.
Per i creatori, le aziende e i team di formazione con sede negli Stati Uniti, la nostra piattaforma è una risposta concreta alla domanda originale: un ambiente all-in-one di creazione e localizzazione multimediale che consolida strumenti vocali e visivi, mantiene la tua voce coerente attraverso le lingue, si adatta ai principali mercati grazie al doppiaggio da oltre 60 a 33 lingue e rimane accessibile sia attraverso un'app web user-friendly per i creatori sia attraverso API. Riportiamo di servire più di 500.000 utenti tra creatori e aziende. La tua prossima mossa è abbinare i criteri sopra a quanto spesso localizzi effettivamente—e se lo fai regolarmente, dicci le tue lingue e il tipo di contenuto così possiamo indirizzarti al flusso di lavoro giusto.
Domande frequenti
Cos'è una piattaforma di creazione multimediale con IA in termini semplici?
È un software che ti permette di creare, doppiare e localizzare contenuti multimediali—specialmente video e audio—utilizzando l'IA da un unico flusso di lavoro centrale, invece di affidarti a strumenti separati per ogni passaggio.
In che modo questo è diverso da un semplice strumento text-to-speech?
Integriamo il TTS all'interno di una pipeline più ampia che include clonazione vocale, doppiaggio IA, speech to text, un separatore vocale e generazione visiva, così passi dallo script o video sorgente ai contenuti multilingue finiti in un unico posto.
Posso mantenere la mia voce quando doppio in altre lingue?
Sì. Con la clonazione vocale e il doppiaggio speech-to-speech, analizziamo la tua voce da un breve campione e generiamo audio in nuove lingue che preserva il tuo tono, la tua intonazione e il tuo stile di parlato.
Quante lingue supporta DubSmart per il doppiaggio?
Supportiamo il doppiaggio da più di 60 lingue in 33 lingue di destinazione, coprendo i principali mercati verso cui i creatori e le aziende con sede negli Stati Uniti si espandono tipicamente.
C'è un modo per provare DubSmart prima di impegnarsi?
Sì. Offriamo un piano gratuito su un modello basato su crediti così creatori e team possono testare i flussi di lavoro, i crediti vengono riportati e i piani enterprise gestiscono l'utilizzo a volumi più elevati.