Se il microfono capta il traffico, il chiacchiericcio di un bar o un tappeto musicale posizionato proprio sopra il dialogo, la domanda non è se la registrazione sia utilizzabile, ma come estrarre di nuovo la voce in modo pulito. È esattamente ciò che fa un separatore vocale. In parole semplici, un separatore vocale è uno strumento audio basato sull'IA che isola il parlato umano da tutto il resto in una registrazione—rumore di fondo, musica e altri suoni—così da ottenere una traccia vocale pulita che puoi trascrivere, doppiare, clonare o remixare. Per chiunque produca contenuti multilingue, quella traccia pulita fa la differenza tra un doppiaggio che suona professionale e uno che suona "abbastanza buono".
Questa guida spiega cos'è realmente un separatore vocale, come funziona sotto il cofano, quando ne hai davvero bisogno e cosa valutare prima di scegliere uno strumento. Integriamo il Separatore Vocale nel flusso di lavoro di DubSmart AI proprio perché un parlato pulito è la base su cui poggia tutto il resto.
Indice dei contenuti
Cos'è davvero un separatore vocale
Nella ricerca audio, la separazione vocale è definita come il compito di separare il parlato di destinazione dalle interferenze di fondo in una registrazione mista. I sistemi più avanzati vanno oltre e separano più interlocutori l'uno dall'altro, producendo una traccia isolata per ogni voce.
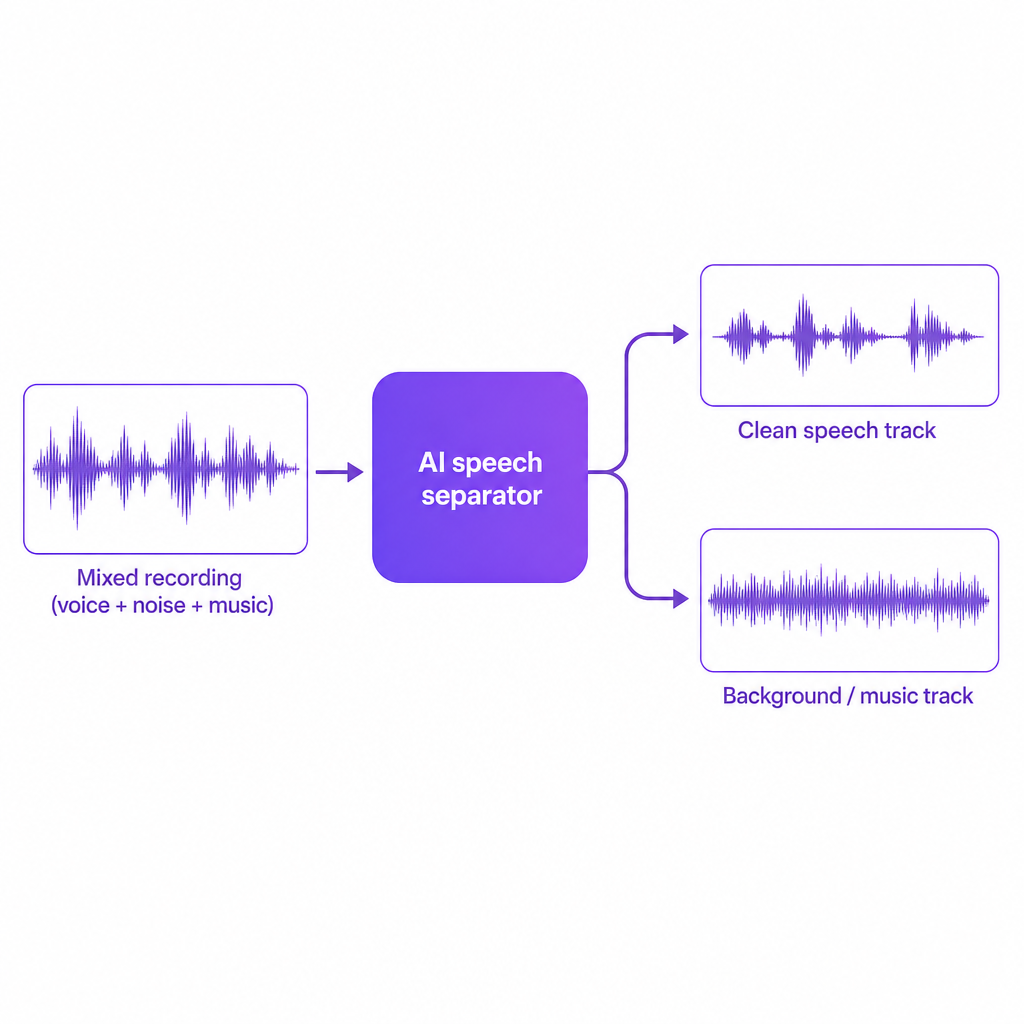
Tradotto nel lavoro di produzione quotidiano, un separatore vocale prende un file audio misto—dialogo più rumore o musica—e produce una o più tracce contenenti solo parlato, oltre a una traccia opzionale che contiene l'audio di fondo restante. Il nostro Separatore Vocale è progettato per rimuovere il rumore di fondo e isolare il parlato da qualsiasi registrazione, il che lo rende adatto alla post-produzione di film, podcast e interviste. Funziona sia su file audio che video: può ridurre il rumore delle registrazioni provenienti da ambienti rumorosi e separare la voce da una base musicale, così da ottenere stem distinti di voce e sottofondo.
È qui che un equivoco comune fa inciampare le persone. Un separatore vocale non è la stessa cosa della riduzione del rumore tradizionale. La riduzione del rumore abbassa il volume dei suoni indesiderati. Un separatore vocale identifica attivamente dove il parlato è presente nel segnale e lo ricostruisce come flusso separato e più pulito. Questa distinzione è il motivo per cui un separatore può recuperare una voce sepolta sotto la musica, mentre un noise gate per lo più rende semplicemente più silenziosa l'intera registrazione.
Ne hai davvero bisogno?
La vera decisione è se il tuo lavoro dipende da un audio del parlato affidabile e pulito piuttosto che da qualunque cosa il microfono abbia catturato. Se è così, un separatore dedicato smette di essere un semplice extra e diventa un passaggio fondamentale.
Diverse situazioni rendono ovvio questo passo avanti. I creatori di YouTube e le piccole imprese spesso riutilizzano vecchi filmati registrati in stanze con eco, bar o per strada, dove il rumore rende il parlato difficile da capire e da trascrivere. I team di e-learning e formazione costruiscono corsi multilingue da webinar e lezioni dal vivo, dove ogni trascrizione e doppiaggio successivo eredita la qualità del parlato originale. I registi e i produttori di podcast hanno spesso bisogno di recuperare una grande performance catturata in condizioni imperfette prima di rimixarla con musica e sound design. E gli sviluppatori o le agenzie che immettono audio degli utenti in pipeline di trascrizione, clonazione vocale o doppiaggio sanno che input rumorosi riducono direttamente l'accuratezza del modello.
Alcuni fattori concreti segnalano che vale la pena adottare un separatore:
- Stai localizzando in più lingue e vuoi un doppiaggio e sottotitoli coerenti e chiari. Un parlato pulito alimenta i nostri motori di Doppiaggio IA e Da Voce a Testo in modo molto più affidabile rispetto a un mix rumoroso.
- Ti affidi alla clonazione vocale per una voce di marca o di un personaggio e vuoi i migliori risultati possibili addestrando su campioni privi di rumore e artefatti.
- Ricevi regolarmente registrazioni generate dagli utenti o sul campo che non hai controllato, e devi comunque renderle pronte per la trasmissione. Un separatore ti offre una fase di pulizia ripetibile invece di regolare manualmente ogni file.
L'eccezione onesta: se il tuo audio è già registrato in uno studio trattato, con stem separati per dialogo e musica, un separatore è una comodità piuttosto che una necessità. Per tutti gli altri che lavorano con suoni del mondo reale, si guadagna un posto permanente nella pipeline.
Come funziona la separazione vocale sotto il cofano
La separazione vocale moderna è costruita sul deep learning e sulla ricerca sulla separazione delle sorgenti, non su semplici EQ e filtri. Il compito di base è semplice da enunciare e difficile da risolvere: dato un segnale misto che contiene più sorgenti, recuperare i singoli segnali vocali senza conoscerli in anticipo.
La maggior parte dei sistemi attuali segue una pipeline encoder–separatore–stimatore–decoder. L'encoder mappa la forma d'onda o lo spettrogramma grezzo in uno spazio di caratteristiche ad alta dimensione dove i pattern rilevanti per il parlato come formanti e armoniche diventano più facili da rilevare. Il separatore—una rete neurale—elabora quelle caratteristiche e impara a disaccoppiare le informazioni appartenenti a diverse sorgenti sonore, che si tratti di parlato contro rumore o di un interlocutore contro un altro. La fase di stima poi predice maschere che filtrano le componenti non vocali oppure stima direttamente la rappresentazione delle caratteristiche di ciascuna sorgente. Infine, il decoder riconverte quelle rappresentazioni separate in audio nel dominio temporale, producendo una o più tracce vocali pulite e, facoltativamente, una traccia di fondo residua.
Questi modelli sono addestrati su grandi dataset pieni di miscele di parlato e rumore, imparando i pattern discriminativi di parlato, interlocutori e interferenze da esempi etichettati. Ricerche più recenti condizionano il separatore su embedding di interlocutori o su prompt, il che rende possibile mirare la separazione a una voce specifica all'interno di audio affollati.
La conclusione pratica per i creatori è che un separatore moderno non è un noise gate travestito. È un modello che ha imparato che aspetto e che suono ha il parlato in molte condizioni, e può ricostruire una voce anche quando è sepolta sotto musica, rumore di folla o eco della stanza.
I due principali compiti di separazione
In pratica incontrerai due varianti di separazione vocale, e le piattaforme spesso le combinano.
La prima è il parlato di un singolo interlocutore contro il sottofondo: estrarre una traccia vocale coerente da rumore, musica o ambiente. È il compito su cui si concentra il nostro Separatore Vocale per film, podcast e interviste, perché corrisponde direttamente a ciò di cui la maggior parte dei creatori ha bisogno giorno per giorno.
La seconda è la separazione multi-interlocutore, dove il sistema produce una traccia separata per ogni interlocutore in una conversazione. Questo è particolarmente utile per la diarizzazione e l'analisi in riunioni o dibattiti di lunga durata, dove sapere chi ha detto cosa conta tanto quanto ciò che è stato detto.
Gli strumenti consumer tendono a impacchettare queste funzioni in interfacce semplici—carica una canzone per ottenere tracce vocali e strumentali separate, oppure isola il dialogo in un video per il montaggio. La nostra implementazione dà rilievo alla separazione parlato-sottofondo perché è il compito immediatamente più prezioso per i flussi di lavoro di doppiaggio, trascrizione e clonazione.
Cosa valutare prima di scegliere un separatore
Quando valuti se un separatore soddisfa le esigenze professionali, alcuni criteri contano più del testo pubblicitario.
Inizia con la qualità del parlato e gli artefatti. Un buon separatore preserva il timbro naturale di una voce invece di farla suonare metallica, sott'acqua o con effetto phaser, ed evita di introdurre rumore musicale o distorsioni aspre quando elimina forti elementi di fondo come la musica. Le rassegne accademiche segnalano l'interferenza residua e gli artefatti come le sfide principali, soprattutto nel rumore non stazionario. Il test più affidabile resta comunque controllare gli output di esempio sul tuo materiale.
La robustezza al rumore del mondo reale è il passo successivo. I modelli addestrati su dati di laboratorio puliti possono avere difficoltà con traffico, vento, brusio di folla, stanze riverberanti e contenuti in cui il parlato si sovrappone a musica o effetti forti. I lavori allo stato dell'arte mirano esattamente a queste miscele complesse, ma le prestazioni variano ancora con le condizioni di registrazione—quindi fai dei test negli ambienti in cui registri davvero, dagli uffici alle strade agli home studio.
La gestione della musica e dei contenuti misti è un'esigenza frequente e specifica. Rimuovere una colonna sonora per ridoppiare, o isolare la narrazione dai B-roll, richiede uno strumento che supporti esplicitamente la separazione tra musica e voce e produca due file utilizzabili invece di un singolo risultato ovattato. La nostra pipeline di separazione rileva le frequenze vocali, le isola dalla musica e produce file separati di alta qualità: uno con voce pulita e uno con la base musicale. È particolarmente utile quando prevedi di remixare, riscrivere le musiche o ridoppiare in altre lingue.
L'integrazione con gli strumenti a valle decide quanto tempo il separatore fa risparmiare effettivamente. La separazione raramente vive da sola—alimenta modelli di trascrizione dove un input più pulito abbassa i tassi di errore sulle parole, motori di clonazione vocale che premiano i campioni privi di rumore e sistemi di doppiaggio che allineano il parlato originale con le tracce tradotte. La nostra piattaforma è costruita attorno a un flusso di lavoro unificato che tiene insieme in un unico posto Separatore Vocale, Da Voce a Testo, Da Testo a Voce, Clonazione Vocale e Doppiaggio IA, così che una singola registrazione ripulita possa diventare contenuto multilingue, con voce clonata e completamente localizzato senza ricostruire ogni volta una pipeline.
Latenza, scalabilità e automazione contano per chiunque abbia un arretrato. Podcast, corsi e archivi di lunga durata necessitano di elaborazione batch che gestisca file di più ore, tempi di elaborazione per file ragionevoli e ganci di automazione dove la separazione risiede all'interno dei tuoi sistemi. Forniamo API per Da Testo a Voce, Clonazione Vocale e Doppiaggio IA, così gli sviluppatori possono integrare l'elaborazione vocale in pipeline end-to-end.
Infine, la privacy e la conformità non scompaiono una volta che l'audio è pulito. Separare il parlato dal sottofondo non rimuove la tua responsabilità per registrazioni che possono contenere conversazioni sensibili, né quella di rispettare i diritti quando estrai e riutilizzi voci da materiale concesso in licenza. I team enterprise dovrebbero confermare politiche chiare sulla conservazione e sull'uso dei dati e allineare qualsiasi flusso di lavoro di separazione alle linee guida interne di conformità.
Dove non arriva
Un separatore vocale può trasformare una registrazione, ma non è magia, e far finta del contrario porta a cattive decisioni.
La riduzione eccessiva del rumore è la trappola più comune. Una separazione aggressiva può eliminare sottili indizi del parlato—consonanti morbide, tono naturale della stanza—e lasciare una voce dal suono innaturale o faticoso da ascoltare. Gli artefatti residui sono l'altra faccia della medaglia: in condizioni difficili un modello può lasciare tracce di musica o rumore nella traccia vocale, o generare rumore musicale, in particolare quando l'interferenza è forte e in continuo cambiamento.
C'è anche da considerare il bias verso interlocutori e lingue. I modelli addestrati prevalentemente su determinate lingue, accenti o stili di parlato possono avere prestazioni peggiori su voci sotto-rappresentate. E una forma d'onda dall'aspetto pulito può creare un falso senso di sicurezza: non garantisce che l'audio sia adatto a compiti critici come l'analisi forense o contesti di conformità rigorosi.
Per il lavoro creativo e di localizzazione queste limitazioni sono gestibili, ma sono un forte argomento a favore dei test con campioni rappresentativi del tuo materiale piuttosto che affidarsi alle demo dei fornitori.
Il Separatore Vocale all'interno del nostro flusso di lavoro
Trattiamo il Separatore Vocale come un'implementazione pratica e a misura di creatore di questa tecnologia, strettamente integrata con il resto della piattaforma DubSmart AI piuttosto che aggiunta all'ultimo momento.
In uso, rimuove il rumore di fondo e isola il parlato da qualsiasi registrazione, producendo una voce pulita adatta alla post-produzione di film, podcast e interviste. Estrae voci chiare da tracce miste e genera file separati di alta qualità per parlato e musica di sottofondo, così puoi montare, ridoppiare o remixare senza combattere contro il mix originale. Funziona sia su sorgenti audio che video—carichi i file o usi link, li fai passare attraverso la pipeline e scarichi le tracce finite. E, cosa cruciale, quegli output sono ottimizzati per alimentare i nostri altri strumenti, così una singola registrazione ripulita può essere trasformata in contenuto multilingue, con voce clonata e completamente localizzato.
Per i creatori di YouTube, le piccole imprese, i formatori, i registi, i podcaster e i team di sviluppatori, questa integrazione cambia il ruolo stesso della separazione. Smette di essere un compito isolato di "sistemare l'audio" e diventa il primo passaggio standardizzato in un ciclo di vita più ampio e automatizzato di creazione e localizzazione dei contenuti. Se stai costruendo un canale o una libreria di corsi multilingue, è lì che il vero risparmio di tempo si accumula.
Domande frequenti
Cos'è un separatore vocale, in parole semplici?
È uno strumento IA che prende una registrazione rumorosa e mista e produce una traccia in cui per lo più senti solo la voce umana, oltre a tracce di sottofondo opzionali che puoi conservare o scartare.
Un separatore vocale è la stessa cosa della riduzione del rumore?
No. La riduzione del rumore si limita ad abbassare i suoni indesiderati. La separazione vocale identifica e ricostruisce esplicitamente il parlato come sorgente distinta, di solito con maggiore chiarezza e più controllo sul risultato.
Un separatore vocale può gestire più di un interlocutore?
Molti sistemi di livello di ricerca e alcuni prodotti possono separare più interlocutori in tracce individuali, sebbene la qualità vari con la sovrapposizione e le condizioni di registrazione. Il nostro Separatore Vocale si concentra principalmente sull'isolamento del parlato dal sottofondo per i flussi di lavoro comuni dei creatori.
L'uso di un separatore vocale migliorerà i miei risultati di doppiaggio e clonazione vocale?
Sì. Un audio in input più pulito generalmente migliora il riconoscimento del parlato, l'allineamento e la qualità della clonazione vocale, il che rende il doppiaggio multilingue e le voci clonate più naturali e coerenti.
La separazione vocale funziona indipendentemente dalla lingua?
La maggior parte dei modelli di separazione opera su pattern acustici piuttosto che sul testo, quindi possono gestire molte lingue. Le prestazioni dipendono comunque dai dati di addestramento e da quanto bene il tuo accento è rappresentato.