Un cambiavoce AI in tempo reale converte la tua voce in una voce diversa mentre parli, catturando l'audio del microfono, analizzandolo, trasformando l'identità di chi parla e riproducendo l'audio convertito con un breve ritardo. A differenza di un semplice filtro di modifica dell'altezza, può mantenere intatte gran parte delle tue parole, della tempistica e dell'espressione, modificando al contempo qualità come il timbro, l'età percepita, la presentazione di genere o lo stile del personaggio. E a differenza della sintesi vocale, parte dal parlato dal vivo anziché dal testo digitato.
La vera decisione per creator, streamer, educatori e aziende non è semplicemente se il risultato suoni realistico. È se lo strumento si adatta al tuo tipo di input, alla tolleranza alla latenza, alle esigenze di controllo della voce, alle integrazioni, agli obblighi sui diritti e alla qualità di produzione desiderata. Questa guida spiega come funziona la tecnologia, dove si colloca rispetto ad altri strumenti vocali AI correlati e quando un flusso di lavoro registrato ti conviene di più.
Indice dei contenuti
Cosa significa davvero "tempo reale"
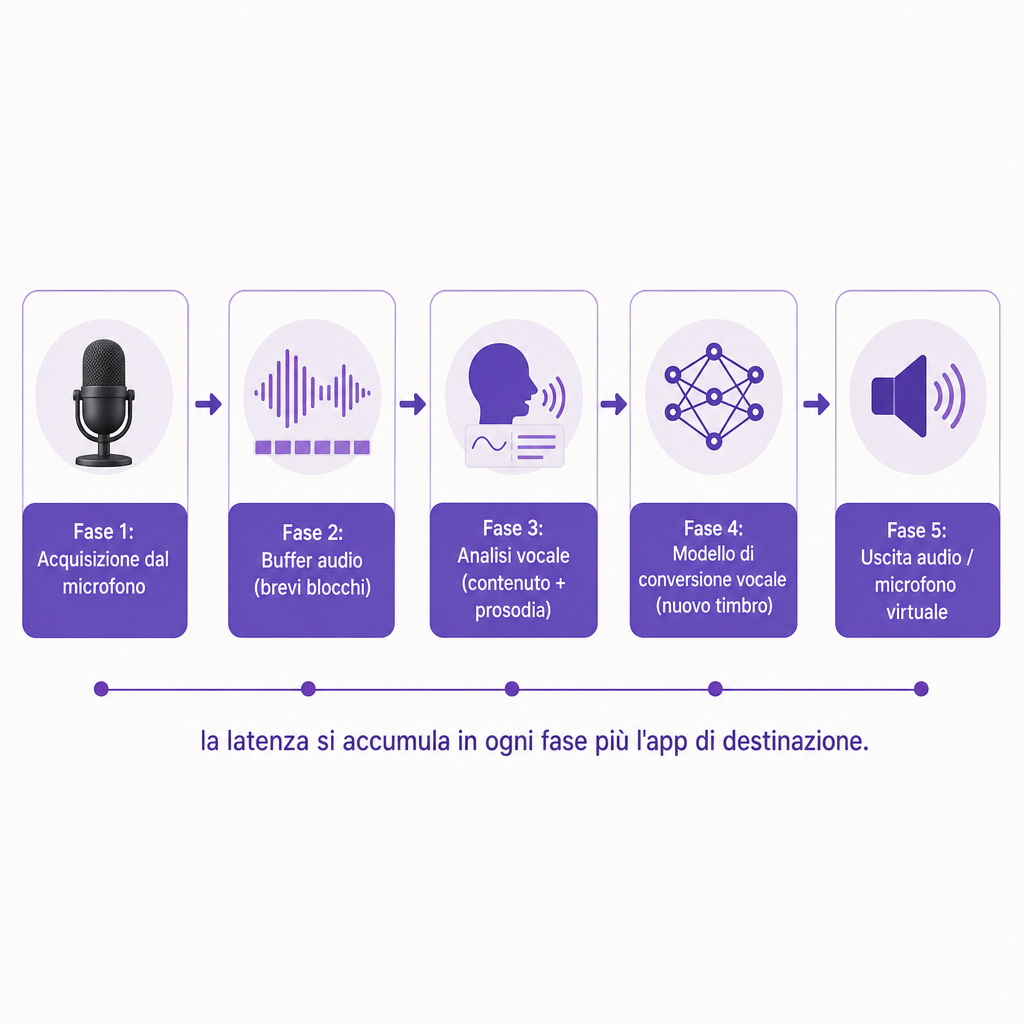
"Tempo reale" significa che il sistema elabora un flusso audio in entrata mentre parli, invece di attendere una registrazione completa o uno script finito. Il segnale percorre un percorso continuo: microfono, buffer audio, analisi del parlato, modello di conversione vocale, uscita audio. Poiché il convertitore lavora su brevi segmenti anziché su frasi complete, la conversione vocale in streaming è tecnicamente diversa dal rendering di un voiceover finito in cui l'intero script è noto in anticipo.
Un certo ritardo è inevitabile. Il sistema ha bisogno di tempo per catturare, analizzare, sintetizzare e emettere ogni blocco di audio. La ricerca dimostra che la conversione a bassa latenza è raggiungibile, anche se i numeri dipendono molto dal modello, dall'hardware, dalla dimensione del buffer e dalla qualità dell'audio. Il modello di ricerca LLVC riporta una latenza inferiore a 20 millisecondi su una CPU di fascia consumer, mentre StreamVC riporta una latenza end-to-end di 70,8 millisecondi nel suo ambiente di valutazione. Questi sono risultati di ricerca ottenuti in condizioni specifiche, non garanzie di prestazioni per qualsiasi strumento commerciale che potresti scaricare.
Come funziona un cambiavoce AI in tempo reale
Il processo si svolge come un ciclo mentre parli, non come un singolo rendering. Comprendere le quattro fasi ti aiuta a capire perché uno strumento risulta naturale e un altro robotico o con ritardo.
Innanzitutto, il sistema cattura il tuo parlato. Riceve audio da un microfono o da un altro input dal vivo e lo divide in brevi blocchi in modo che il modello possa elaborarlo in modo continuo. La qualità dell'input conta più di quanto molti utenti si aspettino. Rumore di fondo, eco della stanza, rumore della tastiera, clipping e un segnale instabile spingono tutti la conversione verso artefatti innaturali.
In secondo luogo, separa il contenuto del parlato dall'identità di chi parla. Una voce porta diversi strati sovrapposti contemporaneamente: il contenuto linguistico, ovvero le parole; la prosodia, che indica ritmo, enfasi e intonazione; l'altezza; il timbro che rende una voce riconoscibile; e l'identità più ampia di chi parla. I sistemi di conversione cercano di preservare il contenuto e l'espressione sostituendo al contempo le caratteristiche di chi parla. La ricerca moderna sullo streaming descrive questo come mantenere il contenuto del parlato sorgente e la prosodia, abbinandoli al contempo al timbro vocale di un parlante target. Questa separazione è il motivo per cui un buon convertitore ti consente di parlare spontaneamente con una voce trasformata invece di spalmare un filtro "robot" fisso sulla forma d'onda.
In terzo luogo, il modello sintetizza una nuova voce. Ricostruisce l'audio utilizzando un profilo di voce target, che potrebbe essere un personaggio integrato, una voce di libreria, una voce personalizzata creata da registrazioni autorizzate o un profilo progettato per l'anonimizzazione anziché per l'imitazione. L'output viene prodotto in modo continuo con un piccolo buffer di anticipazione. Un maggiore contesto può migliorare la stabilità, ma aggiunge anche ritardo, che è il compromesso fondamentale della conversione dal vivo.
In quarto luogo, il segnale convertito viene indirizzato a un'applicazione. Uno strumento desktop in genere espone l'output come microfono virtuale, in modo che altri programmi lo ricevano come se fosse un normale microfono. Questo instradamento è ciò che rende possibili live streaming, giochi online, videochiamate, chat vocali ed eventi virtuali. Un cambiavoce in tempo reale deve quindi funzionare a livello di sistema operativo e di applicazione, non solo all'interno del modello. La compatibilità con software di streaming, Discord, Zoom, browser e dispositivi mobili può contare quanto la qualità vocale pura. Se vuoi estrarre testo pulito da quello stesso audio catturato per i sottotitoli o il riutilizzo, un passaggio separato di speech to text gestisce la trascrizione anziché la conversione.
Conversione in tempo reale vs. strumenti vocali AI correlati
Queste tecnologie si sovrappongono nella mente delle persone ma risolvono problemi genuinamente diversi. La tabella seguente chiarisce cosa ciascuna prende come input e quando arriva l'output.
| Tecnologia | Input | Tempistica dell'output | Più adatto a |
|---|---|---|---|
| Cambiavoce in tempo reale | Parlato dal vivo al microfono | Durante la conversazione | Chiamate dal vivo, gaming, streaming, performance |
| Sintesi vocale | Testo scritto | Dopo l'invio del testo | Narrazione, tutorial, pubblicità, e-learning |
| Clonazione vocale | Campioni vocali | Generato su richiesta | Voce sintetica riutilizzabile per narrazione o doppiaggio |
| Doppiaggio AI | Audio o video esistente | Dopo l'elaborazione | Traduzione e localizzazione di contenuti registrati |
| Effetto altezza o formante | Audio dal vivo o registrato | Dal vivo o quasi dal vivo | Semplice modifica creativa della voce |
Questa distinzione è pratica, non accademica. Una piattaforma può offrire una potente generazione vocale AI o clonazione vocale senza offrire un cambiavoce dal vivo al microfono per chiamate e stream. I nostri strumenti si concentrano sui contenuti multimediali generati e localizzati: forniamo Sintesi Vocale, Clonazione Vocale, Doppiaggio AI, Speech to Text, Separatore Vocale, Text to Image e Image to Video all'interno di un unico flusso di lavoro. Questi sono progettati per produrre audio da testo o costruire una voce riutilizzabile per contenuti generati, quindi appartengono al lato del flusso di lavoro registrato di questa tabella anziché alla conversione dal vivo al microfono.
A cosa serve la conversione vocale dal vivo
Streamer e gamer ricorrono alla conversione vocale per mantenere un personaggio, proteggere la privacy o mantenere una persona di canale coerente. La bassa latenza conta più di tutto qui, perché stai reagendo ad altri giocatori e parlando con un pubblico. Un piccolo ritardo è tollerabile in un monologo in stile broadcast ma diventa evidente durante battute veloci, gioco competitivo o tempi comici.
Nelle riunioni online e negli eventi virtuali, una voce convertita può supportare giochi di ruolo, dimostrazioni, scenari di accessibilità o partecipazione attenta alla privacy. Per contesti professionali, l'intelligibilità e l'affidabilità dovrebbero superare la novità, e i partecipanti dovrebbero essere informati quando una voce è trasformata se il silenzio potrebbe trarre in inganno.
La performance di personaggi è un altro uso dal vivo. Registi indie, sviluppatori di giochi e podcaster possono fare provini per voci di personaggi o eseguire dialoghi temporanei al volo. Per la consegna finale, tuttavia, un voiceover AI registrato o una performance umana solitamente offre un migliore controllo dell'editing e coerenza da sessione a sessione.
La privacy vocale e l'anonimizzazione sono un obiettivo distinto dall'imitazione. L'anonimizzazione cerca di oscurare chi sta parlando, mentre l'imitazione cerca di riprodurre un'identità target specifica. Nessuna delle due è infallibile, e una voce trasformata può comunque rivelare abitudini di eloquio, modi di dire o suoni di sottofondo che aiutano a identificare chi parla.
Infine, la tecnologia della voce sintetica supporta l'accessibilità e la comunicazione assistiva per le persone che hanno perso la capacità di parlare. La Federal Trade Commission riconosce questo beneficio medico e di accessibilità pur avvertendo che la replica della voce può essere usata in modo improprio per frodi e abuso di dati biometrici.
I criteri decisionali che contano davvero
La latenza viene prima, e dovresti richiedere la latenza end-to-end misurata, non solo la velocità di inferenza del modello. Il ritardo che effettivamente percepisci include la cattura del microfono, il buffering, l'estrazione delle caratteristiche, l'inferenza del modello, la sintesi, l'instradamento dell'output e qualunque cosa l'app di chiamata o streaming aggiunga sopra. Un modello che registra benchmark veloci in isolamento può risultare lento una volta assemblato l'intero percorso.
La naturalezza è il test successivo. Ascolta per individuare artefatti metallici, salti tonali improvvisi, problemi di respirazione e pronuncia, pause innaturali, consonanti distorte, glitch ai confini delle frasi e perdita di espressione emotiva. Una voce convincente dovrebbe rimanere comprensibile durante il parlato spontaneo, non solo durante le righe dimostrative lette con cura.
La conservazione del contenuto del parlato è facile da trascurare finché non viene meno. Metti alla prova parlato veloce, interruzioni, numeri, nomi, accenti, risate, domande e cambi di volume. Uno strumento che cambia l'identità ma appiattisce il tuo ritmo e la tua intonazione è poco adatto per performance o interazioni dal vivo.
La selezione e la personalizzazione della voce determinano fino a che punto puoi plasmare il risultato. Verifica la presenza di voci integrate, la creazione di voci personalizzate, i controlli di altezza e tono, le opzioni di emozione o stile, le scelte di accento, la coerenza tra le sessioni e qualsiasi restrizione per l'uso commerciale. La creazione di voci personalizzate dovrebbe sempre richiedere un'autorizzazione chiara: un campione vocale non è un permesso per imitare la persona da cui proviene.
Il supporto hardware e di piattaforma decide se lo strumento si adatta affatto alla tua configurazione. Verifica se funziona localmente su CPU o GPU, in un browser, tramite un'app desktop, su dispositivi mobili, tramite un microfono virtuale o tramite un'API. L'elaborazione nel cloud può semplificare la configurazione ma introduce latenza di rete e questioni di governance dei dati, mentre l'elaborazione locale può ridurre il ritardo di rete ma richiedere hardware più performante. Separatamente, verifica l'instradamento audio: un modello potente è inutile se il suo output non può essere selezionato come microfono nell'applicazione prevista.
La gestione dei dati chiude l'elenco. Prima di caricare qualsiasi campione vocale, verifica se le registrazioni vengono conservate, se alimentano il miglioramento del modello, come vengono eliminate le voci personalizzate, chi può accedere ai file, se esistono controlli business o enterprise e cosa succede all'audio generato in seguito. Le registrazioni vocali possono essere dati personali sensibili o correlati a dati biometrici a seconda del contesto e della legge applicabile, quindi trattale di conseguenza.
Quando un flusso di lavoro registrato batte il tempo reale
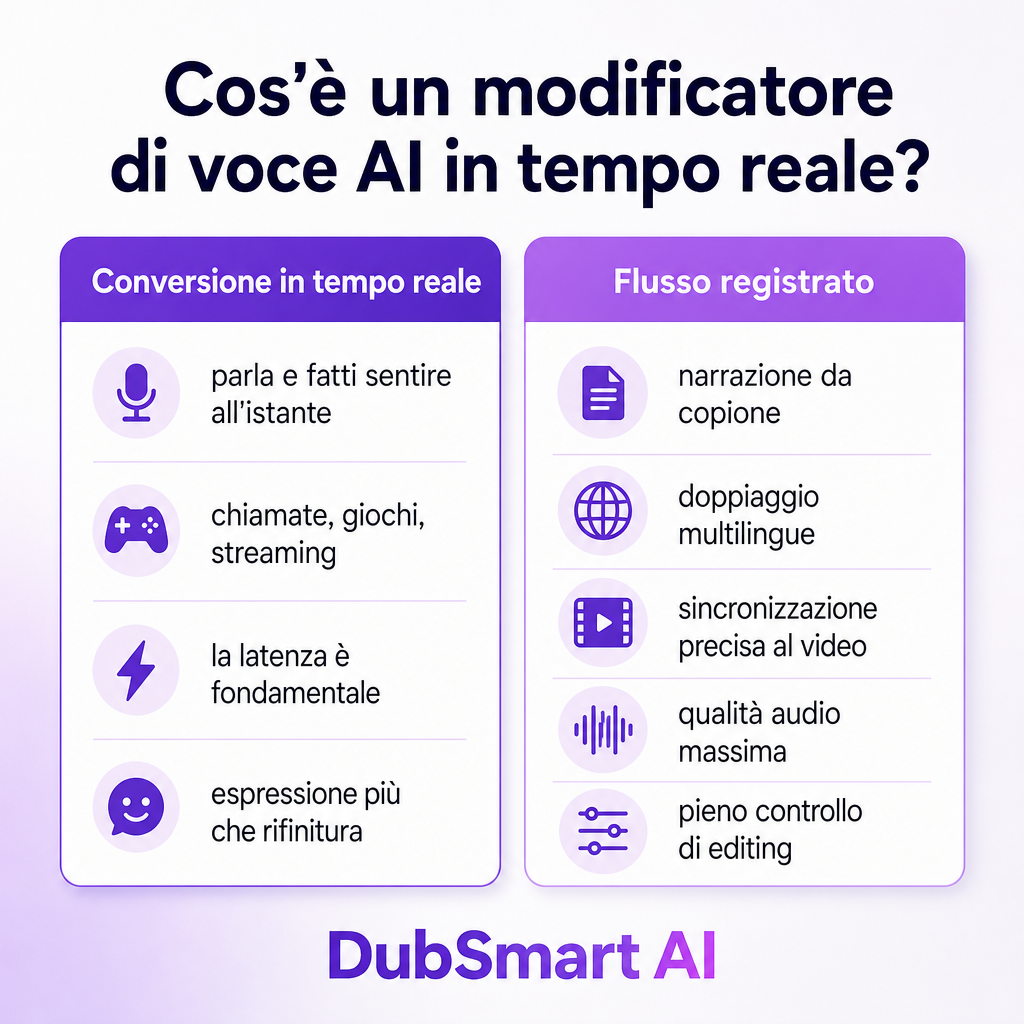
La conversione dal vivo è la scelta giusta quando una persona deve parlare in modo naturale e far sentire immediatamente la voce trasformata. È la scelta sbagliata quando la tua priorità è la massima qualità audio, una pronuncia precisa, una narrazione multilingue, una tempistica esatta rispetto al video, un editing dettagliato, un voiceover commerciale coerente o un doppiaggio di alta qualità.
Per questi obiettivi, vince una pipeline registrata. Con la sintesi vocale, controlli e perfezioni lo script prima che venga generato qualsiasi audio, il che elimina completamente il problema della latenza dal vivo. Con il doppiaggio AI, il sistema elabora un video esistente e allinea il parlato tradotto rispetto alla sorgente, qualcosa che nessun cambiavoce dal vivo può fare. Se il tuo file sorgente mescola dialoghi con musica o rumore, un separatore vocale può isolare una traccia vocale pulita prima di elaborarla. Il nostro Doppiaggio AI è costruito per tradurre audio o video registrati nelle lingue target supportate, non per convertire un feed di microfono dal vivo.
Rischi e uso responsabile
L'impersonificazione e la frode sono il rischio principale. Una voce convertita realistica può rendere più credibile una falsa identità, e la FTC avverte che i sistemi di clonazione vocale sono usati in truffe familiari, impersonificazione aziendale, estorsione e altre frodi, oltre a rischi per gli artisti vocali le cui voci possono essere appropriate indebitamente. Non usare la voce riconoscibile di una persona reale senza autorizzazione, e non presentare mai una voce generata o convertita dall'AI come prova che una persona specifica abbia parlato.
Il consenso e i diritti vocali ne derivano direttamente. Ottieni il permesso prima di clonare o imitare deliberatamente la voce di un'altra persona, e tieni traccia di tale permesso, specialmente per progetti commerciali, pubblicità, formazione, giochi o media pubblici. Il materiale della FTC qui citato discute danni, applicazione della legge e soluzioni proposte piuttosto che stabilire un'unica regola di consenso per ogni uso, quindi gli obblighi specifici possono dipendere dalla giurisdizione, dal contratto, dalla piattaforma e dal caso d'uso. In caso di dubbio, verifica per la tua situazione.
La divulgazione è sensata ogni volta che un pubblico potrebbe ragionevolmente credere che una persona reale stia parlando dal vivo. Un breve avviso che la voce è generata dall'AI o convertita riduce la confusione. Anche la sicurezza conta: proteggi i campioni vocali e i file di voce personalizzata come altri asset sensibili, limita l'accesso, evita di caricare registrazioni senza permesso e rimuovi i profili vocali inutilizzati dove il servizio lo consente. Infine, pianifica per i fallimenti di qualità. Latenza, audio interrotto e artefatti di conversione possono mandare all'aria una conversazione, quindi testa l'intera configurazione con il microfono, le cuffie, l'applicazione, la rete e l'hardware effettivi prima di andare in pubblico.
Dove si inseriscono i nostri strumenti nel tuo progetto vocale
Presentiamo un flusso di lavoro multimediale AI integrato piuttosto che un prodotto di cambiavoce dal vivo al microfono. Sulla nostra piattaforma puoi generare parlato da testo, scegliere tra più di 300 voci, creare voci clonate da un breve campione e usare quelle voci nei progetti di Sintesi Vocale e Doppiaggio AI. Supportiamo il doppiaggio da più di 60 lingue sorgente in 33 lingue target, il che ci rende molto adatti quando il compito è creare un voiceover da uno script, produrre parlato con una voce personalizzata, doppiare audio o video registrati o localizzare contenuti per un pubblico multilingue.
Per gli sviluppatori, pubblichiamo pagine API separate per Sintesi Vocale, Clonazione Vocale e Doppiaggio AI. Questi sono flussi di lavoro di generazione e localizzazione. Se il tuo progetto ha specificamente bisogno di un cambiavoce dal vivo al microfono, verifica che l'input in streaming in tempo reale, l'instradamento dell'output, gli obiettivi di latenza e il supporto per le sessioni dal vivo siano esplicitamente documentati prima di impegnarti con qualsiasi API, la nostra o quella di chiunque altro.
Se stai valutando la conversione dal vivo rispetto a una pipeline registrata e non sei sicuro di quale percorso si adatti ai tuoi contenuti, dicci il tuo formato sorgente, le lingue target e se hai bisogno di output dal vivo o preregistrato, e ti indicheremo il flusso di lavoro giusto.
Domande frequenti
Un cambiavoce AI in tempo reale è la stessa cosa della sintesi vocale?
No. Un cambiavoce in tempo reale trasforma il parlato dal vivo al microfono mentre parli, mentre la sintesi vocale genera nuovo parlato dal testo scritto che invii prima. La nostra Sintesi Vocale è costruita per generare parlato da testo, non per la conversione dal vivo al microfono.
Un cambiavoce AI in tempo reale ha ritardo zero?
No. Ogni sistema ha bisogno di tempo per catturare ed elaborare l'audio, quindi un certo ritardo è inevitabile. Il ritardo pratico dipende dal modello, dal dispositivo, dalle impostazioni del buffer, dalla rete e dall'applicazione di destinazione, e i sistemi di ricerca riportano cifre diverse in diverse condizioni di test.
Un cambiavoce AI può copiare la voce di una celebrità?
Alcuni sistemi possono tecnicamente imitare voci riconoscibili, ma la capacità tecnica non è un permesso. Evita l'impersonificazione non autorizzata e verifica i contratti, le regole della piattaforma e le leggi pertinenti prima di usare la voce riconoscibile di qualsiasi persona.
Cosa dovrei usare per creare video YouTube multilingue?
Per i video preregistrati, il doppiaggio AI si adatta generalmente meglio di un cambiavoce dal vivo perché elabora il video esistente e produce audio allineato e localizzato. Il nostro Doppiaggio AI traduce e doppia audio o video registrati nelle lingue supportate.
La vostra piattaforma può cambiare la mia voce dal vivo durante una chiamata?
La nostra piattaforma documenta Sintesi Vocale, Clonazione Vocale e Doppiaggio AI anziché la conversione vocale dal vivo al microfono. Se stai pianificando un flusso di lavoro per chiamate dal vivo, verifica prima con noi la documentazione attuale del prodotto in modo che possiamo consigliarti l'approccio giusto.