Se stai valutando voiceforge text to speech per un progetto, la vera domanda raramente è se le voci suonino interessanti. È se lo strumento si adatta alla lunghezza del tuo copione, ai tuoi diritti di pubblicazione e al tipo di contenuti che realmente crei. VoiceForge è un servizio di sintesi vocale basato su browser costruito attorno a voci di personaggi distintive. Converte un copione in audio scaricabile utilizzando un motore di sintesi a selezione di unità che unisce segmenti di parlato registrati da speaker umani invece di generare ogni suono da una singola forma d'onda matematica. La decisione pratica si riduce a quattro esigenze: una voce divertente e riconoscibile per progetti personali; audio con licenza per media monetizzati; controllo preciso su pronuncia e ritmo; oppure un flusso di lavoro multilingue scalabile. Solo le prime tre si adattano perfettamente a un generatore di voci di personaggi, ed è proprio in quella lacuna che la maggior parte dei creator inciampa.
Pubblichiamo questa guida perché la stessa confusione si presenta più e più volte: le persone generano audio durante una prova gratuita, presumono di poterlo monetizzare, poi scoprono che la licenza è legata a uno specifico piano. Di seguito, analizziamo come funziona il motore, cosa può e cosa non può fare, e quando uno strumento di novità a voce singola è la scelta giusta rispetto a un flusso di lavoro di localizzazione completo.
Indice dei contenuti
Cos'è realmente VoiceForge text to speech
VoiceForge trasforma parole scritte in audio parlato: inserisci un copione, scegli una voce, generi la clip, la visualizzi in anteprima e scarichi il risultato quando il tuo piano lo consente. Ciò che lo distingue da una libreria di narrazione generica è il suo orientamento. VoiceForge predilige voci con personalità piuttosto che una resa aziendale neutra, il che lo rende naturalmente adatto a sketch su YouTube, clip di gaming, personaggi animati, meme, annunci di novità e progetti musicali.
Questa attenzione al "personaggio prima di tutto" è un pregio per alcuni contenuti e un difetto per altri. Una voce comica o deliberatamente sintetica può reggere una parodia o un NPC di un gioco, ma la stessa voce diventa fastidiosa in un corso di e-learning, in una demo di prodotto o in uno spot di brand premium. Quindi il primo filtro non è "suona umana?" È "questa voce è adatta davanti al mio pubblico specifico?"
Se stai ancora decidendo se un generatore di voci standard sia adatto alle tue esigenze, la nostra spiegazione su cosa fa un generatore di voci AI copre la categoria più ampia e come questi strumenti differiscono dalla clonazione e dal doppiaggio.
Come il motore a selezione di unità costruisce una voce
VoiceForge utilizza la sintesi a selezione di unità, chiamata anche sintesi concatenativa. Invece di generare un'intera registrazione da una singola forma d'onda prodotta da un modello, il sistema cerca in un database di segmenti di parlato registrati e unisce i pezzi che meglio si adattano alla tua frase. Comprendere questo processo spiega sia perché le voci suonino riconoscibili sia perché si comportano in un certo modo sotto pressione.
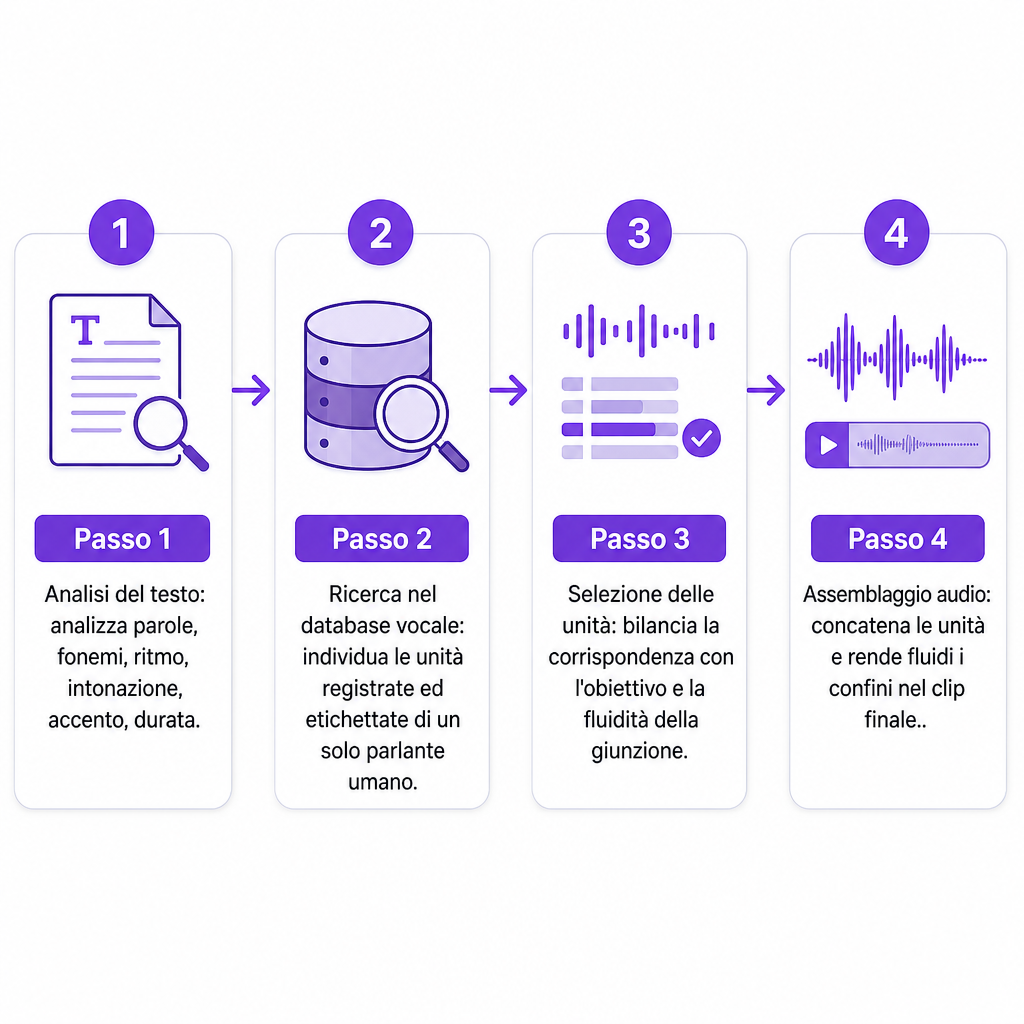
Il processo si svolge in alcune fasi. Prima, l'analisi del testo: il motore analizza parole, struttura della frase, fonemi, ritmo, intonazione, accento e durata per decidere come debba essere pronunciata una battuta. Poi, una ricerca nel database vocale: ogni voce è costruita a partire dalle registrazioni di uno speaker umano, suddivise in unità più piccole ed etichettate per suono e contesto. Poi la selezione delle unità, dove il motore bilancia due obiettivi concorrenti allo stesso tempo — la corrispondenza all'obiettivo, che sceglie un'unità con il suono, l'intonazione, la durata e il contesto giusti, e l'unione fluida, che predilige unità adiacenti che si collegano senza una giuntura evidente. Infine, l'assemblaggio audio unisce la sequenza scelta e applica una leggera levigatura ai confini.
Poiché l'output è assemblato da registrazioni reali, ogni voce mantiene un'identità distintiva. Il compromesso è che questo metodo non è stato progettato per offrire una direzione emotiva illimitata o la resa completamente regolabile associata ai più recenti sistemi generativi. Fraseggi insoliti, cambi rapidi o combinazioni di pronuncia complesse possono mettere in evidenza le giunture tra le unità, producendo risultati che suonano meno coerenti rispetto a una ripresa umana continua. Se vuoi vedere come un processo completamente generativo differisce, la nostra analisi su come funziona la sintesi vocale neurale illustra l'approccio di deep learning che sostituisce la concatenazione.
Voci, SSML e il limite di 500 caratteri
VoiceForge elenca 42 voci uniche, ognuna registrata da uno speaker diverso con il proprio timbro e stile di pronuncia. È più che sufficiente quando la voce stessa fa parte del concetto creativo — un narratore comico per un corto, una personalità bizzarra per un video di gaming, un tono sintetico per un meme. È però un catalogo più ristretto per i team che necessitano di molte varianti regionali o di un narratore accuratamente abbinato su diversi mercati.
Per il controllo della resa, VoiceForge supporta un sottoinsieme di Speech Synthesis Markup Language (SSML). Invece di affidarti alla sola punteggiatura, incorpori le istruzioni direttamente nel copione.
| Controllo SSML | Cosa fa |
|---|---|
<break> |
Inserisce una pausa |
<emphasis> |
Enfatizza una parola o frase |
<prosody> |
Regola l'intonazione, la velocità di pronuncia o il volume |
<phoneme> |
Forza una pronuncia esatta |
<sub> |
Pronuncia un sostituto del testo visibile |
<p> / <s> |
Contrassegna un paragrafo o una frase |
Questi tag si rivelano utili quando il motore legge male un nome di prodotto, un acronimo o un termine tecnico. Racchiudere un'abbreviazione in <sub alias="application programming interface">API</sub> fa pronunciare la frase completa, e <phoneme> fissa un nome complesso. Un <break time="500ms"/> tra le battute aggiunge una pausa deliberata dove la punteggiatura non lo farebbe.
Ecco l'inghippo che ridefinisce il modo in cui scrivi per esso: l'input di testo è limitato a 500 caratteri, e il markup SSML conta ai fini di quel limite. Ogni tag che aggiungi erode lo spazio disponibile per le parole effettive. Le narrazioni lunghe devono essere suddivise in più generazioni, e un markup pesante riduce ulteriormente ogni porzione. In pratica, ciò significa pianificare il copione in brevi passaggi autosufficienti piuttosto che incollare un'intera pagina.
Prova gratuita vs. licenza commerciale: la decisione che conta
VoiceForge offre una prova gratuita limitata, ma una prova non è una licenza di pubblicazione. I suoi piani tracciano una linea netta tra uso personale e commerciale, ed è proprio su quella linea che avviene la maggior parte degli errori.
Il livello Fan Voice è destinato a battute, video, giochi, animazioni e meme non monetizzati. Il piano Publisher è l'abbonamento che concede una licenza commerciale per l'audio TTS in contenuti monetizzati o commerciali — video monetizzati, giochi indie e musica — e pubblicizza download illimitati. La prova gratuita esiste affinché tu possa testare il servizio prima di impegnarti.
La regola operativa è semplice: se un progetto genera denaro, promuove un'attività, appare in media monetizzati o viene distribuito commercialmente, conferma il piano applicabile prima di pubblicare. L'audio che generi durante una prova gratuita non porta automaticamente diritti commerciali solo perché è stato scaricato. Anche il linguaggio delle licenze può cambiare, quindi la pagina del piano è un punto di partenza, non un sostituto per una revisione specifica del progetto quando la posta in gioco è alta — una consegna per un cliente, un annuncio a pagamento, una campagna brandizzata o il rilascio di un'app.
Punti di forza e limiti per progetti reali
I punti di forza di VoiceForge si concentrano attorno a personalità e semplicità. Le voci di personaggio si distinguono quando il timbro fa parte della battuta o dell'identità di un canale. Poiché le fondamenta sono parlato umano registrato, le voci conservano caratteristiche vocali naturali e un'identità riconoscibile. I controlli di pronuncia SSML ti danno un vero potere su acronimi, nomi e termini insoliti. E il piano Publisher rende la questione dell'uso commerciale più esplicita rispetto a strumenti che separano l'accesso alla generazione dai dettagli della licenza.
I limiti sono altrettanto concreti. Il tetto di 500 caratteri costringe i copioni lunghi in molte piccole generazioni, e il markup rende ciascuna più corta. Il catalogo di 42 voci è modesto rispetto alle grandi librerie, il che conta se hai bisogno di centinaia di opzioni o di molti accenti regionali. Lo stile "personaggio prima di tutto" che brilla nell'intrattenimento può penalizzare contenuti legali, medici, didattici o di brand premium. Le restrizioni dei piani sono facili da violare, poiché la capacità di generare audio non è la stessa cosa del diritto di monetizzarlo. E poiché il motore unisce unità registrate, certi fraseggi possono far emergere artefatti di giuntura che una registrazione continua non avrebbe.
Nessuno di questi aspetti è di per sé squalificante. Semplicemente definiscono il punto ideale: clip brevi, orientate alla personalità, in una sola lingua, dove la voce è il fulcro.
Quando una voce di personaggio è adatta e quando vince un flusso di lavoro di localizzazione
VoiceForge è la scelta giusta quando la personalità della voce è centrale, i tuoi copioni si suddividono ordinatamente in brevi sezioni, hai bisogno di un controllo base su pronuncia e ritmo, e stai producendo video, meme, animazioni, musica o contenuti per giochi indie — che siano personali (Fan Voice) o monetizzati con l'abbonamento appropriato.
Un flusso di lavoro più ampio ti serve meglio quando hai bisogno di un narratore neutro raffinato, molte lingue e accenti, la tua voce clonata, narrazioni di lunga durata, aggiornamenti commerciali frequenti, integrazione tramite API, o voci coerenti su un grande catalogo dove la novità conta meno dell'affidabilità. Un canale che si espande a livello internazionale illustra bene questa divisione: VoiceForge potrebbe fornire la voce di personaggio per uno sketch in lingua inglese, mentre una configurazione TTS e di doppiaggio multilingue produce le versioni localizzate per altri pubblici.
È su questo secondo scenario che ci concentriamo. Il nostro strumento Text to Speech offre oltre 300 voci AI, voiceover multilingue, controlli della velocità di pronuncia e progetti scaricabili costruiti per la produzione piuttosto che per una novità occasionale. I creator che vogliono mantenere la propria identità in ogni video possono usare Voice Cloning invece di accontentarsi di un personaggio standard, e gli sviluppatori che necessitano di generazione vocale all'interno di un'app possono costruire sulla nostra Text to Speech API. Quando l'obiettivo è trasformare una singola clip in un rilascio completamente localizzato, l'AI Dubbing porta lo stesso copione in lingue aggiuntive in un unico posto.
Una checklist di qualità pre-pubblicazione
Prima di distribuire l'audio di VoiceForge, fai un rapido controllo sulle cose che si rompono più spesso. Generare prima brevi passaggi di prova vale i pochi minuti in più, perché una voce che funziona in una frase può diventare stancante o fastidiosa nell'arco di un intero video.
- Pronuncia: I nomi, le abbreviazioni, i numeri e i termini tecnici sono pronunciati correttamente?
- Ritmo: Le pause cadono in modo naturale, non a metà frase?
- Coerenza del personaggio: La stessa voce è adatta a ogni scena, non solo all'introduzione?
- Transizioni audio: Ci sono salti udibili tra clip generate separatamente?
- Licenza: Il tuo piano attuale copre effettivamente l'uso monetizzato o commerciale?
- Adeguatezza al pubblico: Lo stile del personaggio è appropriato per la piattaforma e l'argomento?
- Allineamento: L'audio si integra pulitamente con il tuo video, la musica o i dialoghi di gioco?
- Diritti: Hai il permesso per qualsiasi copione fornito, nome o riferimento di terze parti presente nell'audio?
Domande frequenti
Cos'è VoiceForge text to speech?
È un servizio basato su browser che converte il testo scritto in audio parlato utilizzando una libreria di voci di personaggi distintive. Si basa sulla sintesi a selezione di unità, che assembla segmenti di parlato registrato da database vocali umani invece di generare audio da una singola forma d'onda di un modello.
VoiceForge è generato dall'AI?
È un servizio di sintesi vocale, ma il suo metodo documentato è la selezione di unità, non un sistema vocale neurale completamente generativo. Il motore seleziona e unisce unità di parlato umano registrato per produrre ogni enunciato.
Quante voci VoiceForge sono disponibili?
VoiceForge elenca 42 voci uniche, ognuna associata a uno speaker e a una personalità vocale diversi.
Qual è il limite di caratteri di VoiceForge?
Il servizio documenta un limite di 500 caratteri per input di testo, e qualsiasi markup SSML che aggiungi conta ai fini di quel limite. I copioni più lunghi devono essere suddivisi in più generazioni.
Posso usare l'audio di VoiceForge su YouTube?
Puoi, ma i contenuti monetizzati richiedono l'abbonamento commerciale appropriato. Il piano Publisher è descritto come la licenza per l'audio TTS utilizzato in contenuti monetizzati o commerciali, quindi conferma il tuo piano prima di pubblicare un video monetizzato.
VoiceForge è la stessa cosa della clonazione vocale?
No. VoiceForge utilizza la sua libreria vocale esistente, mentre la clonazione vocale crea una voce sintetica personalizzata a partire da registrazioni autorizzate di uno speaker specifico. Spieghiamo quel flusso di lavoro separato nella nostra pagina Voice Cloning.