Quel narratore piatto e leggermente robotico che legge le didascalie su una clip è diventato uno dei suoni più riconoscibili nei video in formato breve. Nel momento in cui le persone lo sentono, sanno esattamente che tipo di contenuto stanno guardando. Se hai cercato un modo affidabile per portare quell'effetto tiktok voice text to speech nei video che pubblichi ovunque, la buona notizia è che non devi restare bloccato dentro l'editor di una singola app per ottenerlo. Con il nostro strumento Text to Speech, scrivi il copione, scegli una voce che corrisponda al tono che desideri, generi l'audio e lo sincronizzi con il tuo filmato per TikTok, YouTube Shorts, Reels o ovunque tu pubblichi.
Il motivo per cui questo è importante va oltre il copiare una tendenza. Una voce narrante distintiva è un pezzo dell'identità del tuo canale. Una volta che è riconoscibile, gli spettatori la collegano a te su ogni piattaforma. Il problema di affidarsi solo al narratore integrato di un'app è che sei limitato a quell'app, alla sua breve lista di voci e alle sue regole. Abbiamo costruito il nostro flusso di lavoro in modo che la stessa voce che ami possa seguire i tuoi contenuti ovunque e, quando sei pronto, anche in altre lingue.
Indice dei contenuti
- Perché la voce narrante di TikTok è diventata uno strumento di narrazione
- Ricreare l'effetto con il nostro strumento Text to Speech
- Andare oltre le voci predefinite con la clonazione vocale
- Portare un'unica voce attraverso lingue e formati
- Automatizzare la narrazione in stile TikTok con le nostre API
- Scegliere il tuo percorso: voce predefinita, voce clonata o API
- Domande frequenti
Perché la voce narrante di TikTok è diventata uno strumento di narrazione
Il narratore integrato è nato come funzione di comodità. Aggiungi del testo a una clip, tocchi per convertirlo in voce, scegli tra una manciata di voci e l'app legge le tue didascalie ad alta voce. I tutorial in tutto il web guidano i principianti esattamente attraverso questo: aggiungere testo, tenerlo premuto a lungo o toccare l'icona della voce, poi scegliere un narratore. Poiché il processo è così semplice, i creator lo hanno adottato per gag comiche, spiegazioni passo passo, post di storytime e recensioni di prodotti.
Ciò che ha trasformato un'utilità in una tendenza è la ripetizione. Quando milioni di clip usano la stessa narrazione neutra e uniformemente ritmata, quel suono diventa una scorciatoia per un certo stile di contenuto. Gli spettatori smettono di sentirlo come una macchina e iniziano a sentirlo come la voce dello storytelling in formato breve. Questa familiarità è il motivo per cui così tanti creator ora vogliono lo stesso effetto su ogni piattaforma su cui pubblicano, e desiderano più controllo di quanto consenta una lista di voci fissa.
Il limite pratico è facile da raggiungere. Il narratore integrato di un'app ti offre un breve menu di voci e mantiene tutto dentro quella singola app. Se riutilizzi un video per un'altra piattaforma, o perdi la narrazione o la registri di nuovo. Se vuoi una voce che non è nella lista, sei bloccato. E se prevedi di pubblicare la stessa idea in un'altra lingua, lo strumento integrato non porterà il tuo narratore da un'altra parte per te. Sono esattamente queste lacune il punto in cui un flusso di lavoro dedicato Text to Speech guadagna il suo posto, permettendoti di generare la narrazione una sola volta e riutilizzarla ovunque pubblichi.
Ricreare l'effetto con il nostro strumento Text to Speech
Il nostro strumento Text to Speech è il pezzo che ricrea direttamente l'effetto del narratore su schermo. Invece di digitare le didascalie in un'app e sperare che il suo narratore vada bene, incolli il tuo copione, scegli da una libreria di oltre 300 voci dal suono naturale e generi un audio pulito che puoi inserire in qualsiasi video. Il risultato è un file scaricabile, quindi appartiene al tuo progetto piuttosto che all'editor di una singola piattaforma.
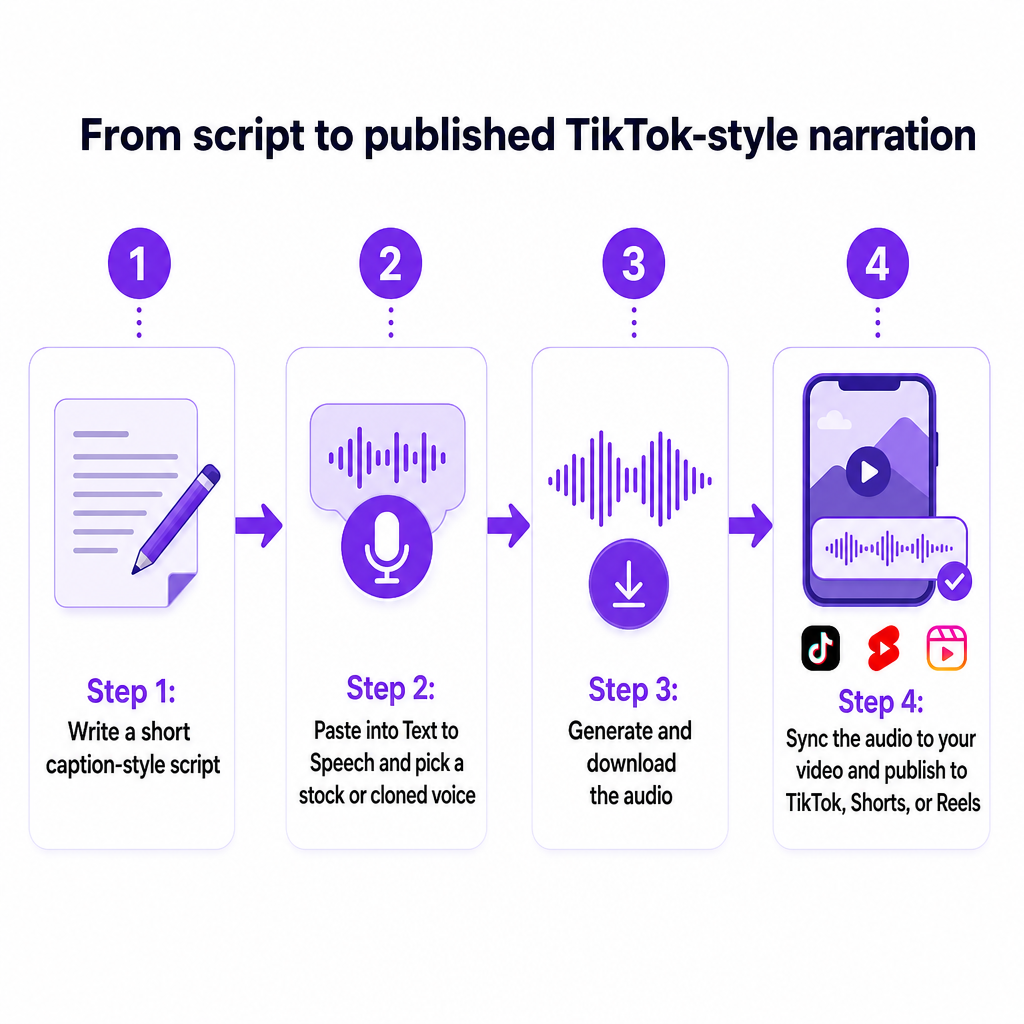
L'app web segue quattro semplici passaggi. Primo, scegli Text to Speech. Secondo, crea il parlato inserendo il tuo testo e selezionando un oratore. Terzo, modifica il progetto, dove puoi aggiungere altri oratori o regolare il testo. Quarto, scarica il progetto finito nel formato di cui hai bisogno. Non c'è nulla di tecnico in questo, ed è proprio il punto: dovresti dedicare le tue energie al copione e al montaggio, non a lottare con il software.
Applicato al video in formato breve, il flusso diventa ancora più concreto. Inizia scrivendo un copione breve, in stile didascalia, esattamente le parole che vuoi vengano lette sulla tua clip. Mantienilo incisivo; l'effetto narratore funziona meglio con frasi brevi e ritmate. Incolla quel copione in Text to Speech e scegli una voce il cui tono corrisponda all'atmosfera che cerchi, che sia impassibile, allegra o pragmatica. Genera l'audio, poi portalo nell'editor di tua scelta e allinealo con le immagini prima di pubblicare su TikTok, Shorts o Reels.
Poiché stai generando la narrazione al di fuori di una singola app, lo stesso file audio funziona su ogni piattaforma nella tua rotazione di pubblicazione. Registra una volta, riutilizza ovunque. Questo da solo risolve la più grande frustrazione con il narratore integrato di un'app: non stai più ricostruendo la stessa voce fuori campo tre volte per tre destinazioni.
Scrivere copioni adatti allo stile del narratore
La voce fa molto del lavoro, ma il copione imposta il ritmo. Frasi dichiarative brevi si leggono in modo pulito e colpiscono con la cadenza netta che gli spettatori associano alla tendenza. Numeri, elenchi e passaggi chiari come "primo", "poi" e "infine" si traducono bene nel parlato sintetizzato perché danno alla voce punti di pausa naturali. Se una frase suona goffa quando la leggi ad alta voce, suonerà goffa anche quando la legge la voce, quindi una rapida prova parlata prima di generare ti fa risparmiare molte rigenerazioni in seguito.
Andare oltre le voci predefinite con la clonazione vocale
Scegliere da una libreria è il percorso rapido e, per molti creator, una voce predefinita ben scelta è tutto ciò di cui hanno bisogno. Ma c'è un limite nel suonare come tutti gli altri. Se il tuo obiettivo è un narratore inconfondibilmente tuo, la nostra Clonazione vocale trasforma la tua stessa voce, o una voce di marchio con consenso, in un modello riutilizzabile che puoi guidare dal testo.
La distinzione è importante. Il text to speech generico significa selezionare tra narratori preimpostati. La clonazione vocale costruisce un modello sintetico di uno specifico oratore, così che nuovo parlato in quella voce possa essere generato da qualsiasi testo tu digiti. Nell'app web, carichi un file audio di almeno 20 secondi di parlato pulito, con rumore di fondo minimo, nella sezione clonazione vocale. Da quel breve e silenzioso campione creiamo una voce personalizzata che puoi usare come qualsiasi altra nei tuoi progetti Text to Speech.
Venti secondi di audio pulito sono un requisito minimo in termini di sforzo produttivo. Una stanza silenziosa, un telefono o un microfono di base e una breve lettura sono sufficienti per generare un narratore distintivo che puoi riutilizzare all'infinito. Una volta che esiste, non stai più scegliendo tra voci predefinite anonime; hai una voce che porta la tua identità in ogni clip, e resta coerente sia che tu pubblichi oggi o tra sei mesi.
È qui che un narratore riconoscibile diventa una risorsa di marca piuttosto che un effetto una tantum. Una voce clonata legge copioni che non hai mai effettivamente registrato, mantiene il suo carattere lungo un intero calendario di contenuti e non ha mai bisogno di una sessione di ri-registrazione perché hai cambiato la tua configurazione. Per i creator che costruiscono un'identità di canale a lungo termine, quella coerenza è il vero miglioramento rispetto a un menu rotante di voci dell'app.
Portare un'unica voce attraverso lingue e formati
Una voce narrante che funziona solo in una lingua limita la tua portata nel momento in cui vuoi crescere a livello internazionale. La nostra piattaforma supporta il doppiaggio multilingue in 33 lingue di destinazione e può generare parlato dal testo nella lingua che scegli, così che la stessa tendenza che funziona in inglese possa essere replicata per il pubblico altrove.
Ecco come i pezzi si incastrano insieme. Text to Speech ti dà la narrazione. La clonazione vocale permette a quella narrazione di restare in un'unica voce riconoscibile. Il nostro Doppiaggio AI estende lo stesso contenuto in altre lingue gestendo video e audio attraverso text to speech, speech to text e clonazione vocale all'interno di un unico flusso di lavoro. Invece di assumere narratori separati per ogni mercato, mantieni un'unica identità vocale e lasci che la piattaforma la porti attraverso le versioni.
Il flusso di lavoro si adatta anche oltre le clip brevi. Per contenuti più lunghi, puoi caricare video interi o file audio, regolare le impostazioni degli oratori, scegliere le lingue e selezionare le voci preferite all'interno di un progetto prima di esportare. Quindi lo stesso approccio che usi per aggiungere un narratore in stile virale a una clip di quindici secondi si applica anche a una spiegazione, a una lezione o a un episodio completo. Il formato breve è dove vive la tendenza, ma gli strumenti sottostanti non si fermano al formato breve.
Per i creator che pianificano una crescita globale, questo cambia l'economia della localizzazione. Un singolo copione diventa uno short in inglese, una versione in spagnolo e ulteriori versioni in altre lingue, tutte narrate con una voce coerente, senza ricostruire il tuo audio da zero ogni volta. L'effetto del narratore riconoscibile diventa qualcosa che puoi gestire come un sistema ripetibile piuttosto che come un colpo di fortuna una tantum.
Automatizzare la narrazione in stile TikTok con le nostre API
I singoli creator possono fare tutto quanto sopra nel browser. Le agenzie, i canali più grandi e i team con cataloghi arretrati di solito hanno bisogno dello stesso risultato in grandi volumi, ed è qui che entrano in gioco le nostre API. La API Text to Speech è un servizio RESTful che converte il testo in parlato dal suono naturale: invii una richiesta POST con il tuo testo e le preferenze vocali e ricevi in cambio un file audio pronto all'uso. Supporta le stesse oltre 300 voci e la clonazione vocale disponibili nell'app.
Per rendere programmatico un narratore personalizzato, la nostra API Clonazione vocale segue uno schema compatto in tre passaggi. Primo, carica un file audio e ricevi una chiave del file. Secondo, crea una voce personalizzata fornendo un nome e quella chiave del file. Terzo, usa la voce clonata risultante all'interno dei progetti Text to Speech tramite gli endpoint dei progetti TTS della piattaforma. Una volta che una voce esiste, diventa una risorsa riutilizzabile che le tue applicazioni possono richiamare, non un'esportazione monouso.
Messo insieme, questo permette a un team di industrializzare l'effetto. Immagina un'agenzia che gestisce diversi canali di clienti: può mantenere una voce di marca clonata per cliente, alimentare i copioni attraverso l'API e generare audio narrato per dozzine di video senza che una persona incolli manualmente il testo in uno strumento ogni volta. Lo stesso schema supporta i sistemi di apprendimento e le pipeline di localizzazione, dove le voci clonate vengono richiamate su richiesta man mano che il contenuto viene prodotto.
Per i team che generano anche immagini o vogliono costruire video brevi attorno a risorse statiche, il nostro strumento image-to-video si trova nello stesso ecosistema, così che la produzione audio e visiva viva in un unico posto piuttosto che sparsa tra app scollegate. L'obiettivo è un unico flusso di lavoro: una piattaforma per scrivere, dare voce, localizzare e assemblare.
Una nota sulle aspettative: descriviamo queste API in termini funzionali perché è da questo che dipende il flusso di lavoro. Se desideri dettagli sui limiti di frequenza, sul throughput o sulle configurazioni specifiche del piano, dicci il volume previsto e il caso d'uso così possiamo preparare una raccomandazione che corrisponda al tuo carico di lavoro.
Scegliere il tuo percorso: voce predefinita, voce clonata o API
La maggior parte dei lettori arriva con una di tre esigenze, e il punto di partenza giusto dipende da quale ti descrive. La tabella qui sotto associa ogni situazione alla prima mossa utile più rapida.
| La tua situazione | Miglior punto di partenza | Perché è adatto |
|---|---|---|
| Testare l'effetto rapidamente | Voce predefinita in Text to Speech | Scegli tra oltre 300 voci, genera audio in pochi minuti, nessuna registrazione necessaria |
| Costruire una voce distintiva del canale | Clonazione vocale | Trasforma un campione pulito di 20 secondi in un narratore personalizzato riutilizzabile |
| Produrre su larga scala o tra più clienti | API TTS e Clonazione vocale | Automatizza la narrazione su molti video e versioni multilingue |
Se non sei sicuro, inizia in modo semplice. Prepara un breve copione in stile didascalia per il tuo prossimo post, apri Text to Speech nel browser e generalo con una voce predefinita che corrisponda al tuo tono. Se ti piace l'effetto ma vuoi che suoni come te, carica un campione pulito di 20 secondi e clona la tua voce, poi confronta le due sulla stessa clip. Quel singolo confronto di solito risolve la questione se vuoi un narratore predefinito in stile virale o una voce di marca unica in futuro.
I team e gli sviluppatori che gestiscono più canali o un grande catalogo arretrato otterranno più valore dall'accesso alle API, poiché il flusso manuale del browser non si adatta a centinaia di risorse. Qualunque si adatti al tuo volume, la capacità sottostante è la stessa: un narratore riconoscibile, alle tue condizioni, su ogni piattaforma su cui pubblichi. Se desideri aiuto per associare il piano del tuo canale, la dimensione del catalogo e le lingue di destinazione all'approccio giusto, condividi questi dettagli con noi e ti suggeriremo una configurazione adeguata.
Un'avvertenza pratica da tenere a mente: quando cloni una voce, usa la tua o una per cui hai un chiaro permesso di utilizzo, e segui le regole di pubblicazione di qualunque piattaforma su cui pubblichi. Questo rende la tua strategia del narratore riconoscibile sostenibile piuttosto che rischiosa.
Domande frequenti
DubSmart AI ha un preset etichettato "voce TikTok"?
Il nostro obiettivo è ricreare l'effetto piuttosto che imitare uno specifico preset proprietario. Ottieni quella familiare sensazione di narratore su schermo generando audio in Text to Speech da una libreria di oltre 300 voci, poi scegliendone una il cui tono corrisponda allo stile che desideri. Puoi anche clonare una voce personalizzata per un narratore che sia unicamente tuo. Se hai in mente un tono o una voce di marca particolare, diccelo e ti suggeriremo un approccio adatto.
Come aggiungo l'effetto narratore a video al di fuori di TikTok?
Scrivi un breve copione in stile didascalia, incollalo nel nostro strumento Text to Speech, seleziona un oratore e genera l'audio. Scarica il file e allinealo con il tuo filmato in qualsiasi editor, poi pubblica su Shorts, Reels o ovunque altro. Poiché l'audio è un file autonomo, una sola narrazione funziona su ogni piattaforma su cui pubblichi.
Cosa mi serve per clonare la mia voce?
Carica un file audio di almeno 20 secondi di parlato pulito con rumore di fondo minimo nella sezione clonazione vocale. Da quel breve e silenzioso campione creiamo un modello di voce personalizzato che puoi poi usare all'interno dei tuoi progetti Text to Speech come qualsiasi altra voce.
Posso usare la stessa voce in lingue diverse?
Sì. La nostra piattaforma supporta il doppiaggio multilingue in 33 lingue di destinazione, e combinando Text to Speech, clonazione vocale e Doppiaggio AI puoi mantenere un'unica voce riconoscibile attraverso le versioni dello stesso contenuto, così che uno short in inglese e le sue versioni in altre lingue condividano un narratore coerente.
C'è un modo per automatizzarlo per molti video contemporaneamente?
Sviluppatori e agenzie possono usare la nostra API Text to Speech per convertire il testo in audio in modo programmatico, e l'API Clonazione vocale per caricare un campione, creare una voce personalizzata con nome e richiamarla all'interno dei progetti TTS. Questo ti permette di generare narrazione su grandi cataloghi e canali multipli senza lavoro manuale per ogni video.
Dovrei scegliere una voce predefinita o clonare la mia?
Una voce predefinita è il modo più rapido per testare l'effetto e funziona bene per molti creator. La clonazione è la scelta migliore quando vuoi un narratore inconfondibilmente legato al tuo marchio e che resti coerente nel tempo. Provare entrambe sulla stessa clip è il modo più veloce per decidere quale preferisci.