Un voiceover AI per video di formazione prende forma quando abbini uno script scritto a un motore vocale AI, cloni facoltativamente la voce del tuo formatore e generi la narrazione in una o più lingue da un'unica piattaforma. Questa è la risposta breve su come creare un voiceover AI per video di formazione, e vale sia che tu stia producendo un clip di onboarding di due minuti sia che tu stia localizzando un'intera libreria sulla compliance. La questione più ampia è quale flusso di lavoro si adatta ai tuoi contenuti, al tuo pubblico e alla frequenza con cui prevedi di aggiornare il materiale.
Con DubSmart AI, i team di formazione generalmente scelgono uno di due punti di partenza. O generi una nuova narrazione dal testo, oppure carichi video esistenti e lasci che la piattaforma li doppi dall'inizio alla fine gestendo trascrizione, traduzione e generazione vocale. Entrambi i percorsi risiedono all'interno di un unico flusso di lavoro basato su crediti, quindi raramente hai bisogno di un'app di trascrizione, un servizio di traduzione o uno strumento vocale separati per completare un corso.
Indice dei contenuti
Quale decisione stai realmente prendendo?
La vera scelta non è solo quale pulsante premere. Si tratta di quale tipo di flusso di lavoro per voiceover si adatta ai tuoi contenuti di formazione e alle persone che li guardano. Con DubSmart AI, quella decisione di solito rientra in tre categorie, e ciascuna definisce quanto coerente risulta l'esperienza di apprendimento e quanto velocemente puoi rivedere i corsi in seguito.
- Usa narratori AI standard da una libreria di oltre 300 voci dal suono naturale in più di 33 lingue quando hai semplicemente bisogno di una narrazione di formazione rapida e professionale.
- Clona la voce di un formatore specifico o del brand così che i discenti sentano un oratore familiare, anche quando i corsi vengono localizzati in diverse lingue.
- Automatizza la produzione di voiceover tramite le nostre API quando hai bisogno di convogliare il testo del corso da un LMS o da un'app direttamente nella generazione audio su larga scala.
Ogni percorso influisce su tre aspetti contemporaneamente: quanto uniforme suona l'esperienza di apprendimento, quanto velocemente puoi pubblicare gli aggiornamenti e con quanta facilità ti espandi nella formazione multilingue senza dover registrare nuovamente tutto. Un team che produce cinque corsi rifiniti all'anno valuterà questi aspetti in modo diverso rispetto a uno che mantiene alcune centinaia di moduli basati sui ruoli, quindi è utile definire il tuo volume e il ritmo di aggiornamento prima di scegliere uno strumento.
Come DubSmart AI crea voiceover per video di formazione
DubSmart è una piattaforma all-in-one di creazione e localizzazione di media AI che consolida Text to Speech, Clonazione Vocale, Doppiaggio AI, Speech to Text, Separatore Vocale, Text to Image e Image to Video in un unico flusso di lavoro basato su crediti. Per i team di formazione, questa consolidazione è il punto chiave: puoi passare da uno script grezzo a un video di formazione finito e localizzato senza cambiare fornitore a metà strada.
Narrazione text-to-speech dal tuo script
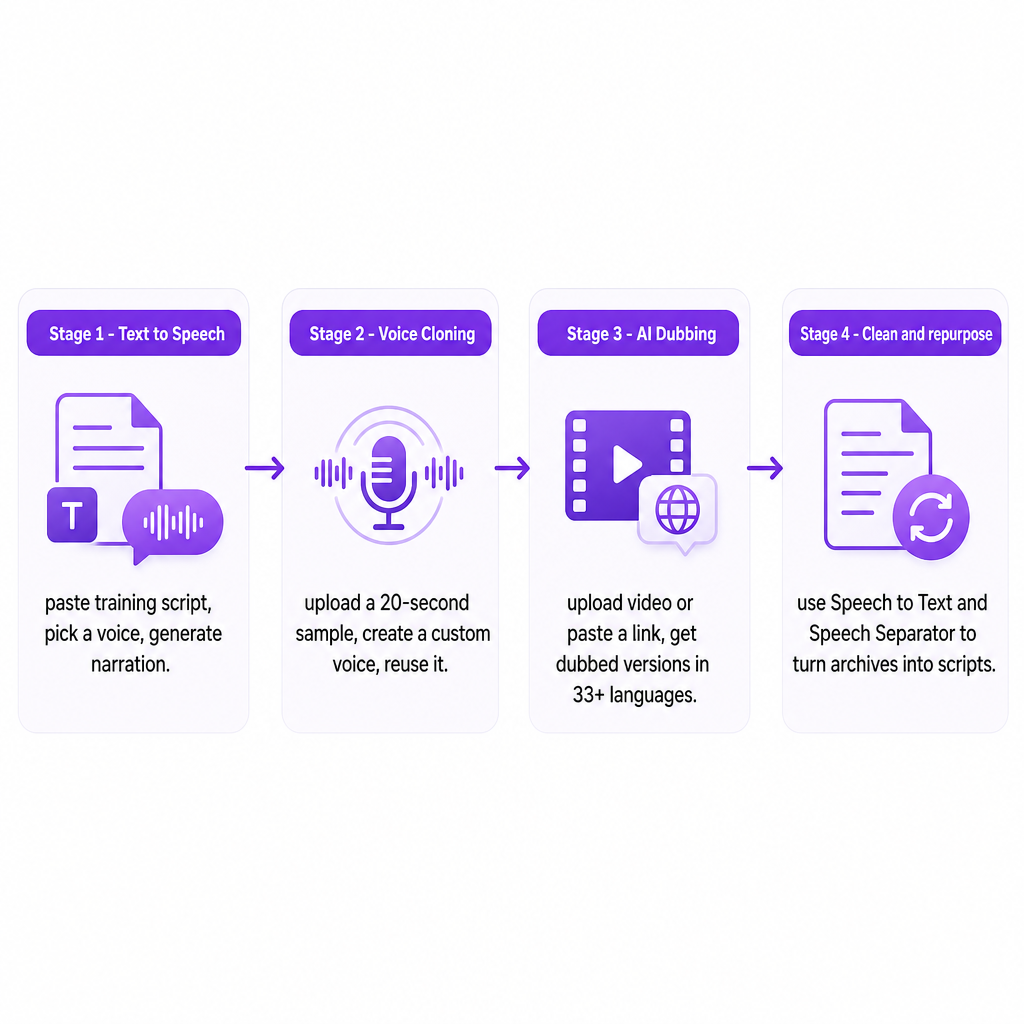
Per la maggior parte dei corsi il punto di partenza è uno script: moduli di onboarding, procedure di sicurezza, spiegazioni sulla compliance o guide software. Il nostro strumento Text to Speech converte quel testo in un parlato naturale e simile a quello umano in qualsiasi lingua supportata. All'interno dell'app web il flusso rimane accessibile per i creatori non tecnici. Apri lo strumento, incolli o digiti il tuo script, scegli un oratore dalla libreria vocale e generi l'audio. Una volta che suona bene, puoi aggiungere o cambiare oratori, rivedere singoli segmenti e scaricare il file finito nel formato che preferisci per inserirlo nel tuo editor video.
I team con una piattaforma di apprendimento o un'app personalizzata possono raggiungere la stessa funzionalità tramite la nostra Text to Speech API. Invii una richiesta con il testo del corso e le preferenze vocali, e l'API restituisce audio di alta qualità che puoi allegare in modo programmatico alle lezioni o a contenuti generati dinamicamente.
Clonazione della voce del tuo formatore o del brand
Quando vuoi che la formazione suoni come una persona specifica, la Clonazione Vocale costruisce un modello sintetico di quella voce così che nuovo parlato possa essere generato dal testo con lo stesso tono. Questo differisce dal text-to-speech generico, dove scegli tra narratori predefiniti anziché fornire il tuo oratore. Nel percorso accessibile ai creatori, raccogli un breve campione pulito, tipicamente di almeno 20 secondi, e lo carichi nella sezione Clonazione Vocale. Il sistema lo trasforma in una voce personalizzata con un nome che poi appare sia nei progetti Text to Speech sia in quelli di Doppiaggio AI. Da lì incolli gli script e li fai leggere con la voce clonata per introduzioni, spiegazioni dettagliate o segmenti sulla compliance, senza dover richiamare il formatore per ogni aggiornamento. Se vuoi conoscere i meccanismi sottostanti, la nostra spiegazione su come l'AI ricrea qualsiasi voce illustra il modello in termini semplici.
Sviluppatori e agenzie possono formalizzare questo tramite la Voice Cloning API secondo uno schema in tre passaggi. Primo, richiedi un URL prefirmato e carichi un file audio in un formato supportato come MP3, WAV, AAC, M4A o FLAC. Secondo, crei una voce personalizzata inviando un nome e la chiave del file di quel caricamento. Terzo, fai riferimento all'identificatore della voce clonata all'interno dei progetti Text to Speech o Doppiaggio AI così che qualsiasi testo di formazione o video utilizzi automaticamente quella voce.
Doppiaggio multilingue per un pubblico globale
Quando hai già registrato guide, sessioni condotte da istruttori o presentazioni dal vivo, doppiarle direttamente spesso è meglio che ricostruire da zero. La nostra AI Dubbing API e lo strumento web sono costruiti per flussi di lavoro speech-to-speech: carichi un file video o audio sorgente, o incolli un link, e ricevi versioni doppiate nelle tue lingue di destinazione mentre la piattaforma gestisce trascrizione, traduzione e generazione vocale. Puoi aggiungere oratori, regolare i tempi e modificare i segmenti di testo generati così che la terminologia e il ritmo corrispondano ai tuoi standard di formazione prima di scaricare. Poiché il doppiaggio funziona in più di 33 lingue e integra la clonazione vocale, puoi mantenere la stessa voce del formatore per ogni regione o cambiare narratori dove ha senso, tutto da un unico account. Per cataloghi di grandi dimensioni, l'API riproduce questo flusso in modo programmatico e restituisce tracce doppiate che puoi inserire in una pipeline di pubblicazione esistente.
Pulizia e riutilizzo dell'audio esistente
Molte organizzazioni possiedono già librerie di webinar e workshop registrati che potrebbero diventare moduli strutturati. Poiché DubSmart include Speech to Text e un Separatore Vocale insieme alla clonazione e al doppiaggio, quegli archivi possono essere trasformati in risorse riutilizzabili. Speech to Text converte il contenuto parlato in trascrizioni che puoi modificare in script puliti, e un Separatore Vocale aiuta a isolare le voci dall'audio misto così da ottenere campioni più puliti per la clonazione o un input migliore per la trascrizione. Questa combinazione riduce la necessità di registrare nuovamente e ti permette di modernizzare i contenuti legacy con una narrazione coerente.
Criteri decisionali chiave per i team di formazione ed e-learning
Una volta compresi i meccanismi, la scelta si riduce a una manciata di fattori pratici. La tabella qui sotto mappa le priorità comuni al percorso che tende ad adattarsi, e le note che seguono aggiungono le sfumature che una tabella non può contenere.
| Priorità | Percorso più adatto | Perché si adatta |
|---|---|---|
| Voce dell'istruttore riconoscibile | Clonazione vocale | Riutilizza una voce clonata in flussi di lavoro TTS, doppiaggio e API |
| Velocità rispetto all'identità | Voci TTS predefinite | Oltre 300 stili pronti senza configurazione |
| Cataloghi grandi o aggiornati frequentemente | API TTS o Doppiaggio | Automatizza la generazione nei flussi di pubblicazione |
| Forza lavoro globale | Doppiaggio AI + clonazione | Doppia in oltre 33 lingue, mantieni la sensazione originale |
| Contenuti tecnici o regolamentati | Progetti di doppiaggio modificabili | Rivedi la terminologia prima di finalizzare |
La coerenza dell'esperienza di apprendimento è spesso il fattore decisivo. Se la tua strategia si basa su un istruttore riconoscibile o su una voce aziendale, la clonazione mantiene intatta quell'identità tra moduli e lingue, e la stessa voce clonata può apparire in corsi generati a mesi di distanza. Se la velocità conta più di una singola identità, le oltre 300 voci predefinite ti permettono di abbinare il tono al tipo di contenuto, per esempio una voce più pacata per la compliance e una più leggera per l'onboarding.
Il volume e la frequenza di aggiornamento spingono il calcolo verso l'automazione. Un team che produce una manciata di corsi può lavorare comodamente nell'app web, generando voiceover e doppiaggi secondo necessità. Le organizzazioni che mantengono grandi cataloghi o variazioni basate sui ruoli beneficiano delle API, che convertono automaticamente testo o video in audio all'interno di flussi di pubblicazione programmati. Se prevedi frequenti cambiamenti di policy o aggiornamenti software, il TTS basato su testo e il doppiaggio ti permettono di rigenerare rapidamente la narrazione senza prenotare tempo in studio.
La copertura linguistica conta di più per le aziende con sede negli Stati Uniti che formano team globali. DubSmart supporta il doppiaggio da più di 60 lingue sorgente in almeno 33 lingue di destinazione, abbinato a clonazione e TTS, così ogni regione può ricevere contenuti nella propria lingua principale mantenendo l'aspetto e la sensazione dell'originale. Per esigenze più leggere, come l'inglese statunitense con occasionali moduli in spagnolo, le voci TTS predefinite possono essere sufficienti e ridurre il lavoro di configurazione.
I contenuti tecnici e normativi meritano cura extra. Il gergo, i nomi dei prodotti e la formulazione legale devono essere pronunciati e tradotti correttamente, quindi la possibilità di rivedere e modificare le trascrizioni e i segmenti generati nei progetti di doppiaggio dà agli esperti in materia un controllo reale. Quando usi le API, puoi codificare la terminologia preferita nei tuoi script o nella logica di pre-elaborazione così che ciò che il TTS o il doppiaggio riceve sia già verificato.
Dati, consenso e governance chiudono l'elenco. La clonazione richiede campioni vocali dell'oratore target, quindi assicurati il consenso e documenta come verrà utilizzata la voce clonata. Poiché il nostro processo di clonazione accetta registrazioni brevi e pulite, raccogli meno dati pur producendo un modello utilizzabile. Centralizzare clonazione, TTS e doppiaggio in un'unica piattaforma semplifica anche le tracce di audit rispetto al destreggiarsi tra strumenti separati, e un modello basato su crediti con API permette ai responsabili della formazione di controllare l'utilizzo da un'unica struttura di account.
Rischi e misure di salvaguardia nell'uso dei voiceover AI nella formazione
La narrazione AI è veloce, ma alcune modalità di fallimento meritano attenzione prima di scalare.
Il disallineamento con lo stile del brand o didattico è il più comune. Le voci AI, comprese quelle clonate, possono essere generate a velocità e intensità diverse che potrebbero non corrispondere al tuo stile aziendale. Ascolta output campione, regola i parametri di resa dove disponibili e standardizza le scelte vocali per tipo di corso prima di distribuire ampiamente.
Le sfumature di pronuncia e traduzione vengono subito dopo. La narrazione automatizzata può inciampare su nomi o termini specializzati, e la traduzione automatica può produrre formulazioni accurate ma pedagogicamente goffe. La possibilità di modificare i segmenti di testo nei progetti di doppiaggio e rigenerare l'audio aiuta, ma non sostituisce la revisione umana per moduli critici di compliance o sicurezza.
L'eccessivo affidamento sull'automazione è un rischio più sottile. Per argomenti sensibili come la condotta sul lavoro, la salute mentale o gli obblighi legali, errori di tono possono insinuarsi anche quando i fatti sono corretti. Abbinare i voiceover AI alla revisione umana, e occasionalmente un segmento registrato da un umano per i messaggi più cruciali, tende a raggiungere un migliore equilibrio.
Gestire responsabilmente le voci clonate completa il quadro. Una voce clonata è una risorsa riutilizzabile, il che solleva questioni di ambito e ciclo di vita. Stabilisci policy interne su chi può attivare la generazione con una determinata voce, per quanto tempo i campioni vengono conservati e come l'accesso viene revocato se un formatore lascia. Queste misure di protezione mantengono la tecnologia etica e prevedibile.
Se stai valutando dove si inserisce la narrazione AI e dove un umano dovrebbe rimanere coinvolto, inizia definendo il volume dei tuoi corsi, le lingue e la frequenza con cui i contenuti cambiano. Comunicaci questi dettagli e possiamo aiutarti a mappare il giusto mix di Text to Speech, clonazione vocale e doppiaggio per il tuo programma.
Domande frequenti
Posso mantenere la voce del mio formatore e comunque localizzare i corsi in più lingue?
Sì. Puoi clonare la voce del tuo formatore e poi usare quella voce clonata sia nei progetti Text to Speech sia in quelli di Doppiaggio AI, incluse le versioni doppiate in altre lingue.
Quanto audio mi serve per clonare una voce per la narrazione di formazione?
La clonazione funziona da campioni brevi e puliti, tipicamente di almeno 20 secondi di parlato. Molti creatori usano da 20 a 60 secondi per un modello più robusto.
Quali formati audio posso usare quando carico campioni per la clonazione vocale?
La Voice Cloning API accetta formati comuni come MP3, WAV, AAC, M4A e FLAC, caricati tramite un URL prefirmato prima che il campione diventi una voce AI personalizzata.
Gli sviluppatori possono automatizzare i voiceover dai contenuti di LMS o app?
Sì. La Text to Speech API e la AI Dubbing API permettono ai sistemi backend di inviare testo o video di formazione e ricevere audio pronto all'uso o tracce doppiate per flussi di pubblicazione automatizzati.
DubSmart è adatto per la formazione sulla compliance e normativa?
La nostra combinazione di TTS, clonazione vocale, Doppiaggio AI e controlli di modifica supporta flussi di lavoro strutturati e ripetibili, ma i team dovrebbero comunque applicare revisione umana e governance per argomenti sensibili o regolamentati.