Il modo più rapido per integrare un'API di sintesi vocale è trattarla come un servizio REST: autenticati con una chiave API, invia il tuo testo insieme alle impostazioni della voce come JSON, lascia che il servizio renderizzi il parlato in background, quindi recupera e archivia i file audio risultanti per la riproduzione ovunque i tuoi utenti ne abbiano bisogno. La nostra API di sintesi vocale segue esattamente questo modello, offrendo oltre 300 voci naturali e clonazione vocale illimitata, così puoi inserire parlato realistico in siti web, app, pipeline video e piattaforme di apprendimento. Questa guida illustra cosa stai effettivamente collegando, come funziona il nostro motore e le decisioni che determinano se l'integrazione è adatta al tuo prodotto.
Indice dei contenuti
Cosa fa un'API di sintesi vocale in DubSmart
Un'API di sintesi vocale trasforma testo strutturato in audio parlato su richiesta, così il tuo codice può richiedere una narrazione o un dialogo nel momento in cui uno script è pronto invece di attendere una registrazione manuale. Il nostro motore di sintesi vocale alimenta sia lo strumento Text to Speech basato su browser sia l'API, offrendo accesso a più di 300 voci AI in diverse lingue, generi e stili, con prosodia ottimizzata per narrazioni, video esplicativi e dialoghi.
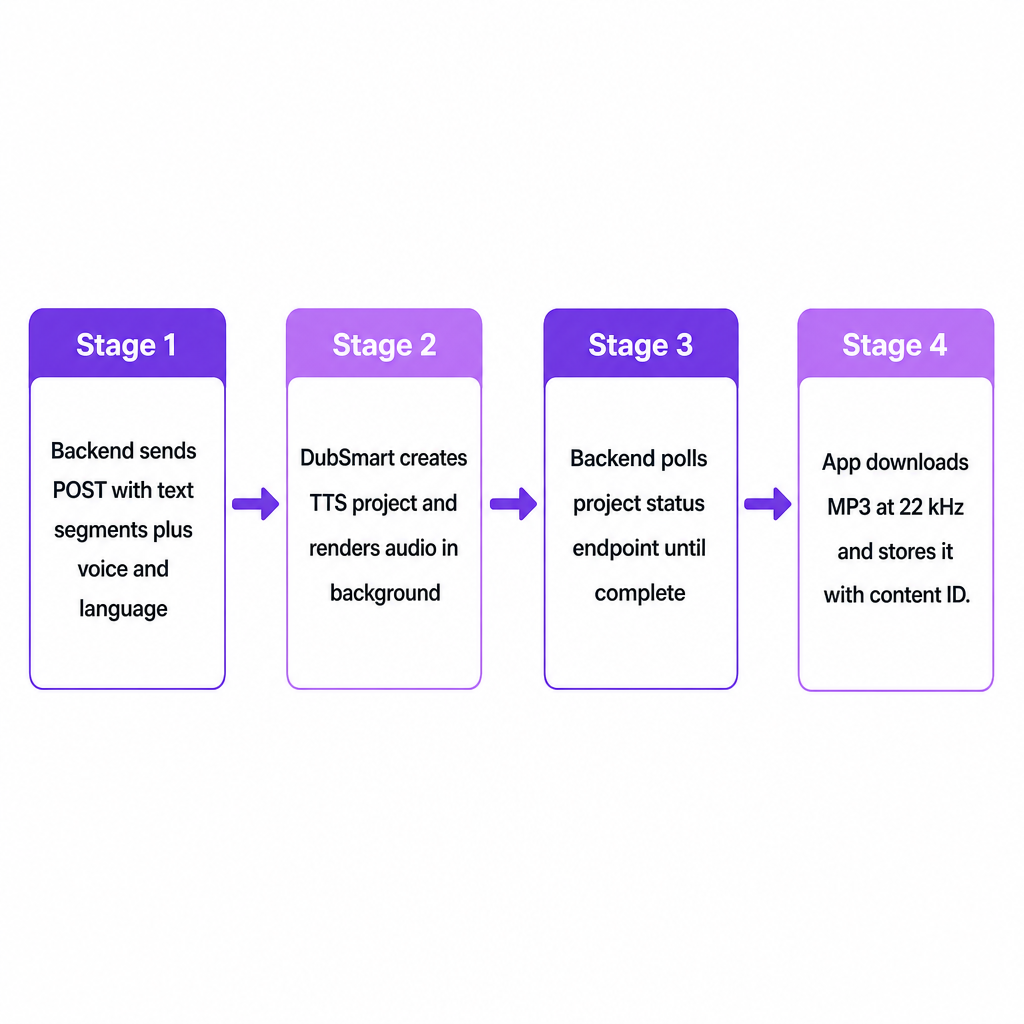
A livello di API esponiamo questo motore come servizio RESTful: il tuo backend invia una richiesta POST contenente segmenti di testo e parametri vocali, e il servizio restituisce un oggetto progetto il cui stato puoi interrogare finché l'audio non è pronto per il download. L'output viene fornito come file audio di alta qualità, tipicamente MP3 a 22 kHz, adatto all'uso diretto in editor video, flussi di lavoro per podcast o player web senza conversioni aggiuntive.
Per i creator e i team che serviamo—YouTuber, piccole imprese, produttori di e-learning, filmmaker e agenzie di sviluppo—l'API collega la pianificazione dei contenuti alla pubblicazione. Non appena uno script arriva a un CMS o a una piattaforma di apprendimento, il backend può generare automaticamente i voiceover, eliminando il collo di bottiglia della ripetuta registrazione manuale.
La decisione di integrazione: cosa stai effettivamente collegando?
"Integrare un'API di sintesi vocale" suona generico, ma in pratica stai decidendo tre cose: dove nel tuo flusso di lavoro dovrebbe essere generato il parlato, quali voci e lingue rappresenteranno il tuo brand e con quanta precisione automatizzi la generazione e il recupero dell'audio.
Per un creator di YouTube che si espande verso contenuti multilingue, l'integrazione spesso significa collegare la nostra API a uno strumento di pianificazione video o a un database di script così che ogni script finalizzato diventi un voiceover nella lingua e nello stile giusti. Per le piccole imprese e i team di marketing, l'API di solito si colloca dietro un CMS o una piattaforma di automazione del marketing, trasformando articoli di blog, video esplicativi di prodotti e testi social in asset audio riutilizzabili. I fornitori di e-learning e formazione aziendale tendono a collegare l'API agli strumenti di authoring così che i moduli delle lezioni possano richiedere una narrazione per diapositiva o per argomento e rigenerarla istantaneamente quando il materiale viene aggiornato.
Gli sviluppatori e le agenzie che integrano l'AI vocale più a fondo di solito scelgono tra due modelli. Un modello batch raccoglie gli script e li elabora tramite lavori pianificati. Un modello transazionale attiva una richiesta immediata ogni volta che arriva nuovo contenuto o un'azione dell'utente. La nostra API basata su progetti funziona perfettamente per entrambi, perché ogni progetto TTS incapsula testo, scelta della voce, lingua e audio risultante in un modo che si mappa alle tue unità di contenuto—video, lezioni o episodi di podcast. Se stai ancora valutando il concetto in sé, il nostro articolo complementare su cos'è un'API di sintesi vocale e come funziona copre le nozioni fondamentali prima che tu ti impegni in un design.
Come funziona la nostra API di sintesi vocale dietro le quinte
La nostra API di sintesi vocale è costruita attorno a progetti e segmenti, il che la rende più flessibile di un singolo endpoint "testo in ingresso, audio in uscita". Un progetto TTS raggruppa uno o più segmenti di testo sotto un titolo e una configurazione condivisa come la lingua e la voce predefinita. Ogni segmento porta il proprio testo, identificatore vocale e tag di lingua, il che ti consente di mescolare stili di narrazione o lingue all'interno di un singolo output.
Un tipico payload JSON verso l'endpoint del progetto TTS include un titolo del progetto leggibile per le tue dashboard e i tuoi log, più un array di segmenti. Ogni segmento imposta text (lo script o la frase da pronunciare), voice (un ID voce integrato o un ID voce personalizzato creato tramite l'API di clonazione vocale) e language (un codice che indica la lingua del segmento).
Quando il tuo backend invia questo payload all'endpoint TTS con una chiave API valida nell'header Authorization, creiamo il progetto e iniziamo a renderizzare l'audio in background. L'API espone un endpoint di stato del progetto che indica se l'elaborazione è ancora in corso o completata, insieme ai riferimenti ai file audio generati una volta pronti. Questo design asincrono mantiene veloci le tue richieste: registra l'ID del progetto, restituisci il controllo all'utente e lascia che un worker in background verifichi il completamento e scarichi l'audio quando disponibile.
Il parlato generato arriva come file scaricabili in formati standard, in particolare MP3 a 22 kHz, che si inserisce facilmente in player web, app mobili e timeline di editing video. Poiché lo stesso motore alimenta il nostro strumento basato su browser, gli sviluppatori possono prototipare voci e script in modo interattivo e poi migrare le combinazioni vincenti in chiamate API automatizzate. Il riferimento completo degli endpoint si trova nella pagina Text to Speech API.
Collegare la clonazione vocale e il doppiaggio AI alla sintesi vocale
La nostra caratteristica distintiva è che Sintesi Vocale, Clonazione Vocale e Doppiaggio AI condividono un unico motore vocale sottostante e un unico flusso di lavoro. Ciò significa che l'API TTS non è isolata—è il cuore di una pipeline di localizzazione più ampia.
L'API di clonazione vocale ti consente di caricare campioni audio di un parlante, creare una voce AI personalizzata e fare riferimento a quella voce nei progetti TTS. Una volta che esiste una voce personalizzata, il suo identificatore diventa il campo voice nei tuoi segmenti di sintesi vocale, così la narrazione viene riprodotta con la voce clonata invece che con una voce standard generica. Questa continuità è importante per conduttori, podcaster e portavoce di brand che desiderano un'identità sonora coerente tra lingue e formati. Se prevedi di aggiungere la clonazione, la nostra guida sull'integrazione di un'API di clonazione vocale nella tua app copre i dettagli.
L'API di doppiaggio AI estende ulteriormente questo aspetto combinando trascrizione, traduzione e sintesi vocale in un'unica pipeline che doppia video in più di 33 lingue di destinazione. Qui il motore TTS converte gli script tradotti in parlato utilizzando la stessa libreria di oltre 300 voci o la tua voce clonata, così le versioni doppiate mantengono tono e tempismo. Per i creator e le aziende multilingue, l'API di sintesi vocale diventa il mattone di base sia per i voiceover monolingua sia per i contenuti doppiati completamente localizzati. La nostra panoramica su come funziona la localizzazione AI mostra come questi elementi si incastrano da un capo all'altro.
Criteri decisionali chiave nell'integrazione della nostra API TTS
Integrare "una qualsiasi" API TTS non è sufficiente; le scelte relative all'implementazione determinano quanto bene si adatta alla tua produzione, al tuo brand e al tuo stack tecnico.
Esigenze di scala e automazione. Se il volume di contenuti è basso e sporadico, lo strumento basato su browser può essere sufficiente. Una volta che gli script vengono generati regolarmente o legati a calendari di contenuti, sistemi di gestione dell'apprendimento o automazione del marketing, l'API diventa il livello giusto perché può essere attivata programmaticamente e scalata con il tuo backend.
Strategia vocale e linguistica. La nostra piattaforma supporta il doppiaggio da oltre 60 lingue di origine verso 33 lingue di destinazione, alimentata dallo stesso motore vocale utilizzato dall'API TTS. Se il tuo brand ha bisogno di una voce di portavoce distintiva, abbinare l'API di clonazione vocale al TTS mantiene quella voce coerente tra lingue e canali. Se dai priorità alla velocità rispetto alla personalizzazione, le voci integrate semplificano l'implementazione.
Punto di integrazione nel tuo stack. Per i canali YouTube, un punto naturale è la pipeline video: script archiviati in uno strumento di pianificazione, inviati all'API TTS quando finalizzati e restituiti come audio pronto per gli editor. Le piattaforme di e-learning possono integrarsi a livello di lezione o diapositiva, dove ogni blocco di contenuto si mappa a un segmento e i progetti rappresentano interi corsi. I team di marketing spesso si integrano a livello di CMS così che ogni articolo o pagina di prodotto possa richiedere una versione audio per l'accessibilità.
Governance, conformità e rischio. Poiché la clonazione vocale può replicare voci riconoscibili, consenso, licenze e politiche di utilizzo sono importanti. Le voci clonate sono identificate da ID e possono essere etichettate con metadati, il che rende più facile applicare regole interne su dove specifiche voci possono essere utilizzate. Decidi in anticipo quali ambienti possono attivare voci clonate rispetto alle voci generiche e aggiungi il logging nei tuoi sistemi.
Aspettative di latenza ed esperienza utente. L'elaborazione asincrona offre flessibilità ma aggiunge una considerazione sul tempismo. Per i flussi di lavoro in cui gli utenti si aspettano una riproduzione immediata—come un editor di script con anteprima istantanea—crea progetti o segmenti più piccoli e mostra indicatori di avanzamento mentre l'audio viene renderizzato. Per la localizzazione batch di intere librerie, la latenza conta meno, e i lavori possono essere eseguiti su pianificazioni con l'audio completato allegato ai record di contenuto in seguito.
| Area decisionale | Modello batch | Modello transazionale |
|---|---|---|
| Attivazione | Lavori pianificati | Per elemento di contenuto o azione dell'utente |
| Tolleranza alla latenza | Alta | Bassa |
| Adatto a | Cataloghi di corsi, librerie video | Editor di script, anteprime in tempo reale |
| Strategia vocale | Voce approvata per lingua | Voce approvata per lingua |
Rischi e misure di sicurezza pratiche
Integrare un'API di sintesi vocale comporta alcuni rischi prevedibili che un design ponderato può mitigare.
Scegliere le voci senza testarle può produrre un parlato che sembra fuori carattere per un brand o un conduttore. Prova prima le voci nell'interfaccia interattiva e mantieni un catalogo di voci approvate all'interno dei tuoi sistemi, organizzato per lingua e tipo di contenuto, prima di codificare gli ID vocali nelle chiamate API.
L'eccessiva automazione di contenuti sensibili è un'altra trappola. Generare automaticamente il parlato per materiale di conformità, medico o legale potrebbe non essere appropriato. Poiché la nostra API opera su progetti e segmenti distinti, puoi mantenere regole di instradamento che inviano al TTS solo categorie approvate mantenendo i contenuti sensibili in flussi di lavoro con registrazione umana.
Gli errori operativi—progetti falliti o download mancanti—si verificano quando problemi di rete o payload non validi interrompono l'elaborazione. Gli endpoint di stato del progetto e le risposte strutturate ti consentono di confermare che un progetto sia stato completato e che i suoi output siano disponibili prima della pubblicazione. Abbina ogni ID progetto TTS al tuo ID di contenuto e implementa nuovi tentativi o fallback quando i controlli di stato segnalano errori.
L'uso improprio delle voci clonate merita controlli espliciti. Le voci personalizzate devono essere create tramite endpoint dedicati e poi referenziate tramite ID nei progetti TTS, il che ti offre un confine tecnico chiaro da monitorare. Limita chi può creare o assegnare gli ID delle voci clonate e registra dove vengono utilizzati.
Un percorso di partenza pratico è integrare prima il TTS per i voiceover standard, validare le voci e la gestione degli errori in produzione, quindi aggiungere la Clonazione Vocale e il Doppiaggio AI una volta che l'integrazione di base è stabile. Dicci il tuo volume di contenuti, le lingue di destinazione e dove dovrebbe collocarsi l'API nel tuo stack, e possiamo indicarti gli endpoint giusti e pianificare per il tuo flusso di lavoro.
Domande frequenti
In che modo l'API di sintesi vocale è diversa dallo strumento browser?
Lo strumento browser è un'interfaccia visiva in cui incolli il testo, scegli una voce e scarichi manualmente l'audio. L'API espone lo stesso motore attraverso endpoint REST così che il tuo backend possa generare e recuperare l'audio automaticamente in risposta a script, pianificazioni o azioni dell'utente.
L'API può parlare con la mia voce, non solo con voci standard?
Sì. Integrando l'API di clonazione vocale, carichi campioni audio di un parlante, crei una voce AI personalizzata e poi fai riferimento all'ID di quella voce nei tuoi segmenti di sintesi vocale così che tutto il parlato generato venga riprodotto con la voce clonata.
In che modo questo aiuta con canali YouTube o podcast multilingue?
La nostra piattaforma trasforma parlato o script da oltre 60 lingue di origine in output doppiato in 33 lingue di destinazione, con il TTS che genera l'audio finale utilizzando oltre 300 voci o la tua voce clonata. Collegando le API TTS e Doppiaggio AI alla tua pipeline di pubblicazione, i nuovi video o episodi possono ricevere voiceover o doppiaggi completi una volta che gli script o l'audio di origine sono pronti.
Quali formati audio riceverà la mia app o il mio editor?
L'API TTS fornisce file audio di alta qualità, inclusi MP3 a 22 kHz, adatti alla maggior parte degli ambienti web, mobili e di editing video senza conversioni aggiuntive.
Posso integrare la sintesi vocale ora e aggiungere il doppiaggio AI in seguito?
Sì. Sintesi Vocale, Clonazione Vocale e Doppiaggio AI condividono un ecosistema API comune, quindi puoi iniziare con il TTS per i voiceover e successivamente aggiungere la Clonazione Vocale e il Doppiaggio AI per automatizzare il doppiaggio multilingue senza ricostruire la tua integrazione di base.