Chiedere come vengono realizzati i voiceover con l'IA significa in realtà chiedere come uno script scritto diventa parlato senza che nessuno entri in una cabina di registrazione. La risposta breve: un modello neurale di text-to-speech converte il tuo script in audio sintetico, una voce clonata opzionale fa suonare quell'audio come una persona specifica, e un livello di doppiaggio allinea tutto con il tuo video nelle varie lingue. In DubSmart AI, gestiamo l'intera catena all'interno di un unico spazio di lavoro, così puoi passare da un paragrafo di testo a un voiceover multilingue completo senza cambiare strumento o prenotare tempo in studio.
Come si presenta questo processo per te dipende da una decisione, e il resto di questa guida illustra i meccanismi, le opzioni e come scegliere.
Indice dei contenuti
La decisione dietro come vengono realizzati i voiceover con l'IA
Prima che venga generato qualsiasi audio, fai due scelte che modellano tutto ciò che segue. La prima è se vuoi una voce preconfezionata da una libreria o un clone della tua stessa voce. La seconda è se hai bisogno di un voiceover in una sola lingua o di una versione completamente localizzata in molte lingue.
Per un creator di YouTube o una piccola impresa, di solito si risolve rapidamente: scegli una voce stock per la velocità, clona una voce quando conta la coerenza del brand, e ricorri al doppiaggio solo quando diventi multilingue. Per sviluppatori e agenzie, la stessa biforcazione diventa una questione di architettura: chiami un endpoint text-to-speech per audio occasionale, oppure colleghi insieme clonazione della voce e doppiaggio in una pipeline che funziona da sola?
Abbiamo costruito DubSmart esattamente attorno a queste biforcazioni. Text to Speech, Voice Cloning, Speech to Text, Speech Separator, Text to Image, Image to Video e AI Dubbing risiedono tutti in un'unica piattaforma, così puoi aumentare o diminuire il livello di automazione e personalizzazione senza mettere insieme fornitori separati.
I meccanismi: come vengono effettivamente realizzati i voiceover con l'IA
Text to speech: trasformare lo script in suono
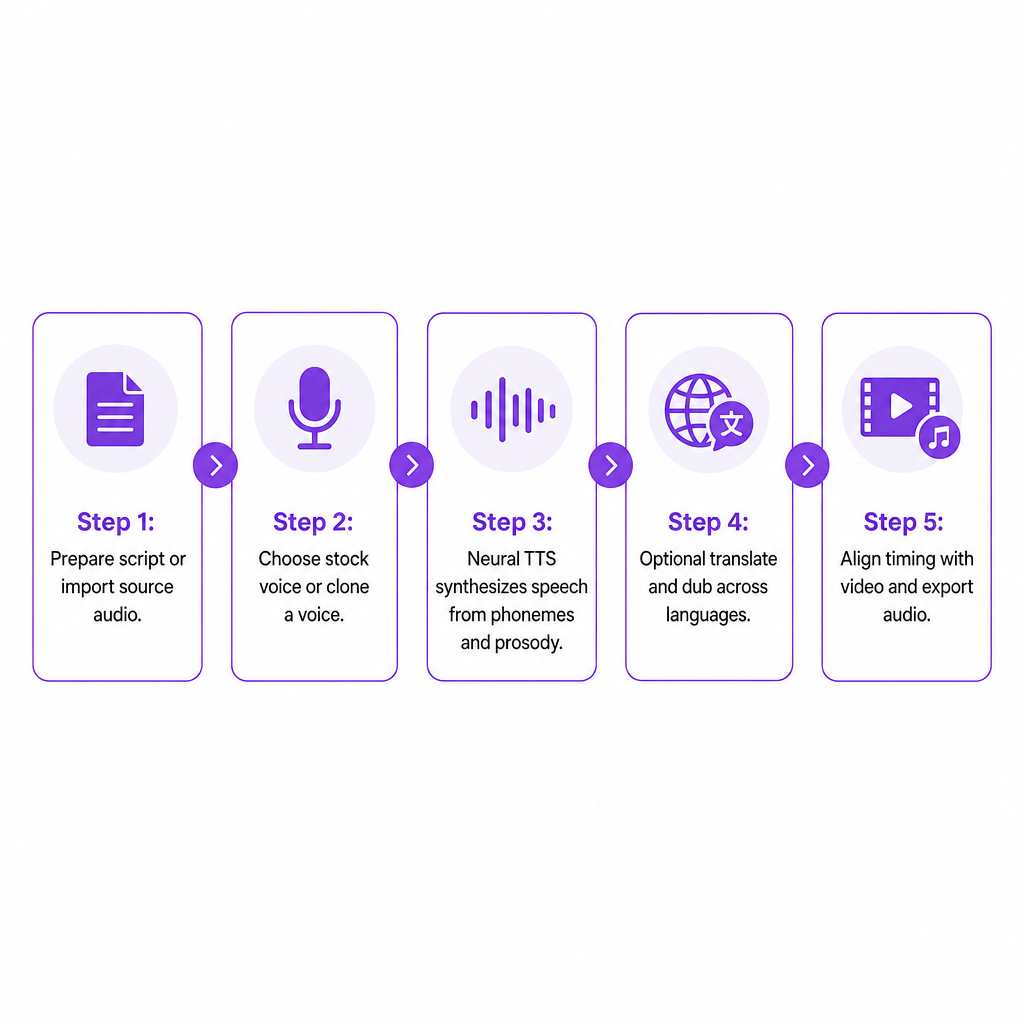
Il text-to-speech (TTS) è al centro di ogni voiceover con l'IA. Il motore analizza prima il tuo script — scomponendo il testo in fonemi, leggendo la punteggiatura e la struttura, e deducendo la prosodia, ovvero il ritmo, l'enfasi e l'intonazione che impediscono al parlato di suonare piatto. I modelli neurali poi sintetizzano quei fonemi in audio e applicano i pattern prosodici che rendono la resa fluente anziché robotica.
Il nostro motore Text to Speech ti permette di incollare testo in qualsiasi lingua, scegliere una voce da una libreria di oltre 300 e generare parlato realistico in pochi secondi. Le voci suonano naturali e simili a quelle umane, e sono categorizzate per lingua, genere e stile così puoi abbinare il tono di ciò che stai producendo. Per gli sviluppatori, lo stesso motore è esposto tramite un'API Text to Speech RESTful: invia una richiesta POST con il tuo testo e i parametri della voce, ricevi in cambio file audio pronti all'uso. Testo strutturato in ingresso, audio realistico in uscita, senza registrazione manuale.
Modelli vocali e librerie di voci
I voiceover con l'IA si basano su modelli vocali addestrati — reti neurali che imparano come dovrebbe suonare una particolare voce attraverso parole, lingue ed emozioni diverse. Una libreria di voci è semplicemente un catalogo di quei modelli. Manteniamo una libreria di oltre 300 voci dal suono naturale che coprono più generi, accenti e stili di parlato in molte lingue, ed è disponibile sia nell'app web che tramite l'API, così gli strumenti interni possono generare parlato su richiesta.
Clonazione vocale: far suonare l'IA come te
La clonazione è il meccanismo che fa suonare un voiceover come una persona specifica anziché come un narratore generico. Il sistema analizza una registrazione campione, apprende il timbro del parlante, la gamma di tonalità e i pattern di pronuncia, poi applica quelle caratteristiche a nuovo parlato sintetico.
In pratica, carichi un file audio di almeno 20 secondi su Voice Cloning — idealmente pulito e privo di rumore di fondo. Elaboriamo quel campione in un profilo vocale personalizzato che puoi nominare e riutilizzare, con la clonazione che richiede tipicamente solo pochi secondi. Una volta creata, la voce clonata diventa disponibile all'interno di Text to Speech e AI Dubbing, così puoi generare script o versioni doppiate con la tua stessa voce. A livello programmatico, l'API Voice Cloning rispecchia questo: ottieni un URL di caricamento, invia il tuo audio in un formato supportato, crea una voce personalizzata dalla chiave del file risultante, poi usala in progetti TTS o di doppiaggio.
Doppiaggio e voiceover multilingue
Passare da un voiceover in una sola lingua a contenuti multilingue aggiunge la localizzazione al di sopra del TTS di base. Lo schema generale è coerente:
- Cattura o importa il parlato originale.
- Trascrivilo in testo.
- Traduci quel testo.
- Genera nuovo parlato nella lingua di destinazione.
- Allinea la tempistica con il video o l'audio originale.
Il nostro workflow AI Dubbing segue esattamente questo schema, combinando speech-to-text, traduzione automatica e text-to-speech, riutilizzando opzionalmente una voce clonata così che la traccia doppiata corrisponda al parlante originale. Trasforma contenuti parlati da più di 60 lingue di origine in versioni doppiate in 33 lingue di destinazione. Il doppiaggio speech-to-speech mira a mantenere tono e tempistica vicini alla performance originale, il che conta di più per e-learning, formazione e contenuti cinematografici dove il lip-sync e il ritmo sostengono l'esperienza.
API e workflow automatizzati
Per i team che producono voiceover su larga scala, le API sono ciò che integra la creazione vocale nei sistemi esistenti. L'API TTS gestisce testo in ingresso, audio in uscita; l'API Voice Cloning aggiunge la creazione e gestione programmatica di voci personalizzate; e l'API AI Dubbing estende entrambe alla traduzione e al doppiaggio automatici in oltre 33 lingue con accesso alle voci clonate. Insieme ti permettono di costruire pipeline in cui script, sottotitoli o trascrizioni estratti da un sistema di contenuti diventano automaticamente voiceover o tracce doppiate, senza gestione manuale dei file.
I tuoi tre modi per creare voiceover con l'IA in DubSmart
All'interno della nostra piattaforma, la domanda si risolve in tre punti di partenza pratici.
Parti da uno script con Text to Speech. Incolla il tuo testo, scegli una voce stock o clonata, imposta la lingua e i controlli di base, e genera parlato che puoi scaricare in formati standard. Questo si adatta a video di formazione, contenuti esplicativi, spot di marketing e intro di podcast dove possiedi lo script fin dall'inizio.
Parti da media esistenti con AI Dubbing. Carica un video o un file audio di origine, lascia che il sistema trascriva e traduca, poi genera tracce doppiate nelle lingue che hai scelto — riutilizzando voci clonate per mantenere il suono coerente. Questa è la strada per canali che si espandono verso pubblici multilingue e per aziende che riutilizzano webinar o demo di prodotto.
Parti dai tuoi sistemi con la generazione basata su API. La tua app invia testo e parametri vocali all'API TTS, opzionalmente collega i contenuti a una voce specifica tramite l'API Voice Cloning, e recupera audio pronto da allegare a video o voiceover di e-learning per moduli di formazione. Questo è adatto a sviluppatori, agenzie e fornitori di LMS che hanno bisogno di output programmatico e coerente.
Criteri decisionali: scegliere la tua configurazione di voiceover con l'IA
Naturalezza e qualità audio
La naturalezza non è negoziabile. I motori robusti modellano la prosodia e l'articolazione così il parlato scorre con pause ed enfasi appropriate. Poiché la generazione è veloce, puoi iterare su uno script e rigenerare l'audio finché la resa non ti sembra giusta, invece di accontentarti della prima ripresa.
Copertura linguistica e profondità di localizzazione
Se canali multilingue o formazione internazionale sono nella tua roadmap, la copertura decide fino a dove puoi arrivare. Trasformare contenuti da oltre 60 lingue di origine in 33 lingue di destinazione da un unico workflow definisce i mercati che puoi servire, e il doppiaggio speech-to-speech aiuta a mantenere tono e tempistica coerenti in ogni versione.
Branding vocale e capacità di clonazione
Una voce riconoscibile conta per aziende, creator e podcast. La clonazione ti permette di portare la stessa voce attraverso lingue e canali. Poter clonare da circa 20 secondi di audio pulito e riutilizzare quel profilo all'interno di Text to Speech e AI Dubbing rende pratico stabilire e mantenere un suono distintivo.
Semplicità del workflow versus integrazione tecnica
I creator spesso vogliono caricamento, editing e download gestiti in un unico posto. I team tecnici spesso hanno bisogno di API. Offriamo entrambi: strumenti rivolti agli utenti in un'app unificata e API per sviluppatori che espongono gli stessi motori. La scelta si riduce a se il tuo team lavora principalmente in un browser o costruisce su sistemi interni.
Velocità, scalabilità e coerenza
Uno strumento di voiceover dovrebbe accorciare la produzione e scalare senza che la qualità cali. La generazione TTS quasi istantanea e la clonazione che si completa in secondi consentono un'iterazione rapida e output di massa, mentre le API permettono l'elaborazione automatica di migliaia di script o segmenti con voci e impostazioni coerenti.
Struttura di budget e controllo
Invece di tariffe per sessione di studio, gli strumenti di voiceover con l'IA generalmente utilizzano prezzi basati sull'utilizzo. Il nostro modello basato su crediti ti dà accesso ad AI Dubbing, Text to Speech, Voice Cloning, Speech to Text, Speech Separator, Text to Image e Image to Video sotto un unico account, con un piano gratuito e piani enterprise. I crediti forniscono limiti di utilizzo prevedibili mentre il riporto e la scalabilità rimangono disponibili quando il volume aumenta. Se vuoi dimensionare i crediti rispetto al runtime, la nostra analisi del costo del doppiaggio IA al minuto illustra i calcoli.
Conformità, consenso e gestione dei dati
La clonazione e il parlato sintetico comportano un peso etico e legale. Richiediamo che tu carichi audio di cui hai i diritti e raccomandiamo registrazioni pulite per ottenere i migliori risultati, il che mantiene il consenso e il controllo al centro. La nostra documentazione API utilizza URL di caricamento presignati e sicuri e formati audio standard, offrendo agli sviluppatori uno schema chiaro per un uso conforme all'interno delle applicazioni.
Rischi da pianificare
Anche con strumenti capaci, vale la pena anticipare alcune modalità di fallimento.
L'audio innaturale o robotico di solito è riconducibile a script mal punteggiati o a una voce non adatta al contenuto. Scegliere da una libreria di voci naturali e rigenerare finché la resa non si adatta è la soluzione pratica, e la generazione veloce rende quella sperimentazione economica.
Gli errori di pronuncia tendono a emergere con nomi, termini tecnici e contenuti localizzati. Una pipeline che esegue trascrizione, traduzione e revisione — anziché una conversione cieca da audio ad audio — intercetta più di questi errori prima che vadano in produzione.
Le discrepanze temporali tra il parlato sintetizzato e le immagini sullo schermo danneggiano l'esperienza dello spettatore. Il doppiaggio speech-to-speech che rimane vicino al tono e alla tempistica originali, abbinato all'editing all'interno dell'ambiente del progetto, ti dà un migliore controllo sull'allineamento.
Eticamente, clonare una voce senza i diritti appropriati invita a problemi seri. Richiedere un campione pulito sotto il tuo controllo, e inquadrare la clonazione come uno strumento per creator e aziende anziché come impersonificazione anonima, è ciò che mantiene la pratica responsabile. Quando stai localizzando filmati esistenti, la nostra guida su come cambiare la lingua della voce in un video mostra il percorso favorevole alla revisione.
Come diversi creator mettono questo in pratica
Un creator di YouTube che si espande all'estero può trasformare un video in inglese in versioni spagnole, portoghesi e tedesche con AI Dubbing e una voce clonata, così l'host rimane riconoscibile in ogni mercato — tutto all'interno della pipeline di oltre 60 lingue di origine e 33 di destinazione.
Una piccola impresa o un team di marketing può redigere uno script esplicativo di prodotto o pubblicitario in un documento, convertirlo in audio con Text to Speech, e scegliere una voce che si abbina al tono del brand — energica, formale o colloquiale. Quegli stessi script possono essere localizzati in seguito tramite AI Dubbing usando una voce di brand clonata.
Un produttore di e-learning o formazione aziendale può automatizzare la narrazione per presentazioni di slide e pacchetti SCORM inviando il testo delle lezioni tramite l'API TTS e allegando l'audio restituito a ciascun modulo, con la clonazione che mantiene coerente la voce dell'istruttore anche tra versioni regionali.
Un filmmaker indipendente o un creator di podcast può produrre trailer, promo o dialoghi tradotti senza prenotare uno studio in ogni lingua, combinando Speech to Text, AI Dubbing e voci clonate per mantenere stabile l'identità dei personaggi.
Sviluppatori e agenzie possono integrare le API TTS, Voice Cloning e AI Dubbing in strumenti interni o piattaforme client, automatizzando tutto, dai voiceover per i social in formato breve agli agenti vocali interattivi.
Domande frequenti
In cosa si differenziano i voiceover con l'IA dai tradizionali voiceover registrati?
I voiceover tradizionali necessitano di un doppiatore umano, tempo in studio e più sessioni. I voiceover con l'IA sono generati da motori di text-to-speech e clonazione vocale che trasformano gli script direttamente in audio utilizzando modelli neurali addestrati anziché una performance dal vivo.
Un voiceover con l'IA può suonare come una persona specifica?
Sì. La clonazione vocale analizza un breve campione della voce di qualcuno e costruisce un modello personalizzato in grado di pronunciare qualsiasi script con quella voce, disponibile nel nostro strumento e API Voice Cloning.
Quanto audio serve per clonare una voce?
Chiediamo almeno 20 secondi di audio pulito, privo di rumore di fondo, per creare un profilo vocale clonato affidabile, con la clonazione che tipicamente si completa in secondi.
Posso creare voiceover in più lingue da un unico video di origine?
Sì. Combiniamo speech-to-text, traduzione e text-to-speech per trasformare contenuti da oltre 60 lingue di origine in output doppiato in 33 lingue di destinazione, così un unico video originale può produrre molti voiceover localizzati.
C'è un modo per automatizzare la creazione di voiceover invece di usare l'interfaccia?
Le nostre API TTS e Voice Cloning permettono ad app e strumenti interni di inviare testo e campioni audio, creare voci personalizzate e ricevere parlato sintetico a livello programmatico, così i voiceover possono essere generati automaticamente su larga scala.