La separazione vocale AI è un processo di deep-learning che estrae una voce umana da un mix rumoroso e restituisce una traccia vocale pulita, pronta per la trascrizione, il doppiaggio o la clonazione vocale. Questa singola capacità risponde alla domanda che la maggior parte dei creator si pone davvero: posso recuperare questa registrazione senza rigirarla? Capire come funziona la separazione vocale AI ti aiuta a decidere quando affidarti ad essa, quando registrare in modo più pulito fin dall'inizio, e come una traccia vocale pulita migliori silenziosamente tutto ciò che viene dopo. Questa guida illustra il meccanismo, la differenza tra migliorare un singolo speaker e separarne molti, dove si inserisce il processo in una pipeline di localizzazione, e cosa ancora non può risolvere.
Indice dei contenuti
La decisione dietro la separazione vocale
Qualsiasi registrazione reale cattura molto più del solo speaker. Vlog, webinar, video di formazione e podcast raccolgono rumore stradale, ambiente della stanza, basi musicali, clic della tastiera e chiacchiericcio sovrapposto che possono seppellire le parole che contano. Un separatore vocale esiste per districare quel mix: prende un file mixato e restituisce una traccia che contiene principalmente voce umana, più una traccia opzionale che contiene l'audio di sottofondo rimanente.
Quella traccia vocale pulita diventa la base per qualsiasi cosa venga dopo: trascrizione speech-to-text accurata, doppiaggio multilingue, clonazione vocale ad alta fedeltà, o semplicemente un originale dal suono migliore. Quindi la vera decisione non è tecnica, è pratica. Ti fidi abbastanza del tuo audio attuale da costruirci sopra contenuti multilingue, oppure vuoi che l'AI pulisca e separi prima la voce? E vuoi un'utility di pulizia autonoma, o un separatore integrato in una piattaforma più ampia di creazione e localizzazione così da non dover destreggiarti tra diverse app?
Abbiamo progettato il nostro Speech Separator per agire come primo gate AI in un flusso di lavoro unificato. Si colloca prima dello speech-to-text, del text-to-speech, della clonazione vocale e del doppiaggio, così ogni sistema a valle vede il segnale vocale più chiaro possibile invece di ereditare qualunque rumore ci fosse nella stanza.
Il meccanismo: dalla forma d'onda alla voce pulita
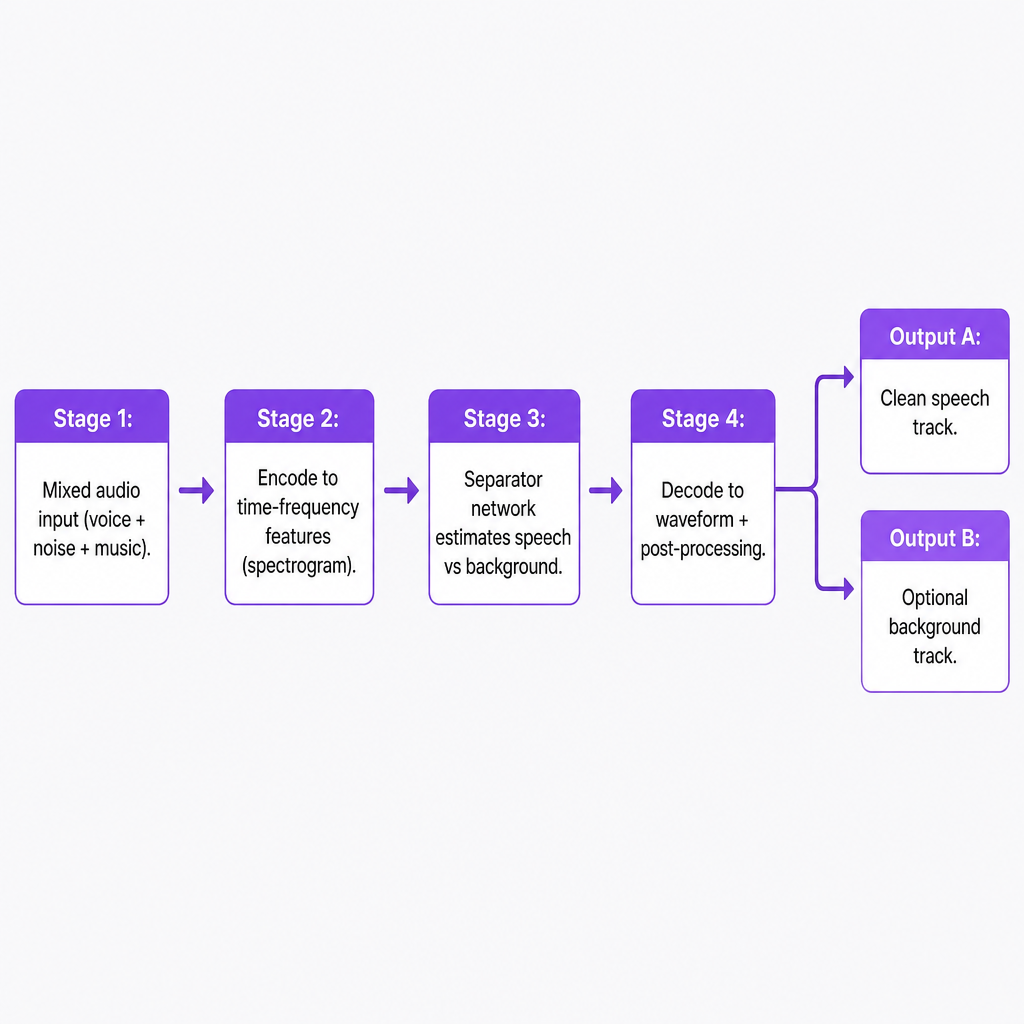
La moderna separazione vocale AI segue una pipeline in quattro fasi: codificare il segnale, separare le sorgenti in uno spazio di feature appreso, stimare la voce pulita e decodificarla nuovamente in audio.
Dalla forma d'onda alle feature
La maggior parte dei sistemi converte prima la forma d'onda grezza del microfono in una rappresentazione tempo-frequenza come uno spettrogramma, che mostra come l'energia in diverse bande di frequenza cambia nel tempo. Quella vista rende più facile per una rete neurale distinguere i pattern che corrispondono alla voce umana rispetto al rumore o alla musica. Una rete encoder mappa quindi l'input in uno spazio di feature ad alta dimensione dove le diverse sorgenti sonore diventano più distinguibili, enfatizzando caratteristiche vocali come formanti, armoniche e struttura temporale mentre sopprime i contenuti di sottofondo irrilevanti.
Reti di separazione e maschere
Il cuore del processo è la rete di separazione, un modello profondo addestrato a giudicare cosa appartiene alla voce e cosa no in ciascun punto tempo-frequenza. Dominano due strategie. La separazione basata su maschere prevede una maschera per lo spettrogramma che mantiene l'energia vocale e attenua tutto il resto; quando applicata allo spettrogramma originale, il rumore di sottofondo e la musica calano bruscamente mentre la voce rimane. La stima diretta della sorgente prevede invece lo spettrogramma vocale pulito stesso, e talvolta un sottofondo residuo, che viene poi decodificato nuovamente in audio.
Esistono approcci più specializzati per i casi più difficili. Il deep clustering apprende un embedding per ogni bin tempo-frequenza in modo che i bin della stessa sorgente si raggruppino insieme, dopodiché un clustering standard separa la voce dalle altre sorgenti. Altri modelli usano l'addestramento invariante alle permutazioni così da poter separare diversi speaker senza assumere quale speaker sia l'output uno rispetto all'output due.
Addestramento con esempi supervisionati
Questi modelli imparano da mix di esempio abbinati a voce pulita di riferimento (ground-truth), adattandosi per minimizzare il divario tra il loro output e il riferimento. Gli obiettivi di addestramento possono essere maschere, spettrogrammi puliti o forme d'onda ricostruite, e le funzioni di perdita sono spesso legate a misure di qualità percettiva come il rapporto segnale-distorsione. Alimentata con molti campioni diversi tra accenti, microfoni e ambienti, la rete interiorizza indizi robusti che separano la voce umana dal contenuto di sottofondo e generalizza a registrazioni che non ha mai visto.
Decodifica nuovamente in audio
Infine il sistema mappa la rappresentazione della voce separata nuovamente in una forma d'onda nel dominio del tempo attraverso una trasformata inversa, seguita da post-elaborazione come denoising e normalizzazione del volume. Il risultato è una traccia dominata dalla voce che può stare da sola o essere ricombinata con una quantità controllata di sottofondo per naturalezza. Il nostro Speech Separator segue esattamente questo schema: acquisisce l'audio o il video caricato, esegue la pipeline di separazione e restituisce una traccia focalizzata sulla voce più un sottofondo opzionale, così sei tu a decidere quanto secco o ambientale debba essere il mix finale.
Miglioramento di un singolo speaker vs separazione di più speaker
C'è una linea importante tra migliorare un singolo speaker dominante e separare davvero diverse voci sovrapposte, e questo determina cosa puoi realisticamente aspettarti.
Il miglioramento di un singolo speaker isola una voce principale da rumore di sottofondo, riverbero e suoni non vocali così che l'intelligibilità aumenti. Questo funziona particolarmente bene per vlog, webinar, lezioni e contenuti talking-head, dove il problema è il rumore ambientale o una base musicale piuttosto che la sovrapposizione di voci. Il nostro Speech Separator è ottimizzato per questo caso: tratta la voce umana come sorgente primaria e tutto il resto come sottofondo, fornendo una traccia vocale pulita e una traccia di sottofondo opzionale.
La separazione multi-speaker è un compito diverso: dividere un mix di più persone che parlano contemporaneamente in flussi individuali, uno per voce. I modelli di ricerca hanno separato fino a cinque voci da un singolo microfono addestrando reti diverse per diversi numeri di speaker e scegliendo la migliore per ogni campione. Tecniche come il deep clustering e il beamforming neurale multi-microfono spingono le prestazioni oltre in contesti far-field e multi-canale, ma sono più complesse e computazionalmente pesanti. In pratica questi sistemi puntano ancora a scenari specializzati come la trascrizione di riunioni, i call center e i dispositivi smart piuttosto che i flussi di lavoro quotidiani dei creator. Per la maggior parte dei nostri utenti, che gestiscono canali YouTube, team di marketing o librerie di corsi, il maggior vantaggio pratico deriva da un forte miglioramento del singolo speaker e dalla separazione voce-vs-sottofondo, non dalla separazione completa multi-voce.
Dove si colloca la separazione in un flusso di lavoro di localizzazione
La separazione è il ponte tra registrazioni rumorose del mondo reale e lavoro vocale AI di alta qualità. Un percorso tipico attraversa in modo pulito diversi strumenti.
Un creator carica un file audio o video, e il separatore isola la traccia vocale e opzionalmente il sottofondo. Quella voce pulita alimenta lo speech-to-text, così la trascrizione e la traduzione operano su un segnale chiaro, il che migliora l'accuratezza e riduce le parole allucinate causate da musica o rumore pesanti. Il testo risultante e le traduzioni passano poi al text-to-speech e all'AI dubbing, che generano nuove versioni linguistiche usando voci clonate o sintetiche; poiché la voce sorgente era pulita, l'allineamento temporale è più preciso e gli artefatti di mixaggio come il pumping sono ridotti.
La clonazione vocale dipende dallo stesso input pulito. I modelli hanno bisogno di esempi relativamente privi di rumore per apprendere in modo affidabile il timbro, la prosodia e l'articolazione di uno speaker, e la separazione riduce la contaminazione di sottofondo che può distorcere una voce clonata. La nostra guida in lingua spagnola alla separazione cattura bene l'esperienza quotidiana: carica un file, lascia che l'AI separi la voce dal sottofondo, poi scarica la traccia vocale pulita o il sottofondo isolato per ulteriore editing, doppiaggio o narrazione, tutto all'interno di un unico flusso di lavoro. Quel consolidamento è il punto per i piccoli team, che altrimenti rimbalzano tra plugin separati di riduzione del rumore, strumenti di trascrizione, servizi di doppiaggio e piattaforme di clonazione.
Scegliere e usare la separazione vocale AI
Quando decidi come adottare la separazione, una manciata di criteri pratici fa la maggior parte del lavoro.
Condizioni audio e tipo di contenuto. Con un singolo speaker principale e rumore di sottofondo o musica moderati, la separazione è altamente efficace e a basso rischio. Con forte sovrapposizione, microfoni far-field o input di qualità molto bassa, aspettati rendimenti decrescenti e affianca l'AI a una registrazione migliore invece di affidarti ad essa per salvare tutto.
Integrazione con gli strumenti a valle. Un separatore che confluisce direttamente in trascrizione, text-to-speech e doppiaggio riduce l'attrito e gli artefatti cumulativi rispetto all'esportazione e reimportazione tra app. Colleghiamo lo Speech Separator al resto dei nostri strumenti di localizzazione esattamente per questo motivo, il che conta di più quando il tuo obiettivo è la pubblicazione multilingue piuttosto che una riduzione del rumore una tantum.
Controllo sull'audio di sottofondo. Per lo storytelling del brand spesso vuoi mantenere un po' di ambiente o musica per l'impatto emotivo. I sistemi che producono sia una traccia vocale pulita sia un sottofondo isolato danno agli editor più margine rispetto agli strumenti che producono solo un unico mix denoised. Il nostro separatore supporta questo paradigma voce-più-sottofondo-opzionale così puoi remixare in modo deliberato.
Velocità, semplicità e scala. Per i creator e i piccoli team, l'usabilità rivaleggia con le prestazioni pure. La separazione con un clic tramite browser o API, con gestione automatica dei formati comuni, batte le complesse catene di plugin che presuppongono competenze di ingegneria audio. Una volta che gestisci centinaia di video o moduli di corso, l'elaborazione batch e l'automazione smettono di essere lussi.
Affidabilità e artefatti. Un modello forte migliora l'intelligibilità senza aggiungere distorsioni evidenti, ronzii metallici o artefatti di respirazione. Le demo possono lusingare un sistema, quindi testa con le tue registrazioni rappresentative prima di rendere un qualsiasi separatore parte fissa della tua pipeline.
Privacy e conformità. La separazione opera direttamente su dati vocali che possono includere informazioni sensibili. I team aziendali dovrebbero verificare come viene memorizzato l'audio, se viene usato per l'addestramento dei modelli, e quali controlli esistono per conservazione e accesso, specialmente per settori regolamentati e contenuti di formazione interna.
Pesare questi criteri rispetto ai tuoi casi d'uso reali, che si tratti di espansione di canale, formazione, marketing, lavoro narrativo o un prodotto API, ti dice se un separatore integrato con strumenti vocali a valle si adatta al modo in cui operi.
Rischi, limiti e cosa non può risolvere
Anche i modelli forti hanno bordi netti che vale la pena conoscere prima di impegnarti.
- Rumore estremo o rapporto segnale-rumore molto basso. Quando la voce è sepolta sotto rumore o musica forti, il modello potrebbe non riuscire a recuperare ogni parola, producendo dropout o output ovattato.
- Forte sovrapposizione di speaker. Le persone che parlano esattamente nello stesso momento mettono in difficoltà anche i sistemi multi-speaker avanzati e possono causare la fuoriuscita della voce tra i flussi separati.
- Artefatti di sovra-separazione. Il mascheramento aggressivo può introdurre rumore musicale o un timbro robotico, più evidente sui suoni sostenuti e sulle sibilanti.
- Discrepanza addestramento-realtà. I modelli calibrati su determinati microfoni, lingue o ambienti possono avere prestazioni inferiori su registrazioni molto diverse, il che poi abbassa l'accuratezza di trascrizione e doppiaggio.
- Etica e diritti. La voce separata in modo pulito è più facile da trascrivere, analizzare e remixare, quindi i team devono rispettare il consenso e i diritti quando riutilizzano voci in nuove lingue o contesti.
La conclusione onesta è che la separazione è un potenziamento potente, non un sostituto di ragionevoli abitudini di registrazione. Buoni microfoni, livelli sensati e scelte oculate della location ripagano ancora, e l'AI poi moltiplica quelle scelte rendendo il contenuto molto più flessibile per la localizzazione e il riutilizzo. Se stai esplorando come inserire questo in un setup di pubblicazione più ampio, la nostra spiegazione su cos'è un separatore vocale copre i fondamentali più in profondità.
Domande frequenti
Cos'è la separazione vocale AI in termini semplici?
È un processo AI che prende una registrazione mixata e isola la voce umana, dandoti una traccia vocale pulita e, opzionalmente, una traccia di sottofondo separata che puoi mantenere o scartare.
In che modo il nostro Speech Separator è diverso dalla riduzione del rumore di base?
La riduzione del rumore tradizionale attenua principalmente il rumore stazionario. Il nostro separatore usa il deep learning per riconoscere i pattern vocali ed estrarli da un'ampia gamma di suoni di sottofondo e musica, il che di solito produce un dialogo più pulito e naturale.
Può gestire più speaker?
Il nostro Speech Separator è ottimizzato per isolare la voce umana dai sottofondi non vocali, il che funziona meglio con uno speaker principale nel mix. La separazione di diverse voci sovrapposte è un'area di ricerca attiva, ed esistono modelli specializzati, ma tipicamente puntano a riunioni o call center piuttosto che ai flussi di lavoro generali dei creator.
Perché la separazione vocale conta per il doppiaggio multilingue?
La localizzazione si basa su trascrizione e timing accurati. Una traccia vocale pulita riduce gli errori di riconoscimento e aiuta i voiceover tradotti ad allinearsi con il video originale, riducendo gli artefatti udibili quando le nuove voci vengono mixate con musica ed effetti mantenuti.
Quanta conoscenza tecnica mi serve per usarlo?
Pochissima. Carichi un file audio o video, lasci che l'AI lo elabori, e scarichi le tracce vocali e di sottofondo separate per editing, doppiaggio o automazione, senza alcuna necessità di regolazione manuale dei parametri.