Scegliere le migliori voci text to speech per YouTube significa meno rincorrere una voce "perfetta" e più abbinare la giusta configurazione vocale alla nicchia del tuo canale, ai tuoi piani linguistici e al modo in cui produci effettivamente i video. Su DubSmart AI, questa scelta si riduce a quattro opzioni pratiche all'interno di un unico spazio di lavoro: la nostra libreria di oltre 300 voci AI pronte all'uso, una voce che cloni dal tuo stesso audio, le stesse voci applicate al doppiaggio multilingue e voci basate su API per pipeline automatizzate. Ognuna risolve un problema diverso, e la scelta migliore solitamente ne combina un paio man mano che il tuo canale cresce.
Questa guida illustra ciò che ogni configurazione vocale fa bene, dove si adatta e dove presenta dei limiti, così da poter decidere con sicurezza invece di tirare a indovinare da una classifica generica.
Indice dei contenuti
Come scegliamo le migliori voci text to speech per YouTube
Selezioniamo voci e configurazioni vocali che reggono su un vero canale YouTube, non in base ad astratte classifiche di mercato. Cinque criteri guidano ogni scelta qui sotto.
La naturalezza conta prima di tutto, perché la maggior parte del tempo di visualizzazione avviene su telefoni a volume variabile. Una voce deve suonare umana e rimanere chiara attraverso audio compresso e rumore di fondo durante uno spostamento. Segue la copertura linguistica e di accenti: una voce è utile per la crescita solo se puoi portarla in nuove regioni senza ri-registrare il tuo catalogo precedente. La coerenza del brand è il terzo filtro, poiché la stessa voce dovrebbe essere riutilizzabile sia nel nostro studio Text to Speech sia nel doppiaggio, inclusa una voce clonata che suoni come la tua. L'adattamento al flusso di lavoro decide se una voce è pratica da generare, modificare ed esportare all'interno di un vero programma di produzione. Infine, il potenziale di automazione determina se sviluppatori e agenzie possono richiamare le stesse voci tramite API per output basati su template o su larga scala.
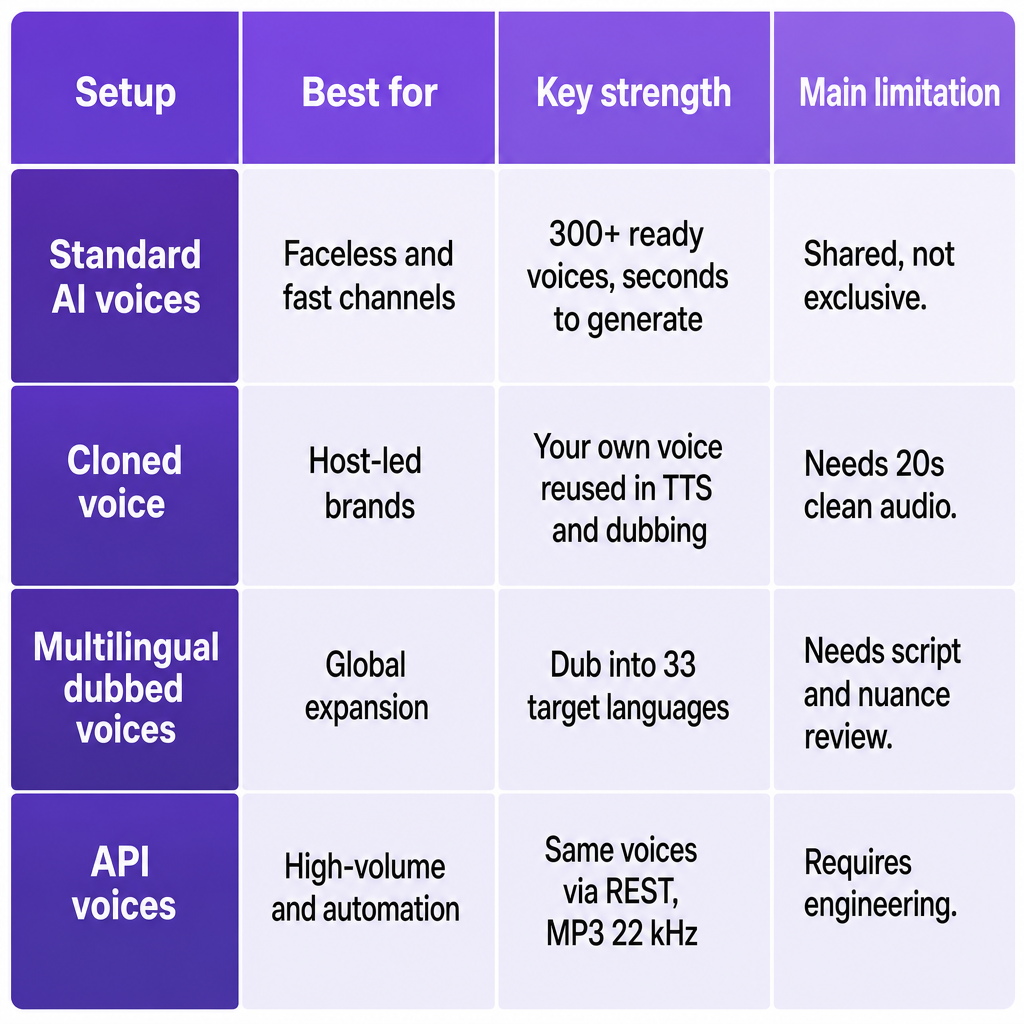
Ogni voce qui sotto ha una sezione con la sua distinzione, il suo migliore adattamento su YouTube e i suoi limiti onesti, tratti dal modo in cui questi strumenti funzionano realmente all'interno della nostra piattaforma.
Libreria di voci AI standard: narrazione veloce e pronta alla pubblicazione
Il percorso più rapido verso una voce fuori campo finita è il nostro motore Text to Speech: incolla uno script nella tua lingua, scegli tra più di 300 voci AI, visualizza l'anteprima e genera un parlato realistico in pochi secondi. Puoi selezionare uno speaker, regolare le impostazioni di base ed esportare audio standard da inserire direttamente in un montaggio YouTube. Lo stesso catalogo è esposto tramite la nostra TTS API, così ogni voce pronta all'uso esiste sia nello studio web sia nei flussi di lavoro programmatici.
Questa configurazione si adatta ai canali senza volto e di commento che valorizzano velocità e coerenza rispetto a una singola personalità riconoscibile. È adatta ad analisi di notizie, listicle, tutorial e presentazioni che necessitano di una narrazione pulita con tempi stretti, oltre a canali di e-learning, aziendali e di marketing che preferiscono un tono professionale neutro. Un creator può incollare uno script, scegliere una voce, generare e scaricare per un editor come Premiere o Final Cut senza toccare attrezzatura di registrazione. Per i team tecnici, la nostra Text to Speech API restituisce file MP3 a 22 kHz dopo una semplice richiesta con testo e preferenze vocali, che si inserisce perfettamente in pipeline video basate su template o dati. Se vuoi approfondire i meccanismi, il nostro articolo su come funziona il text to speech neurale spiega cosa accade dietro ogni render.
Il compromesso è l'esclusività. Le voci standard sono condivise tra gli utenti, quindi un canale fortemente brandizzato e guidato dalla personalità potrebbe alla fine volere qualcosa di più distintivo. Puoi regolare lingua, speaker e alcuni parametri, ma non otterrai le sottili particolarità della tua stessa voce senza clonazione. E poiché il catalogo è ampio, trovare la voce che corrisponde davvero al tuo pubblico richiede comunque qualche test di ascolto piuttosto che una scelta fortunata.
Voce clonata del creator: un conduttore riconoscibile su larga scala
Quando il tuo suono fa parte del tuo brand, la clonazione cambia le carte in tavola. La nostra clonazione vocale costruisce una voce AI personalizzata da un breve campione, poi rende quella voce selezionabile ovunque appaiano le voci standard, sia in Text to Speech sia nel doppiaggio. Carichi almeno 20 secondi di audio pulito senza rumore di fondo e il sistema produce un clone riutilizzabile. Supportiamo la clonazione di qualsiasi numero di voci, così un brand non è vincolato a un solo conduttore: puoi clonare diversi portavoce o voci di personaggi secondo necessità.
Una voce clonata è la scelta più forte per i canali guidati dalla personalità in cui gli spettatori si iscrivono per una persona specifica. Si adatta anche ai creator che vogliono mantenere la propria voce automatizzando parti della produzione, come la narrazione di B-roll, tracce in lingue alternative o short scriptati. Ed è la spina dorsale dei canali multilingue che desiderano un'identità vocale coerente attraverso le lingue quando abbinata al doppiaggio. Una volta clonata, la tua voce diventa un'opzione normale nello studio, pronta per la narrazione scriptata o per ri-doppiare interi video in altre lingue preservando la tua identità.
La qualità dipende dal tuo audio sorgente. Un campione rumoroso o con eco produce un clone più debole e può introdurre artefatti, quindi molti creator registrano un campione pulito dedicato invece di riutilizzare audio da livestream o vlog. Tra le lingue, accento e prosodia seguono il modello di sintesi, quindi la pronuncia potrebbe non corrispondere perfettamente a un madrelingua in ogni lingua di destinazione. La clonazione aggiunge anche un passaggio di configurazione prima del primo utilizzo, il che la rende ideale per canali impegnati in una coerenza a lungo termine piuttosto che in un test occasionale.
Voci doppiate multilingue: trasformare un canale in molti
Il percorso più diretto verso un canale globale è il doppiaggio. Con il nostro AI Dubbing, carichi un video, lo traduci e lo ri-doppi in una qualsiasi delle 33 lingue di destinazione e, facoltativamente, applichi una voce clonata a quelle tracce doppiate. Il dettaglio chiave è che il doppiaggio attinge dallo stesso catalogo di voci e voci clonate usate per il Text to Speech, quindi le tue "migliori" voci per il doppiaggio sono semplicemente le voci che hai scelto configurate per script tradotti. Poiché lo spazio di lavoro integra anche Speech to Text, un Speech Separator e strumenti per immagini e video, eviti di mettere insieme fornitori separati per trascrizione, traduzione, voce fuori campo e grafica.
Questo si adatta ai canali che già hanno successo in una lingua e sono pronti a espandersi senza ri-girare. Tutorial, recensioni di prodotti, documentari e contenuti di lunga durata con alto valore di riproduzione giustificano lo sforzo, così come aziende, fornitori di e-learning e team di marketing che necessitano di una narrazione brandizzata coerente tra le regioni. Puoi partire da video esistenti, generare script tradotti e applicare una voce standard o la tua voce clonata all'audio doppiato, creando versioni locali del tuo canale che mantengono la stessa personalità. Mantenere Text to Speech e doppiaggio in un unico spazio di lavoro rende facile allineare lo stile di narrazione tra versioni originali e tradotte. Se stai valutando i formati di localizzazione, la nostra analisi di doppiaggio contro sottotitoli aiuta a inquadrare la decisione.
Il doppiaggio aggiunge lavoro che la narrazione in una sola lingua non richiede. Anche con traduzione e sintesi efficaci, devi comunque rivedere gli script per le sfumature culturali, adattare gli esempi e confermare che lo stile vocale sia adatto al pubblico di destinazione. Consuma anche più crediti e gestione delle esportazioni rispetto a una clip occasionale. Le voci clonate preservano l'identità, ma la sincronizzazione labiale e il timing potrebbero non corrispondere perfettamente alla grafica originale su contenuti con parlato veloce o fortemente animati, quindi aspettati alcune modifiche manuali nel tuo editor video.
Voci basate su API: produzione automatizzata ad alto volume
Per i team che producono su larga scala, le stesse voci sono disponibili in modo programmatico tramite tre endpoint. La nostra Text to Speech API converte il testo in parlato naturale usando l'intero set di oltre 300 voci e restituisce file MP3 scaricabili a 22 kHz al completamento dell'elaborazione. La nostra Voice Cloning API ti permette di caricare campioni e creare voci personalizzate utilizzabili in TTS o nel doppiaggio. La nostra AI Dubbing API consente a sviluppatori e agenzie di tradurre e doppiare video in modo programmatico, integrando queste capacità direttamente nelle pipeline di contenuti o in un CMS.
Questa configurazione si adatta ai canali che generano molti video simili, come digest di notizie ricorrenti, riassunti basati su dati o tutorial basati su template in cui gli script sono generati o compilati da dati strutturati. È adatta ad agenzie che gestiscono più canali clienti che necessitano di un flusso di lavoro vocale ripetibile e automatizzato, e a prodotti software che offrono funzionalità di pubblicazione automatica che richiedono voci fuori campo di qualità su larga scala. Poiché le voci clonate possono essere referenziate per ID insieme alle voci standard, l'automazione non ti costa la coerenza del brand: ogni render usa la stessa voce prevista tra video e canali.
Il costo è l'ingegneria. I flussi di lavoro API richiedono familiarità con i servizi RESTful oltre a un'infrastruttura per archiviare l'audio, post-elaborarlo e associarlo agli asset video. I creator più piccoli che lavorano interamente nell'editor web di solito non ne beneficeranno finché non raggiungono una scala significativa. Le pipeline automatizzate necessitano anche di salvaguardie riguardo qualità degli script, timing e conformità, perché input deboli producono comunque output deboli indipendentemente da quanto sia buona la voce.
Come scegliere la giusta configurazione vocale per il tuo canale
Quattro domande risolvono la maggior parte delle decisioni. Rispondi in ordine e il tuo stack vocale andrà al suo posto.
Pubblico e formato. Se il tuo canale è senza volto, incentrato sulle notizie o basato su listicle, inizia con voci AI standard per tempi rapidi e facili test di tono. Se gli spettatori si iscrivono per te in particolare, investi nel clonare la tua voce e usarla sia in Text to Speech sia nel doppiaggio.
Strategia linguistica. Se pubblichi in una sola lingua, trova una o due voci che corrispondano al tuo tono e impegnati a usarle per coerenza. Se intendi diventare globale, progetta attorno al doppiaggio: scegli una voce clonata primaria e mappala alle tracce doppiate in un massimo di 33 lingue di destinazione.
Volume di produzione. Per caricamenti settimanali o serie occasionali, gli strumenti web Text to Speech e AI Dubbing sono sufficienti. Per contenuti ad alto volume o basati su dati, pianifica un flusso di lavoro API-first in cui nuovi script e asset attivano la generazione vocale automaticamente.
Controllo del brand e rischio. Usa voci standard per pilot a basso rischio e canali in cui l'identità vocale non è centrale. Usa voci clonate con regole interne chiare su chi può attivarle e dove possono apparire, il che conta di più per canali aziendali o brandizzati.
Abbinare le tue voci alle aspettative del pubblico, ai piani linguistici e al flusso di lavoro è il modo per evitare i fallimenti comuni: narrazione incoerente, cambi di voce inaspettati tra i video e pipeline sovra-ingegnerizzate difficili da mantenere. Un percorso pratico è testare prima alcune voci standard, aggiungere una voce clonata quando la tua identità conta, e introdurre API e doppiaggio multilingue quando la tua operazione supera il rendering manuale.
Domande frequenti
Posso usare le voci AI di DubSmart sui miei video YouTube?
I nostri strumenti Text to Speech e AI Dubbing sono progettati per creator e aziende per produrre voci fuori campo per contenuti pubblici, incluso YouTube, con un modello di utilizzo basato su crediti. Rimani responsabile del rispetto dei termini di YouTube, delle politiche pubblicitarie e delle normative locali, ma la nostra piattaforma è progettata per l'uso di media commerciali.
Di quanto audio ho bisogno per clonare la mia voce?
Hai bisogno di almeno 20 secondi di parlato pulito senza rumore di fondo per creare una voce clonata utilizzabile. Più pulita è la registrazione, più accurato e naturale sarà il risultato, quindi un campione silenzioso dedicato batte l'audio rumoroso riutilizzato.
La mia voce clonata funzionerà in più lingue?
Sì. Una voce clonata è utilizzabile sia in Text to Speech sia in AI Dubbing, che supportano molte lingue e 33 lingue di destinazione per il doppiaggio. Mantieni la stessa identità vocale attraverso script in lingue diverse, anche se pronuncia e accento seguono il modello di sintesi piuttosto che il parlato umano madrelingua in ogni caso.
Posso passare dalle voci standard a una voce clonata in seguito?
Sì. Trattiamo le voci clonate come voci riutilizzabili nello stesso catalogo delle voci AI standard, quindi puoi iniziare con voci standard e in seguito passare i progetti a una voce clonata usando le stesse interfacce o API Text to Speech e AI Dubbing, senza ricostruire il tuo flusso di lavoro.
In che modo le API aiutano con la produzione per YouTube?
Le nostre API Text to Speech, Voice Cloning e AI Dubbing ti permettono di convertire script in parlato, clonare voci e doppiare video tramite endpoint RESTful. Questo rende pratico automatizzare formati ricorrenti, integrare voci fuori campo in un CMS o una pipeline di montaggio esistente e scalare su molti canali o lingue senza attivare manualmente ogni render.