Terjemahan ucapan ke ucapan mengubah kata-kata yang diucapkan dalam satu bahasa menjadi ucapan yang dapat didengar dalam bahasa lain, sehingga audiens Anda mendengar terjemahannya alih-alih membacanya. Bayangkan seorang instruktur yang merekam pelajaran dalam bahasa Inggris dan kini membutuhkan versi bahasa Spanyol tanpa harus merekam ulang apa pun: sistem mentranskripsikan bahasa Inggris, menerjemahkan maknanya, dan menghasilkan audio bahasa Spanyol sebagai gantinya. Pergeseran dari membaca ke mendengarkan itulah intinya, dan hal itu mengubah cara Anda merencanakan, meninjau, dan menerbitkan konten multibahasa.
Pertanyaan sebenarnya jarang tentang apakah teknologinya berfungsi. Melainkan versi mana yang Anda butuhkan: terjemahan rekaman untuk video, kursus, dan podcast; terjemahan mendekati waktu nyata untuk rapat dan acara; output yang mempertahankan suara yang menjaga identitas pembicara asli; atau API yang dapat Anda integrasikan ke dalam aplikasi Anda sendiri. Masing-masing jalur tersebut membawa pertimbangan yang berbeda dalam hal kualitas, latensi, dan upaya peninjauan, dan panduan ini memetakannya agar Anda dapat memilih dengan mata terbuka.
Daftar isi
Cara kerja terjemahan ucapan ke ucapan
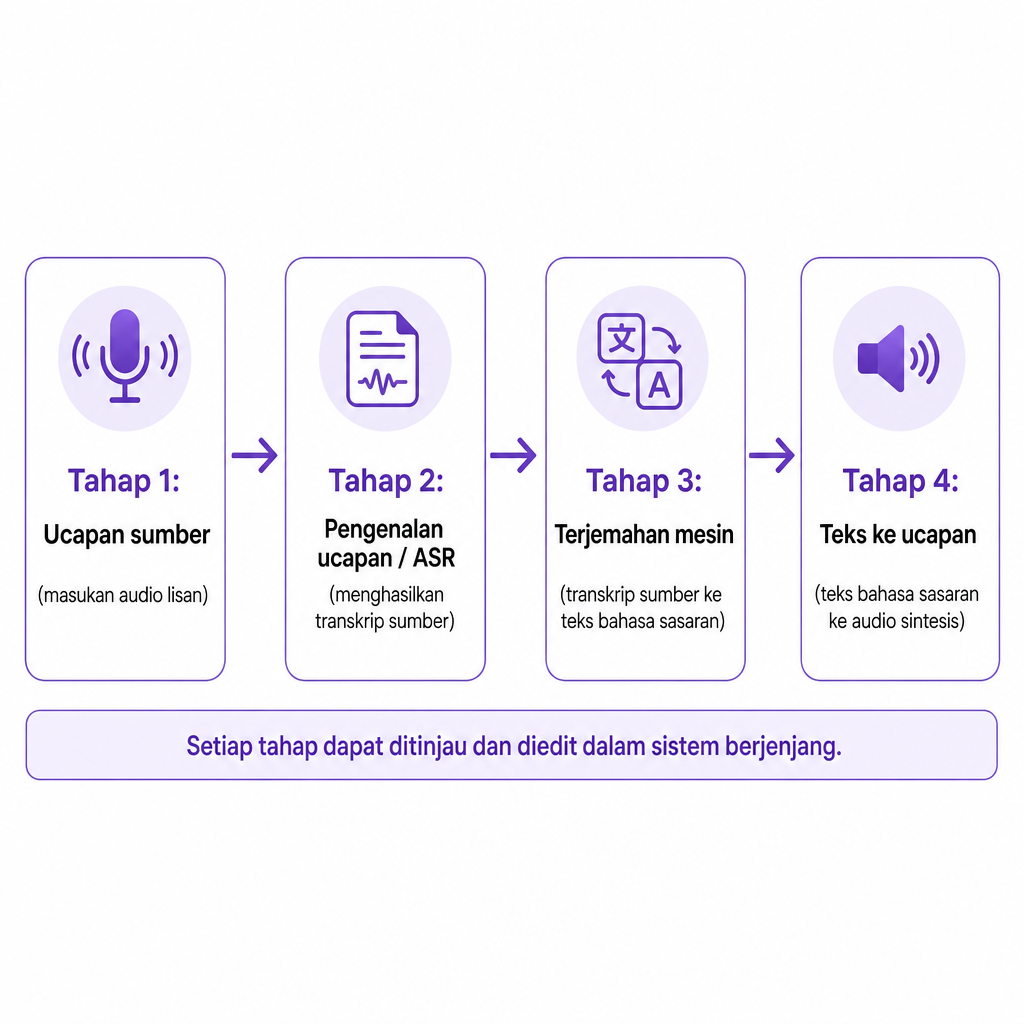
Sebagian besar sistem menjalankan pipeline terhubung dari tiga teknologi. Pertama, pengenalan ucapan otomatis (ASR) menganalisis audio sumber dan menghasilkan transkrip. Selanjutnya, terjemahan mesin mengubah teks bahasa sumber tersebut ke dalam bahasa target. Terakhir, teks ke ucapan mengubah teks yang diterjemahkan menjadi audio yang diucapkan. Alurnya terbaca jelas sebagai ucapan sumber, lalu pengenalan, lalu teks terjemahan, lalu ucapan yang disintesis.
Ucapan sumber → pengenalan ucapan → teks terjemahan → ucapan yang disintesis
Desain berlapis ini disebut terjemahan ucapan ke ucapan berjenjang, dan publikasi NIST tentang evaluasi terjemahan ucapan menggambarkan struktur yang sama: ASR membangun transkrip sumber, terjemahan mesin menghasilkan teks bahasa target, dan teks ke ucapan menghasilkan output lisan. Keunggulan jenjang adalah bahwa setiap tahap dapat diperiksa, sehingga Anda dapat mengoreksi transkrip atau terjemahan sebelum audio pernah dihasilkan.
Pendekatan yang lebih baru melatih model end-to-end untuk memetakan audio sumber langsung ke audio bahasa target tanpa memperlihatkan tahap transkripsi dan sintesis yang terpisah. Penelitian yang dibagikan melalui laporan teknis DTIC tentang terjemahan ucapan langsung membingkai ini sebagai cara untuk mengurangi penundaan dan mempertahankan lebih banyak suara asli pembicara, sembari mencatat bahwa hal itu tetap mengorbankan kecepatan, konteks, cakupan bahasa, dan kualitas output. Dalam praktiknya, jenjang memberi Anda lebih banyak kontrol editorial; pendekatan end-to-end mengejar latensi yang lebih rendah dan kontinuitas suara.
Terjemahan ucapan ke ucapan versus tugas terkait
Orang sering mencampuradukkan terjemahan ucapan ke ucapan dengan transkripsi, terjemahan teks, dan sulih suara, tetapi masing-masing berakhir dengan hasil yang berbeda. Terjemahan teks berhenti pada output tertulis. Terjemahan ucapan ke ucapan berakhir dengan output lisan, meskipun sistem berjenjang tetap menggunakan teks secara internal sebagai representasi antara. Memilah input dan output menyelamatkan Anda dari memilih alat yang salah untuk pekerjaan tersebut.
| Teknologi | Input | Output | Penggunaan umum |
|---|---|---|---|
| Ucapan ke teks | Audio lisan | Transkrip tertulis | Takarir, catatan, konten yang dapat dicari |
| Terjemahan teks | Teks tertulis | Teks terjemahan | Dokumen, subtitel, halaman web |
| Teks ke ucapan | Teks tertulis | Ucapan sintetis | Narasi, aksesibilitas, antarmuka suara |
| Terjemahan ucapan ke ucapan | Audio lisan | Ucapan terjemahan | Percakapan, sulih suara, media multibahasa |
Sulih suara layak mendapat pembedaan tersendiri. Terjemahan ucapan ke ucapan berfokus secara sempit pada mengubah bahasa yang diucapkan. Sulih suara adalah alur kerja lokalisasi media yang lebih luas yang membungkusnya: menerjemahkan dialog, menetapkan pembicara, menghasilkan suara baru, menyesuaikan waktu, mencampur suara terjemahan dengan musik dan audio latar, serta mengekspor proyek yang sudah jadi. Untuk video YouTube yang direkam, kursus daring, podcast, atau film, sulih suara biasanya merupakan format yang lebih praktis karena menambahkan kontrol editorial tersebut di atas terjemahan. Jika Anda sedang menimbang audio terhadap teks di layar, penjelasan kami tentang sulih suara versus subtitel untuk video membahas pilihan spesifik tersebut, dan mekanisme yang lebih luas ada dalam panduan kami tentang apa itu sulih suara AI dan cara kerjanya.
Tiga komponen yang menentukan kualitas
Kualitas output bukanlah satu angka tunggal. Ia merupakan hasil dari tiga tahap, masing-masing dengan mode kegagalannya sendiri, sehingga lebih baik mengevaluasinya secara terpisah daripada mempercayai kesan keseluruhan.
Pengenalan ucapan otomatis mengidentifikasi kata-kata dalam rekaman sumber, dan akurasinya menurun dengan musik latar, pembicara yang tumpang tindih, aksen kuat, ucapan cepat atau tidak lengkap, istilah khusus domain, mikrofon yang buruk, serta peralihan kode antarbahasa. Metrik umum di sini adalah tingkat kesalahan kata (WER), yang membandingkan transkrip otomatis terhadap referensi manusia dengan menghitung substitusi, penghapusan, dan penyisipan. Publikasi NIST yang sama menggunakan WER sebagai tolok ukur pengenalan, meskipun WER yang rendah tidak menegaskan bahwa terjemahan berikutnya mempertahankan makna atau nada. Jika audio sumber Anda bising, mengisolasi ucapan yang bersih terlebih dahulu dengan alat seperti pemisah ucapan kami dapat meningkatkan akurasi pengenalan bahkan sebelum terjemahan dimulai.
Terjemahan mesin harus menafsirkan lebih dari sekadar kata-kata individual. Ia menangani struktur kalimat, konteks, kata ganti dan gender, idiom, humor, formalitas, referensi budaya, terminologi teknis, dan perbedaan dalam urutan kata. Terjemahan harfiah bisa saja benar secara tata bahasa namun terdengar tidak alami atau diam-diam mengubah makna yang dimaksud, yang sangat berisiko untuk klaim iklan, instruksi hukum, informasi medis, konten keuangan, dan materi pendidikan.
Sintesis ucapan menghasilkan suara bahasa target akhir, mengendalikan pengucapan, jeda, kecepatan bicara, intonasi, penekanan, nada emosional, identitas suara, serta aksen atau varian bahasa. Produk Teks ke Ucapan kami menawarkan lebih dari 300 suara AI, pembuatan multibahasa, dan kloning suara di 33 bahasa, dengan kontrol untuk kecepatan bicara, penekanan, pembacaan angka, dan penyampaian emosional. Terjemahan yang akurat secara teknis masih dapat kurang mengena jika penyampaiannya tidak sesuai dengan merek, kursus, atau dokumenter yang menjadi miliknya.
Kloning suara dalam ucapan terjemahan
Kloning suara bersifat opsional, tetapi itulah yang membuat konten terjemahan terasa seperti kreator yang sama alih-alih orang asing yang membacakan naskah. Alih-alih menetapkan suara stok yang tidak berkaitan untuk setiap bahasa, sebuah sistem dapat membangun penampilan bahasa target yang dimodelkan pada identitas vokal pembicara asli. Kontinuitas itu penting bagi saluran yang menginginkan satu suara yang dapat dikenali di berbagai bahasa, perusahaan dengan presenter yang dikenal, kursus panjang yang dipimpin instruktur, pembuat film yang membutuhkan konsistensi di berbagai versi sulih suara, atau pembawa acara podcast yang mempertahankan suara yang familier dalam episode terjemahan.
Ini bukan jaminan. Kloning mempertahankan identitas vokal, tetapi emosi, humor, tempo, pengucapan, dan konteks budaya masih memerlukan sentuhan manusia sebelum Anda menerbitkan. Yang sama pentingnya adalah otorisasi: alur kerja yang bertanggung jawab memastikan bahwa siapa pun yang menyediakan rekaman telah menyetujui kloning dan bahwa suara yang dihasilkan boleh digunakan untuk distribusi komersial, publik, atau geografis yang dimaksud. Jika Anda penasaran tentang mekanisme di balik ini, ikhtisar kami tentang cara kerja kloning suara membahas lebih dalam, dan alat Kloning Suara menunjukkan sisi produksinya.
Terjemahan rekaman versus terjemahan waktu nyata
Inilah keputusan yang sebenarnya dihadapi sebagian besar tim, dan kedua mode tersebut tidak boleh dinilai dengan tolok ukur yang sama.
Terjemahan rekaman biasanya lebih cocok untuk produksi media karena memberi Anda waktu untuk bekerja. Anda dapat mengoreksi transkrip, mengedit terminologi, meninjau terjemahan, mengidentifikasi pembicara, menyesuaikan waktu, menghasilkan ulang suara, mencampur audio latar, dan menjalankan jaminan kualitas oleh manusia sebelum apa pun dirilis. Hal itu membuatnya sangat cocok untuk saluran YouTube, e-learning, pelatihan korporat, podcast, video produk, dan film independen.
Terjemahan waktu nyata beroperasi di bawah batasan yang lebih keras: ia harus mulai menghasilkan output sebelum pembicara menyelesaikan sebuah kalimat. Lebih banyak konteks meningkatkan kualitas terjemahan tetapi menambah penundaan, sementara penundaan yang lebih pendek memaksa prediksi atau terjemahan parsial, dan kesalahan sulit ditarik kembali setelah audio sudah diputar. Laporan DTIC mencatat bahwa sistem berjenjang sebelumnya sering berjalan dengan penundaan empat hingga lima detik, mengakumulasi kesalahan di berbagai tahap, dan memiliki personalisasi yang terbatas, serta bahwa meningkatkan lookahead sebuah model dapat menaikkan kualitas sekaligus membuat interaksi terasa kurang langsung. Fitur konferensi langsung dan sulih suara multibahasa yang halus memecahkan masalah yang berbeda, jadi nilailah keduanya dengan standar yang berbeda.
Cara mengevaluasi alur kerja ucapan ke ucapan
Uji dengan sampel yang representatif, bukan kalimat demo yang rapi. Daftar periksa di bawah mencerminkan kondisi nyata yang akan dihadapi konten Anda, dan hal itu menjaga evaluasi tetap jujur.
- Cakupan bahasa dan dialek: "Mendukung bahasa Spanyol" mungkin tidak berarti aksen, kosakata, atau preferensi regional yang diharapkan audiens Anda. Konfirmasikan varian sumber dan target, termasuk bahasa Inggris AS versus bahasa Inggris lainnya, bahasa Spanyol Amerika Latin versus Eropa, dan bahasa Prancis Kanada versus Eropa.
- Akurasi transkrip: Sebuah terjemahan tidak dapat secara andal memperbaiki transkrip yang mengacaukan nama, angka, atau istilah produk. Periksa apakah Anda dapat meninjau dan mengedit transkrip sebelum menghasilkan audio.
- Makna dan konteks: Uji secara sengaja idiom, lelucon, ajakan bertindak, klaim produk, dan terminologi industri. Kelancaran bukanlah akurasi.
- Penanganan pembicara: Untuk wawancara, panel, dan film, verifikasi bahwa alat dapat mengidentifikasi banyak pembicara dan menjaga suara mereka tetap konsisten, termasuk saat orang saling menyela.
- Waktu dan sinkronisasi: Kalimat terjemahan jarang cocok dengan durasi aslinya. Cari kontrol waktu atau kecepatan bicara, ditambah pengeditan dialog, pelestarian audio latar, penyesuaian volume, pembuatan ulang segmen, dan penyelarasan visual bila diperlukan.
- Kealamian suara: Perhatikan pengucapan, jeda, penekanan, rentang emosional, dan ritme yang tidak alami.
- Latensi: Untuk penggunaan langsung, ukur penundaan dari pembicara ke audio. Untuk penggunaan rekaman, prioritaskan fleksibilitas pengeditan di atas kecepatan pemrosesan mentah.
- Kontrol peninjauan dan ekspor: Alat yang siap produksi memungkinkan Anda mengoreksi teks, menghasilkan ulang segmen individual, menyesuaikan waktu, dan mengekspor dalam format yang diterima alur kerja penerbitan Anda.
Jalankan sampel-sampel ini melalui daftar pilihan Anda dan bandingkan akurasi transkrip, makna terjemahan, pengucapan, kealamian suara, konsistensi pembicara, waktu, kualitas audio latar, upaya peninjauan, dan total biaya pada volume yang Anda harapkan. Sistem terkuat bukanlah yang memiliki suara atau bahasa terbanyak. Melainkan yang menghasilkan hasil yang dapat diterima untuk konten spesifik Anda dengan beban kerja peninjauan yang benar-benar dapat ditanggung tim Anda.
Risiko dan keterbatasan yang perlu diantisipasi
Setiap tahap memperkenalkan jenis kesalahannya sendiri, dan suara yang terdengar alami dapat menyamarkan semuanya. AI dapat salah menerjemahkan ekspresi yang ambigu, nama, idiom, dan istilah khusus, sehingga peninjauan manusia tetap penting di mana pun akurasi membawa bobot hukum, keselamatan, keuangan, atau reputasi. Kesalahan pengenalan memperparah masalah: kebisingan, obrolan silang, aksen, dan rekaman yang buruk dapat menyebabkan sistem salah mendengar sumber, itulah sebabnya meninjau transkrip sebelum menyetujui terjemahan tidak dapat ditawar.
Makna budaya mudah hilang. Terjemahan langsung mungkin menghilangkan humor, kesopanan, atau referensi yang hanya bertahan dengan penulisan ulang alih-alih terjemahan kata demi kata. Kloning suara menambah risiko persetujuan dan peniruan, jadi dokumentasikan siapa yang mengotorisasi suara, cakupan penggunaan, wilayah, durasi, dan apakah suara itu boleh muncul dalam iklan atau pernyataan publik sintetis. Ada juga dimensi kepercayaan audiens: laporan DTIC menggambarkan bagaimana satu pengalaman terjemahan memberi tahu pengguna bahwa audio terjemahan dihasilkan secara sintetis, sebuah ekspektasi yang wajar untuk direncanakan dalam pengungkapan Anda sendiri.
Dua risiko yang lebih tenang melengkapi daftar ini. Privasi menjadi penting setiap kali audio berisi informasi pribadi, diskusi rahasia, data pelanggan, atau konten yang belum dirilis, jadi tinjau ketentuan penanganan data, retensi, akses, dan penghapusan penyedia sebelum mengunggah. Dan rasa percaya diri yang keliru adalah kegagalan yang paling berbahaya dari semuanya: suara yang halus membuat terjemahan yang salah terdengar otoritatif, jadi jangan pernah menganggap kelancaran sebagai bukti akurasi faktual.
Di mana DubSmart berperan
Kami paling relevan secara langsung dengan terjemahan ucapan ke ucapan rekaman melalui Sulih Suara AI, alih-alih klaim apa pun tentang terjemahan percakapan langsung universal. Alur kerja sulih suara kami menerima unggahan audio dan video serta tautan YouTube, mendukung lebih dari 60 bahasa sumber dan 33 bahasa target, mengkloning suara setiap pembicara untuk versi terjemahan, dan memungkinkan Anda mengedit teks, pembicara, dan waktu, menghasilkan ulang segmen, menyesuaikan volume suara latar, dan mengunduh proyek yang sudah jadi. Lapisan editorial itulah yang persis dibutuhkan produksi media rekaman.
Untuk tim yang membangun pipeline mereka sendiri, kami juga menawarkan API Sulih Suara AI, Teks ke Ucapan, dan Kloning Suara, yang cocok untuk agensi, alur kerja media, dan aplikasi yang perlu mengotomatiskan produksi suara multibahasa. Pilihan yang tepat bergantung pada apakah proyek Anda menginginkan editor media yang sudah jadi, pipeline berbasis API, atau keduanya. Untuk pesan singkat dan berisiko tinggi, terjemahan dan perekaman manusia profesional mungkin masih unggul; untuk pustaka konten yang besar dan sering diperbarui, alur kerja AI lebih baik dalam penskalaan dengan peninjauan manusia yang difokuskan pada materi berisiko tertinggi.
Pertanyaan yang sering diajukan
Apakah terjemahan ucapan ke ucapan sama dengan interpretasi?
Tidak. Interpretasi manusia bergantung pada orang terlatih yang mendengarkan, memahami, dan menyampaikan makna saat itu juga. Terjemahan ucapan ke ucapan bersifat otomatis: cepat dan dapat diskalakan, tetapi mungkin memerlukan peninjauan dan dapat kesulitan dengan nuansa yang ditangani seorang penerjemah lisan profesional secara alami.
Apakah selalu bekerja secara waktu nyata?
Tidak. Beberapa sistem memproses audio rekaman dengan kontrol pengeditan penuh, sementara yang lain menyediakan output langsung atau mendekati waktu nyata. Sistem langsung terus-menerus menyeimbangkan konteks terjemahan, latensi, dan akurasi.
Dapatkah ia mempertahankan suara pembicara asli?
Terkadang. Sistem yang menggunakan kloning suara atau sintesis yang mempertahankan suara dapat memodelkan identitas pembicara asli, tetapi hasilnya bergantung pada teknologi, pasangan bahasa, kualitas audio, dan otorisasi untuk menggunakan suara tersebut.
Apakah sulih suara AI merupakan bentuk terjemahan ucapan ke ucapan?
Ya. Sulih suara AI adalah aplikasi media rekaman dari terjemahan ucapan ke ucapan yang menambahkan fitur pengeditan, manajemen pembicara, pengaturan waktu, pencampuran, dan ekspor di atas terjemahan inti.
Seberapa akurat?
Akurasi bervariasi menurut bahasa, kualitas rekaman, terminologi, pembicara, dan sistem. Evaluasi transkrip, terjemahan, dan audio yang dihasilkan secara terpisah alih-alih mempercayai satu persentase akurasi tunggal.