Jika mikrofon Anda menangkap suara lalu lintas, obrolan di kafe, atau bantalan musik yang menumpuk tepat di atas dialog, pertanyaannya bukanlah apakah rekaman itu bisa digunakan—melainkan bagaimana cara menarik kembali suara dengan bersih. Itulah persis yang dilakukan pemisah ucapan. Dalam istilah sederhana, pemisah ucapan adalah alat audio bertenaga AI yang mengisolasi ucapan manusia dari segala sesuatu yang lain dalam sebuah rekaman—kebisingan latar belakang, musik, dan suara lainnya—sehingga Anda tersisa dengan jalur suara bersih yang dapat Anda transkripsikan, sulih suarakan, kloning, atau remix. Bagi siapa saja yang memproduksi konten multibahasa, jalur bersih itu adalah pembeda antara sulih suara yang terdengar profesional dan sulih suara yang terdengar "cukup baik".
Panduan ini menjelaskan apa sebenarnya pemisah ucapan itu, bagaimana cara kerjanya di balik layar, kapan Anda benar-benar membutuhkannya, dan apa yang perlu dipertimbangkan sebelum Anda memutuskan menggunakan sebuah alat. Kami membangun Speech Separator ke dalam alur kerja DubSmart AI justru karena ucapan yang bersih adalah fondasi tempat segala sesuatu lainnya berdiri.
Daftar isi
Apa sebenarnya pemisah ucapan itu
Dalam penelitian audio, pemisahan ucapan didefinisikan sebagai tugas memisahkan ucapan target dari gangguan latar belakang dalam rekaman campuran. Sistem yang lebih canggih melangkah lebih jauh dan memisahkan beberapa pembicara satu sama lain, menghasilkan jalur terisolasi untuk setiap suara.
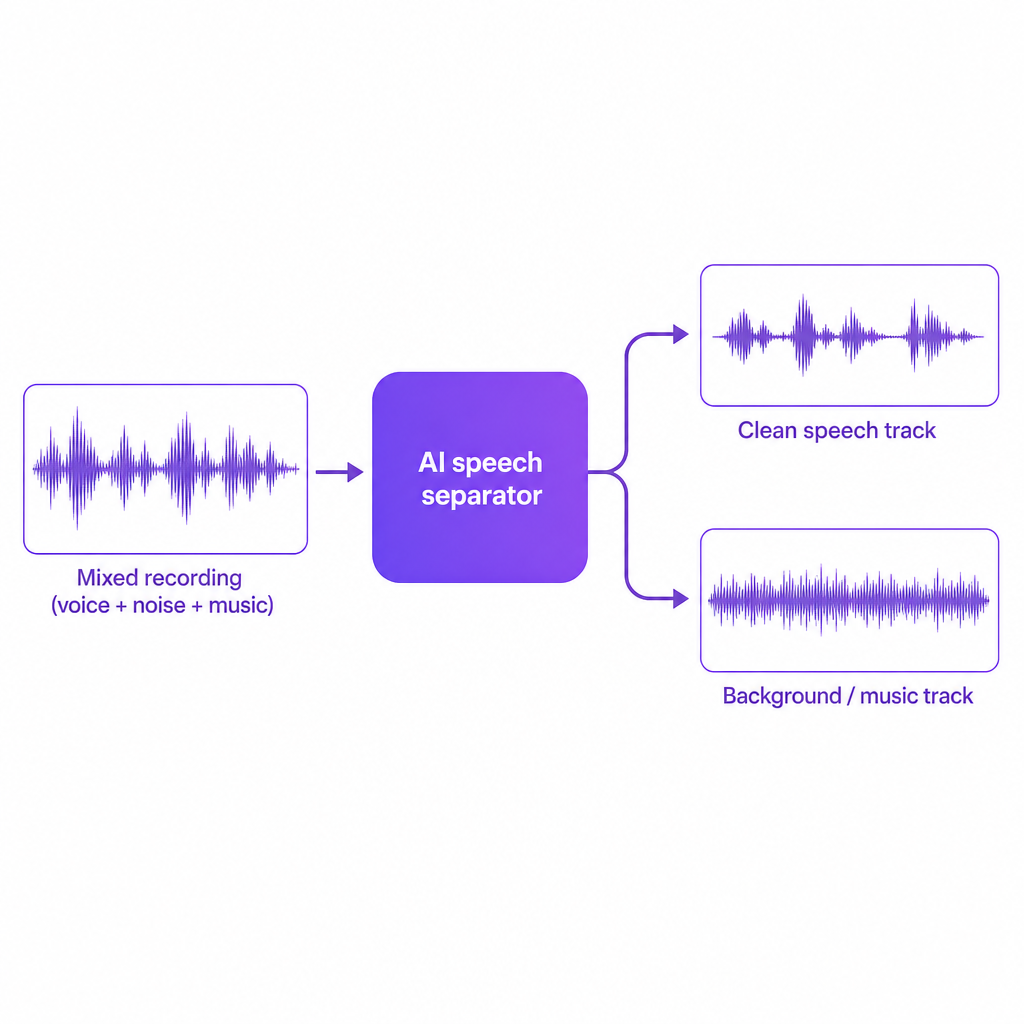
Diterjemahkan ke dalam pekerjaan produksi sehari-hari, pemisah ucapan mengambil berkas audio campuran—dialog ditambah kebisingan atau musik—dan menghasilkan satu atau lebih jalur yang hanya berisi ucapan, ditambah jalur opsional yang menyimpan sisa audio latar belakang. Speech Separator kami dibangun untuk menghilangkan kebisingan latar belakang dan mengisolasi ucapan dari rekaman apa pun, yang membuatnya sangat cocok untuk pasca-produksi film, podcast, dan wawancara. Alat ini bekerja pada berkas audio maupun video: alat ini dapat mengurangi kebisingan rekaman dari lingkungan yang bising dan memisahkan vokal dari jalur pengiring sehingga Anda mendapatkan stem suara dan latar belakang yang terpisah.
Di sinilah kesalahpahaman umum membuat orang keliru. Pemisah ucapan tidak sama dengan pengurangan kebisingan tradisional. Pengurangan kebisingan menurunkan volume suara yang tidak diinginkan. Pemisah ucapan secara aktif mengidentifikasi di mana ucapan hadir dalam sinyal dan merekonstruksinya sebagai aliran yang terpisah dan lebih bersih. Perbedaan itulah mengapa pemisah dapat menyelamatkan suara yang terkubur di bawah musik, sementara gerbang kebisingan sebagian besar hanya membuat seluruh rekaman menjadi lebih pelan.
Apakah Anda benar-benar membutuhkannya?
Keputusan sebenarnya adalah apakah pekerjaan Anda bergantung pada audio ucapan yang andal dan bersih daripada apa pun yang kebetulan ditangkap mikrofon. Jika ya, pemisah khusus berhenti menjadi sekadar pelengkap dan menjadi langkah fundamental.
Beberapa situasi membuat peningkatan itu menjadi jelas. Kreator YouTube dan bisnis kecil sering menggunakan kembali rekaman lama yang direkam di ruangan bergema, kafe, atau di jalanan, di mana kebisingan membuat ucapan sulit dipahami dan sulit ditranskripsikan. Tim e-learning dan pelatihan membangun kursus multibahasa dari webinar dan kuliah langsung, di mana setiap transkrip dan sulih suara hilir mewarisi kualitas ucapan aslinya. Pembuat film dan produser podcast sering perlu menyelamatkan penampilan hebat yang ditangkap dalam kondisi tidak sempurna sebelum menggabungkannya kembali dengan musik dan desain suara. Dan pengembang atau agensi yang memasukkan audio pengguna ke dalam alur transkripsi, kloning suara, atau sulih suara tahu bahwa input yang bising secara langsung menurunkan akurasi model.
Beberapa pemicu konkret menandakan bahwa pemisah layak diadopsi:
- Anda melokalisasi ke dalam beberapa bahasa dan menginginkan sulih suara serta subtitle yang konsisten dan jelas. Ucapan yang bersih memberi masukan ke mesin AI Dubbing dan Speech to Text kami jauh lebih andal daripada campuran yang bising.
- Anda mengandalkan kloning suara untuk suara bermerek atau karakter dan menginginkan hasil terbaik dengan melatih pada sampel yang bebas kebisingan dan bebas artefak.
- Anda secara rutin menerima rekaman yang dibuat pengguna atau rekaman lapangan yang tidak Anda kendalikan, dan Anda tetap membutuhkannya siap siar. Pemisah memberi Anda tahap pembersihan yang berulang alih-alih menyetel setiap berkas secara manual.
Pengecualian yang jujur: jika audio Anda sudah direkam di studio yang tertata, dengan stem terpisah untuk dialog dan musik, maka pemisah adalah kenyamanan alih-alih keharusan. Bagi semua orang lain yang bekerja dengan suara dunia nyata, alat ini pantas mendapat tempat permanen dalam alur.
Bagaimana pemisahan ucapan bekerja di balik layar
Pemisahan ucapan modern dibangun di atas pembelajaran mendalam dan penelitian pemisahan sumber, bukan EQ dan filter sederhana. Tugas yang mendasarinya mudah dinyatakan namun sulit dipecahkan: diberikan sinyal campuran yang berisi beberapa sumber, pulihkan sinyal ucapan individual tanpa mengetahuinya sebelumnya.
Sebagian besar sistem saat ini mengikuti alur encoder–separator–estimator–decoder. Encoder memetakan bentuk gelombang atau spektrogram mentah ke dalam ruang fitur berdimensi tinggi di mana pola-pola relevan ucapan seperti forman dan harmonik menjadi lebih mudah dideteksi. Separator—sebuah jaringan saraf—memproses fitur-fitur itu dan belajar memisahkan informasi milik sumber suara yang berbeda, entah itu ucapan versus kebisingan atau satu pembicara versus lainnya. Tahap estimasi kemudian memprediksi topeng yang menyaring komponen non-ucapan atau langsung memperkirakan representasi fitur dari setiap sumber. Akhirnya, decoder mengubah representasi terpisah itu kembali menjadi audio domain waktu, menghasilkan satu atau lebih jalur ucapan bersih dan secara opsional jalur latar belakang residual.
Model-model ini dilatih pada kumpulan data besar yang penuh dengan campuran ucapan-dan-kebisingan, mempelajari pola diskriminatif dari ucapan, pembicara, dan gangguan dari contoh berlabel. Penelitian yang lebih baru mengondisikan pemisah pada embedding pembicara atau prompt, yang memungkinkan pemisahan diarahkan pada suara tertentu di dalam audio yang ramai.
Kesimpulan praktis bagi kreator adalah bahwa pemisah modern bukanlah gerbang kebisingan yang dimuliakan. Ini adalah model yang telah belajar seperti apa tampilan dan bunyi ucapan di berbagai kondisi, dan dapat merekonstruksi suara bahkan ketika terkubur di bawah musik, kebisingan kerumunan, atau gema ruangan.
Dua tugas pemisahan utama
Dalam praktiknya Anda akan menemui dua jenis pemisahan ucapan, dan platform sering menggabungkan keduanya.
Yang pertama adalah ucapan satu pembicara versus latar belakang: mengekstrak satu jalur suara yang koheren dari kebisingan, musik, atau suara sekitar. Inilah tugas yang menjadi fokus Speech Separator kami untuk film, podcast, dan wawancara, karena tugas ini langsung memetakan apa yang paling dibutuhkan kebanyakan kreator sehari-hari.
Yang kedua adalah pemisahan multi-pembicara, di mana sistem menghasilkan jalur terpisah untuk setiap pembicara dalam percakapan. Ini sangat berguna untuk diarisasi dan analitik dalam rapat berformat panjang atau diskusi panel, di mana mengetahui siapa yang mengatakan apa sama pentingnya dengan apa yang dikatakan.
Alat konsumen cenderung mengemas ini dalam antarmuka sederhana—unggah sebuah lagu untuk mendapatkan jalur vokal dan instrumental terpisah, atau isolasi dialog dalam video untuk pengeditan. Implementasi kami menekankan pemisahan ucapan-versus-latar belakang karena ini adalah tugas yang paling langsung bernilai untuk alur kerja sulih suara, transkripsi, dan kloning.
Apa yang perlu dipertimbangkan sebelum memilih pemisah
Ketika Anda mengevaluasi apakah pemisah memenuhi kebutuhan profesional, segelintir kriteria lebih penting daripada materi pemasaran.
Mulailah dengan kualitas ucapan dan artefak. Pemisah yang baik mempertahankan timbre alami sebuah suara alih-alih membuatnya terdengar metalik, seperti di bawah air, atau berfase, dan menghindari munculnya kebisingan musikal atau distorsi kasar ketika menghilangkan elemen latar belakang yang kuat seperti musik. Survei akademis menandai gangguan residual dan artefak sebagai tantangan utama, terutama pada kebisingan non-stasioner. Uji yang paling andal tetaplah memeriksa keluaran sampel pada materi Anda sendiri.
Ketahanan terhadap kebisingan dunia nyata adalah berikutnya. Model yang dilatih pada data laboratorium yang bersih dapat kesulitan dengan lalu lintas, angin, gumaman kerumunan, ruangan bergema, dan konten di mana ucapan tumpang tindih dengan musik atau efek yang keras. Karya mutakhir menargetkan tepat campuran kompleks ini, tetapi kinerja masih bervariasi tergantung kondisi rekaman—jadi ujilah di berbagai lingkungan tempat Anda benar-benar merekam, dari kantor hingga jalanan hingga studio rumah.
Penanganan musik dan konten campuran adalah kebutuhan yang sering dan spesifik. Menghilangkan soundtrack untuk sulih suara ulang, atau mengisolasi narasi dari B-roll, memerlukan alat yang secara eksplisit mendukung pemisahan musik-dan-suara dan menghasilkan dua berkas yang dapat digunakan alih-alih satu hasil yang teredam. Alur pemisahan kami mendeteksi frekuensi vokal, mengisolasinya dari musik, dan menghasilkan berkas berkualitas tinggi yang terpisah: satu dengan vokal bersih dan satu dengan bantalan musik. Ini sangat berguna ketika Anda berencana untuk me-remix, menskoring ulang, atau melakukan sulih suara ulang ke bahasa lain.
Integrasi dengan alat hilir menentukan seberapa banyak waktu yang benar-benar dihemat pemisah. Pemisahan jarang berdiri sendiri—ia memberi masukan ke model transkripsi di mana input yang lebih bersih menurunkan tingkat kesalahan kata, mesin kloning suara yang menghargai sampel bebas kebisingan, dan sistem sulih suara yang menyelaraskan ucapan asli dengan jalur terjemahan. Platform kami dibangun di sekitar alur kerja terpadu yang menjaga Speech Separator, Speech to Text, Text to Speech, Voice Cloning, dan AI Dubbing dalam satu tempat, sehingga satu rekaman yang telah dibersihkan dapat menjadi konten multibahasa, bersuara kloning, dan terlokalisasi penuh tanpa membangun ulang alur setiap saat.
Latensi, skala, dan otomatisasi penting bagi siapa saja yang memiliki tumpukan pekerjaan. Podcast, kursus, dan arsip berformat panjang membutuhkan pemrosesan batch yang menangani berkas multijam, waktu pemrosesan per berkas yang wajar, dan pengait otomatisasi di mana pemisahan berada di dalam sistem Anda sendiri. Kami menyediakan API Text to Speech, Voice Cloning, dan AI Dubbing sehingga pengembang dapat menghubungkan pemrosesan ucapan ke dalam alur menyeluruh.
Akhirnya, privasi dan kepatuhan tidak hilang begitu audio bersih. Memisahkan ucapan dari latar belakang tidak menghilangkan tanggung jawab Anda atas rekaman yang mungkin berisi percakapan sensitif, atau untuk menghormati hak ketika Anda mengekstrak dan menggunakan kembali suara dari materi berlisensi. Tim perusahaan harus memastikan kebijakan yang jelas tentang penyimpanan dan penggunaan data serta menyelaraskan setiap alur pemisahan dengan pedoman kepatuhan internal.
Di mana kekurangannya
Pemisah ucapan dapat mengubah sebuah rekaman, tetapi ia bukan keajaiban, dan berpura-pura sebaliknya mengarah pada keputusan yang buruk.
Pengurangan kebisingan berlebihan adalah jebakan yang paling umum. Pemisahan yang agresif dapat menghilangkan isyarat ucapan yang halus—konsonan lembut, nada ruangan alami—dan meninggalkan suara yang terdengar tidak alami atau melelahkan untuk didengarkan. Artefak residual adalah sisi lainnya: dalam kondisi sulit, model mungkin meninggalkan jejak musik atau kebisingan di jalur ucapan, atau menghasilkan kebisingan musikal, terutama ketika gangguan kuat dan terus-menerus berubah.
Ada juga bias pembicara dan bahasa yang perlu diperhitungkan. Model yang dilatih dominan pada bahasa, aksen, atau gaya bicara tertentu dapat berkinerja lebih buruk pada suara yang kurang terwakili. Dan bentuk gelombang yang tampak bersih dapat menciptakan rasa aman yang keliru: itu tidak menjamin audio cocok untuk tugas kritis seperti analisis forensik atau konteks kepatuhan yang ketat.
Untuk pekerjaan kreatif dan lokalisasi, keterbatasan ini dapat dikelola, tetapi keterbatasan tersebut merupakan argumen kuat untuk menguji dengan sampel representatif dari materi Anda sendiri alih-alih memercayai demo vendor.
Speech Separator di dalam alur kerja kami
Kami memperlakukan Speech Separator sebagai implementasi praktis dan ramah kreator dari teknologi ini, terintegrasi erat dengan sisa platform DubSmart AI alih-alih ditempelkan.
Dalam penggunaan, alat ini menghilangkan kebisingan latar belakang dan mengisolasi ucapan dari rekaman apa pun, menghasilkan suara bersih yang cocok untuk pasca-produksi film, podcast, dan wawancara. Alat ini mengekstrak vokal yang jelas dari jalur campuran dan menghasilkan berkas berkualitas tinggi yang terpisah untuk ucapan dan musik latar, sehingga Anda dapat mengedit, melakukan sulih suara ulang, atau me-remix tanpa berjuang melawan campuran asli. Alat ini bekerja pada sumber audio maupun video—Anda mengunggah berkas atau menggunakan tautan, menjalankannya melalui alur, dan mengunduh jalur yang sudah selesai. Dan yang terpenting, keluaran itu dioptimalkan untuk memberi masukan ke alat kami lainnya, sehingga satu rekaman yang telah dibersihkan dapat diubah menjadi konten multibahasa, bersuara kloning, dan terlokalisasi penuh.
Bagi kreator YouTube, bisnis kecil, pelatih, pembuat film, podcaster, dan tim pengembang, integrasi itu mengubah peran pemisahan itu sendiri. Ia berhenti menjadi tugas terisolasi "perbaiki audio" dan menjadi langkah pertama yang terstandarisasi dalam siklus hidup pembuatan dan lokalisasi konten yang lebih besar dan otomatis. Jika Anda membangun saluran atau perpustakaan kursus multibahasa, di sanalah penghematan waktu yang sebenarnya berlipat ganda.
Pertanyaan yang sering diajukan
Apa itu pemisah ucapan, dalam istilah sederhana?
Ini adalah alat AI yang mengambil rekaman campuran yang bising dan menghasilkan jalur di mana Anda sebagian besar hanya mendengar suara manusia, ditambah jalur latar belakang opsional yang dapat Anda simpan atau buang.
Apakah pemisah ucapan sama dengan pengurangan kebisingan?
Tidak. Pengurangan kebisingan hanya menurunkan suara yang tidak diinginkan. Pemisahan ucapan secara eksplisit mengidentifikasi dan merekonstruksi ucapan sebagai sumber yang berbeda, biasanya dengan kejelasan yang lebih tinggi dan kontrol yang lebih besar atas hasilnya.
Dapatkah pemisah ucapan menangani lebih dari satu pembicara?
Banyak sistem tingkat penelitian dan beberapa produk dapat memisahkan beberapa pembicara ke dalam jalur individual, meskipun kualitas bervariasi tergantung tumpang tindih dan kondisi rekaman. Speech Separator kami berfokus terutama pada mengisolasi ucapan dari latar belakang untuk alur kerja kreator umum.
Apakah menggunakan pemisah ucapan akan meningkatkan hasil sulih suara dan kloning suara saya?
Ya. Audio input yang lebih bersih umumnya meningkatkan pengenalan ucapan, penyelarasan, dan kualitas kloning suara, yang membuat sulih suara multibahasa dan suara kloning lebih alami dan konsisten.
Apakah pemisahan ucapan bekerja terlepas dari bahasa?
Sebagian besar model pemisah beroperasi pada pola akustik alih-alih teks, sehingga dapat menangani banyak bahasa. Kinerja masih bergantung pada data pelatihan dan seberapa baik aksen Anda terwakili.