Pengubah suara AI real time mengubah suara Anda menjadi suara yang berbeda saat Anda berbicara, dengan menangkap audio mikrofon, menganalisisnya, mengubah identitas pembicara, dan memutar kembali audio yang telah diubah dengan sedikit jeda. Tidak seperti filter pengubah nada dasar, alat ini dapat mempertahankan sebagian besar kata-kata, timing, dan ekspresi Anda tetap utuh sambil mengubah kualitas seperti timbre, persepsi usia, presentasi gender, atau gaya karakter. Dan tidak seperti text to speech, alat ini dimulai dari ucapan langsung, bukan teks yang diketik.
Keputusan sebenarnya bagi kreator, streamer, pendidik, dan bisnis bukan sekadar apakah hasilnya terdengar realistis. Melainkan apakah alat tersebut cocok dengan jenis input, toleransi latensi, kebutuhan kontrol suara, integrasi, kewajiban hak, dan kualitas produksi yang Anda targetkan. Panduan ini menjelaskan cara kerja teknologinya, di mana posisinya dibanding alat suara AI terkait, dan kapan alur kerja rekaman lebih melayani Anda.
Daftar isi
Apa arti "real time" yang sebenarnya
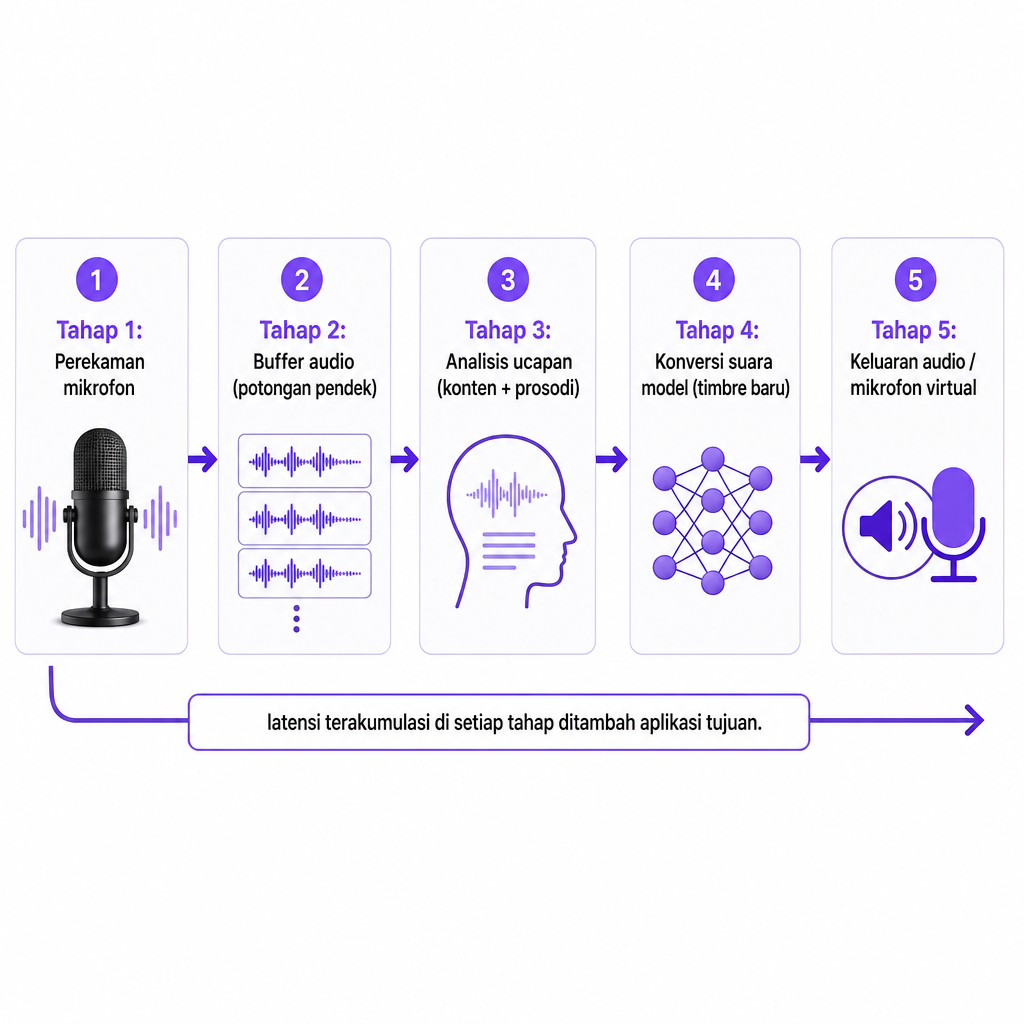
"Real time" berarti sistem memproses aliran audio yang masuk saat Anda berbicara, bukan menunggu rekaman lengkap atau naskah yang selesai. Sinyal menempuh jalur berkelanjutan: mikrofon, buffer audio, analisis ucapan, model konversi suara, output audio. Karena konverter bekerja pada segmen pendek daripada kalimat penuh, konversi suara streaming secara teknis berbeda dari rendering voiceover yang sudah jadi di mana seluruh naskah diketahui sebelumnya.
Beberapa jeda tidak dapat dihindari. Sistem membutuhkan waktu untuk menangkap, menganalisis, mensintesis, dan mengeluarkan setiap potongan audio. Penelitian menunjukkan bahwa konversi latensi rendah dapat dicapai, meskipun angkanya sangat bergantung pada model, perangkat keras, ukuran buffer, dan kualitas audio. Model penelitian LLVC melaporkan latensi di bawah 20 milidetik pada CPU konsumen, sementara StreamVC melaporkan latensi end-to-end sebesar 70,8 milidetik dalam lingkungan evaluasinya. Ini adalah hasil penelitian dalam kondisi tertentu, bukan jaminan kinerja untuk alat komersial apa pun yang mungkin Anda unduh.
Cara kerja pengubah suara AI real time
Proses berjalan sebagai loop saat Anda berbicara, bukan sebagai render tunggal. Memahami empat tahap ini membantu Anda menilai mengapa satu alat terasa alami dan alat lain terasa robotik atau lamban.
Pertama, sistem menangkap ucapan Anda. Ia menerima audio dari mikrofon atau input langsung lainnya dan membaginya menjadi potongan-potongan pendek agar model dapat memprosesnya secara berkelanjutan. Kualitas input lebih penting daripada yang diperkirakan banyak pengguna. Kebisingan latar belakang, gema ruangan, suara ketikan keyboard, clipping, dan sinyal yang tidak stabil semuanya mendorong konversi ke arah artefak yang tidak alami.
Kedua, ia memisahkan konten ucapan dari identitas pembicara. Suara membawa beberapa lapisan yang tumpang tindih sekaligus: konten linguistik, atau kata-kata; prosodi, yang berarti ritme, penekanan, dan intonasi; nada; timbre yang membuat suara dapat dikenali; dan identitas pembicara yang lebih luas. Sistem konversi berusaha mempertahankan konten dan ekspresi sambil mengganti karakteristik pembicara. Penelitian streaming modern menggambarkan ini sebagai mempertahankan konten dan prosodi ucapan sumber sambil mencocokkan timbre vokal pembicara target. Pemisahan itulah yang membuat konverter yang baik memungkinkan Anda berbicara secara spontan dalam suara yang telah diubah alih-alih mengaburkan filter "robot" tetap di seluruh gelombang.
Ketiga, model mensintesis suara baru. Ia merekonstruksi audio menggunakan profil suara target, yang mungkin berupa karakter bawaan, suara pustaka, suara khusus yang dibuat dari rekaman yang diizinkan, atau profil yang dirancang untuk anonimisasi daripada peniruan. Output diproduksi secara berkelanjutan dengan buffer look-ahead kecil. Lebih banyak konteks dapat meningkatkan stabilitas, tetapi juga menambah jeda, yang merupakan trade-off inti dari konversi langsung.
Keempat, sinyal yang telah dikonversi dirutekan ke sebuah aplikasi. Alat desktop biasanya mengekspos output sebagai mikrofon virtual, sehingga program lain menerimanya seolah-olah itu mikrofon normal. Perutean itulah yang memungkinkan live stream, game online, panggilan video, obrolan suara, dan acara virtual. Oleh karena itu, pengubah real-time harus bekerja di tingkat sistem operasi dan aplikasi, bukan hanya di dalam model. Kompatibilitas dengan perangkat lunak streaming, Discord, Zoom, browser, dan perangkat seluler bisa sama pentingnya dengan kualitas suara mentah. Jika Anda ingin mengekstrak teks bersih dari audio yang sama untuk teks atau pengolahan ulang, langkah speech to text terpisah menangani transkripsi, bukan konversi.
Konversi real-time vs. alat suara AI terkait
Teknologi-teknologi ini tumpang tindih dalam benak orang tetapi menyelesaikan masalah yang benar-benar berbeda. Tabel di bawah ini memperjelas apa yang menjadi input masing-masing dan kapan outputnya tiba.
| Teknologi | Input | Waktu output | Paling cocok untuk |
|---|---|---|---|
| Pengubah suara real-time | Ucapan mikrofon langsung | Selama percakapan | Panggilan langsung, gaming, streaming, pertunjukan |
| Text to speech | Teks tertulis | Setelah teks dikirim | Narasi, tutorial, iklan, e-learning |
| Kloning suara | Sampel suara | Dihasilkan sesuai permintaan | Suara sintetis yang dapat digunakan ulang untuk narasi atau dubbing |
| AI dubbing | Audio atau video yang sudah ada | Setelah pemrosesan | Menerjemahkan dan melokalkan konten rekaman |
| Efek nada atau formant | Audio langsung atau rekaman | Langsung atau hampir langsung | Modifikasi suara kreatif sederhana |
Perbedaan itu bersifat praktis, bukan akademis. Sebuah platform mungkin menawarkan pembuatan suara AI atau kloning suara yang kuat tanpa menawarkan pengubah mikrofon langsung untuk panggilan dan streaming. Alat kami sendiri berfokus pada media yang dihasilkan dan dilokalkan: kami menyediakan Text to Speech, Voice Cloning, AI Dubbing, Speech to Text, Speech Separator, Text to Image, dan Image to Video dalam satu alur kerja. Ini dirancang untuk menghasilkan audio dari teks atau membangun suara yang dapat digunakan ulang untuk konten yang dihasilkan, sehingga termasuk dalam sisi alur kerja rekaman dari tabel ini daripada konversi mikrofon langsung.
Untuk apa konversi suara langsung berguna
Streamer dan gamer memanfaatkan konversi suara untuk mempertahankan karakter, melindungi privasi, atau menjaga persona channel yang konsisten. Latensi rendah paling penting di sini, karena Anda bereaksi terhadap pemain lain dan berbicara dengan audiens. Jeda kecil dapat ditoleransi dalam monolog bergaya siaran tetapi menjadi sangat mencolok selama percakapan cepat, permainan kompetitif, atau timing komedi.
Dalam rapat online dan acara virtual, suara yang dikonversi dapat mendukung role-play, demonstrasi, skenario aksesibilitas, atau partisipasi yang sadar privasi. Untuk lingkungan profesional, kejelasan dan keandalan harus mengungguli kebaruan, dan peserta harus diberi tahu ketika sebuah suara diubah jika kebisuan dapat menyesatkan mereka.
Pertunjukan karakter adalah penggunaan langsung lainnya. Pembuat film indie, pengembang game, dan podcaster dapat menguji suara karakter atau melakukan dialog sementara secara langsung. Namun untuk pengiriman akhir, voiceover AI rekaman atau pertunjukan manusia biasanya memberikan kontrol pengeditan yang lebih baik dan konsistensi antar sesi.
Privasi suara dan anonimisasi adalah tujuan yang berbeda dari peniruan. Anonimisasi berusaha menyamarkan siapa yang berbicara, sementara peniruan berusaha mereproduksi identitas target tertentu. Keduanya tidak sepenuhnya aman, dan suara yang diubah masih dapat membocorkan kebiasaan berbicara, pilihan kata, atau suara latar belakang yang membantu mengidentifikasi pembicara.
Terakhir, teknologi suara sintetis mendukung aksesibilitas dan komunikasi bantuan bagi orang-orang yang telah kehilangan kemampuan berbicara. Federal Trade Commission mengakui manfaat medis dan aksesibilitas ini sekaligus memperingatkan bahwa replikasi suara dapat disalahgunakan untuk penipuan dan penyalahgunaan data biometrik.
Kriteria keputusan yang benar-benar penting
Latensi menjadi yang pertama, dan Anda harus meminta latensi end-to-end yang terukur, bukan hanya kecepatan inferensi model. Jeda yang benar-benar Anda rasakan mencakup penangkapan mikrofon, buffering, ekstraksi fitur, inferensi model, sintesis, perutean output, dan apa pun yang ditambahkan aplikasi panggilan atau streaming di atasnya. Sebuah model yang benchmark-nya cepat secara terisolasi bisa terasa lamban setelah seluruh jalur dirangkai.
Kealamian adalah tes berikutnya. Dengarkan artefak metalik, lonjakan nada mendadak, masalah pernapasan dan pengucapan, jeda yang tidak alami, konsonan yang terdistorsi, gangguan di batas kalimat, dan hilangnya ekspresi emosional. Suara yang meyakinkan harus tetap dapat dipahami selama ucapan spontan, bukan hanya selama baris demo yang dibaca dengan hati-hati.
Pemeliharaan konten ucapan mudah diabaikan sampai gagal. Uji ucapan cepat, interupsi, angka, nama, aksen, tawa, pertanyaan, dan perubahan volume. Alat yang mengubah identitas tetapi meratakan ritme dan intonasi Anda tidak cocok untuk pertunjukan atau interaksi langsung.
Pemilihan dan kustomisasi suara menentukan seberapa jauh Anda dapat membentuk hasilnya. Periksa suara bawaan, pembuatan suara khusus, kontrol nada dan ton, opsi emosi atau gaya, pilihan aksen, konsistensi antar sesi, dan batasan penggunaan komersial apa pun. Pembuatan suara khusus harus selalu memerlukan otorisasi yang jelas: sampel suara bukanlah izin untuk meniru orang yang menjadi sumbernya.
Dukungan perangkat keras dan platform menentukan apakah alat tersebut cocok dengan pengaturan Anda sama sekali. Pastikan apakah ia berjalan secara lokal di CPU atau GPU, di browser, melalui aplikasi desktop, di perangkat seluler, melalui mikrofon virtual, atau melalui API. Pemrosesan cloud dapat menyederhanakan pengaturan tetapi memperkenalkan latensi jaringan dan pertanyaan tata kelola data, sementara pemrosesan lokal dapat mengurangi jeda jaringan tetapi membutuhkan perangkat keras yang lebih mumpuni. Secara terpisah, verifikasi perutean audio: model yang kuat tidak berguna jika outputnya tidak dapat dipilih sebagai mikrofon dalam aplikasi yang Anda tuju.
Penanganan data menutup daftar. Sebelum mengunggah sampel suara apa pun, tinjau apakah rekaman disimpan, apakah mereka digunakan untuk peningkatan model, bagaimana suara khusus dihapus, siapa yang dapat mengakses file, apakah ada kontrol bisnis atau perusahaan, dan apa yang terjadi pada audio yang dihasilkan setelahnya. Rekaman suara dapat menjadi data pribadi yang sensitif atau terkait biometrik tergantung pada konteks dan hukum yang berlaku, jadi perlakukan dengan cara demikian.
Kapan alur kerja rekaman mengalahkan real time
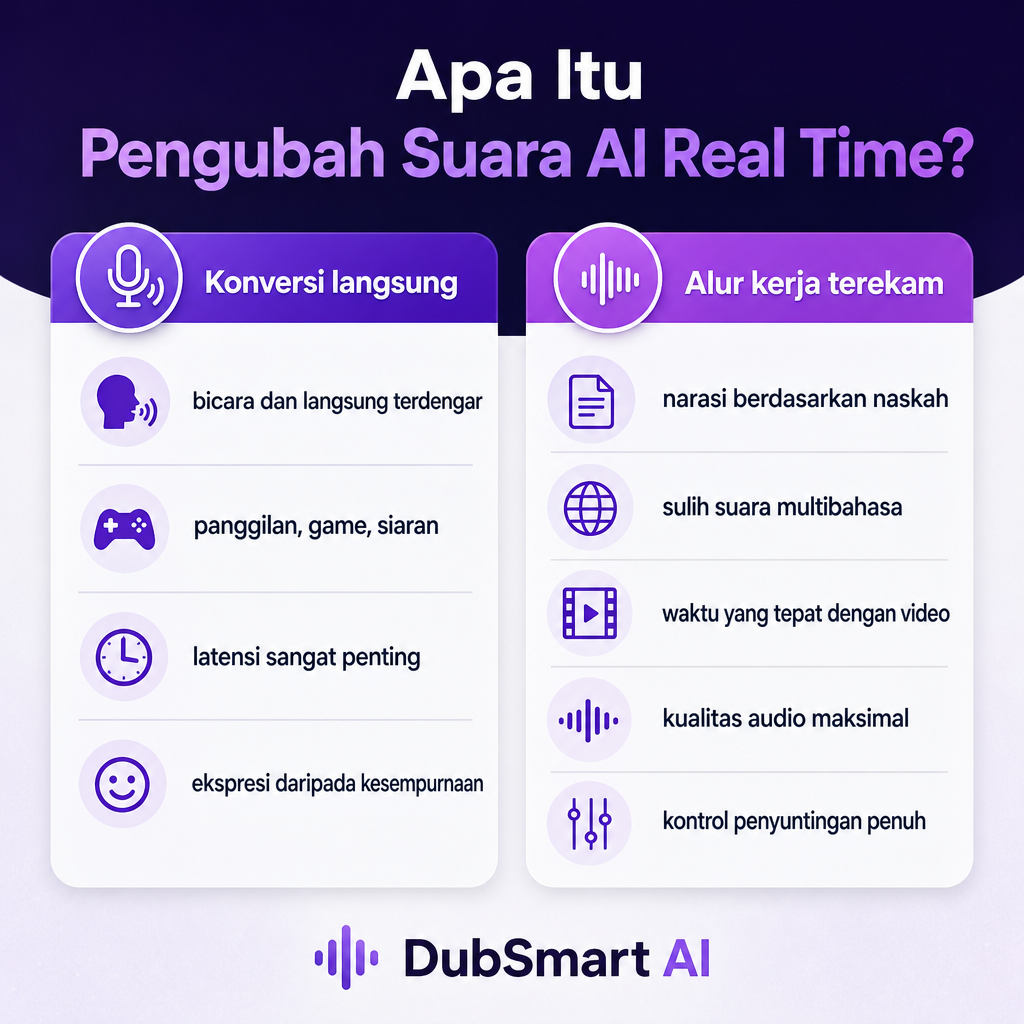
Konversi langsung adalah pilihan yang tepat ketika seseorang perlu berbicara secara alami dan suara yang diubah didengar segera. Itu adalah pilihan yang salah ketika prioritas Anda adalah kualitas audio maksimal, pengucapan yang tepat, narasi multibahasa, timing yang tepat terhadap video, pengeditan terperinci, voiceover komersial yang konsisten, atau dubbing berkualitas tinggi.
Untuk tujuan-tujuan itu, pipeline rekaman menang. Dengan text to speech, Anda mengontrol dan menyempurnakan naskah sebelum audio apa pun dihasilkan, yang menghilangkan masalah latensi langsung sepenuhnya. Dengan AI dubbing, sistem memproses video yang sudah ada dan menyelaraskan ucapan terjemahan terhadap sumbernya, sesuatu yang tidak dapat dilakukan oleh pengubah langsung mana pun. Jika file sumber Anda mencampur dialog dengan musik atau kebisingan, sebuah speech separator dapat mengisolasi trek suara yang bersih sebelum Anda memprosesnya. AI Dubbing kami dibangun untuk menerjemahkan audio atau video rekaman ke dalam bahasa target yang didukung, bukan untuk mengonversi feed mikrofon langsung.
Risiko dan penggunaan yang bertanggung jawab
Peniruan identitas dan penipuan adalah risiko utama. Suara yang dikonversi secara realistis dapat membuat identitas palsu lebih dapat dipercaya, dan FTC memperingatkan bahwa sistem kloning suara digunakan dalam penipuan keluarga, peniruan bisnis, pemerasan, dan penipuan lainnya, bersama dengan risiko bagi seniman suara yang suaranya mungkin diambil alih. Jangan menggunakan suara yang dapat dikenali dari orang sungguhan tanpa otorisasi, dan jangan pernah menyajikan suara yang dihasilkan atau dikonversi AI sebagai bukti bahwa orang tertentu berbicara.
Persetujuan dan hak suara mengikuti secara langsung. Dapatkan izin sebelum mengkloning atau sengaja meniru suara orang lain, dan simpan catatan izin tersebut, terutama untuk proyek komersial, periklanan, pelatihan, game, atau media publik. Materi FTC yang dikutip di sini membahas kerugian, penegakan, dan solusi yang diusulkan daripada menetapkan satu aturan persetujuan untuk setiap penggunaan, sehingga kewajiban spesifik dapat bergantung pada yurisdiksi, kontrak, platform, dan kasus penggunaan. Jika ragu, verifikasi untuk situasi Anda.
Pengungkapan masuk akal kapan pun audiens dapat secara wajar percaya bahwa seseorang berbicara secara langsung. Pemberitahuan singkat bahwa suara tersebut dihasilkan AI atau dikonversi suara mengurangi kebingungan. Keamanan juga penting: lindungi sampel suara dan file suara khusus seperti aset sensitif lainnya, batasi akses, hindari mengunggah rekaman tanpa izin, dan hapus profil suara yang tidak terpakai di mana layanan memungkinkan. Terakhir, rencanakan untuk kegagalan kualitas. Latensi, audio yang terputus, dan artefak konversi dapat menggagalkan percakapan, jadi uji seluruh pengaturan dengan mikrofon, headphone, aplikasi, jaringan, dan perangkat keras yang sebenarnya sebelum go public.
Di mana alat kami cocok dengan proyek suara Anda
Kami menyajikan alur kerja media AI terintegrasi daripada produk pengubah suara mikrofon langsung. Di platform kami, Anda dapat menghasilkan ucapan dari teks, memilih dari lebih dari 300 suara, membuat suara kloning dari sampel pendek, dan menggunakan suara-suara tersebut di seluruh proyek Text to Speech dan AI Dubbing. Kami mendukung dubbing dari lebih dari 60 bahasa sumber ke 33 bahasa target, yang menjadikan kami pilihan yang kuat ketika pekerjaannya adalah membuat voiceover dari naskah, menghasilkan ucapan dengan suara khusus, men-dubbing audio atau video rekaman, atau melokalkan konten untuk audiens multibahasa.
Untuk pengembang, kami menerbitkan halaman API terpisah untuk Text to Speech, Voice Cloning, dan AI Dubbing. Ini adalah alur kerja pembuatan dan pelokalan. Jika proyek Anda secara khusus membutuhkan pengubah suara mikrofon langsung, pastikan bahwa input streaming real-time, perutean output, target latensi, dan dukungan sesi langsung didokumentasikan secara eksplisit sebelum Anda berkomitmen pada API apa pun, baik milik kami maupun orang lain.
Jika Anda menimbang konversi langsung terhadap pipeline rekaman dan tidak yakin jalur mana yang cocok untuk konten Anda, beri tahu kami format sumber Anda, bahasa target, dan apakah Anda membutuhkan output langsung atau prarekam, dan kami akan mengarahkan Anda ke alur kerja yang tepat.
Pertanyaan yang sering diajukan
Apakah pengubah suara AI real time sama dengan text to speech?
Tidak. Pengubah suara real-time mengubah ucapan mikrofon langsung saat Anda berbicara, sementara text to speech menghasilkan ucapan baru dari teks tertulis yang Anda kirim terlebih dahulu. Text to Speech kami dibangun untuk menghasilkan ucapan dari teks, bukan untuk konversi mikrofon langsung.
Apakah pengubah suara AI real time memiliki jeda nol?
Tidak. Setiap sistem membutuhkan waktu untuk menangkap dan memproses audio, sehingga beberapa latensi tidak dapat dihindari. Jeda praktis bergantung pada model, perangkat, pengaturan buffer, jaringan, dan aplikasi tujuan, dan sistem penelitian melaporkan angka yang berbeda dalam kondisi pengujian yang berbeda.
Bisakah pengubah suara AI menyalin suara selebriti?
Beberapa sistem secara teknis dapat meniru suara yang dapat dikenali, tetapi kemampuan teknis bukanlah izin. Hindari peniruan tanpa izin dan periksa kontrak terkait, aturan platform, dan hukum sebelum menggunakan suara orang yang dapat dikenali.
Apa yang harus saya gunakan untuk membuat video YouTube multibahasa?
Untuk video prarekam, AI dubbing umumnya lebih cocok daripada pengubah suara langsung karena memproses video yang sudah ada dan menghasilkan audio yang diselaraskan dan dilokalkan. AI Dubbing kami menerjemahkan dan men-dubbing audio atau video rekaman ke dalam bahasa yang didukung.
Bisakah platform Anda mengubah suara saya secara langsung selama panggilan?
Platform kami mendokumentasikan Text to Speech, Voice Cloning, dan AI Dubbing daripada konversi suara mikrofon langsung. Jika Anda merencanakan alur kerja panggilan langsung, konfirmasikan dokumentasi produk terkini dengan kami terlebih dahulu agar kami dapat merekomendasikan pendekatan yang tepat.