Cara tercepat untuk mengintegrasikan API text to speech adalah memperlakukannya sebagai layanan REST: autentikasi dengan kunci API, kirim teks Anda beserta pengaturan suara sebagai JSON, biarkan layanan merender ucapan di latar belakang, lalu ambil dan simpan file audio hasilnya untuk diputar di mana pun pengguna Anda membutuhkannya. API Text to Speech kami mengikuti pola ini persis sambil menghadirkan 300+ suara natural dan kloning suara tak terbatas, sehingga Anda dapat menyematkan ucapan yang hidup ke situs web, aplikasi, alur produksi video, dan platform pembelajaran. Panduan ini menjelaskan apa yang sebenarnya Anda hubungkan, cara kerja mesin kami, dan keputusan-keputusan yang menentukan apakah integrasi tersebut cocok untuk produk Anda.
Daftar isi
Apa yang dilakukan API text to speech di DubSmart
API text to speech mengubah teks terstruktur menjadi audio ucapan sesuai permintaan, sehingga kode Anda dapat meminta narasi atau dialog saat naskah siap alih-alih menunggu perekaman manual. Mesin Text to Speech kami menggerakkan baik alat Text to Speech berbasis browser maupun API-nya, memberikan akses ke lebih dari 300 suara AI dalam berbagai bahasa, jenis kelamin, dan gaya, dengan prosodi yang disesuaikan untuk narasi, penjelasan, dan dialog.
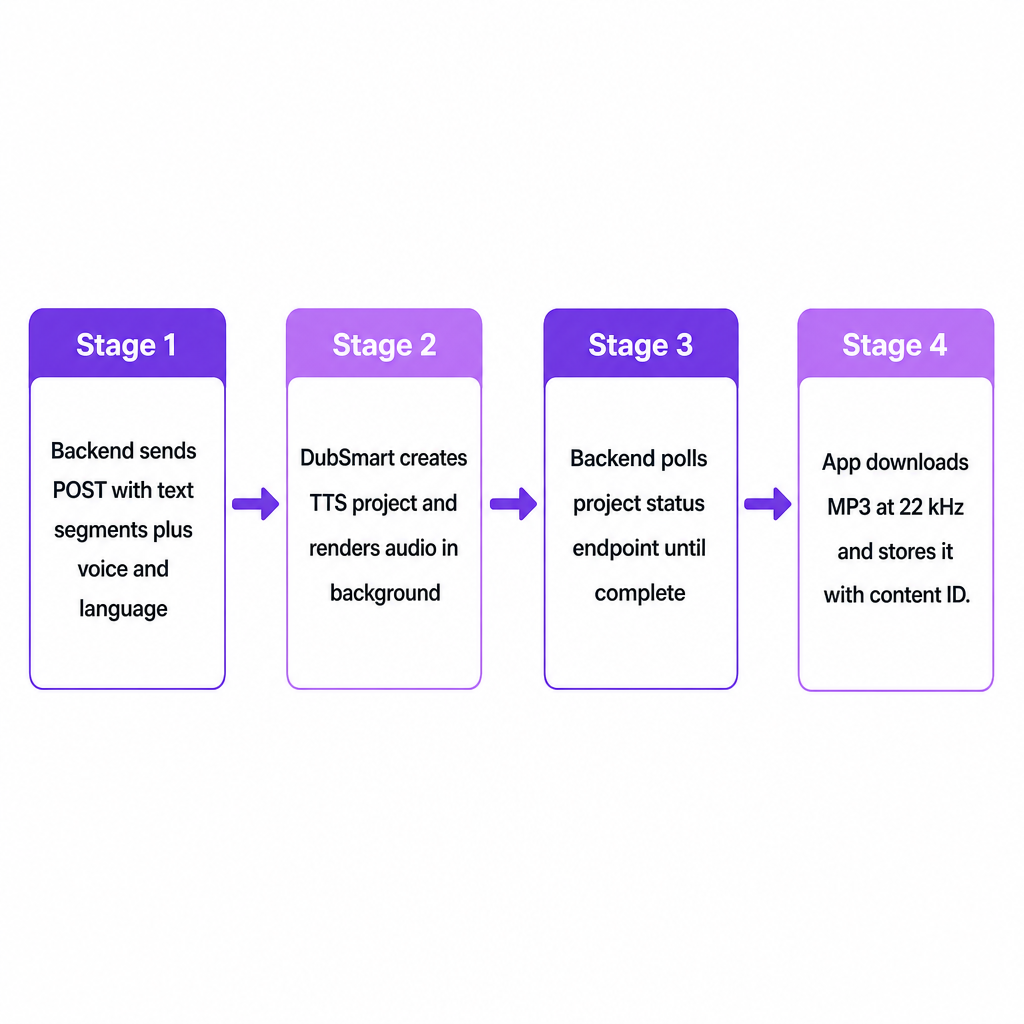
Di lapisan API, kami menghadirkan mesin ini sebagai layanan RESTful: backend Anda mengirim permintaan POST yang berisi segmen teks dan parameter suara, dan layanan mengembalikan objek proyek yang statusnya dapat Anda periksa hingga audio siap diunduh. Output dikirim sebagai file audio berkualitas tinggi, biasanya MP3 pada 22 kHz, cocok untuk penggunaan langsung di editor video, alur kerja podcast, atau pemutar web tanpa konversi tambahan.
Bagi para kreator dan tim yang kami layani—YouTuber, bisnis kecil, produsen e-learning, pembuat film, dan agensi pengembang—API menjembatani perencanaan konten dan publikasi. Segera setelah naskah masuk ke CMS atau platform pembelajaran, backend dapat menghasilkan voiceover secara otomatis, yang menghilangkan hambatan perekaman manual berulang.
Keputusan integrasi: apa yang sebenarnya Anda hubungkan?
"Mengintegrasikan API text to speech" terdengar umum, tetapi dalam praktiknya Anda memutuskan tiga hal: di mana dalam alur kerja Anda ucapan harus dihasilkan, suara dan bahasa mana yang akan mewakili merek Anda, dan seberapa erat Anda mengotomatiskan pembuatan dan pengambilan audio.
Bagi kreator YouTube yang memperluas ke konten multibahasa, integrasi sering berarti menghubungkan API kami ke alat perencanaan video atau basis data naskah sehingga setiap naskah yang difinalisasi menjadi voiceover dalam bahasa dan gaya yang tepat. Untuk bisnis kecil dan tim pemasaran, API biasanya berada di belakang CMS atau platform otomasi pemasaran, mengubah posting blog, penjelasan produk, dan salinan media sosial menjadi aset audio yang dapat digunakan kembali. Penyedia e-learning dan pelatihan korporat cenderung menghubungkan API ke alat penulisan sehingga modul pelajaran dapat meminta narasi per slide atau per topik dan menghasilkannya kembali secara instan saat materi diperbarui.
Pengembang dan agensi yang mengintegrasikan AI suara lebih dalam biasanya memilih antara dua pola. Model batch mengumpulkan naskah dan memprosesnya melalui pekerjaan terjadwal. Model transaksional memicu permintaan langsung setiap kali konten baru atau tindakan pengguna tiba. API berbasis proyek kami bekerja dengan mulus untuk keduanya, karena setiap proyek TTS merangkum teks, pilihan suara, bahasa, dan audio hasil dengan cara yang sesuai dengan unit konten Anda sendiri—video, pelajaran, atau episode podcast. Jika Anda masih mempertimbangkan konsepnya sendiri, penjelasan pendamping kami tentang apa itu API text to speech dan cara kerjanya membahas dasar-dasarnya sebelum Anda berkomitmen pada suatu desain.
Cara kerja API Text to Speech kami di balik layar
API Text to Speech kami dibangun berdasarkan proyek dan segmen, yang membuatnya lebih fleksibel daripada satu endpoint "teks masuk, audio keluar". Proyek TTS mengelompokkan satu atau lebih segmen teks di bawah satu judul dan konfigurasi bersama seperti bahasa dan suara default. Setiap segmen membawa teksnya sendiri, pengidentifikasi suara, dan tag bahasa, yang memungkinkan Anda mencampur gaya narasi atau bahasa dalam satu output.
Payload JSON tipikal ke endpoint proyek TTS mencakup judul proyek yang dapat dibaca manusia untuk dasbor dan log Anda, ditambah array segmen. Setiap segmen menetapkan text (naskah atau kalimat yang akan diucapkan), voice (baik ID suara bawaan atau ID suara kustom yang dibuat melalui Voice Cloning API), dan language (kode yang menunjukkan bahasa segmen).
Saat backend Anda mengirim payload ini ke endpoint TTS dengan kunci API yang valid di header Authorization, kami membuat proyek dan mulai merender audio di latar belakang. API menghadirkan endpoint status proyek yang melaporkan apakah pemrosesan masih berlangsung atau selesai, beserta referensi ke file audio yang dihasilkan setelah siap. Desain asinkron ini menjaga permintaan Anda sendiri tetap cepat: catat ID proyek, kembalikan kontrol ke pengguna, dan biarkan worker latar belakang memeriksa penyelesaian dan menarik audio saat tersedia.
Ucapan yang dihasilkan tiba sebagai file yang dapat diunduh dalam format standar, terutama MP3 pada 22 kHz, yang mudah masuk ke pemutar web, aplikasi seluler, dan timeline pengeditan video. Karena mesin yang sama menggerakkan alat berbasis browser kami, pengembang dapat membuat prototipe suara dan naskah secara interaktif dan kemudian memindahkan kombinasi terbaik ke panggilan API otomatis. Referensi endpoint lengkap ada di halaman Text to Speech API.
Menghubungkan kloning suara dan AI dubbing ke text to speech
Fitur khas kami adalah bahwa Text to Speech, Voice Cloning, dan AI Dubbing berbagi satu mesin suara dan alur kerja dasar yang sama. Itu berarti API TTS tidak berdiri sendiri—ia adalah inti dari alur pelokalan yang lebih luas.
Voice Cloning API memungkinkan Anda mengunggah sampel audio seorang pembicara, membuat suara AI kustom, dan mereferensikan suara tersebut dalam proyek TTS. Setelah suara kustom ada, pengidentifikasinya menjadi field voice dalam segmen Text to Speech Anda, sehingga narasi diputar dalam suara kloning alih-alih suara stok generik. Kesinambungan itu penting bagi pembawa acara, podcaster, dan juru bicara merek yang menginginkan identitas suara yang konsisten di berbagai bahasa dan format. Jika Anda berencana menambahkan kloning, panduan kami tentang mengintegrasikan API kloning suara di aplikasi Anda membahas hal-hal spesifiknya.
AI Dubbing API memperluas ini lebih jauh dengan menggabungkan transkripsi, terjemahan, dan text to speech dalam satu alur yang men-dubbing video ke lebih dari 33 bahasa target. Di sini mesin TTS mengubah naskah yang diterjemahkan menjadi ucapan menggunakan pustaka 300+ suara yang sama atau suara kloning Anda, sehingga versi dubbing mempertahankan nada dan waktu. Bagi kreator dan bisnis multibahasa, API Text to Speech menjadi blok bangunan untuk voiceover monolingual maupun konten dubbing yang sepenuhnya dilokalkan. Ikhtisar kami tentang bagaimana pelokalan AI bekerja menunjukkan bagaimana bagian-bagian ini menyatu dari awal hingga akhir.
Kriteria keputusan utama saat mengintegrasikan API TTS kami
Mengintegrasikan API TTS "apa saja" tidak cukup; pilihan seputar implementasi menentukan seberapa baik ia cocok dengan produksi, merek, dan tumpukan teknis Anda.
Kebutuhan skala dan otomasi. Jika volume konten rendah dan sporadis, alat berbasis browser mungkin cukup. Setelah naskah dihasilkan secara teratur atau terkait dengan kalender konten, sistem manajemen pembelajaran, atau otomasi pemasaran, API menjadi lapisan yang tepat karena dapat dipicu secara programatik dan diskalakan dengan backend Anda.
Strategi suara dan bahasa. Platform kami mendukung dubbing dari lebih dari 60 bahasa sumber ke 33 bahasa target, ditenagai oleh mesin suara yang sama yang digunakan API TTS. Jika merek Anda membutuhkan suara juru bicara yang khas, memasangkan Voice Cloning API dengan TTS menjaga suara itu tetap konsisten di berbagai bahasa dan saluran. Jika Anda memprioritaskan kecepatan daripada personalisasi, suara bawaan membuat implementasi lebih sederhana.
Titik integrasi dalam tumpukan Anda. Untuk kanal YouTube, tempat yang alami adalah alur video: naskah disimpan dalam alat perencanaan, dikirim ke API TTS saat difinalisasi, dan dikembalikan sebagai audio yang siap untuk editor. Platform e-learning dapat berintegrasi pada level pelajaran atau slide, di mana setiap blok konten dipetakan ke segmen dan proyek mewakili seluruh kursus. Tim pemasaran sering berintegrasi pada level CMS sehingga setiap artikel atau halaman produk dapat meminta versi audio untuk aksesibilitas.
Tata kelola, kepatuhan, dan risiko. Karena kloning suara dapat mereplikasi suara yang dikenali, persetujuan, lisensi, dan kebijakan penggunaan menjadi penting. Suara kloning diidentifikasi oleh ID dan dapat ditandai dengan metadata, yang memudahkan penegakan aturan internal tentang di mana suara tertentu boleh digunakan. Putuskan sejak awal lingkungan mana yang boleh memicu suara kloning versus suara generik, dan tambahkan pencatatan log di sistem Anda sendiri.
Ekspektasi latensi dan pengalaman pengguna. Pemrosesan asinkron menawarkan fleksibilitas tetapi menambah pertimbangan waktu. Untuk alur kerja di mana pengguna mengharapkan pemutaran langsung—seperti editor naskah dengan pratinjau instan—buat proyek atau segmen yang lebih kecil dan tampilkan indikator kemajuan saat audio dirender. Untuk pelokalan batch di seluruh pustaka, latensi kurang penting, dan pekerjaan dapat berjalan sesuai jadwal dengan audio yang selesai dilampirkan ke catatan konten setelahnya.
| Area keputusan | Model batch | Model transaksional |
|---|---|---|
| Pemicu | Pekerjaan terjadwal | Per item konten atau tindakan pengguna |
| Toleransi latensi | Tinggi | Rendah |
| Paling cocok untuk | Katalog kursus, pustaka video | Editor naskah, pratinjau langsung |
| Strategi suara | Suara yang disetujui per bahasa | Suara yang disetujui per bahasa |
Risiko dan pengamanan praktis
Mengintegrasikan API text to speech membawa beberapa risiko yang dapat diprediksi yang dapat dimitigasi dengan desain yang matang.
Memilih suara tanpa pengujian dapat menghasilkan ucapan yang terasa tidak sesuai karakter untuk sebuah merek atau pembawa acara. Uji coba suara di antarmuka interaktif terlebih dahulu, dan pertahankan katalog suara yang disetujui di dalam sistem Anda sendiri, diatur per bahasa dan jenis konten, sebelum mengodekan ID suara dalam panggilan API.
Otomasi berlebihan pada konten sensitif adalah jebakan lain. Menghasilkan ucapan secara otomatis untuk materi kepatuhan, medis, atau hukum mungkin tidak sesuai. Karena API kami beroperasi pada proyek dan segmen terpisah, Anda dapat memelihara aturan perutean yang mengirimkan hanya kategori yang disetujui ke TTS sambil menjaga konten sensitif dalam alur kerja rekaman manusia.
Kesalahan operasional—proyek yang gagal atau unduhan yang hilang—terjadi ketika masalah jaringan atau payload tidak valid mengganggu pemrosesan. Endpoint status proyek dan respons terstruktur memungkinkan Anda mengonfirmasi bahwa proyek selesai dan outputnya tersedia sebelum dipublikasikan. Pasangkan setiap ID proyek TTS dengan ID konten Anda sendiri, dan terapkan percobaan ulang atau fallback saat pemeriksaan status melaporkan kesalahan.
Penyalahgunaan suara kloning layak mendapat kontrol eksplisit. Suara kustom harus dibuat melalui endpoint khusus dan kemudian direferensikan oleh ID dalam proyek TTS, yang memberi Anda batas teknis yang jelas untuk dipantau. Batasi siapa yang dapat membuat atau menetapkan ID suara kloning, dan catat di mana suara tersebut digunakan.
Jalur awal yang praktis adalah mengintegrasikan TTS untuk voiceover standar terlebih dahulu, memvalidasi suara dan penanganan kesalahan dalam produksi, lalu menambahkan Voice Cloning dan AI Dubbing setelah integrasi inti stabil. Beri tahu kami volume konten Anda, bahasa target, dan di mana API harus berada dalam tumpukan Anda, dan kami dapat mengarahkan Anda ke endpoint yang tepat serta merencanakan alur kerja Anda.
Pertanyaan yang sering diajukan
Apa perbedaan API Text to Speech dengan alat browser?
Alat browser adalah antarmuka visual di mana Anda menempelkan teks, memilih suara, dan mengunduh audio secara manual. API menghadirkan mesin yang sama melalui endpoint REST sehingga backend Anda dapat menghasilkan dan mengambil audio secara otomatis sebagai respons terhadap naskah, jadwal, atau tindakan pengguna.
Dapatkah API berbicara dengan suara saya sendiri, bukan hanya suara stok?
Ya. Dengan mengintegrasikan Voice Cloning API, Anda mengunggah sampel audio seorang pembicara, membuat suara AI kustom, lalu mereferensikan ID suara tersebut dalam segmen Text to Speech Anda sehingga semua ucapan yang dihasilkan diputar dalam suara kloning.
Bagaimana ini membantu kanal YouTube atau podcast multibahasa?
Platform kami mengubah ucapan atau naskah dari lebih dari 60 bahasa sumber menjadi output dubbing di 33 bahasa target, dengan TTS menghasilkan audio akhir menggunakan 300+ suara atau suara kloning Anda. Menghubungkan API TTS dan AI Dubbing ke alur publikasi Anda memungkinkan video atau episode baru menerima voiceover atau dubbing penuh setelah naskah atau audio sumber siap.
Format audio apa yang akan diterima aplikasi atau editor saya?
API TTS mengirimkan file audio berkualitas tinggi, termasuk MP3 pada 22 kHz, cocok untuk sebagian besar lingkungan web, seluler, dan pengeditan video tanpa konversi tambahan.
Dapatkah saya mengintegrasikan Text to Speech sekarang dan menambahkan AI Dubbing nanti?
Ya. Text to Speech, Voice Cloning, dan AI Dubbing berbagi ekosistem API yang sama, sehingga Anda dapat memulai dengan TTS untuk voiceover dan kemudian menambahkan Voice Cloning dan AI Dubbing untuk mengotomatiskan dubbing multibahasa tanpa membangun ulang integrasi inti Anda.